MCP
什么是MCP?
MCP 起源于 2024 年 11 月 25 日 Anthropic 发布的文章:Introducing the Model Context Protocol。
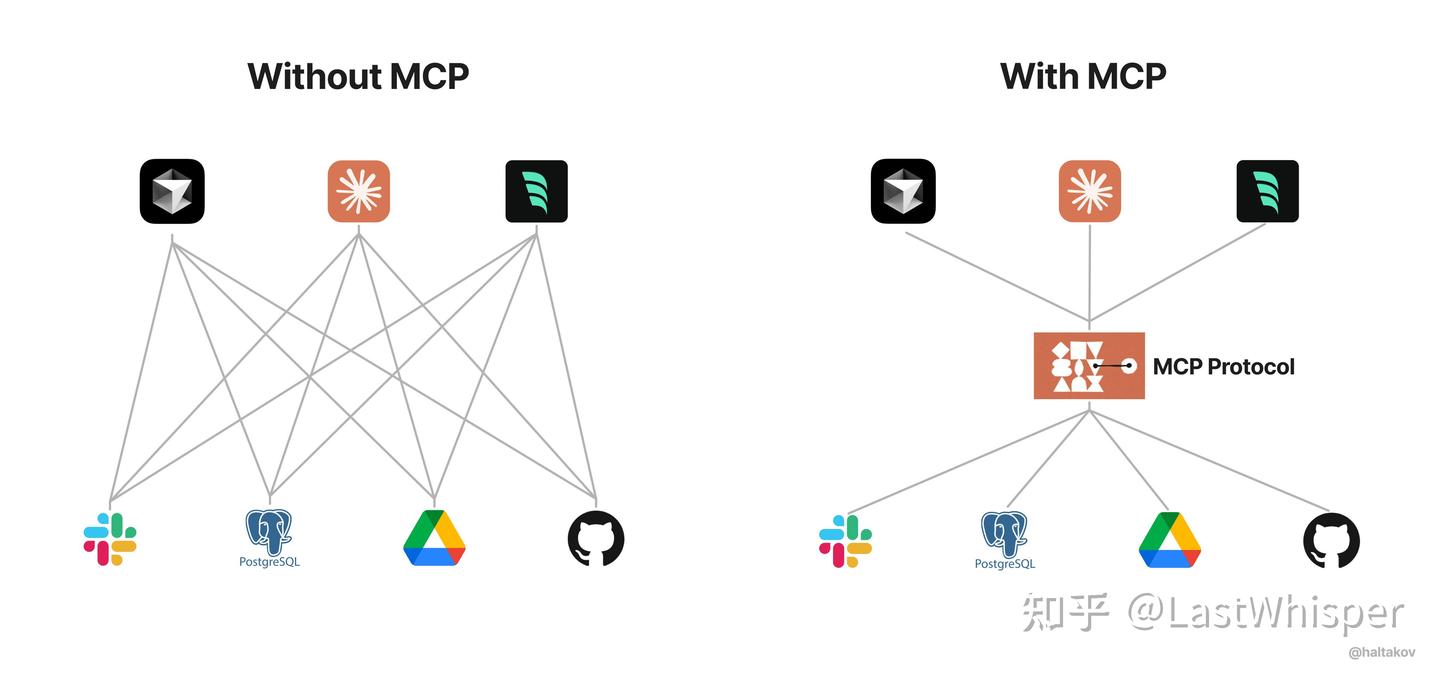
MCP (Model Context Protocol,模型上下文协议)定义了应用程序和 AI 模型之间交换上下文信息的方式。这使得开发者能够**以一致的方式将各种数据源、工具和功能连接到 AI 模型**(一个中间协议层),就像 USB-C 让不同设备能够通过相同的接口连接一样。MCP 的目标是创建一个通用标准,使 AI 应用程序的开发和集成变得更加简单和统一。
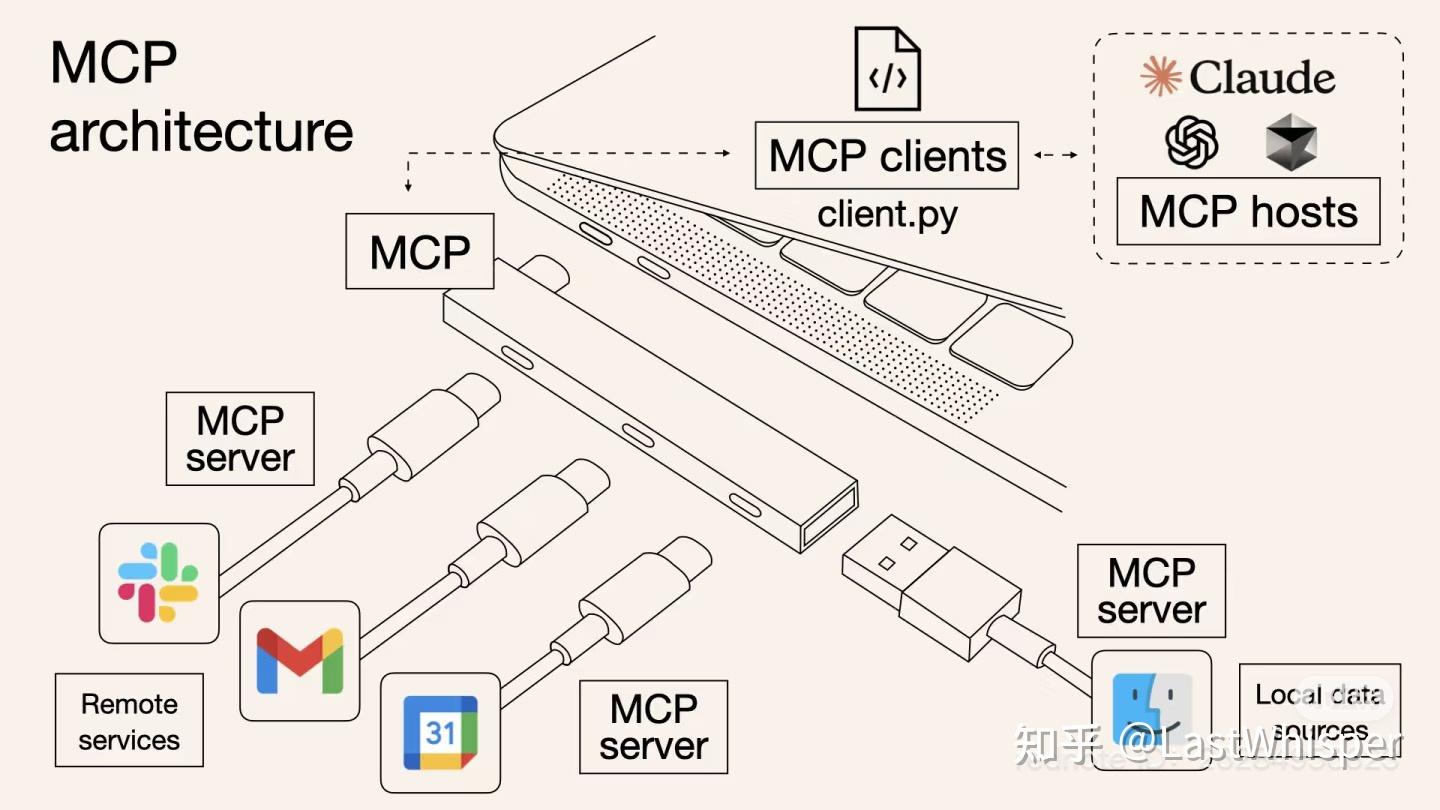
可以看出,MCP 就是以更标准的方式让 LLM Chat 使用不同工具,更简单的可视化如下图所示,这样你应该更容易理解“中间协议层”的概念了。Anthropic 旨在实现 LLM Tool Call 的标准。
如何使用MCP?
对于用户来说,我们并不关心 MCP 是如何实现的,通常我们只考虑如何更简单的用上这一特性。
具体的使用方式参考官方文档:For Claude Desktop Users。这里不再赘述,配置成功后可以在 Claude 中测试:Can you write a poem and save it to my desktop? Claude 会请求你的权限后在本地新建一个文件。
并且官方也提供了非常多现成的 MCP Servers,你只需要选择你希望接入的工具,然后接入即可。
比如官方介绍的 filesystem 工具,它允许 Claude 读取和写入文件,就像在本地文件系统中一样。
MCP架构
这里首先引用官方给出的架构图。
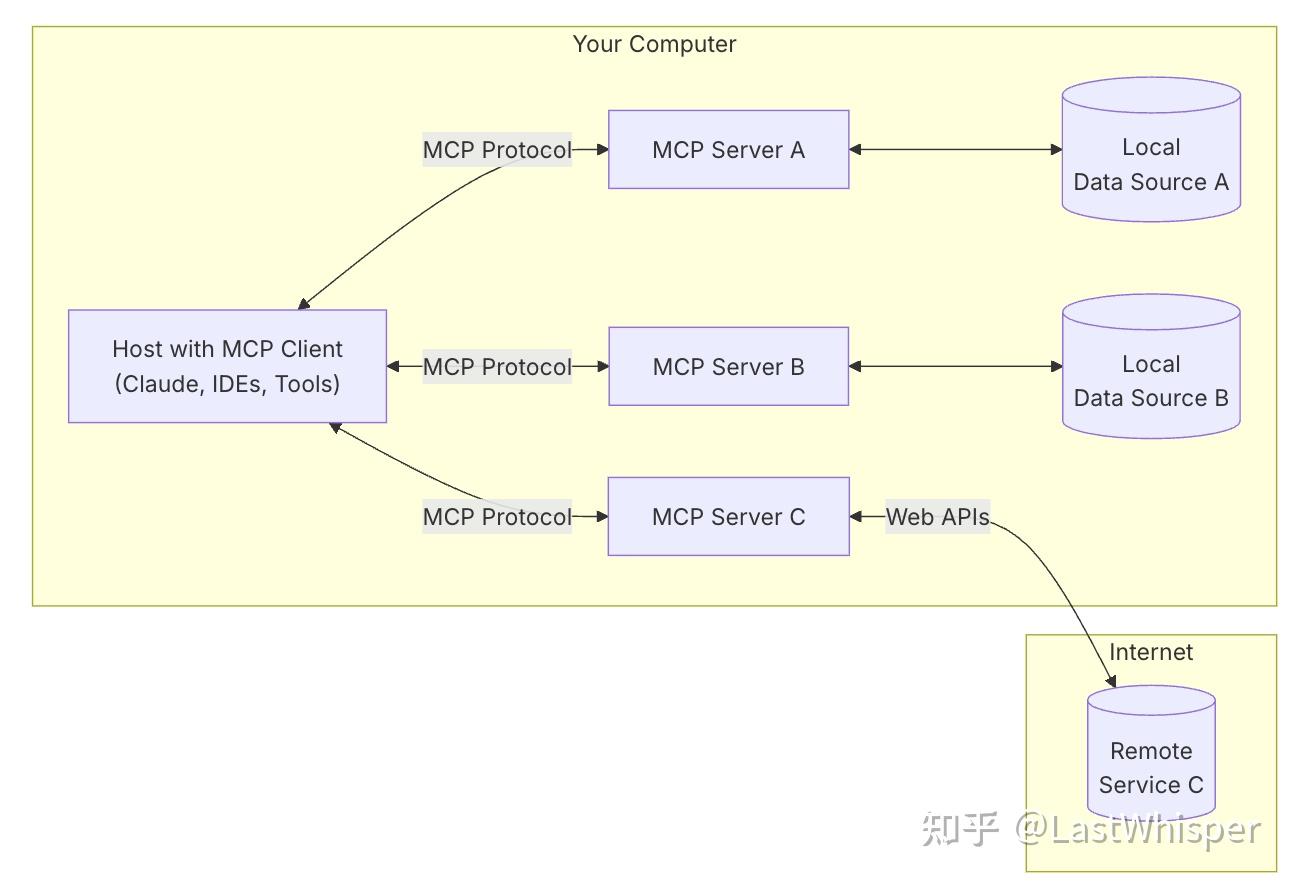
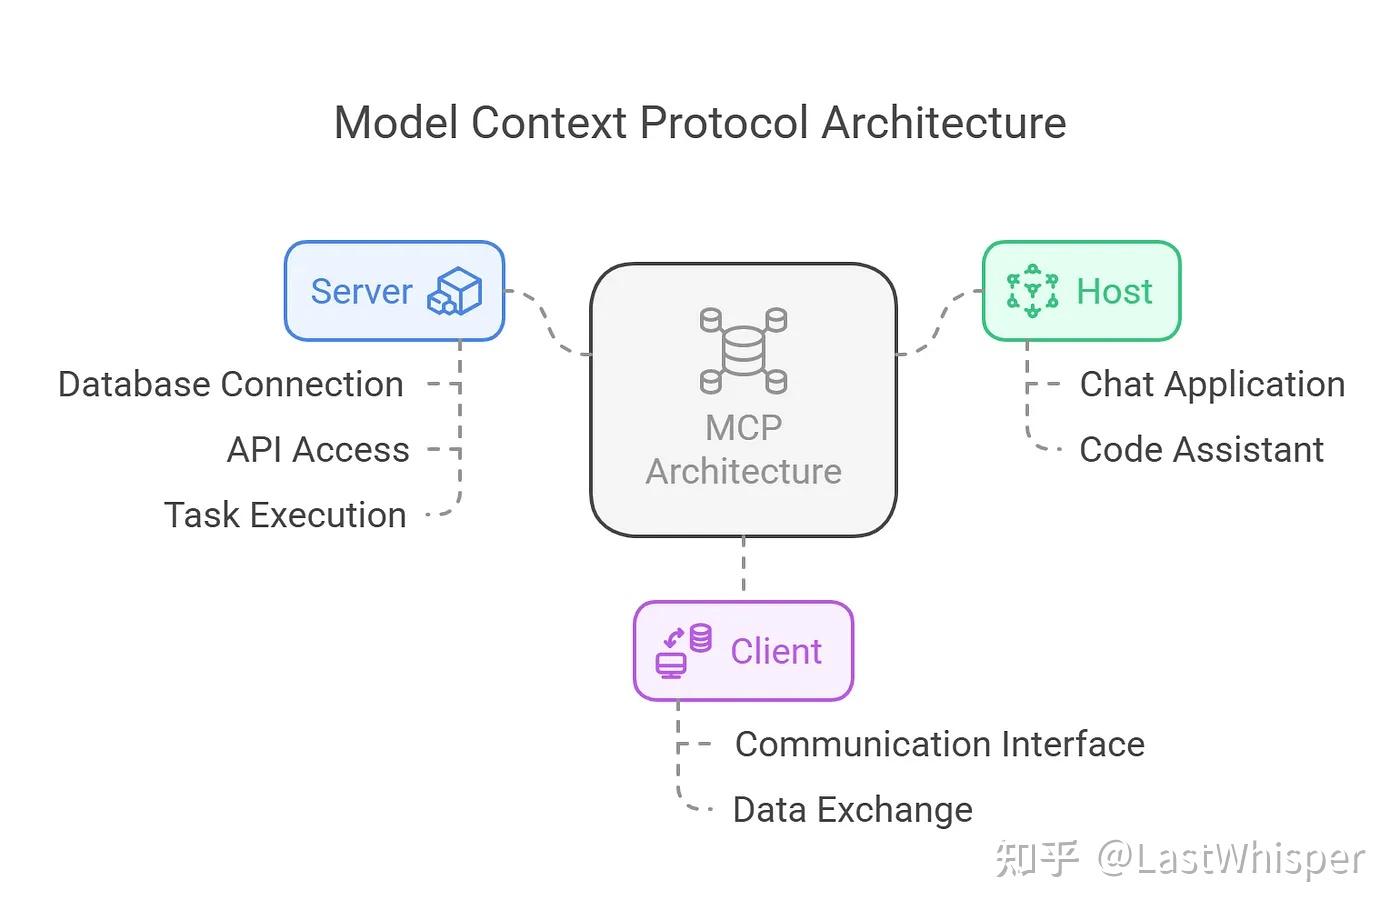
MCP 由三个核心组件构成:Host、Client 和 Server。让我们通过一个实际场景来理解这些组件如何协同工作:
假设你正在使用 Claude Desktop (Host) 询问:"我桌面上有哪些文档?"
- Host:Claude Desktop 作为 Host,负责接收你的提问并与 Claude 模型交互。
- Client:当 Claude 模型决定需要访问你的文件系统时,Host 中内置的 MCP Client 会被激活。这个 Client 负责与适当的 MCP Server 建立连接。
- Server:在这个例子中,文件系统 MCP Server 会被调用。它负责执行实际的文件扫描操作,访问你的桌面目录,并返回找到的文档列表。
整个流程是这样的:你的问题 → Claude Desktop(Host) → Claude 模型 → 需要文件信息 → MCP Client 连接 → 文件系统 MCP Server → 执行操作 → 返回结果 → Claude 生成回答 → 显示在 Claude Desktop 上。
这种架构设计使得 Claude 可以在不同场景下灵活调用各种工具和数据源,而开发者只需专注于开发对应的 MCP Server,无需关心 Host 和 Client 的实现细节。
模型如何决定使用的工具?
Claude(模型)是在什么时候确定使用哪些工具的呢?好在 Anthropic 为我们提供了详细的解释:
当用户提出一个问题时:
- 客户端(Claude Desktop / Cursor)将你的问题发送给 Claude。
- Claude 分析可用的工具,并决定使用哪一个(或多个)。
- 客户端通过 MCP Server 执行所选的工具。
- 工具的执行结果被送回给 Claude。
- Claude 结合执行结果构造最终的 prompt 并生成自然语言的回应。
- 回应最终展示给用户!
MCP Server 是由 Claude 主动选择并调用的。有意思的是 Claude 具体是如何确定该使用哪些工具呢?以及是否会使用一些不存在的工具呢(幻觉)?
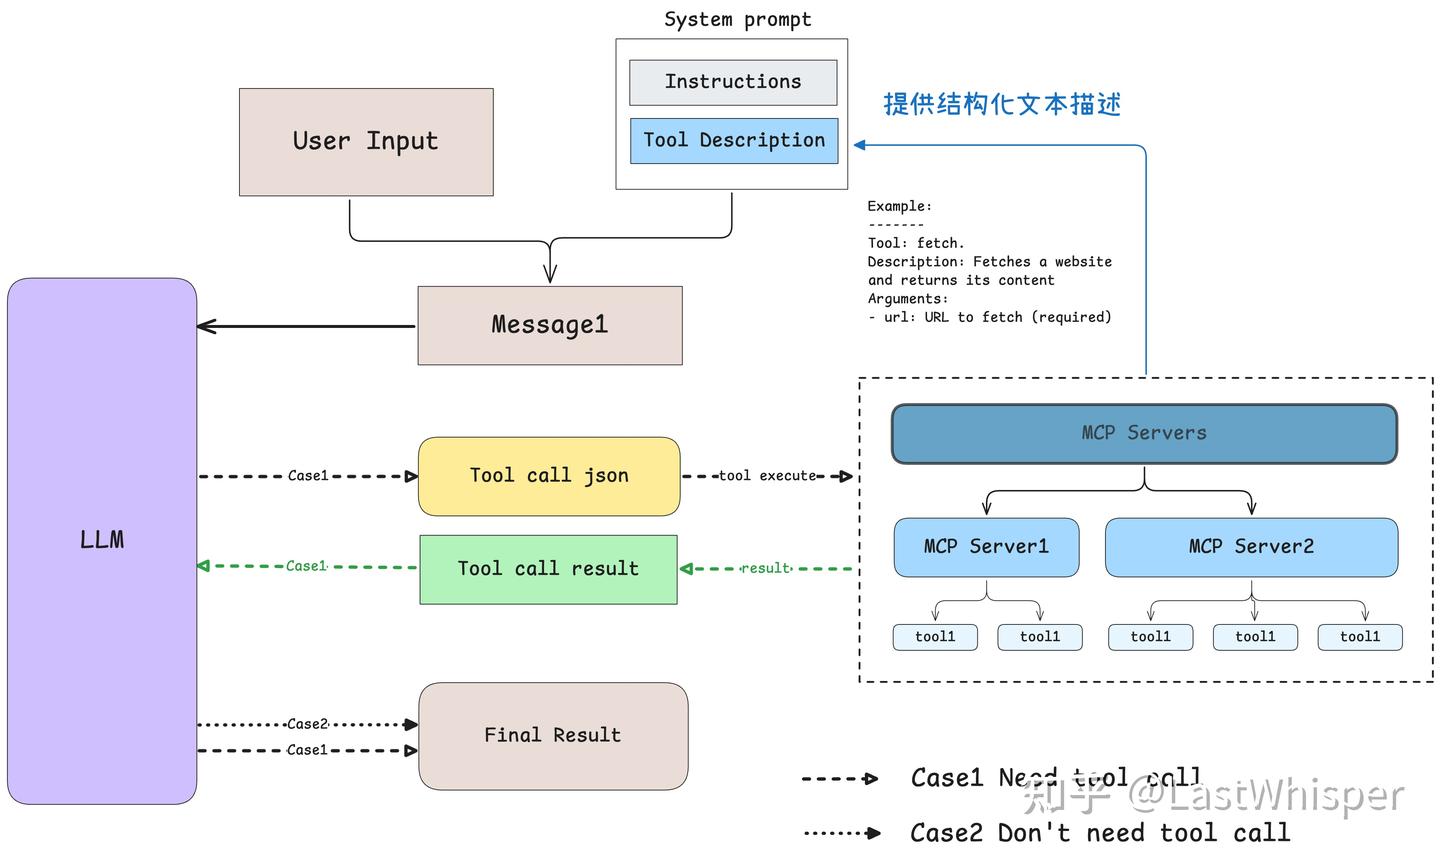
工具执行与结果反馈机制
其实工具的执行就比较简单和直接了。承接上一步,我们把 system prompt(指令与工具调用描述)和用户消息一起发送给模型,然后接收模型的回复。当模型分析用户请求后,它会决定是否需要调用工具:
- 无需工具时:模型直接生成自然语言回复。
- 需要工具时:模型输出结构化 JSON 格式的工具调用请求。
如果回复中包含结构化 JSON 格式的工具调用请求,则客户端会根据这个 json 代码执行对应的工具。具体的实现逻辑都在 process_llm_response 中,代码,逻辑非常简单。
如果模型执行了 tool call,则工具执行的结果 result 会和 system prompt 和用户消息一起**重新发送**给模型,请求模型生成最终回复。
如果 tool call 的 json 代码存在问题或者模型产生了幻觉怎么办呢?通过阅读代码 发现,我们会 skip 掉无效的调用请求。
执行相关的代码与注释如下:
 ... # 省略无关的代码
 async def start(self):
     ... # 上面已经介绍过了,模型如何选择工具

     while True:
         # 假设这里已经处理了用户消息输入.
         messages.append({"role": "user", "content": user_input})

         # 获取 LLM 的输出
         llm_response = self.llm_client.get_response(messages)

         # 处理 LLM 的输出(如果有 tool call 则执行对应的工具)
         result = await self.process_llm_response(llm_response)

         # 如果 result 与 llm_response 不同,说明执行了 tool call (有额外信息了)
         # 则将 tool call 的结果重新发送给 LLM 进行处理。
         if result != llm_response:
             messages.append({"role": "assistant", "content": llm_response})
             messages.append({"role": "system", "content": result})

             final_response = self.llm_client.get_response(messages)
             logging.info("\nFinal response: %s", final_response)
             messages.append(
                 {"role": "assistant", "content": final_response}
             )
         # 否则代表没有执行 tool call,则直接将 LLM 的输出返回给用户。
         else:
             messages.append({"role": "assistant", "content": llm_response})
结合这部分原理分析:
- 工具文档至关重要 - 模型通过工具描述文本来理解和选择工具,因此精心编写工具的名称、docstring 和参数说明至关重要。
- 由于 MCP 的选择是基于 prompt 的,所以任何模型其实都适配 MCP,只要你能提供对应的工具描述。但是当你使用非 Claude 模型时,MCP 使用的效果和体验难以保证(没有做专门的训练)。