如何形成自已的凭据字典
收集前人开源的字典
我们主要要打造一个好用的用户名字典,但是量级也不能太夸张,不然会拖累效率。我们首先基于前人的各种字典项目,打造一个字典的“基础”。这里我举一些例子,包括但不限于如下:
https://github.com/danielmiessler/SecLists
https://github.com/TheKingOfDuck/fuzzDicts
https://github.com/insightglacier/Dictionary-Of-Pentesting
https://github.com/a3vilc0de/PentesterSpecialDict
https://github.com/CrackerCat/SuperWordlist
https://github.com/cpkkcb/fuzzDicts
https://github.com/huyuanzhi2/password_brute_dictionary
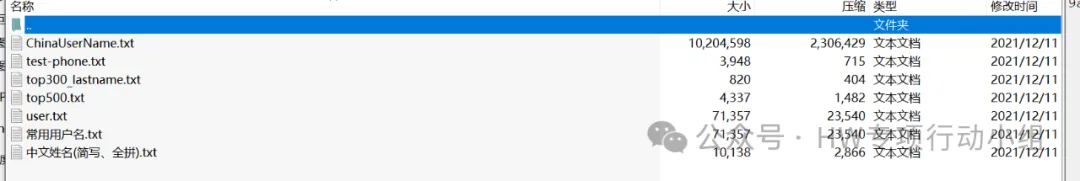
实际上还有挺多的,微信公众号或者其它搜索引擎搜索“渗透 字典”这样的关键词,还能找到很多。这里不一一列举了。我们下载回来之后,找到用户名相关的字典。一般能看到多种长度的,从几百条的小型字典,到十几万条的超大型字典。
字典合并去重
我们接下来要做的事就是把所有比较小的字典做一个合并去重。比如几百条,几千条,小几万条的那种用户名字典,我们给它统统做一个合并去重。注意千万不要选择那种大几万条甚至十几万条的大字典也进行合并去重,否则我们最后的字典会究极臃肿。
import os
import argparse


def collect_txt_files(directory):
    txt_files = []
    for root, _, files in os.walk(directory):
        for file in files:
            if file.lower().endswith('.txt'):
                txt_files.append(os.path.join(root, file))
    return txt_files


def deduplicate_txt_files(txt_files):
    unique_lines = set()
    for file_path in txt_files:
        with open(file_path, 'r', encoding='utf-8') as f:
            for line in f:
                unique_lines.add(line.rstrip('\n\r'))
    return unique_lines


def main():
    parser = argparse.ArgumentParser(description='Deduplicate dictionary txt files in a directory.')  # noqa
    parser.add_argument('-d', '--directory', required=True, help='Directory to search for txt files')  # noqa
    parser.add_argument('-o', '--output', default='deduplicated.txt', help='Output file name(default is deduplicated.txt)')  # noqa
    args = parser.parse_args()

    txt_files = collect_txt_files(args.directory)
    if not txt_files:
        print('No txt files found in the specified directory.')
        return

    unique_lines = deduplicate_txt_files(txt_files)
    with open(args.output, 'w', encoding='utf-8') as out_file:
        for line in sorted(unique_lines):
            out_file.write(line + '\n')
    print(f'Deduplication complete. {len(unique_lines)} unique lines saved to {args.output}.')  # noqa


if __name__ == '__main__':
    main()
针对性扩展
这样做完合并之后,我们就打造好了一个字典的“基础”,这时候已经可以用了,但是我们下面要做一些针对性补充,添加一些数据,让它变得更好用。
姓名缩写补充
第一个补充措施是,我们要往里添加两位英文字符排列组合(aa-zz)+三位英文字符排列组合(aaa-zzz)相关的字符串
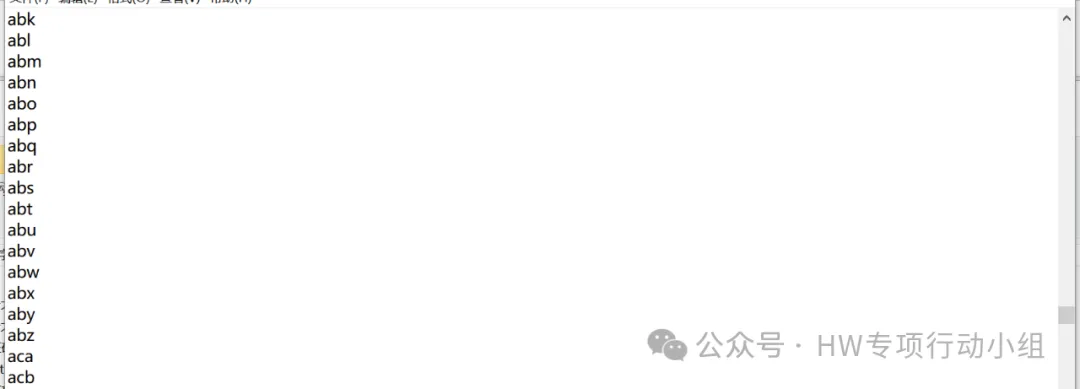
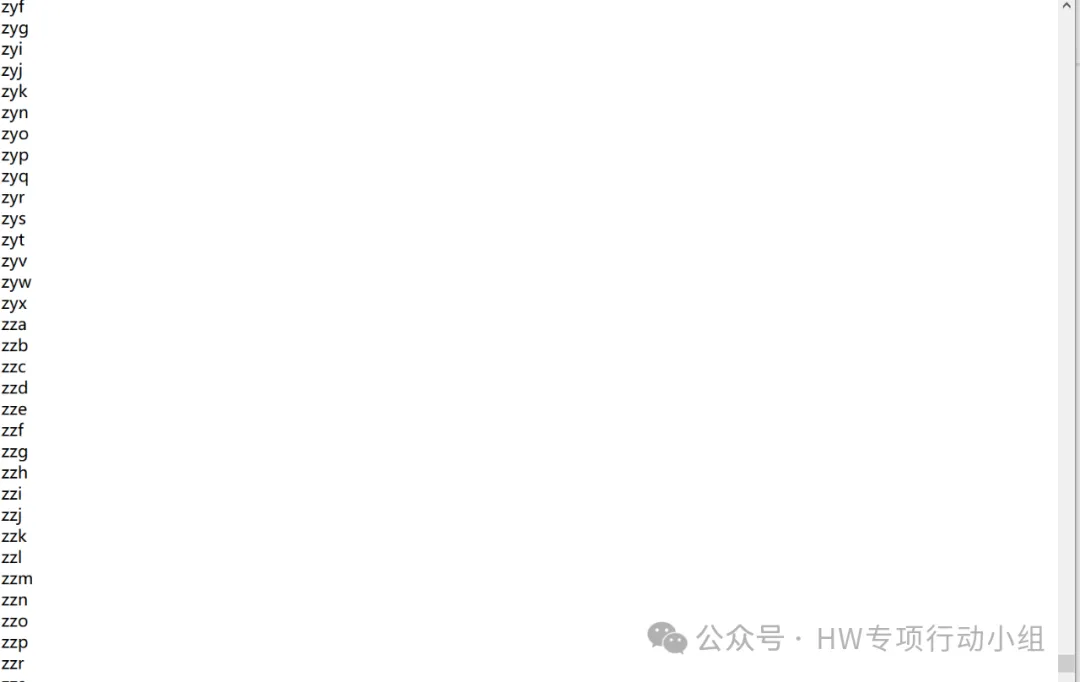
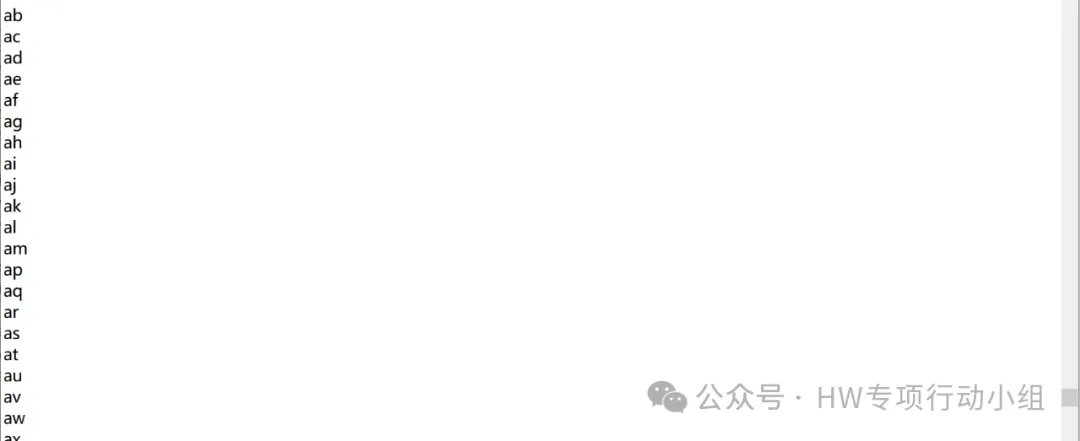
这样排列组合的字符串很好生成,可以让GPT帮你写一个脚本去生成,最后生成出来的数量级大概接近2w条。
这么做的目的是什么呢?这个主要是符合国内用户的一个经典习惯。比如我的名字叫张伟,那我的用户名很可能就写成zw,我叫张谋仁,可能用户名就写成zmr。可以看到,最常见的二字或三字姓名,在这种规则下就会被缩写成两位英文字母的组合或三位英文字母的组合。因此我们只要排列组合出所有的可能性,就能完全覆盖这种规则下的用户名。
import string


def generate_abbreviations():
    letters = string.ascii_lowercase
    abbreviations = []

    # Two-letter abbreviations: aa - zz
    for a in letters:
        for b in letters:
            abbr = a + b
            abbreviations.append(abbr)           # 全小写
            abbreviations.append(abbr.upper())   # 全大写
            # abbreviations.append(abbr.capitalize())  # 首字母大写

    # Three-letter abbreviations: aaa - zzz
    for a in letters:
        for b in letters:
            for c in letters:
                abbr = a + b + c
                abbreviations.append(abbr)           # 全小写
                abbreviations.append(abbr.upper())   # 全大写
                # abbreviations.append(abbr.capitalize())  # 首字母大写

    return abbreviations


def save_to_txt(filename, abbreviations):
    with open(filename, 'w', encoding='utf-8') as f:
        for abbr in abbreviations:
            f.write(abbr + '\n')


if __name__ == "__main__":
    abbrs = generate_abbreviations()
    save_to_txt('abbreviations.txt', abbrs)
    print(f"Generated {len(abbrs)} abbreviations and saved to 'abbreviations.txt'.")  # noqa
姓名拼音补充
第二个补充措施是,我们可以尽可能多收集国内常见的姓名的拼音形式,比如上面提到的张伟,用户名可能就是zhangwei,很好理解。这个各种字典项目里应该也有,也很容易找到
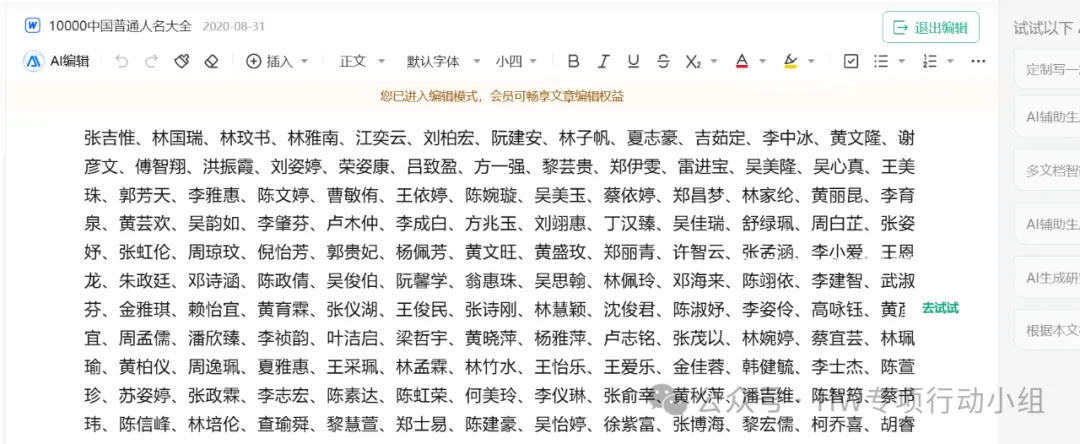
还可以搜集常见的中文人名,然后用python的pypinyin之类的库把中文人名转化为拼音,问GPT就完事
除了根据现有的这些项目去搜集,还可以根据公安部的一些姓名调查报告去进一步完善:
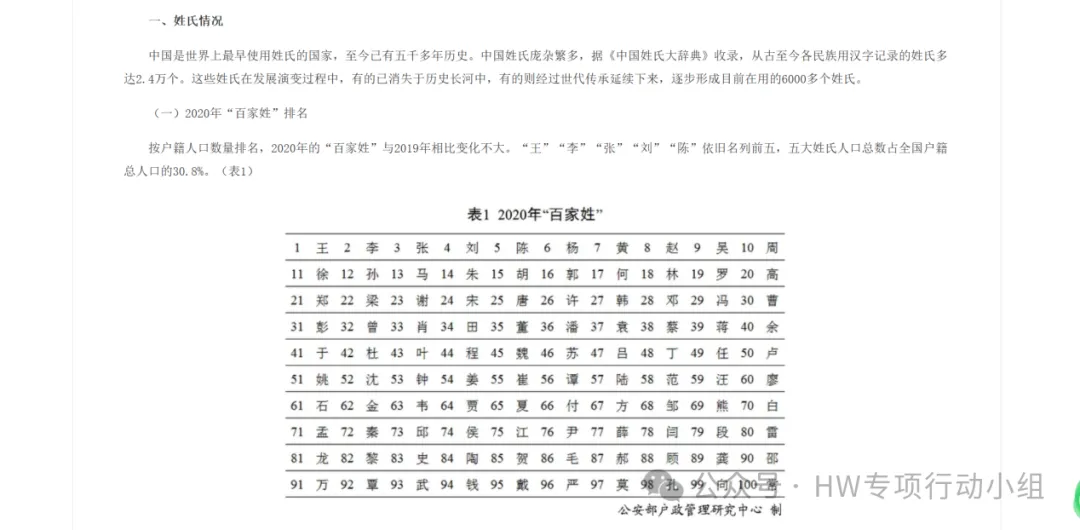
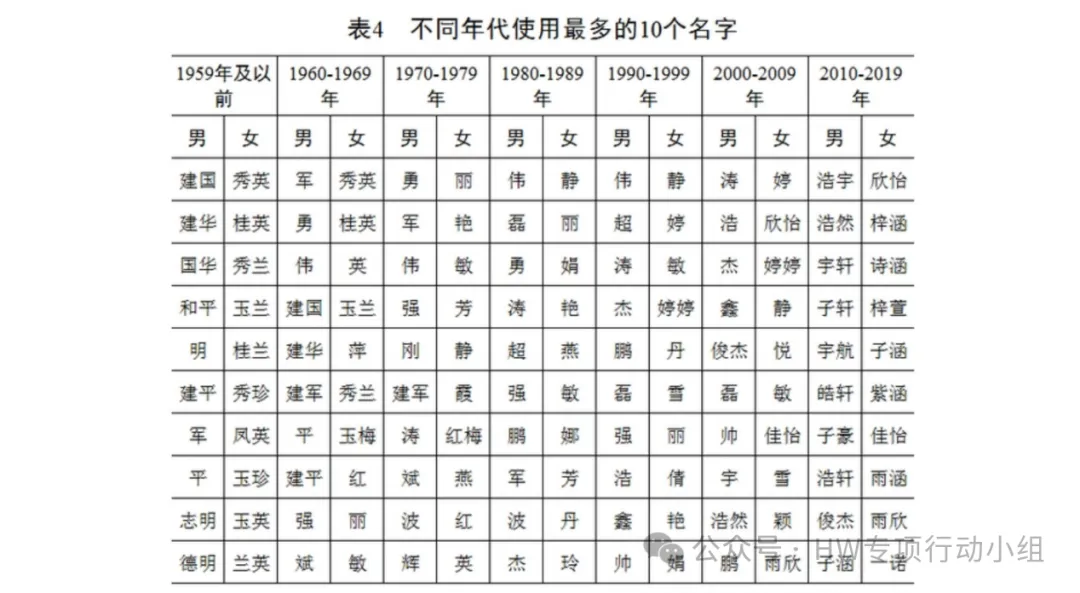
将常见姓和名转化成拼音,进行排列组合。这样补充数据是为了覆盖用户名是拼音的情况,当然汉字博大精深,我们这样收集到的也只是比较小的一部分,够用就行。
# 王、李、张、刘、陈、杨、黄、赵、吴、周
MOST_USE_SURNAME_TOP_10 = ["wang", "li", "zhang", "liu", "chen",
                           "yang", "huang", "zhao", "hao", "zhou"]


# https://www.namechef.co/cn/popular-chinese-names/china/
# most use name top 10 is 张伟、王伟、王芳、李伟、王秀英、李秀英、李娜、张秀英、刘伟和张敏
MOST_USE_NAME_TOP_208 = [
    "junjie", "zihan",
    "yuxuan", "xinyi",
    "bowen", "xinyi",
    "haoran", "tingting",
    "haoyu", "jingjing",
    "yiming", "jingyi",
    "wentao", "kexin",
    "zhiyuan", "jiajia",
    "zeyu", "jiaqi",
    "zhenyu", "lina",
    "zixuan", "zihan",
    "yuhang", "jiayi",
    "wenbo", "anqi",
    "zihao", "jiayi",
    "tianyu", "yutong",
    "xiangyu", "yuanyuan",
    "siyuan", "siqi",
    "jiahao", "yuqing",
    "wenxuan", "mengyao",
    "siyu", "jiali",
    "wenjie", "yujie",
    "yifan", "yuxuan",
    "yuxiang", "yuxin",
    "jiale", "xinyue",
    "yifan", "jiaxin",
    "zixuan", "ziqi",
    "haiyang", "yaqi",
    "xinyu", "yingying",
    "zhiwei", "xiaotong",
    "chenyang", "yuting",
    "siyuan", "jiahui",
    "wenbin", "mengqi",
    "zihao", "huimin",
    "pengfei", "yuxuan",
    "wentao", "yufei",
    "junyu", "shanshan",
    "zhihao", "shiyu",
    "weijie", "jingwen",
    "yuchen", "jiaxin",
    "jiahao", "zihan",
    "zijian", "jiaqi",
    "yifan", "dandan",
    "jiale", "haiyan",
    "wenbin", "shanshan",
    "zhiyuan", "kexin",
    "xingyu", "wenjing",
    "wenhao", "mengting",
    "zhipeng", "yiran",
    "zhijie", "yuhan",
    "zilong", "yutong",
    "zirui", "xinyan",
    "zhiqiang", "yuting",
    "yuhao", "xinxin",
    "zijie", "xinran",
    "wenlong", "jiahui",
    "kaiwen", "ziqi",
    "jiajun", "chenchen",
    "yuheng", "jiaying",
    "chenxi", "ziyi",
    "yinuo", "wanting",
    "yunpeng", "siying",
    "shijie", "yawen",
    "xudong", "zixin",
    "xingyu", "xinyu",
    "yingjie", "ruixue",
    "weihao", "zimeng",
    "haoran", "xinyu",
    "haitao", "wenting",
    "hongyu", "shihan",
    "zirui", "siyu",
    "xiaolong", "mingyue",
    "sirui", "xinyue",
    "haifeng", "xiaoyan",
    "yangyang", "qianqian",
    "xinyu", "lijuan",
    "yuchen", "shiqi",
    "junfeng", "yuchen",
    "qingqing", "lingling",
    "jiawei", "xinyi",
    "yuxin", "ruohan",
    "wenjun", "jiaqi",
    "zimo", "yawen",
    "guodong", "shiya",
    "hongwei", "ziqing",
    "haonan", "sisi",
    "junwei", "miaomiao",
    "junhao", "yuanyuan",
    "junhui", "jiale",
    "haowen", "lixia",
    "wenjun", "xiaoxue",
    "jiawei", "yujia",
    "haoming", "yuping",
    "zhenxuan", "yuxin",
    "junxi", "danni",
    "wenhao", "yaxuan",
    "zhixuan", "yuhan",
    "zihao", "yuhan",
    "jianan", "xuemei",
    "yunfei", "yiting",
    "siqi", "siqi",
    "wei", "fang",
    "xiuying", "na",
    "la", "min",
    "ming", "xiao",
]


def main():
    # 去重
    surnames = sorted(set(MOST_USE_SURNAME_TOP_10))
    names = sorted(set(MOST_USE_NAME_TOP_208))

    # 拼接
    full_names = []
    for surname in surnames:
        for name in names:
            full_names.append(surname + name)

    # 保存
    with open("name_pinyin_dict.txt", "w", encoding="utf-8") as f:
        for item in full_names:
            f.write(item + "\n")
    print(f"已生成 {len(full_names)} 条姓名拼音,保存至 name_pinyin_dict.txt")


if __name__ == "__main__":
    main()
这种情况还有一个变种,那就是我们可以搜集五百个或者一千个左右的常见中文名(更多点也无所谓,能找到就行),注意是中文名不是拼音,然后对其进行url编码
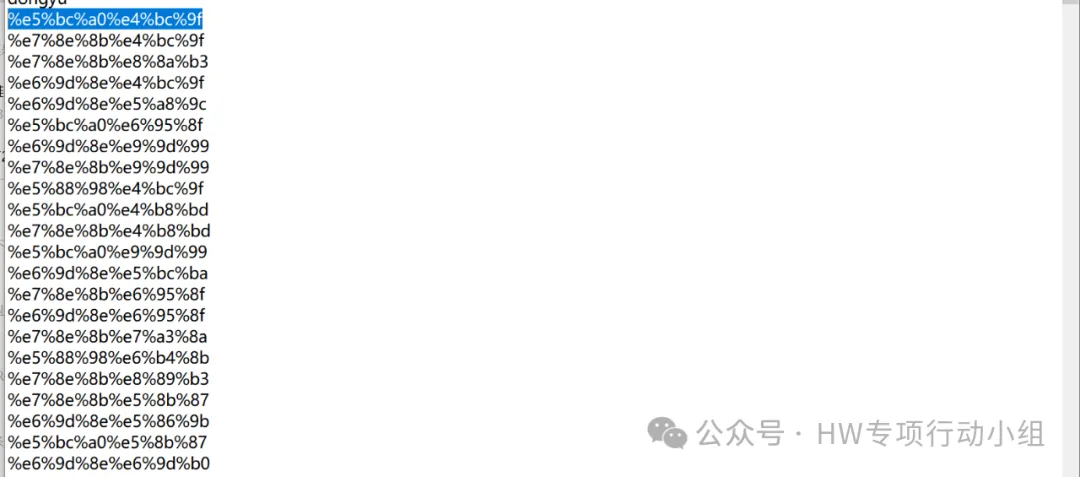
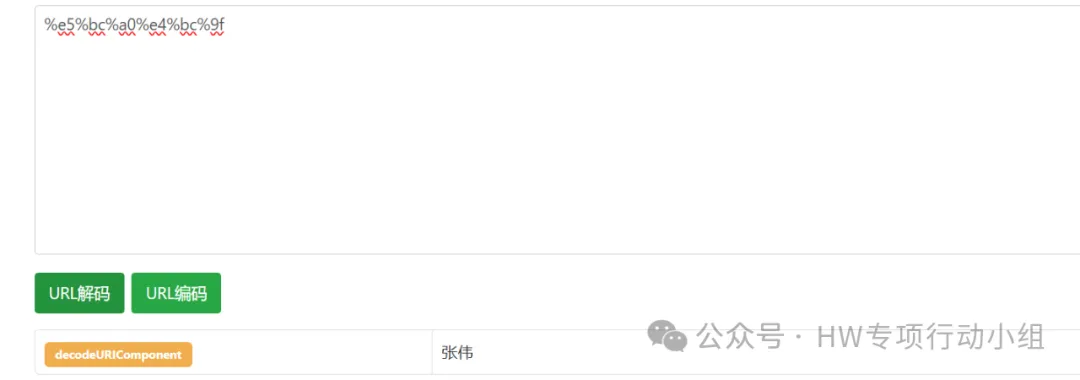
这是为了对抗使用中文名作为用户名的情况。我发现一些比较老的系统真就挺喜欢用中文名作为用户名的。
常见英文用户名补充
第三个补充措施和英文用户名、英文单词有关,我们可以搜集一些常见的英文单词(尤其是名词)添加到字典里,上面的各种字典项目里应该也有一些常见英文用户名,添加进我们的字典里即可。
测试手机号补充
第四个补充措施和测试手机号有关,
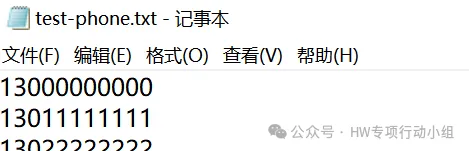
这个项目里有一个test-phone字典,里面都是一些常见测试手机号,比如13888888888等等,很多系统的用户需要填手机号,并且可以把手机号作为用户名去登录,你会发现很多管理员和测试用户的手机号一般都是13888888888这种
简单ID和编号补充
第五个补充措施是一些用户id和简单的编号,这个不需要太多,比如001、0001、111111这类
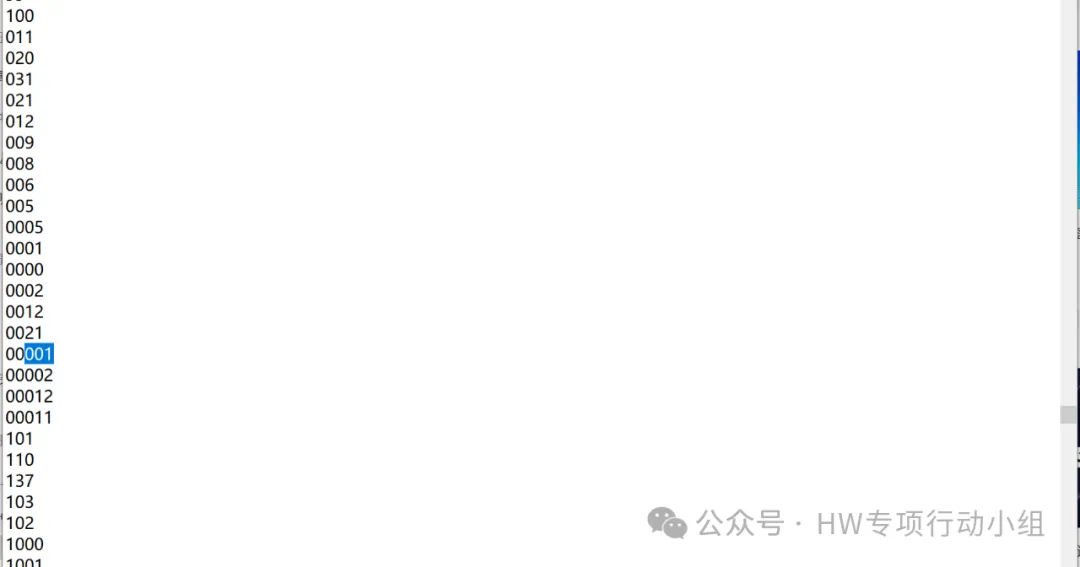
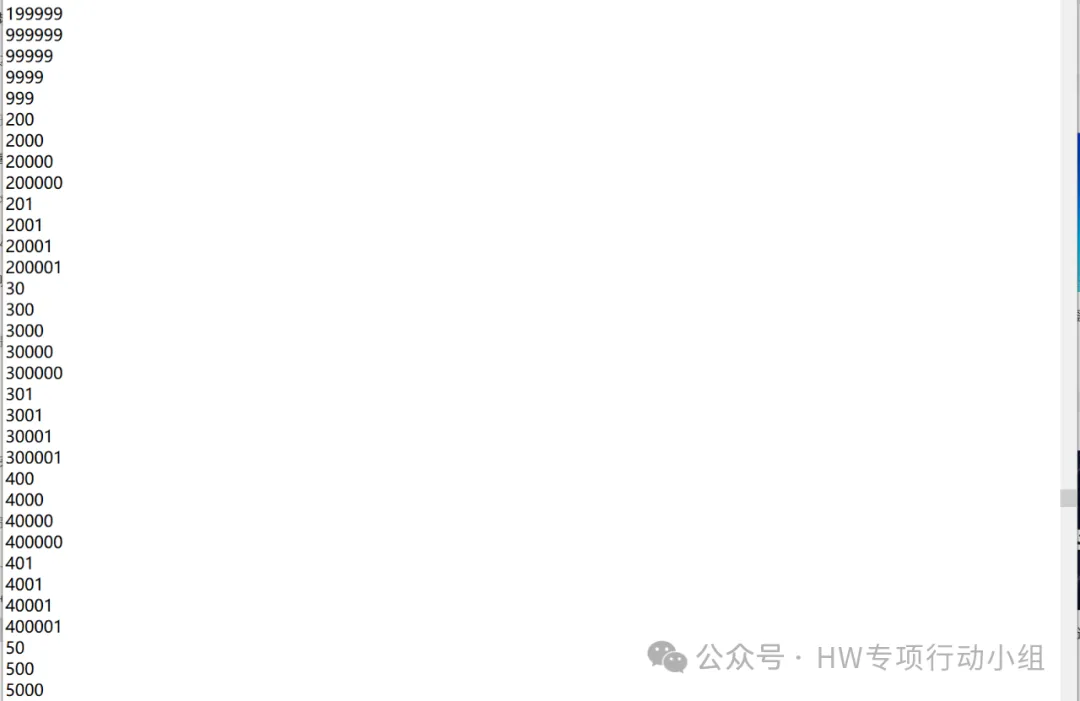
主要是1和0的位置去排列组合。这个是应付一些数字编号(比如工号)、用户id作为用户名的场景。
常用用户名加编号扩充
第六个补充措施是对一些常见用户名进行拓展,什么意思呢,比方说admin、test用户,实际上常见的不只是admin、test,还有
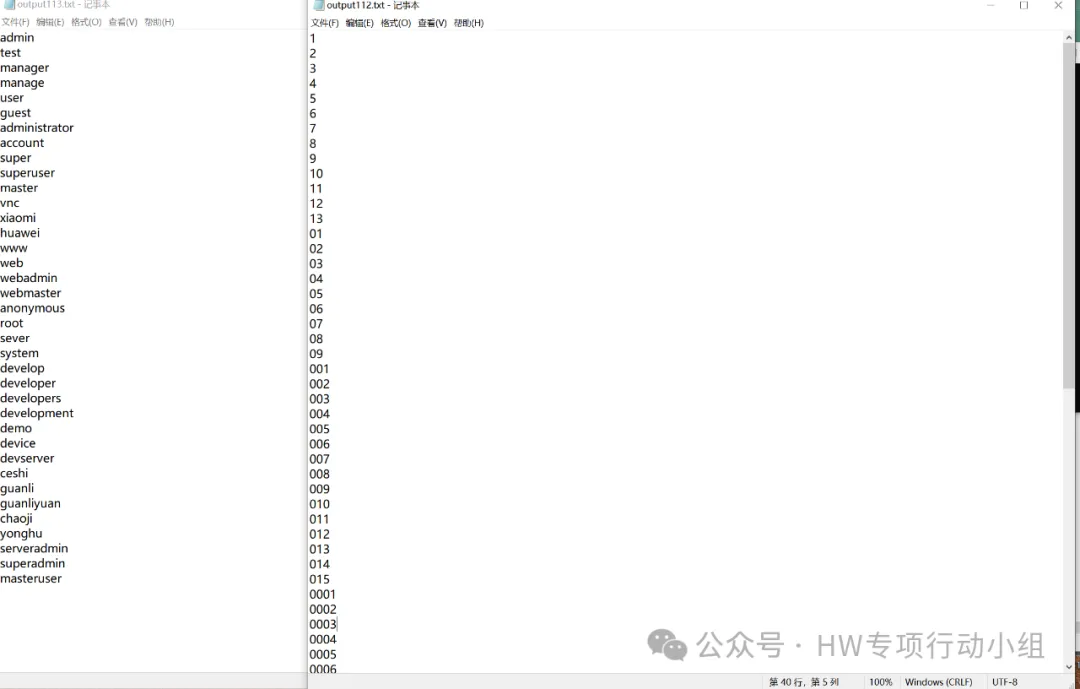
对上面的字典进行排列组合即可。
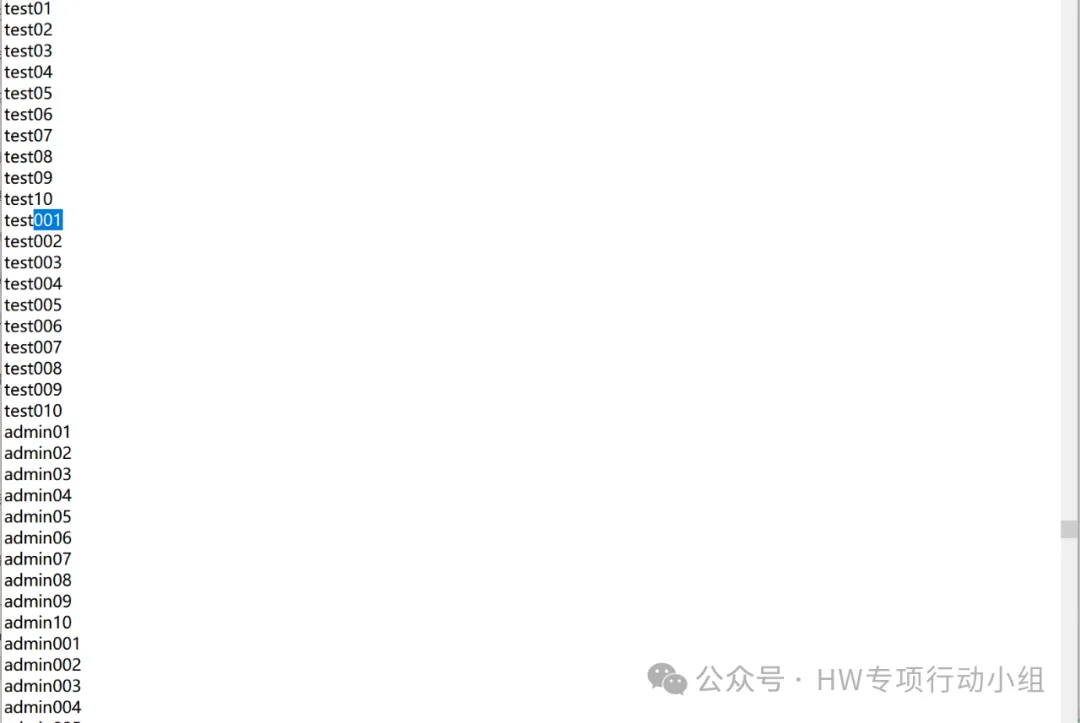
这个可以从top500之类的字典作为基础,往每一行字符后面拼接1 01 001 123之类的数字,很ez的。
有规律的密码扩充
键盘规律
简单来说是键盘顺序排列组合的一些密码。比如
也可能是九宫格位置相关的一些密码,比如笔者就见过
乍一看这种不像是常规弱口令。但实际上还真是,456852是数字九宫格中间的十字,159753则是九宫格斜线交叉。
这种就有点抽象而且很考验想象力了,QWER1234这种一般的字典里应该有,但是再复杂一点的键盘顺序就不一定有了。
关键用户名+数字(年份)/关键用户名+特殊符号+数字(年份)
典型例子有
等等。
REGULAR_USERNAME = [
    "admin",
    "administrator",
    "root",
    "user",
    "guest",
    "test",
    "info",
    "support",
    "webmaster",
    "contact",
    "service",
    "sales",
    "marketing",
    "help"
]

COMMON_SPECIAL_CHAR = [
    "!",
    "@",
    "#",
    "$",
    "%"
]

COMMON_SUFFIX = [
    "1",
    "2",
    "3",
    "01",
    "02",
    "03",
    "123",
    "456",
    "789",
    "000",
    "001",
    "002",
    "003",
    "0001",
    "0002",
    "0003",
    "111",
    "222",
    "1234",
    "12345",
    "123456",
    "1234567",
    "12345678",
    "123456789",
    "abc",
    "qwe",
    "xyz",
    "pass",
    "welcome",
    "iloveyou"
]

REGULAR_YEARS = [
    "2025",
    "2024",
    "2023",
    "2022",
    "2021",
    "2020",
    "2019",
    "2018",
    "1949",
    "1978",
    "2003"
]

REGULAR_KEYBOARD_PASSWD = [
    "qwerty",
    "qweasdzxc",
    "qwertyuiop",
    "asdfghjkl",
    "zxcvbnm",
    "159753",
    "159357",
    "753159",
    "753951",
    "456852",
    "456258",
    "654258",
    "654852",
    "123123",
    "123321",
    "123456",
    "666666",
    "7895123",
    "3215987",
    "135798462",
    "795134862",
    "88888888",
    "1234567"
    "12345678"
    "123456789",
    "1234567890",
]


def create_regular_pass1() -> set[str]:
    # REGULAR_USERNAME + COMMON_SPECIAL_CHAR + COMMON_SUFFIX
    regular_pass = set()

    for username in REGULAR_USERNAME:
        for special_char in COMMON_SPECIAL_CHAR:
            for suffix in COMMON_SUFFIX:
                regular_pass.add(f"{username}{special_char}{suffix}")
                regular_pass.add(f"{username}{suffix}{special_char}")
                regular_pass.add(f"{username.capitalize()}{special_char}{suffix}")  # noqa
                regular_pass.add(f"{username.capitalize()}{suffix}{special_char}")  # noqa
                regular_pass.add(f"{username}{special_char}{suffix[::-1]}")
                regular_pass.add(f"{username}{suffix[::-1]}{special_char}")

    return regular_pass


def create_regular_pass2() -> set[str]:
    # REGULAR_USERNAME + COMMON_SPECIAL_CHAR + REGULAR_YEARS
    regular_pass = set()

    for username in REGULAR_USERNAME:
        for special_char in COMMON_SPECIAL_CHAR:
            for year in REGULAR_YEARS:
                regular_pass.add(f"{username}{special_char}{year}")
                regular_pass.add(f"{username.capitalize()}{special_char}{year}")
                regular_pass.add(f"{username}{year}")
                regular_pass.add(f"{username.capitalize()}{year}")
    return regular_pass


def main():
    regular_pass1 = create_regular_pass1()
    regular_pass2 = create_regular_pass2()

    # 合并两个集合
    all_regular_pass = regular_pass1.union(regular_pass2)

    # 添加键盘密码
    all_regular_pass.update(REGULAR_KEYBOARD_PASSWD)

    # 保存到文件
    with open("regular_passwords.txt", "w", encoding="utf-8") as f:
        for password in sorted(all_regular_pass):
            f.write(password + "\n")

    print(f"共生成 {len(all_regular_pass)} 个常规密码,已保存到 regular_passwords.txt")


if __name__ == "__main__":
    main()
专门的社工字典
这个主要是针对密码爆破的,建议把上面的常规流程走完,再来搞这个。简单来说,当我们上面的流程没什么收获,但是我们又要对高价值用户进行密码爆破(如admin、root等用户)的时候,可以考虑这个流程。
可以通过目标公司名或域名关键词、年份、数字、特殊字符去生成目标专属的密码字典