HTTP解析
概念
协议是指计算机通信网络中两台计算机之间进行通信所必须共同遵守的规定或规则,超文本传输协议(HTTP)是一种通信协议,它允许将超文本标记语言(HTML)文档从Web服务器传送到客户端的浏览器。
HTTP协议,即超文本传输协议(Hypertext transfer protocol)。是一种详细规定了浏览器和万维网(WWW = World Wide Web)服务器之间互相通信的规则,通过因特网传送万维网文档的数据传送协议。
HTTP协议是用于从WWW服务器传输超文本到本地浏览器的传送协议。它可以使浏览器更加高效,使网络传输减少。它不仅保证计算机正确快速地传输超文本文档,还确定传输文档中的哪一部分,以及哪部分内容首先显示(如文本先于图形)等。
HTTP是一个应用层协议,由请求和响应构成,是一个标准的客户端服务器模型。HTTP是一个无状态的协议。
在Internet中所有的传输都是通过TCP/IP进行的。HTTP协议作为TCP/IP模型中应用层的协议也不例外。HTTP协议通常承载于TCP协议之上,有时也承载于TLS或SSL协议层之上,这个时候,就成了我们常说的HTTPS。如下图所示:
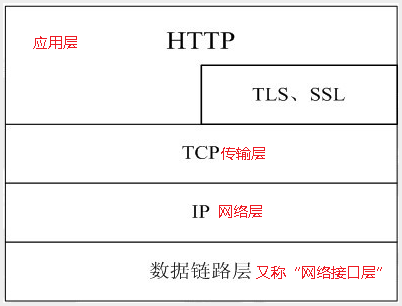
HTTP默认的端口号为80,HTTPS的端口号为443。
浏览网页是HTTP的主要应用,但是这并不代表HTTP就只能应用于网页的浏览。HTTP是一种协议,只要通信的双方都遵守这个协议,HTTP就能有用武之地。比如咱们常用的QQ,迅雷这些软件,都会使用HTTP协议(还包括其他的协议)。
统一资源定位符
URL 的一般形式是:
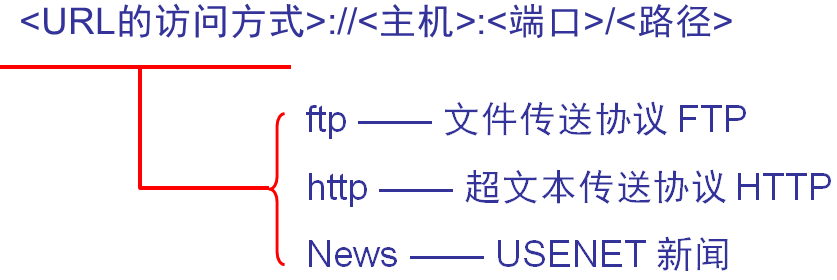
HTTP 的操作过程
- 每个Web站点都运行一个服务器进程,它不断地监听TCP的端口80,以便发现是否有向它发来连接请求;
- 一旦收到请求并建立了TCP连接之后,浏览器就向服务器发出某个页面的请求,服务器接着就返回请求的页面作响应;
- 最后连接被释放。这之间一系列信息的传输都遵循HTTP。
Web工作过程
**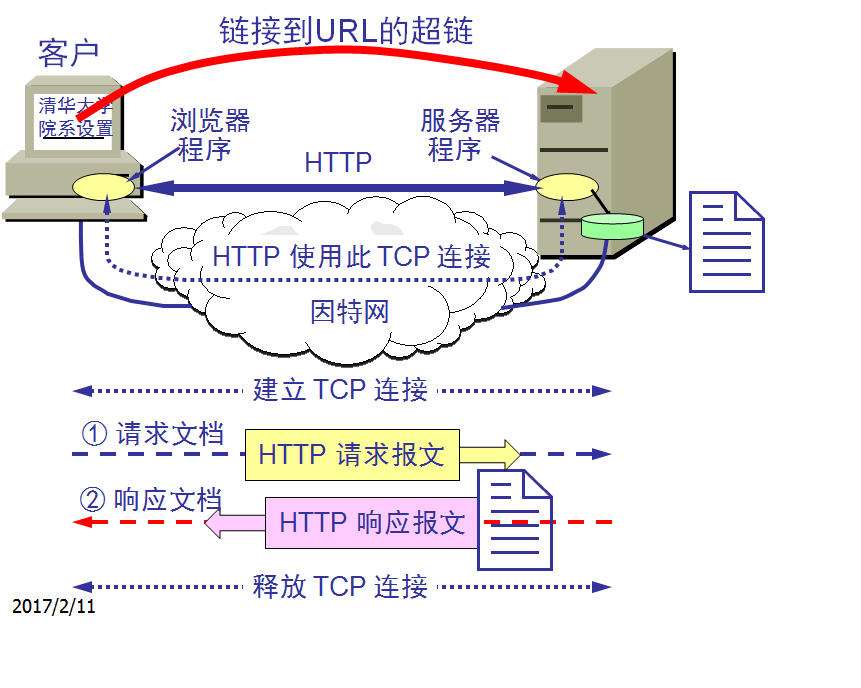
上图用户点击鼠标后所发生的事件:
-
浏览器分析超链指向页面的 URL;
-
浏览器向 DNS 请求解析 www.tsinghua.edu.cn 的 IP 地址;
-
域名系统 DNS 解析出清华大学服务器的 IP 地址;
-
浏览器与服务器建立 TCP 连接;
-
浏览器遵循HTTP协议发出取文件请求;
6.服务器给出响应,把文件 index.htm 发给浏览器;
7.TCP 连接释放;
8.浏览器显示“清华大学院系设置”文件 index.htm 中的所有文本。
HTTP 的报文种类
HTTP 有两类报文:
-
请求报文——从客户向服务器发送请求报文。
-
响应报文——从服务器到客户的回答。
HTTP 的报文结构
请求报文
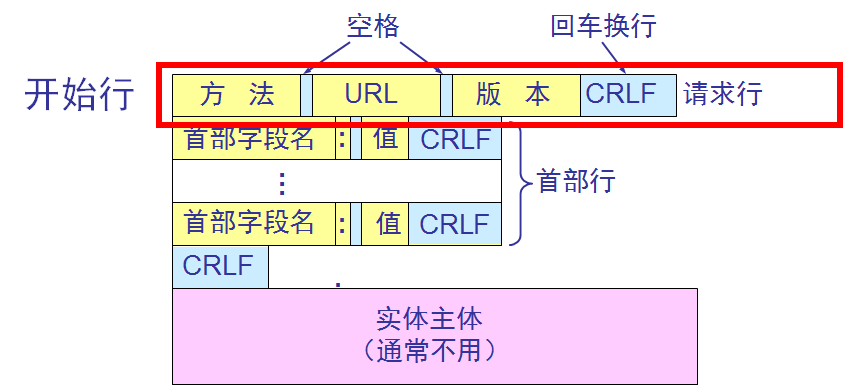
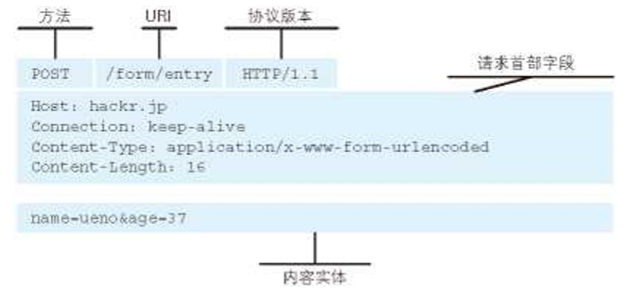
报文由三个部分组成,即**开始行、首部行和实体主体**。
在请求报文中,开始行就是请求行。
方法
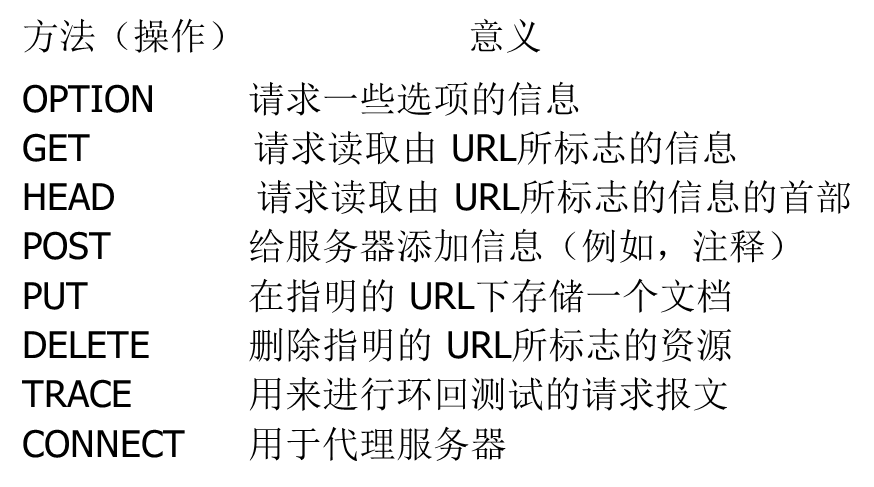
“方法”是面向对象技术中使用的专门名词。所谓“方法”就是对所请求的对象进行的操作,因此这些方法实际上也就是一些命令。因此,请求报文的类型是由它所采用的方法决定的。
HTTP 请求报文的一些方法
URL
“URL”是所请求的资源的 URL。
版本
“版本”是 HTTP 的版本。
一个请求报文的例子
响应报文
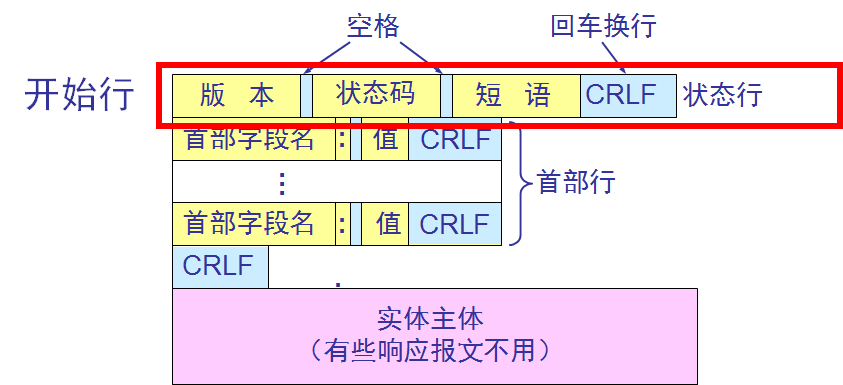
响应报文的开始行是状态行。
状态行包括三项内容,即 HTTP 的版本,状态码,以及**解释状态码的简单短语**。
状态码都是三位数字 :
- 1xx 表示通知信息的,如请求收到了或正在进行处理。
- 2xx 表示成功,如接受或知道了。
- 3xx 表示重定向,表示要完成请求还必须采取进一步的行动。
- 4xx 表示客户的差错,如请求中有错误的语法或不能完成。
- 5xx 表示服务器的差错,如服务器失效无法完成请求。
一个响应报文的例子:
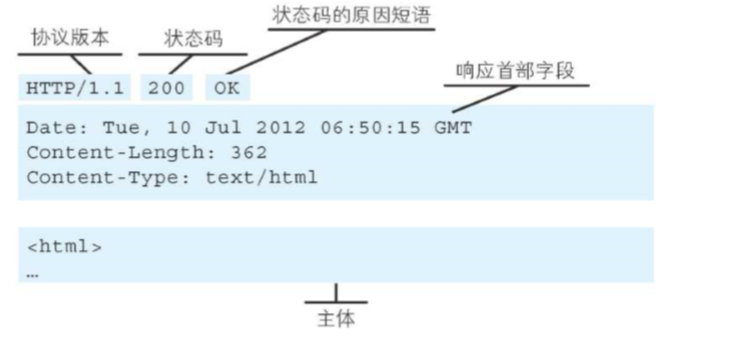
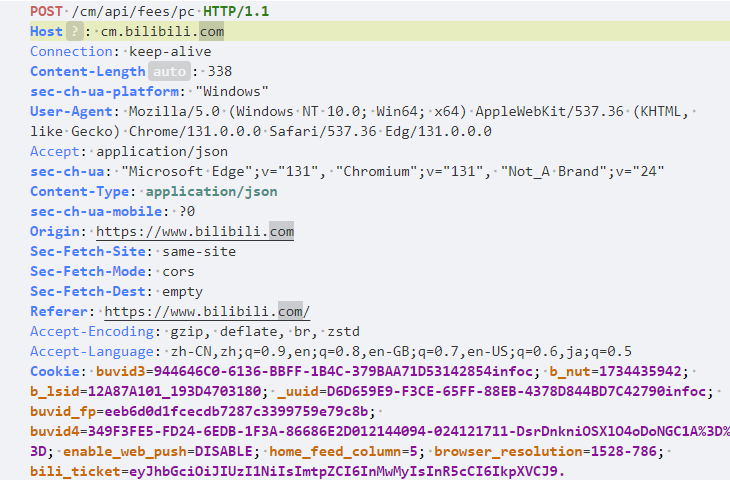
使用WireShark实例分析
下面是一个用wireShark获取的http协议包:
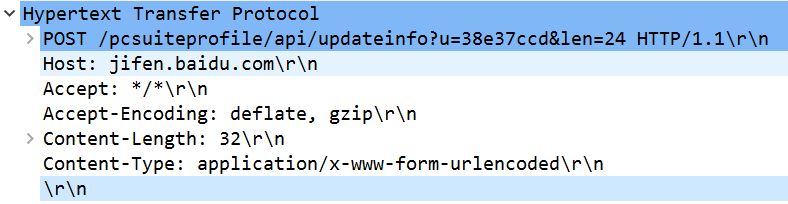
可以看到这是post方法
url:/pcsuiteprofile/api/updateinfo?u=38e37ccd&len=24
版本:HTTP/1.1  \r\n:回车换行
首部字段:Host、Accept、Content-Type、Content-Length等等。
展开Post,具体分析,如图:
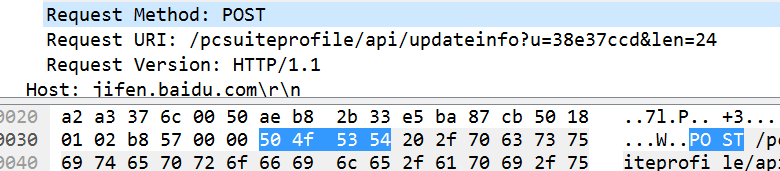
选中post,下边的16进制中显示的是:50 4f 53 54正好是POST四个字母对应的16进制ASCII,可以自行去对比ASCII。
使用 Cookie 的状态管理
HTTP 是无状态协议,它不对之前发生过的请求和响应的状态进行管理。也就是说,无法根据之前的状态进行本次的请求处理。
Cookie 技术通过在请求和响应报文中写入 Cookie 信息来控制客户端的状态。
Cookie 会根据从服务器端发送的响应报文内的一个叫做 Set-Cookie 的首部字段信息,通知客户端保存 Cookie。当下次客户端再往该服务器发送请求时,客户端会自动在请求报文中加入 Cookie 值后发送出去。
服务器端发现客户端发送过来的 Cookie 后,会去检查究竟是从哪一个客户端发来的连接请求,然后对比服务 器上的记录,最后得到之前的状态信息。
没有 Cookie 信信息状态下的请求
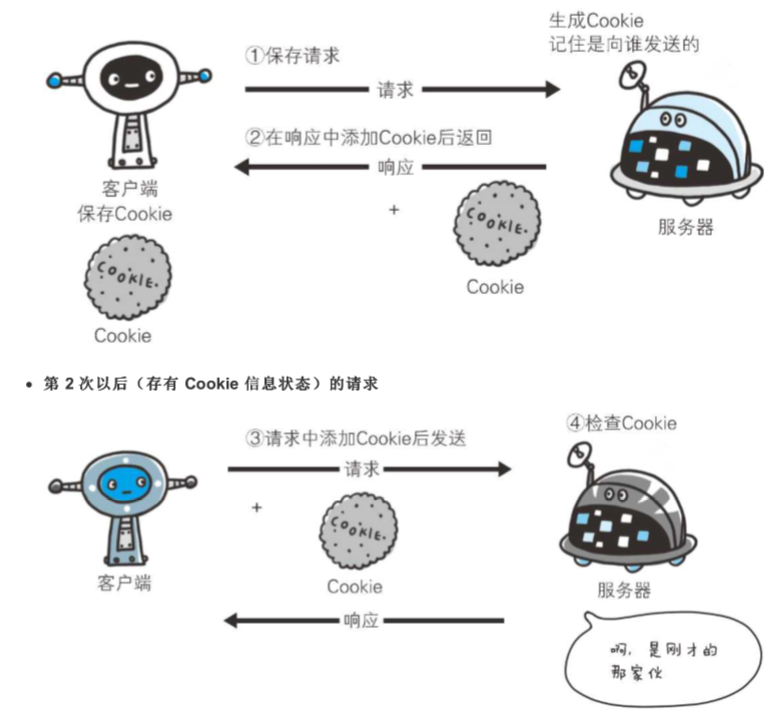
上图展示了发生 Cookie 交互的情景,HTTP 请求报文和响应报文的内容如下。
1. 请求报文(没有 Cookie 信息的状态)
2. 响应报文(服务器端生成 Cookie 信息)
HTTP/1.1 200 OK
Date:Thu,12Jul201207:12:20GMT
Server:Apache
Set-Cookie:sid=1342077140226724;path=/;expires=Wed,10-Oct-1207:12:20GMT
Content-Type:text/plain;charset=UTF-8
3. 请求报文(自动发送保存着的 Cookie 信息)
有关请求报文和响应报文内Cookie 对应的首部字段,请参考之后的章节。
为 Cookie 服务的首部字段
管理服务器与客户端之间状态的 Cookie,虽然没有被编入标准化 HTTP/1.1 的 RFC2616 中,但在 Web 网 站方面得到了广泛的应用。 Cookie 的工作机制是用户识别及状态管理。Web 网站为了管理用户的状态会通过 Web 浏览器,把一些数据 临时写入用户的计算机内。接着当用户访问该Web网站时,可通过通信方式取回之前发放的 Cookie。
下面的表格内列举了与 Cookie 有关的首部字段。
| 首部字段名 | 说明 | 首部类型 |
|---|---|---|
| Set-Cookie | 开始状态管理所使用的Cookie信息 | 响应首部字段 |
| Cookie | 服务器接收到的Cookie信息 | 请求首部字段 |
Set-Cookie
Set-Cookie: status=enable; expires=Tue, 05 Jul 2011 07:26:31 GMT; path=/; domain=.hackr.jp;
当服务器准备开始管理客户端的状态时,会事先告知各种信息。
下面的表格列举了 Set-Cookie 的字段值。
| 属性 | 说明 |
|---|---|
| NAME=VALUE | 赋予 Cookie 的名称和其值(必需项) |
| expires=DATE | Cookie的有效期(若不明确指定则默认为浏览器关闭前为止) |
| path=PATH | 将服务器上的文件目录作为Cookie的适用对象(若不指定则默认为文档所在的文件目录) |
| domain=域名 | 作为 Cookie 适用对象的域名 (若不指定则默认为创建Cookie的服务器的域名) |
| Secure | 仅在 HTTPS 安全通信时才会发送 Cookie |
| HttpOnly | 加以限制,使 Cookie 不能被 JavaScript 脚本访问 |
expires 属性
Cookie 的 expires 属性指定浏览器可发送 Cookie 的有效期。
当省略 expires 属性时,其有效期仅限于维持浏览器会话(Session)时间段内。这通常限于浏览器应用程序被关闭之前。
另外,一旦 Cookie 从服务器端发送至客户端,服务器端就不存在可以显式删除 Cookie 的方法。但可通过覆盖已过期的 Cookie,实现对客户端 Cookie 的实质性删除操作。
Cookie
首部字段 Cookie 会告知服务器,当客户端想获得 HTTP 状态管理支持时,就会在请求中包含从服务器接收到的 Cookie。接收到多个 Cookie 时,同样可以以多个 Cookie 形式发送。
HTTP常用字段总结
请求header大全
| Header | 解释 | 示例 |
|---|---|---|
| Accept | 指定客户端可以接收的内容类型 | Accept: text/plain, text/html |
| Accept-Charset | 浏览器能够接受的字符编码集。 | Accept-Charset: iso-8859-5 |
| Accept-Encoding | 指定浏览器能够支持的web服务器返回内容压缩编码类型。 | Accept-Encoding: compress, gzip |
| Accept-Language | 浏览器可接受的语言 | Accept-Language: en,zh |
| Accept-Ranges | 能够请求网页实体的一个或者多个子范围字段 | Accept-Ranges: bytes |
| Authorization | HTTP受权的受权证书 | Authorization: Basic QWxhZGRpbjpvcGVuIHNlc2FtZQ== |
| Cache-Control | 指定请求和响应遵循的缓存机制 | Cache-Control: no-cache |
| Connection | 表示是否须要持久链接。(HTTP 1.1默认进行持久链接) | Connection: close |
| Cookie | HTTP请求发送时,会把保存在该请求域名下的全部cookie值一块儿发送给web服务器。 | Cookie: $Version=1; Skin=new; |
| Content-Length | 请求的内容长度 | Content-Length: 348 |
| Content-Type | 请求的与实体对应的MIME信息 | Content-Type: application/x-www-form-urlencoded |
| Date | 请求发送的日期和时间 | Date: Tue, 15 Nov 2010 08:12:31 GMT |
| Expect | 请求的特定的服务器行为 | Expect: 100-continue |
| From | 发出请求的用户的Email | From: user@email.com |
| Host | 指定请求的服务器的域名和端口号 | Host: www.zcmhi.com |
| If-Match | 只有请求内容与实体相匹配才有效 | If-Match: “737060cd8c284d8af7ad3082f209582d” |
| If-Modified-Since | 若是请求的部分在指定时间以后被修改则请求成功,未被修改则返回304代码 | If-Modified-Since: Sat, 29 Oct 2010 19:43:31 GMT |
| If-None-Match | 若是内容未改变返回304代码,参数为服务器先前发送的Etag,与服务器回应的Etag比较判断是否改变 | If-None-Match: “737060cd8c284d8af7ad3082f209582d” |
| If-Range | 若是实体未改变,服务器发送客户端丢失的部分,不然发送整个实体。参数也为Etag | If-Range: “737060cd8c284d8af7ad3082f209582d” |
| If-Unmodified-Since | 只在实体在指定时间以后未被修改才请求成功 | If-Unmodified-Since: Sat, 29 Oct 2010 19:43:31 GMT |
| Max-Forwards | 限制信息经过代理和网关传送的时间 | Max-Forwards: 10 |
| Pragma | 用来包含实现特定的指令 | Pragma: no-cache |
| Proxy-Authorization | 链接到代理的受权证书 | Proxy-Authorization: Basic QWxhZGRpbjpvcGVuIHNlc2FtZQ== |
| Range | 只请求实体的一部分,指定范围 | Range: bytes=500-999 |
| Referer | 先前网页的地址,当前请求网页紧随其后,即来路 | Referer: http://www.zcmhi.com/archives/71.html |
| TE | 客户端愿意接受的传输编码,并通知服务器接受接受尾加头信息 | TE: trailers,deflate;q=0.5 |
| Upgrade | 向服务器指定某种传输协议以便服务器进行转换(若是支持) | Upgrade: HTTP/2.0, SHTTP/1.3, IRC/6.9, RTA/x11 |
| User-Agent | User-Agent的内容包含发出请求的用户信息 | User-Agent: Mozilla/5.0 (Linux; X11) |
| Via | 通知中间网关或代理服务器地址,通讯协议 | Via: 1.0 fred, 1.1 nowhere.com (Apache/1.1) |
| Warning | 关于消息实体的警告信息 | Warn: 199 Miscellaneous warning |
| X-Forwarded-For | 用来说明从哪里来的,一般用来内网伪装 | X-Forwarded-For: 127.0.0.1 |
响应header大全
| Header | 解释 | 示例 |
|---|---|---|
| Accept-Ranges | 代表服务器是否支持指定范围请求及哪一种类型的分段请求 | Accept-Ranges: bytes |
| Age | 从原始服务器到代理缓存造成的估算时间(以秒计,非负) | Age: 12 |
| Allow | 对某网络资源的有效的请求行为,不容许则返回405 | Allow: GET, HEAD |
| Cache-Control | 告诉全部的缓存机制是否能够缓存及哪一种类型 | Cache-Control: no-cache |
| Content-Encoding | web服务器支持的返回内容压缩编码类型。 | Content-Encoding: gzip |
| Content-Language | 响应体的语言 | Content-Language: en,zh |
| Content-Length | 响应体的长度 | Content-Length: 348 |
| Content-Location | 请求资源可替代的备用的另外一地址 | Content-Location: /index.htm |
| Content-MD5 | 返回资源的MD5校验值 | Content-MD5: Q2hlY2sgSW50ZWdyaXR5IQ== |
| Content-Range | 在整个返回体中本部分的字节位置 | Content-Range: bytes 21010-47021/47022 |
| Content-Type | 返回内容的MIME类型 | Content-Type: text/html; charset=utf-8 |
| Date | 原始服务器消息发出的时间 | Date: Tue, 15 Nov 2010 08:12:31 GMT |
| ETag | 请求变量的实体标签的当前值 | ETag: “737060cd8c284d8af7ad3082f209582d” |
| Expires | 响应过时的日期和时间 | Expires: Thu, 01 Dec 2010 16:00:00 GMT |
| Last-Modified | 请求资源的最后修改时间 | Last-Modified: Tue, 15 Nov 2010 12:45:26 GMT |
| Location | 用来重定向接收方到非请求URL的位置来完成请求或标识新的资源 | Location: http://www.zcmhi.com/archives/94.html |
| Pragma | 包括实现特定的指令,它可应用到响应链上的任何接收方 | Pragma: no-cache |
| Proxy-Authenticate | 它指出认证方案和可应用到代理的该URL上的参数 | Proxy-Authenticate: Basic |
| Refresh | 应用于重定向或一个新的资源被创造,在5秒以后重定向(由网景提出,被大部分浏览器支持) | Refresh: 5; url=http://www.zcmhi.com/archives/94.html |
| Retry-After | 若是实体暂时不可取,通知客户端在指定时间以后再次尝试 | Retry-After: 120 |
| Server | web服务器软件名称 | Server: Apache/1.3.27 (Unix) (Red-Hat/Linux) |
| Set-Cookie | 设置Http Cookie | Set-Cookie: UserID=JohnDoe; Max-Age=3600; Version=1 |
| Trailer | 指出头域在分块传输编码的尾部存在 | Trailer: Max-Forwards |
| Transfer-Encoding | 文件传输编码 | Transfer-Encoding:chunked |
| Vary | 告诉下游代理是使用缓存响应仍是从原始服务器请求 | Vary: * |
| Via | 告知代理客户端响应是经过哪里发送的 | Via: 1.0 fred, 1.1 nowhere.com (Apache/1.1) |
| Warning | 警告实体可能存在的问题 | Warning: 199 Miscellaneous warning |
| WWW-Authenticate | 代表客户端请求实体应该使用的受权方案 | WWW-Authenticate: Basic |
请求方法大全
| 方法 | 描述 |
|---|---|
| GET | 发送请求来获得服务器上的资源,请求体中不会包含请求数据,请求数据放在协议头中。另外get支持快取、缓存、可保留书签等。幂等 |
| POST | 和get一样很常见,向服务器提交资源让服务器处理,比如提交表单、上传文件等,可能导致建立新的资源或者对原有资源的修改。提交的资源放在请求体中。不支持快取。非幂等 |
| HEAD | 本质和get一样,但是响应中没有呈现数据,而是http的头信息,主要用来检查资源或超链接的有效性或是否可以可达、检查网页是否被串改或更新,获取头信息等,特别适用在有限的速度和带宽下。 |
| PUT | 和post类似,html表单不支持,发送资源与服务器,并存储在服务器指定位置,要求客户端事先知道该位置;比如post是在一个集合上(/province),而put是具体某一个资源上(/province/123)。所以put是安全的,无论请求多少次,都是在123上更改,而post可能请求几次创建了几次资源。幂等 |
| DELETE | 请求服务器删除某资源。和put都具有破坏性,可能被防火墙拦截。如果是https协议,则无需担心。 |
| CONNECT | HTTP/1.1协议中预留给能够将连接改为管道方式的代理服务器。就是把服务器作为跳板,去访问其他网页然后把数据返回回来,连接成功后,就可以正常的get、post了。 |
| OPTIONS | 获取http服务器支持的http请求方法,允许客户端查看服务器的性能,比如ajax跨域时的预检等。 |
| TRACE | 回显服务器收到的请求,主要用于测试或诊断。一般禁用,防止被恶意攻击或盗取信息。 |
Cookie-Session机制解析
Cookie机制
Cookie技术是客户端的解决方案,Cookie就是由服务器发给客户端的特殊信息,而这些信息以文本文件的方式存放在客户端,然后客户端每次向服务器发送请求的时候都会带上这些特殊的信息。
让我们说得更具体一些:当用户使用浏览器访问一个支持Cookie的网站的时候,用户会提供包括用户名在内的个人信息并且提交至服务器
接着,服务器在向客户端回传相应的超文本的同时也会发回这些个人信息,当然这些信息并不是存放在HTTP响应体(Response Body)中的,而是存放于HTTP响应头(Response Header)
当客户端浏览器接收到来自服务器的响应之后,浏览器会将这些信息存放在一个统一的位置,这通常由于系统版本和浏览器的不同而不同
自此,客户端再向服务器发送请求的时候,都会把相应的Cookie再次发回至服务器。而这次,Cookie信息则存放在HTTP请求头(Request Header)了。
有了Cookie这样的技术实现,服务器在接收到来自客户端浏览器的请求之后,就能够通过分析存放于请求头的Cookie得到客户端特有的信息,从而动态生成与该客户端相对应的内容。
通常,我们可以从很多网站的登录界面中看到“请记住我”这样的选项,如果你勾选了它之后再登录,那么在下一次访问该网站的时候就不需要进行重复而繁琐的登录动作了,而这个功能就是通过Cookie实现的。
客户端发送一个http请求到服务器端 服务器端发送一个http响应到客户端,其中包含Set-Cookie头部 客户端发送一个http请求到服务器端,其中包含Cookie头部 服务器端发送一个http响应到客户端
这个通讯过程也可以用以下下示意图来描述:
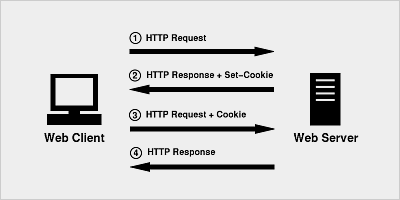
在客户端的第二次请求中包含的Cookie头部中,提供给了服务器端可以用来唯一标识客户端身份的信息。
这时,服务器端也就可以判断客户端是否启用了cookies。尽管,用户可能在和应用程序交互的过程中突然禁用cookies的使用,但是,这个情况基本是不太可能发生的,所以可以不加以考虑,这在实践中也被证明是对的。
Cookie的不可跨域名性
很多网站都会使用Cookie。例如,Google会向客户端颁发Cookie,Baidu也会向客户端颁发Cookie。那浏览器访问Google会不会也携带上Baidu颁发的Cookie呢?或者Google能不能修改Baidu颁发的Cookie呢?
答案是否定的。Cookie具有不可跨域名性。根据Cookie规范,浏览器访问Google只会携带Google的Cookie,而不会携带Baidu的Cookie。Google也只能操作Google的Cookie,而不能操作Baidu的Cookie。
Cookie在客户端是由浏览器来管理的。浏览器能够保证Google只会操作Google的Cookie而不会操作Baidu的Cookie,从而保证用户的隐私安全。浏览器判断一个网站是否能操作另一个网站Cookie的依据是域名。Google与Baidu的域名不一样,因此Google不能操作Baidu的Cookie。
需要注意的是,虽然网站images.google.com与网站www.google.com同属于Google,但是域名不一样,二者同样不能互相操作彼此的Cookie。
注意:用户登录网站www.google.com之后会发现访问images.google.com时登录信息仍然有效,而普通的Cookie是做不到的。这是因为Google做了特殊处理。本章后面也会对Cookie做类似的处理。
Unicode编码:保存中文
中文与英文字符不同,中文属于Unicode字符,在内存中占4个字符,而英文属于ASCII字符,内存中只占2个字节。Cookie中使用Unicode字符时需要对Unicode字符进行编码,否则会乱码。
提示:Cookie中保存中文只能编码。一般使用UTF-8编码即可。不推荐使用GBK等中文编码,因为浏览器不一定支持,而且JavaScript也不支持GBK编码。
BASE64编码:保存二进制图片
Cookie不仅可以使用ASCII字符与Unicode字符,还可以使用二进制数据。例如在Cookie中使用数字证书,提供安全度。使用二进制数据时也需要进行编码。
注意:本程序仅用于展示Cookie中可以存储二进制内容,并不实用。由于浏览器每次请求服务器都会携带Cookie,因此Cookie内容不宜过多,否则影响速度。Cookie的内容应该少而精。
Session机制
除了使用Cookie,Web应用程序中还经常使用Session来记录客户端状态。Session是服务器端使用的一种记录客户端状态的机制,使用上比Cookie简单一些,相应的也增加了服务器的存储压力。
Session技术则是服务端的解决方案,它是通过服务器来保持状态的。
由于Session这个词汇包含的语义很多,因此需要在这里明确一下 Session的含义。首先,我们通常都会把Session翻译成会话,因此我们可以把客户端浏览器与服务器之间一系列交互的动作称为一个 Session。
从这个语义出发,我们会提到Session持续的时间,会提到在Session过程中进行了什么操作等等;其次,Session指的是服务器端为客户端所开辟的存储空间,在其中保存的信息就是用于保持状态。
从这个语义出发,我们则会提到往Session中存放什么内容,如何根据键值从 Session中获取匹配的内容等。
要使用Session,第一步当然是创建Session了。那么Session在何时创建呢?当然还是在服务器端程序运行的过程中创建的,不同语言实现的应用程序有不同创建Session的方法,而在Java中是通过调用HttpServletRequest的getSession方法(使用true作为参数)创建的。
在创建了Session的同时,服务器会为该Session生成唯一的Session id,而这个Session id在随后的请求中会被用来重新获得已经创建的Session
在Session被创建之后,就可以调用Session相关的方法往Session中增加内容了,而这些内容只会保存在服务器中,发到客户端的只有Session id
当客户端再次发送请求的时候,会将这个Session id带上,服务器接受到请求之后就会依据Session id找到相应的Session,从而再次使用之。这样,用户的状态也就得以保持了。
Session是另一种记录客户状态的机制,不同的是Cookie保存在客户端浏览器中,而Session保存在服务器上。客户端浏览器访问服务器的时候,服务器把客户端信息以某种形式记录在服务器上。这就是Session。客户端浏览器再次访问时只需要从该Session中查找该客户的状态就可以了。
如果说Cookie机制是通过检查客户身上的“通行证”来确定客户身份的话,那么Session机制就是通过检查服务器上的“客户明细表”来确认客户身份。Session相当于程序在服务器上建立的一份客户档案,客户来访的时候只需要查询客户档案表就可以了。
Session对浏览器的要求
虽然Session保存在服务器,对客户端是透明的,它的正常运行仍然需要客户端浏览器的支持。这是因为Session需要使用Cookie作为识别标志。HTTP协议是无状态的,Session不能依据HTTP连接来判断是否为同一客户,因此服务器向客户端浏览器发送一个名为JSESSIONID的Cookie,它的值为该Session的id(也就是HttpSession.getId()的返回值)。Session依据该Cookie来识别是否为同一用户。
该Cookie为服务器自动生成的,它的maxAge属性一般为–1,表示仅当前浏览器内有效,并且各浏览器窗口间不共享,关闭浏览器就会失效。
因此同一机器的两个浏览器窗口访问服务器时,会生成两个不同的Session。但是由浏览器窗口内的链接、脚本等打开的新窗口(也就是说不是双击桌面浏览器图标等打开的窗口)除外。这类子窗口会共享父窗口的Cookie,因此会共享一个Session。
注意:新开的浏览器窗口会生成新的Session,但子窗口除外。子窗口会共用父窗口的Session。例如,在链接上右击,在弹出的快捷菜单中选择“在新窗口中打开”时,子窗口便可以访问父窗口的Session。
如果客户端浏览器将Cookie功能禁用,或者不支持Cookie怎么办?例如,绝大多数的手机浏览器都不支持Cookie。Java Web提供了另一种解决方案:URL地址重写。
URL地址重写
URL地址重写是对客户端不支持Cookie的解决方案。URL地址重写的原理是将该用户Session的id信息重写到URL地址中。服务器能够解析重写后的URL获取Session的id。这样即使客户端不支持Cookie,也可以使用Session来记录用户状态。HttpServletResponse类提供了encodeURL(Stringurl)实现URL地址重写,例如:
该方法会自动判断客户端是否支持Cookie。如果客户端支持Cookie,会将URL原封不动地输出来。如果客户端不支持Cookie,则会将用户Session的id重写到URL中。重写后的输出可能是这样的:
<td>
    <a href="index.jsp;jsessionid=0CCD096E7F8D97B0BE608AFDC3E1931E?c=1&wd=Java">Homepage</a>
</td>
即在文件名的后面,在URL参数的前面添加了字符串“;jsessionid=XXX”。其中XXX为Session的id。分析一下可以知道,增添的jsessionid字符串既不会影响请求的文件名,也不会影响提交的地址栏参数。用户单击这个链接的时候会把Session的id通过URL提交到服务器上,服务器通过解析URL地址获得Session的id。
如果是页面重定向(Redirection),URL地址重写可以这样写:
<%
    if(“administrator”.equals(userName)) {
        response.sendRedirect(response.encodeRedirectURL(“administrator.jsp”));
        return;
    }
%>
效果跟response.encodeURL(String url)是一样的:如果客户端支持Cookie,生成原URL地址,如果不支持Cookie,传回重写后的带有jsessionid字符串的地址。
Cookie与Session的区别
- cookie数据存放在客户的浏览器上,session数据放在服务器上;
- cookie不是很安全,别人可以分析存放在本地的COOKIE并进行COOKIE欺骗,考虑到安全应当使用session;
- session会在一定时间内保存在服务器上。当访问增多,会比较占用你服务器的性能。考虑到减轻服务器性能方面,应当使用COOKIE;
- 单个cookie在客户端的限制是3K,就是说一个站点在客户端存放的COOKIE不能超过3K;
Cookie和Session的方案虽然分别属于客户端和服务端,但是服务端的session的实现对客户端的cookie有依赖关系的,上面我讲到服务端执行session机制时候会生成session的id值,这个id值会发送给客户端,客户端每次请求都会把这个id值放到http请求的头部发送给服务端,而这个id值在客户端会保存下来,保存的容器就是cookie,因此当我们完全禁掉浏览器的cookie的时候,服务端的session也会不能正常使用
参考文章:理解Cookie和Session机制 - Andrew.Zhou - 博客园
同源策略
**同源策略**在web应用的安全模型中是一个重要概念。在这个策略下,web浏览器允许第一个页面的脚本访问第二个页面里的数据,但是也只有在两个页面有相同的源时。源是由URI,主机名,端口号组合而成的。这个策略可以阻止一个页面上的恶意脚本通过页面的DOM对象获得访问另一个页面上敏感信息的权限。
对于普遍依赖于cookie维护授权用户session的现代浏览器来说,这种机制有特殊意义。客户端必须在不同站点提供的内容之间维持一个严格限制,以防丢失数据机密或者完整性。
源决定规则
RFC6454中有定义URI源的算法定义。对于绝对的URIs,源就是{协议,主机,端口}定义的。只有这些值完全一样才认为两个资源是同源的。
为了举例,下面的表格给出了与URL"http://www.example.com/dir/page.html"的对比。
| 对比URL | 结果 | 结果 |
|---|---|---|
http://www.example.com/dir/page2.html |
同源 | 相同的协议,主机,端口 |
http://www.example.com/dir2/other.html |
同源 | 相同的协议,主机,端口 |
http://username:password@www.example.com/dir2/other.html |
同源 | 相同的协议,主机,端口 |
http://www.example.com:81/dir/other.html |
不同源 | 相同的协议,主机,端口不同 |
https://www.example.com/dir/other.html |
不同源 | 协议不同 |
http://en.example.com/dir/other.html |
不同源 | 不同主机 |
http://example.com/dir/other.html |
不同源 | 不同主机(需要精确匹配) |
http://v2.www.example.com/dir/other.html |
不同源 | 不同主机(需要精确匹配) |
http://www.example.com:80/dir/other.html |
看情况 | 端口明确,依赖浏览器实现 |
不像其他浏览器,IE在计算源的时候没有包括端口。
安全考量
有这种限制的主要原因就是如果没有同源策略将导致安全风险。
假设用户在访问银行网站,并且没有登出。然后他又去了任意的其他网站,刚好这个网站有恶意的js代码,在后台请求银行网站的信息。
因为用户目前仍然是银行站点的登陆状态,那么恶意代码就可以在银行站点做任意事情。
例如,获取你的最近交易记录,创建一个新的交易等等。因为浏览器可以发送接收银行站点的session cookies,在银行站点域上。访问恶意站点的用户希望他访问的站点没有权限访问银行站点的cookie。
js虽然不能直接获取银行站点的session cookie,但是他仍然可以向银行站点发送接收附带银行站点session cookie的请求,本质上就像一个正常用户访问银行站点一样。关于发送的新交易,甚至银行站点的CSRF(跨站请求伪造)防护都无能无力,因为脚本可以轻易的实现正常用户一样的行为。
如果没有 DOM 同源策略,也就是说不同域的 iframe 之间可以相互访问,那么黑客可以这样进行攻击:
- 做一个假网站,里面用 iframe 嵌套一个银行网站
http://mybank.com。 - 把 iframe 宽高啥的调整到页面全部,这样用户进来除了域名,别的部分和银行的网站没有任何差别。
- 这时如果用户输入账号密码,我们的主网站可以跨域访问到
http://mybank.com的 dom 节点,就可以拿到用户的账户密码了。
如果没有 XMLHttpRequest 同源策略,那么黑客可以进行 CSRF(跨站请求伪造) 攻击:
- 用户登录了自己的银行页面
http://mybank.com,http://mybank.com向用户的 cookie 中添加用户标识。 - 用户浏览了恶意页面
http://evil.com,执行了页面中的恶意 AJAX 请求代码。 http://evil.com向http://mybank.com发起 AJAX HTTP 请求,请求会默认把http://mybank.com对应 cookie 也同时发送过去。- 银行页面从发送的 cookie 中提取用户标识,验证用户无误,response 中返回请求数据。此时数据就泄露了。
- 而且由于 Ajax 在后台执行,用户无法感知这一过程。
因此,有了浏览器同源策略,我们才能更安全的上网。
跨域方法
CORS(跨域资源共享)
CORS(Cross-origin resource sharing,跨域资源共享)是一个 W3C 标准,定义了在必须访问跨域资源时,浏览器与服务器应该如何沟通。CORS 背后的基本思想,就是使用自定义的 HTTP 头部让浏览器与服务器进行沟通,从而决定请求或响应是应该成功,还是应该失败。
CORS 需要浏览器和服务器同时支持。目前,所有浏览器都支持该功能,IE 浏览器不能低于 IE10。
整个 CORS 通信过程,都是浏览器自动完成,不需要用户参与。对于开发者来说,CORS 通信与同源的 AJAX 通信没有差别,代码完全一样。浏览器一旦发现 AJAX 请求跨源,就会自动添加一些附加的头信息,有时还会多出一次附加的请求,但用户不会有感觉。
因此,实现 CORS 通信的关键是服务器。只要服务器实现了 CORS 接口,就可以跨源通信。
浏览器将CORS请求分成两类:简单请求(simple request)和非简单请求(not-so-simple request)。
只要同时满足以下两大条件,就属于**简单请求**。
请求方法是以下三种方法之一:
- HEAD
- GET
- POST
HTTP的头信息不超出以下几种字段:
- Accept
- Accept-Language
- Content-Language
- Last-Event-ID
- Content-Type:只限于三个值 application/x-www-form-urlencoded、multipart/form-data、text/plain
凡是不同时满足上面两个条件,就属于**非简单请求**。
浏览器对这两种请求的处理,是不一样的。
简单请求
- 在请求中需要附加一个额外的 Origin 头部,其中包含请求页面的源信息(协议、域名和端口),以便服务器根据这个头部信息来决定是否给予响应。例如:
Origin: http://www.laixiangran.cn - 如果服务器认为这个请求可以接受,就在 Access-Control-Allow-Origin 头部中回发相同的源信息(如果是公共资源,可以回发 * )。例如:
Access-Control-Allow-Origin:http://www.laixiangran.cn - 没有这个头部或者有这个头部但源信息不匹配,浏览器就会驳回请求。正常情况下,浏览器会处理请求。注意,请求和响应都不包含 cookie 信息。
- 如果需要包含 cookie 信息,ajax 请求需要设置 xhr 的属性 withCredentials 为 true,服务器需要设置响应头部
Access-Control-Allow-Credentials: true。
非简单请求
浏览器在发送真正的请求之前,会先发送一个 Preflight 请求给服务器,这种请求使用 OPTIONS 方法,发送下列头部:
- Origin:与简单的请求相同。
- Access-Control-Request-Method: 请求自身使用的方法。
- Access-Control-Request-Headers: (可选)自定义的头部信息,多个头部以逗号分隔。
例如:
Origin: http://www.laixiangran.cn
Access-Control-Request-Method: POST
Access-Control-Request-Headers: NCZ
发送这个请求后,服务器可以决定是否允许这种类型的请求。服务器通过在响应中发送如下头部与浏览器进行沟通:
- Access-Control-Allow-Origin:与简单的请求相同。
- Access-Control-Allow-Methods: 允许的方法,多个方法以逗号分隔。
- Access-Control-Allow-Headers: 允许的头部,多个方法以逗号分隔。
- Access-Control-Max-Age: 应该将这个 Preflight 请求缓存多长时间(以秒表示)。
例如:
Access-Control-Allow-Origin: http://www.laixiangran.cn
Access-Control-Allow-Methods: GET, POST
Access-Control-Allow-Headers: NCZ
Access-Control-Max-Age: 1728000
一旦服务器通过 Preflight 请求允许该请求之后,以后每次浏览器正常的 CORS 请求,就都跟简单请求一样了。
优点
- CORS 通信与同源的 AJAX 通信没有差别,代码完全一样,容易维护。
- 支持所有类型的 HTTP 请求。
缺点
- 存在兼容性问题,特别是 IE10 以下的浏览器。
- 第一次发送非简单请求时会多一次请求。
JSONP 跨域
由于 script 标签不受浏览器同源策略的影响,允许跨域引用资源。因此可以通过动态创建 script 标签,然后利用 src 属性进行跨域,这也就是 JSONP 跨域的基本原理。
直接通过下面的例子来说明 JSONP 实现跨域的流程:
// 1. 定义一个 回调函数 handleResponse 用来接收返回的数据
function handleResponse(data) {
    console.log(data);
};

// 2. 动态创建一个 script 标签,并且告诉后端回调函数名叫 handleResponse
var body = document.getElementsByTagName('body')[0];
var script = document.gerElement('script');
script.src = 'http://www.laixiangran.cn/json?callback=handleResponse';
body.appendChild(script);

// 3. 通过 script.src 请求 `http://www.laixiangran.cn/json?callback=handleResponse`,
// 4. 后端能够识别这样的 URL 格式并处理该请求,然后返回 handleResponse({"name": "laixiangran"}) 给浏览器
// 5. 浏览器在接收到 handleResponse({"name": "laixiangran"}) 之后立即执行 ,也就是执行 handleResponse 方法,获得后端返回的数据,这样就完成一次跨域请求了。
优点
- 使用简便,没有兼容性问题,目前最流行的一种跨域方法。
缺点
- 只支持 GET 请求。
- 由于是从其它域中加载代码执行,因此如果其他域不安全,很可能会在响应中夹带一些恶意代码。
- 要确定 JSONP 请求是否失败并不容易。虽然 HTML5 给 script 标签新增了一个 onerror 事件处理程序,但是存在兼容性问题。
图像 Ping 跨域
由于 img 标签不受浏览器同源策略的影响,允许跨域引用资源。因此可以通过 img 标签的 src 属性进行跨域,这也就是图像 Ping 跨域的基本原理。
直接通过下面的例子来说明图像 Ping 实现跨域的流程:
var img = new Image();

// 通过 onload 及 onerror 事件可以知道响应是什么时候接收到的,但是不能获取响应文本
img.onload = img.onerror = function() {
    console.log("Done!");
}

// 请求数据通过查询字符串形式发送
img.src = 'http://www.laixiangran.cn/test?name=laixiangran';
优点
- 用于实现跟踪用户点击页面或动态广告曝光次数有较大的优势。
缺点
- 只支持 GET 请求。
- 只能浏览器与服务器的单向通信,因为浏览器不能访问服务器的响应文本。
服务器代理
浏览器有跨域限制,但是服务器不存在跨域问题,所以可以由服务器请求所有域的资源再返回给客户端。
服务器代理是万能的。
document.domain 跨域
对于主域名相同,而子域名不同的情况,可以使用 document.domain 来跨域。这种方式非常适用于 iframe 跨域的情况。
比如,有一个页面,它的地址是 http://www.laixiangran.cn/a.html,在这个页面里面有一个 iframe,它的 src 是 http://laixiangran.cn/b.html。很显然,这个页面与它里面的 iframe 框架是不同域的,所以我们是无法通过在页面中书写 js 代码来获取 iframe 中的东西的。
这个时候,document.domain 就可以派上用场了,我们只要把 http://www.laixiangran.cn/a.html 和 http://laixiangran.cn/b.html 这两个页面的 document.domain 都设成相同的域名就可以了。但要注意的是,document.domain 的设置是有限制的,我们只能把 document.domain 设置成自身或更高一级的父域,且主域必须相同。例如:a.b.laixiangran.cn 中某个文档的 document.domain 可以设成 a.b.laixiangran.cn、b.laixiangran.cn 、laixiangran.cn 中的任意一个,但是不可以设成 c.a.b.laixiangran.cn ,因为这是当前域的子域,也不可以设成 baidu.com,因为主域已经不相同了。
例如,在页面 http://www.laixiangran.cn/a.html 中设置document.domain:
<iframe src="http://laixiangran.cn/b.html" id="myIframe" onload="test()">
<script>
    document.domain = 'laixiangran.cn'; // 设置成主域
    function test() {
        console.log(document.getElementById('myIframe').contentWindow);
    }
</script>
在页面 http://laixiangran.cn/b.html 中也设置 document.domain,而且这也是必须的,虽然这个文档的 domain 就是 laixiangran.cn,但是还是必须显式地设置 document.domain 的值:
这样,http://www.laixiangran.cn/a.html 就可以通过 js 访问到 http://laixiangran.cn/b.html 中的各种属性和对象了。
window.name 跨域
window 对象有个 name 属性,该属性有个特征:即在一个窗口(window)的生命周期内,窗口载入的所有的页面(不管是相同域的页面还是不同域的页面)都是共享一个 window.name 的,每个页面对 window.name 都有读写的权限,window.name 是持久存在一个窗口载入过的所有页面中的,并不会因新页面的载入而进行重置。
通过下面的例子介绍如何通过 window.name 来跨域获取数据的。
页面 http://www.laixiangran.cn/a.html 的代码:
<iframe src="http://laixiangran.cn/b.html" id="myIframe" onload="test()" style="display: none;">
<script>
    // 2. iframe载入 "http://laixiangran.cn/b.html 页面后会执行该函数
    function test() {
        var iframe = document.getElementById('myIframe');

        // 重置 iframe 的 onload 事件程序,
        // 此时经过后面代码重置 src 之后,
        // http://www.laixiangran.cn/a.html 页面与该 iframe 在同一个源了,可以相互访问了
        iframe.onload = function() {
            var data = iframe.contentWindow.name; // 4. 获取 iframe 里的 window.name
            console.log(data); // hello world!
        };

        // 3. 重置一个与 http://www.laixiangran.cn/a.html 页面同源的页面
        iframe.src = 'http://www.laixiangran.cn/c.html';
    }
</script>
页面 http://laixiangran.cn/b.html 的代码:
<script type="text/javascript">
    // 1. 给当前的 window.name 设置一个 http://www.laixiangran.cn/a.html 页面想要得到的数据值
    window.name = "hello world!";
</script>
location.hash 跨域
location.hash 方式跨域,是子框架修改父框架 src 的 hash 值,通过这个属性进行传递数据,且更改 hash 值,页面不会刷新。但是传递的数据的字节数是有限的。
页面 http://www.laixiangran.cn/a.html 的代码:
<iframe src="http://laixiangran.cn/b.html" id="myIframe" onload="test()" style="display: none;">
<script>
    // 2. iframe载入 "http://laixiangran.cn/b.html 页面后会执行该函数
    function test() {
        // 3. 获取通过 http://laixiangran.cn/b.html 页面设置 hash 值
        var data = window.location.hash;
        console.log(data);
    }
</script>
页面 http://laixiangran.cn/b.html 的代码:
script type="text/javascript">
    // 1. 设置父页面的 hash 值
    parent.location.hash = "world";
</script>
postMessage 跨域
window.postMessage(message,targetOrigin) 方法是 HTML5 新引进的特性,可以使用它来向其它的 window 对象发送消息,无论这个 window 对象是属于同源或不同源。这个应该就是以后解决 dom 跨域通用方法了。
调用 postMessage 方法的 window 对象是指要接收消息的那一个 window 对象,该方法的第一个参数 message 为要发送的消息,类型只能为字符串;第二个参数 targetOrigin 用来限定接收消息的那个 window 对象所在的域,如果不想限定域,可以使用通配符 *。
需要接收消息的 window 对象,可是通过监听自身的 message 事件来获取传过来的消息,消息内容储存在该事件对象的 data 属性中。
页面 http://www.laixiangran.cn/a.html 的代码:
<iframe src="http://laixiangran.cn/b.html" id="myIframe" onload="test()" style="display: none;">
<script>
    // 1. iframe载入 "http://laixiangran.cn/b.html 页面后会执行该函数
    function test() {
        // 2. 获取 http://laixiangran.cn/b.html 页面的 window 对象,
        // 然后通过 postMessage 向 http://laixiangran.cn/b.html 页面发送消息
        var iframe = document.getElementById('myIframe');
        var win = iframe.contentWindow;
        win.postMessage('我是来自 http://www.laixiangran.cn/a.html 页面的消息', '*');
    }
</script>
页面 http://laixiangran.cn/b.html 的代码:
<script type="text/javascript">
    // 注册 message 事件用来接收消息
    window.onmessage = function(e) {
        e = e || event; // 获取事件对象
        console.log(e.data); // 通过 data 属性得到发送来的消息
    }
</script>
CSP
跨域脚本攻击 XSS 是最常见、危害最大的网页安全漏洞。为了防止它们,要采取很多编程措施,非常麻烦。很多人提出,能不能根本上解决问题,浏览器自动禁止外部注入恶意脚本?这就是"网页安全政策"(Content Security Policy,缩写 CSP)的来历。内容安全策略(CSP),其核心思想十分简单:网站通过发送一个 CSP 头部,来告诉浏览器什么是被授权执行的与什么是需要被禁止的。其被誉为专门为解决XSS攻击而生的神器。
在浏览网页的过程中,尤其是移动端的网页,经常看到有很多无关的广告,其实大部分广告都是所在的网络劫持了网站响应的内容,并在其中植入了广告代码。为了防止这种情况发生,我们可以使用CSP来快速的阻止这种广告植入。而且可以比较好的防御dom xss。
CSP(Content Security Policy)指的是内容安全策略 ,是一个附加的安全层,用于帮助检测和缓解某些类型的攻击,包括跨站脚本攻击 (XSS) 和数据注入等攻击。
这些攻击可用于实现从数据窃取到网站破坏或作为恶意软件分发版本等用途。为了缓解很大一部分潜在的跨站脚本问题,浏览器的扩展程序系统引入了内容安全策略(CSP)的一般概念。
这将引入一些相当严格的策略,会使扩展程序在默认情况下更加安全,开发者可以创建并强制应用一些规则,管理网站允许加载的内容。简单来说,就是我们能够**规定,我们的网站只接受我们指定的请求资源**。
CSP 的实质就是白名单制度,开发者明确告诉客户端,哪些外部资源可以加载和执行,等同于提供白名单。
它的实现和执行全部由浏览器完成,开发者只需提供配置。CSP 大大增强了网页的安全性。攻击者即使发现了漏洞,也没法注入脚本,除非还控制了一台列入了白名单的可信主机。
csp指令说明
指令就是csp中用来定义策略的基本单位,我们可以使用单个或者多个指令来组合作用,功能防护我们的网站.
以下是常用的指令说明:
| 指令名 | demo | 说明 |
|---|---|---|
| default-src | 'self' cdn.example.com | 默认策略,可以应用于js文件/图片/css/ajax请求等所有访问 |
| script-src | 'self' js.example.com | 定义js文件的过滤策略 |
| style-src | 'self' css.example.com | 定义css文件的过滤策略 |
| img-src | 'self' img.example.com | 定义图片文件的过滤策略 |
| connect-src | 'self' | 定义请求连接文件的过滤策略 |
| font-src | font.example.com | 定义字体文件的过滤策略 |
| object-src | 'self' | 定义页面插件的过滤策略,如 |
| media-src | media.example.com | 定义媒体的过滤策略,如 HTML6的 |
| frame-src | 'self' | 定义加载子frmae的策略 |
| sandbox | allow-forms allow-scripts | 沙盒模式,会阻止页面弹窗/js执行等,你可以通过添加allow-forms allow-same-origin allow-scripts allow-popups, allow-modals, allow-orientation-lock, allow-pointer-lock, allow-presentation, allow-popups-to-escape-sandbox, and allow-top-navigation 策略来放开相应的操作 |
| report-uri | /some-report-uri | 错误报告地址 |
| navigate-to | navigate-to |
限制调整链接的 地址方位 |
| 属性值 | 示例 | 说明 |
|---|---|---|
| * | ing-src * | 允许从任意url加载,除了data:blob:filesystem:schemes |
| ‘none’ | object-src ‘none’ | 禁止从任何url加载资源 |
| ‘self’ | img-src ‘self’ | 只可以加载同源资源 |
| data: | img-src ‘self’ data: | 可以通过data协议加载资源 |
| domain.example.com | ing-src domain.example.com | 只可以从特定的域加载资源 |
| *.example.com | img-src *.example.com | 可以从任意example.com的子域处加载资源 |
| https://cdn.com | img-src https://cdn.com | 只能从给定的域用https加载资源 |
| https: | img-src https: | 只能从任意域用https加载资源 |
| ‘unsafe-inline’ | script-src ‘unsafe-inline’ | 允许内部资源执行代码例如style attribute,onclick或者是sicript标签 |
| ‘unsafe-eval’ | script-src ‘unsafe-eval’ | 允许一些不安全的代码执行方式,例如js的eval() |
Refer
https://developer.mozilla.org/en-US/docs/Web/HTTP/Headers/Content-Security-Policy