Curl Tricks
题目的curl的url参数可控,并且题目说明了提示放在 /hint.txt 里面,所以第一反应就是用file协议去读 hint.txt ,但是有如下过滤:
$blacklist = "/l|g|[\x01-\x1f]|[\x7f-\xff]|['\"]/i"; ,file的 l 被ban了。所以这里就要涉及到curl对url的一些处理,当curl
遇到url中包含 { 和 [ 时,该url就会被特殊处理:
https://github.com/curl/curl/blob/master/src/tool_urlglob.c#L360
[ 的相关操作由 glob_range 进行处理, { 由 glob_set 进行处理,看注释就能大概知道这2个函数的基本处理逻辑
glob_range
/* 处理以’['后紧跟的范围表达式
- 字符范围:如"a-z]",“B-Q]”
- 数字范围:如"0-9]",“17-2000]”
- 带前导零的数字范围:如"001-999]" 对表达式进行合法性检查,并将其收集直到下一个’]’ */
glob_set
/* 处理以’{‘后紧跟的集合表达式 用逗号分隔的元素将被收集,直到下一个闭合的’}’ */
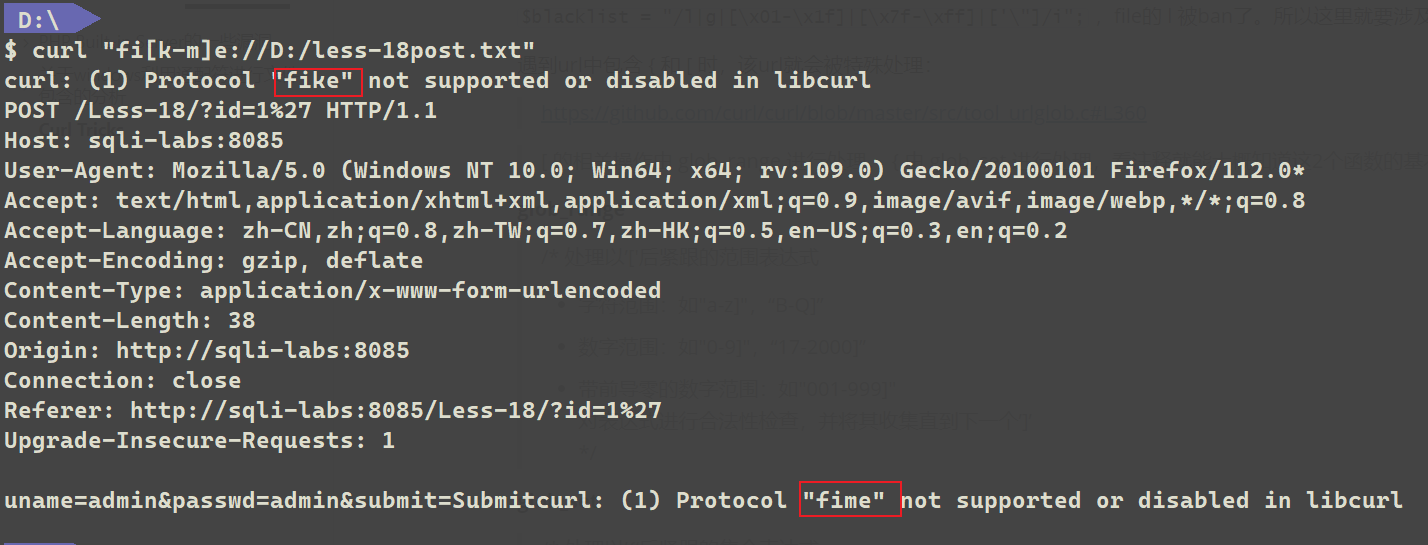
举个例子: 'fi[k-m]e:///etc/passwd' 会解析成3个url
fike:///etc/passwd file:///etc/passwd fime:///etc/passwd
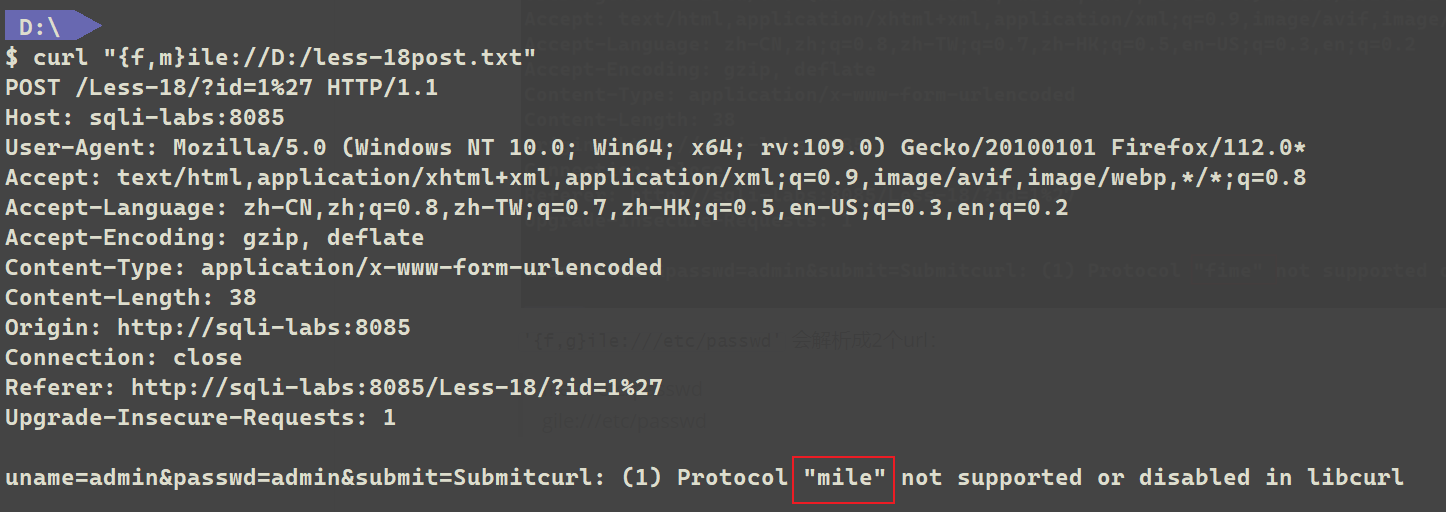
'{f,m}ile:///etc/passwd' 会解析成2个url:
file:///etc/passwd gile:///etc/passwd
通过这个trick我们可以衍生出一些curl奇技淫巧,比如主机扫描、端口扫描等等:
curl 'http://127.0.0.1:{80,8080,8000}/' # 扫描特定端口 curl 'http://127.0.0.1:[80-1000]/' # 扫描某个范围的端口 curl 'http://172.27.190.[1-254]:80' # 扫描C段的80端口 curl 'http://172.27.190.[1-254]:{80,8080}' # 扫描C段的80和8080端口 ...
PS:需要注意的是 {} 和 [] 是可以出现在url任何位置的,包括get参数如果不url编码的话也会被curl特殊处理
关于Powershell一些Tricks
Here-String配合Invoke-Expression
如果你想通过Powershell发起一个可以携带自定义header的get/post请求
有两种方法
第一种:
你只需要先使用cmd输入powershell.exe,然后键入以下代码:
$code = @' $webClient = New-Object Net.WebClient
$webClient.Headers.Add("Cookie", "TonyD0g=123456789")
$webClient.DownloadString("http://127.0.0.1/a") '@

Invoke-Expression -Command $code
第二种:
生成一个ps1文件,然后再执行这个ps1文件:
能执行,但是生成的ps1文件里变量$webClient都消失了,搞了好久也没搞懂,看看有没有师傅会吧.
powershell.exe -Command New-Item -Path C:\ -Name script.ps1
-ItemType File -Value '$webClient = New-Object Net.WebClient
$webClient.Headers.Add(\"Cookie"\, \"TonyD0g=123456789"\)

IEX ($webClient.DownloadString(\("http://127.0.0.1/a")\)'
在 PowerShell 脚本中,使用
@' '@或@""@语法可定义包含多行文本的字符串,这被称为 Here-String(行内字符串)。Here-String 使用
@' '@或@“"@括起来,类似于多行注释。这两种语法的区别在于@' '@保留字符串中的格式和空格,而@”"@对字符串中的特殊字符进行解析和替换。
利用URN绕过URL
所有ur开头的scheme,还有blob:、data:,这些“是一个url,又不全是一个url”的url,其pathname是不会有/前缀的。
同时Java里如果对URL进行检查,我们可以通过增加“url:”前缀来尝试绕过:new URL(url:hxxp://example.com);
补充一下,“URL”不仅限于http。
import java.io.BufferedReader;
import java.io.IOException;
import java.io.InputStreamReader;
import java.net.URL;
import java.net.URLConnection;

public class Test {
    public static void main(String[] args) {
        try {
            // 创建URL对象
            URL url = new URL("url:file:///D:test.txt");

            // 打开URL连接
            URLConnection connection = url.openConnection();

            // 建立实际的连接
            connection.connect();

            // 读取页面内容
            BufferedReader reader = new BufferedReader(new InputStreamReader(connection.getInputStream()));
            String line;
            StringBuilder content = new StringBuilder();
            while ((line = reader.readLine()) != null) {
                content.append(line);
            }
            reader.close();

            // 输出页面内容
            System.out.println(content.toString());
        } catch (IOException e) {
            e.printStackTrace();
        }
    }
}
浏览器和编程语言对url的解析差异
浏览器会将///example.com这样的链接解析为host是example.com的链接
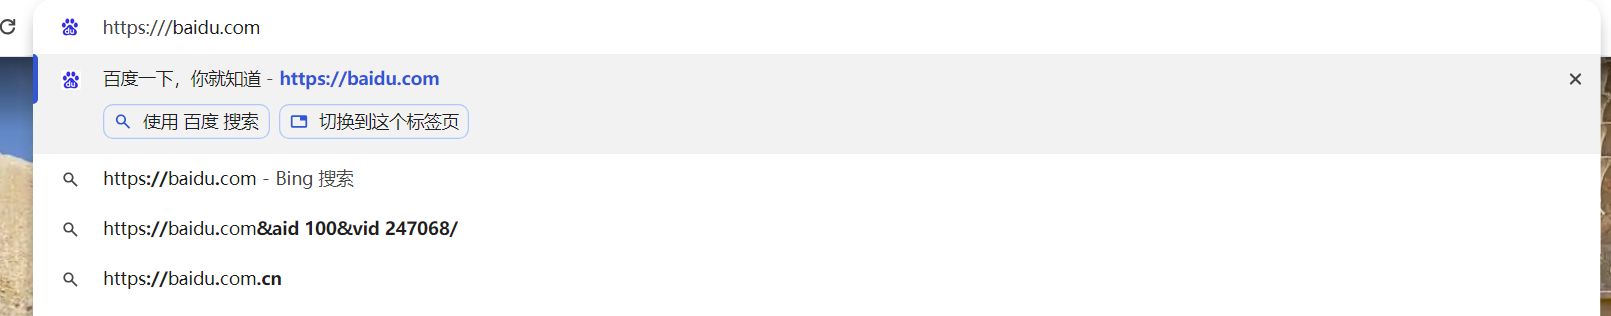
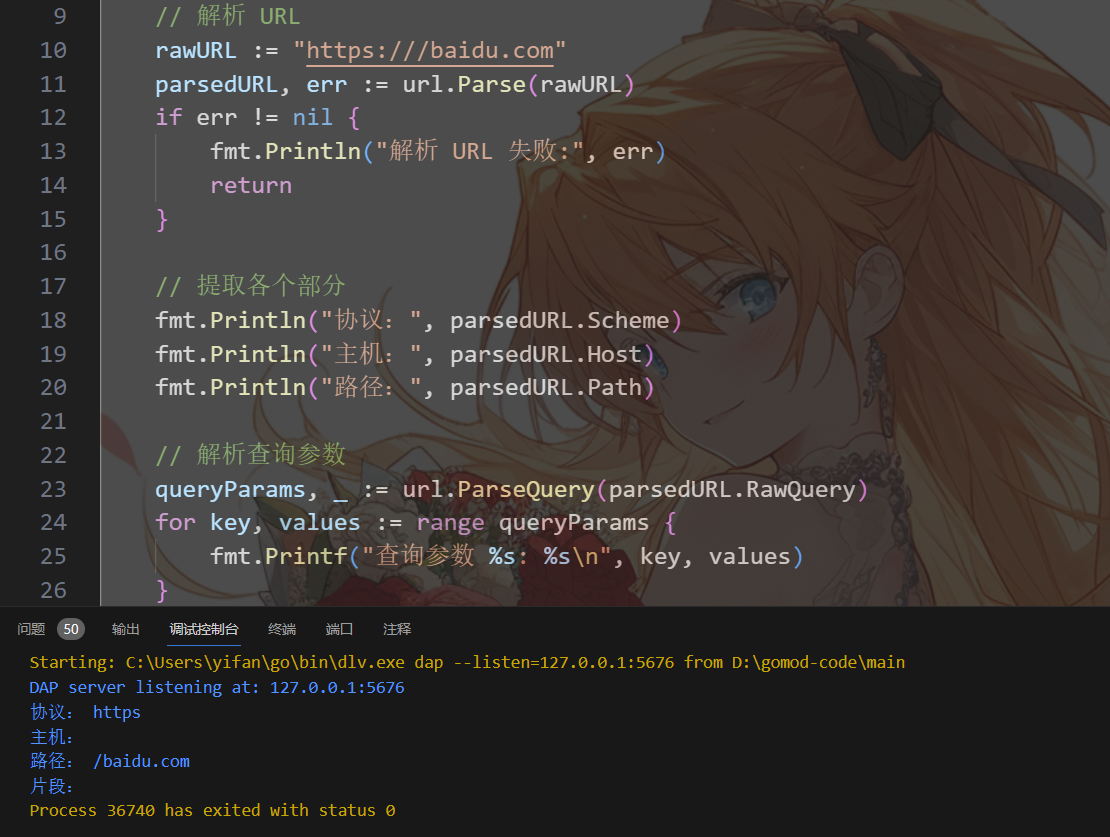
而在go或python等编程语言对URL的解析中,则会将其理解为host为空,path为/example.com的链接。
go的net/url解析,实测net/http并不会有这个差异
python urllib库解析url
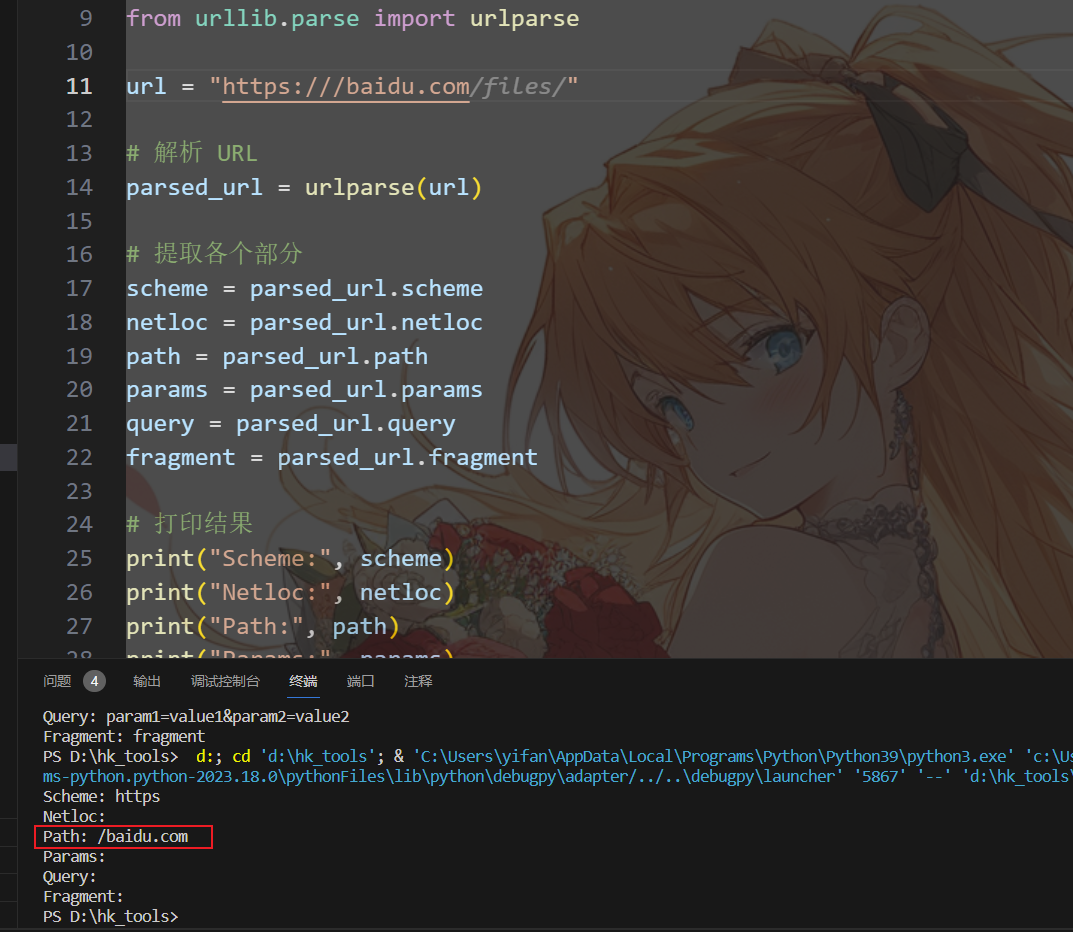
这就造成了一个差异,进而可能导致任意链接跳转这样的Bug。 这种问题通常不会造成SSRF检测的绕过,因为差异是出现在浏览器和编程语言间,除非发送请求的是浏览器引擎。
利用点:
- 具体的危害就是,使⽤上⾯的payload构造钓⻥链接,⽤⼾点击后,就会带着CAS返回的 trustDomain对应的 service 的登录凭证跳转到攻击者的VPS,导致登录凭证泄露。
- 可以利⽤在开放性重定向这种位置,毕竟⼤多是后端逻辑在遇到 Host 为空的情况都是认定为本站跳转。
golang net/http
CONNECT method
In the Go programming language, a common practice when handling HTTP requests, specifically using the net/http library, is the automatic conversion of the request path into a standardized format. This process involves:
- Paths ending with a slash (
/) like/flag/are redirected to their non-slash counterpart,/flag. - Paths containing directory traversal sequences such as
/../flagare simplified and redirected to/flag. - Paths with a trailing period as in
/flag/.are also redirected to the clean path/flag.
However, an exception is observed with the use of the CONNECT method. Unlike other HTTP methods, CONNECT does not trigger the path normalization process. This behavior opens a potential avenue for accessing protected resources. By employing the CONNECT method alongside the --path-as-is option in curl, one can bypass the standard path normalization and potentially reach restricted areas.
The following command demonstrates how to exploit this behavior:
https://github.com/golang/go/blob/9bb97ea047890e900dae04202a231685492c4b18/src/net/http/server.go#L2354-L2364
关于正则首尾界定符的tricks
m限定符的多行匹配
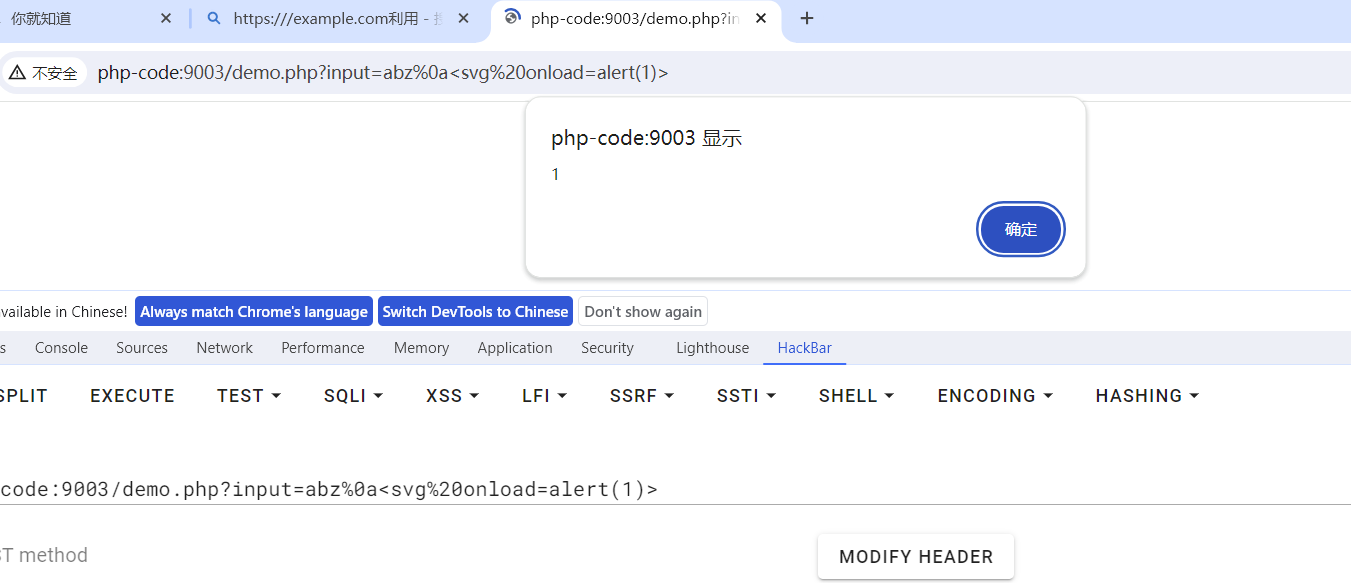
可以看到,加一个换行就可以绕过检测
<?php
if(preg_match('/SELECT.+FROM/i', $_GET['input'])) {
echo 'SQL Injection: ' . $_GET['input'];
} else {
echo 'Bypass: ' . $_GET['input'];
}
这个代码是想拦截select from这种形式
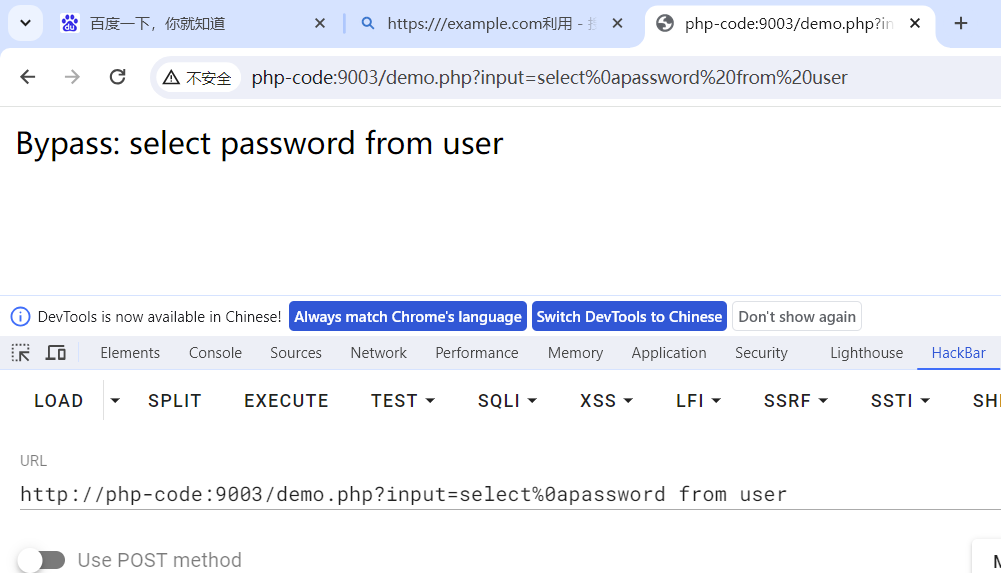
可以看到即使我没有使用m修饰符,仍然可以加一个换行就绕过检测
single-line和multi-line
multi-line表示按行来匹配正则,可以理解为,将待匹配的文本用换行符分割后,每一部分都对其进行正则匹配,并将结果用OR运算来计算,得出最终结果。这也解释了为什么错误一中我们可以通过 abz%0a<svg%20onload=alert(1)> 来绕过检测了,因为 abz这部分通过了匹配,导致 preg_match 返回1。
相对的,这篇文档中single-line的意思是将待匹配的文本视为一行,换行符不再作为“换行”的标志。在正则语法中, . 匹配的是“除了换行以外的所有字符”,在single-line的语境下,因为换行符不再作为换行,所以 . 也就可以匹配上换行符了。
那么这个时候问题来了,如果我们既不加 s 也不加 m ,这个正则究竟是single-line还是multi-line?
结果是0。说明这里并不是multi-line。
结果是0。说明
.没匹配上\n,又好像是multi-line。这里出现了矛盾。
所以perl文档说s修饰符是“Treat the string as single line”,这个描述是不对的。s并不能指定正则是否是single-line,因为PCRE正则默认情况下就是single-line,而s的意思只是“ . 是否能匹配上换行”。 那么,现在我们就可能遇到如下多种情况:
- 不加s或m修饰符 -> single line,但
.不能匹配换行符 - 单独加s修饰符 -> single line,且
.匹配包括换行符在内的所有字符 - 单独加m修饰符 -> multi line
- 同时加m和s两个修饰符 -> multi line,且
.匹配包括换行符在内的所有字符
有关^和$的一些事
回到本文的主题, ^ 和 $ 又和single-line、multi-line有什么关系呢?
^ 和 $ 原本表示的意思是“匹配行的开始和行的结束”,所以,他们在single-line与multi-line两个情境下就会有差异了。
在multi-line时,因为是多行模式,所以 ^ 和 $ 只需要匹配上其中一行就行了,这也是错误一的原因所在。
在single-line时,我们将整个文本视为一行,所以 ^ 和 $ 自然就可以理解为文本的开头和结尾了。很多人对于这两个符号的理解也正因为PCRE正则默认情况下是single-line,所以你将他们俩理解为匹配文本的开始和结束,是“没有”太大问题的。
为什么我为“没有”两个字加了引号?因为其实还是会存在一些些差异,比如看下面这个例子:
开发者将 ^ 和 $ 理解为匹配文本的开始和结束,但这里可以发现,我在文本的末尾加了一个换行,但这个正则匹配仍然返回了1。
虽然影响不大,但有一些违背开发者的初衷吧,毕竟开发者希望文本以z结尾,而不是换行符结尾。
导致这个结果的原因是,“行”这个事物本身就会存在两种情况:
- 非最后一行的“行”,其结尾就是换行符
- 最后一行,其结尾就是字符串结尾
所以, $ 也就可以匹配两种情况:字符串结尾或换行符。即使在single-line模式下,“行”的性质仍然是不变的
解决问题的方法
那么,如果我们不想让这件事发生,可以怎么办?
@ryat老师在回复中说到了一个修饰符 D 。 D 是PHP中独有的修饰符,其作用就是告诉引擎 $ 仅匹配文本结尾,不再匹配到一个换行符。
那么,非PHP环境下如何解决这个问题呢?在此之前,我们先屡一下正则中所有具有“首尾”界定符意思的字符:
-
^ -
$ \A\Z\z
一共五个,前两个就不说了,第三个 \A 表示“字符串的开头”,第四个 \Z 表示行的结尾,其效果其实和$ 完全一样,第五个 \z 表示“字符串的结尾”。
所以,其实 \A 和 \z 这两个界定符才是真正表示“字符串开头”和“字符串结尾”的,我们一直错误地使用^ 和 $ 其实只是碰巧没有出现问题罢了。
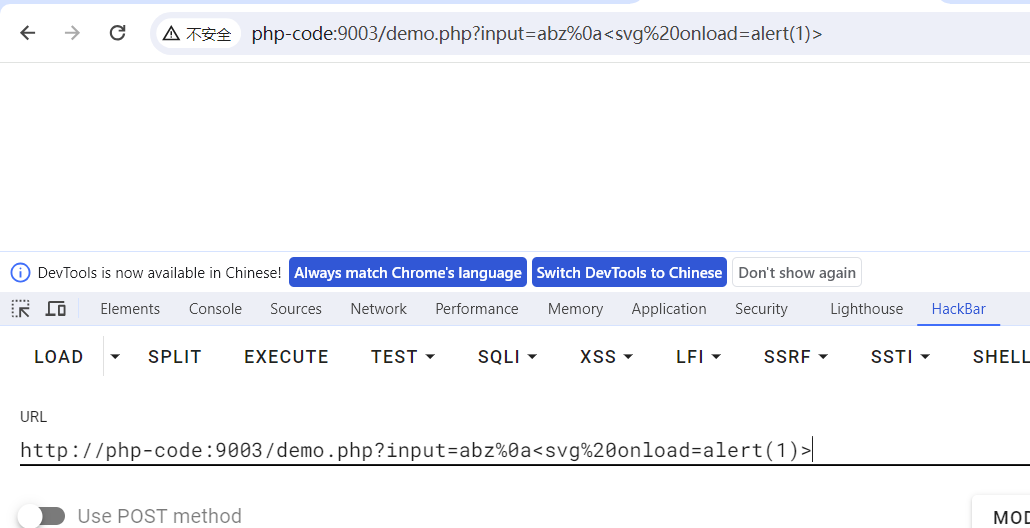
可以看到这样就不会被换行绕过了
关于POST中绕过Waf的研究
Web 应用防火墙,主要用途是对 HTTP(s)协议进行校验,拦截恶意的攻击请求,放行正常的业务请求。从架构来看,主要分为:网络
层、应用层、云 WAF 三类。从绕过来看,分为通用型绕过和单一规则绕过。通用型绕过即完全绕过 WAF 防护,一旦产生绕过后,可以
利用该 Payload 实现任意一种攻击;而单一规则绕过,则仅能够绕过特定规则,例如:SQL 注入规则中使用 select-1.1from……来绕过
select\b[\s\S]*\bfrom 这一正则规则,绕过以后仅能够实现 SQL 注入攻击。我所致力研究的属于前者。从网络层、应用层、云 WAF 三类
场景来看他们的绕过思路也有所区别,例如,对于传统的网络层 WAF,采用 chunked 编码即可绕过,目前多数 WAF 厂商已经修复,但
是我们仍然可以在网络层发包这一方向进行尝试和探索。对于应用层 WAF,WAF 的处理引擎是经过前端 Nginx 或 Apache(大多数场景
都是 Nginx 及 Tengine)完成 HTTP 协议初步解析以后,再转发给 WAF 处理引擎的,因而一些网络层组包的技术是无法绕过的。那么就
需要我们去研究:对于一个 HTTP 请求,Nginx 解析了什么内容?交给后面的 PHP、ASP 又解析了什么内容?
本文介绍的思路主要围绕: multipart/form-data。主要针对于 POST 参数的,对于漏洞点在 GET 参数位置则用处不大。
multipart/form-data 。我们知道,HTTP 协议 POST 请求,除了常规的 application/x-wwwform-urlencoded 以外,还multipart/form-
data 这种形式,主要是为了解决上传文件场景下文件内容较大且内置字符不可控的问题。multipart/form-data 格式也是可以传递 POST
参数的。对于 Nginx+PHP 的架构,Nginx 实际上是不负责解析 multipart/form-data 的 body 部分的,而是交由 PHP 来解析,因此 WAF
所获取的内容就很有可能与后端的 PHP 发生不一致。
测试脚本
Linux-Proc目录的一些利用
在 CTF 中经常会用到 /proc 这个目录来进行绕过,利用它里面的一些子目录或文件读取网站源码或者环境信息等,甚至直接读取flag或者直接Getshell。下面我们就简单总结一下 /proc 目录是什么以及他的作用。
Linux系统上的/proc目录是一种文件系统,即proc文件系统。与其它常见的文件系统不同的是,/proc 是一种伪文件系统(也即虚拟文件系统),存储的是当前内核运行状态的一系列特殊文件,用户可以通过这些文件查看有关系统硬件及当前正在运行进程的信息,甚至可以通过更改其中某些文件来改变内核的运行状态。
简单来讲,/proc 目录即保存在系统内存中的信息,大多数虚拟文件可以使用文件查看命令如cat、more或者less进行查看,有些文件信息表述的内容可以一目了然,但也有文件的信息却不怎么具有可读性。
/proc 目录中包含许多以数字命名的子目录,这些数字表示系统当前正在运行进程的进程号(PID),里面包含对应进程相关的多个信息文件:
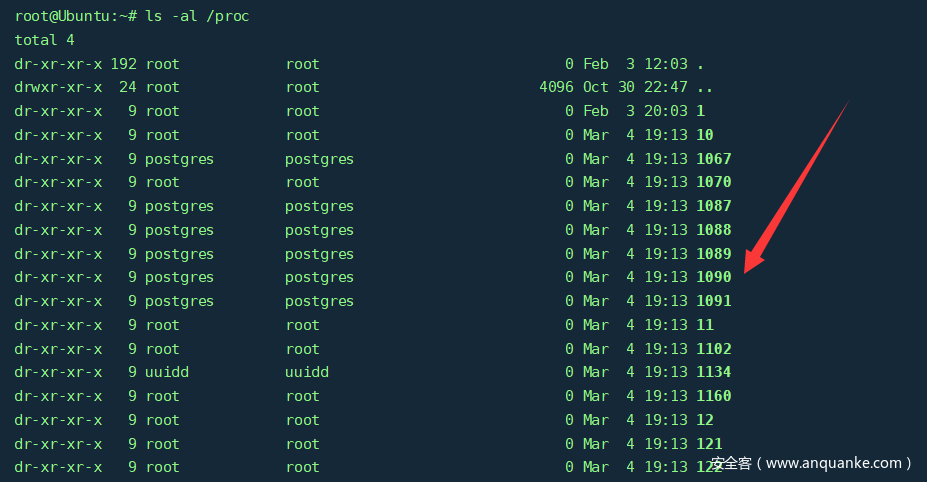 下面我们简单介绍一下
/proc 目录中的常见文件夹与文件。
上面列出的是 /proc 目录中一些进程相关的目录,每个目录中是其进程本身相关信息的文件。下面是系统上运行的一个PID为1090的进程的相关文件,其中有些文件是每个进程都会具有的:
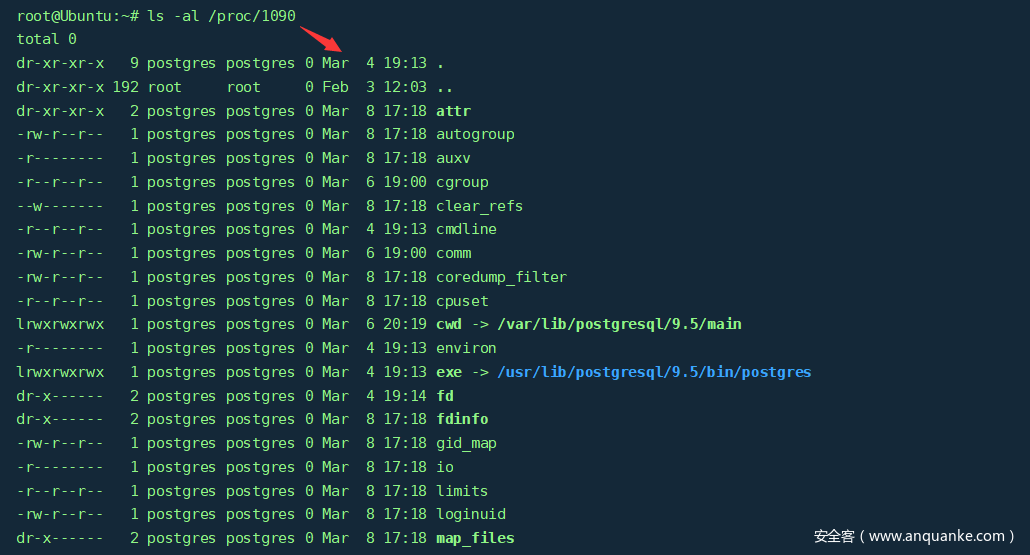
这里简单讲几个与题目相关的进程文件:
cmdline
cmdline 文件存储着启动当前进程的完整命令,但僵尸进程目录中的此文件不包含任何信息。可以通过查看cmdline目录获取启动指定进程的完整命令:
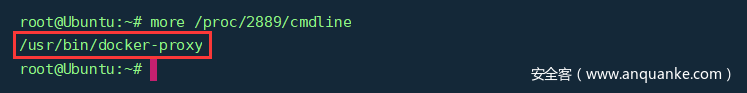
可知PID为2889的进程的启动命令为/usr/bin/docker-proxy。
cwd
cwd 文件是一个指向当前进程运行目录的符号链接。可以通过查看cwd文件获取目标指定进程环境的运行目录:
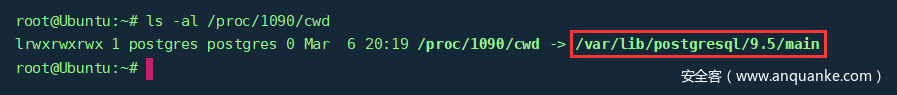
可见PID为1090的进程的运行目录为/var/lib/postgresql/9.5/main,然后我们可以直接使用ls目录查看该进行运行目录下的文件:
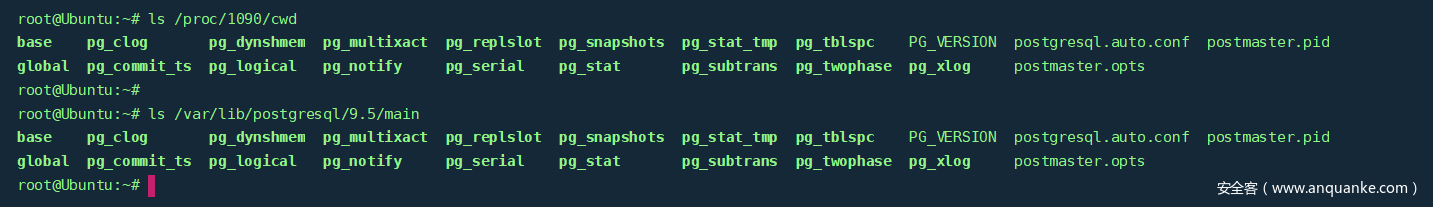
如上图所示,与直接查看/var/lib/postgresql/9.5/main目录的效果是一样的。
exe
exe 是一个指向启动当前进程的可执行文件(完整路径)的符号链接。通过exe文件我们可以获得指定进程的可执行文件的完整路径:

environ
environ 文件存储着当前进程的环境变量列表,彼此间用空字符(NULL)隔开。变量用大写字母表示,其值用小写字母表示。可以通过查看environ目录来获取指定进程的环境变量信息:

常用来读取环境变量中的SECRET_KEY或FLAG。
fd
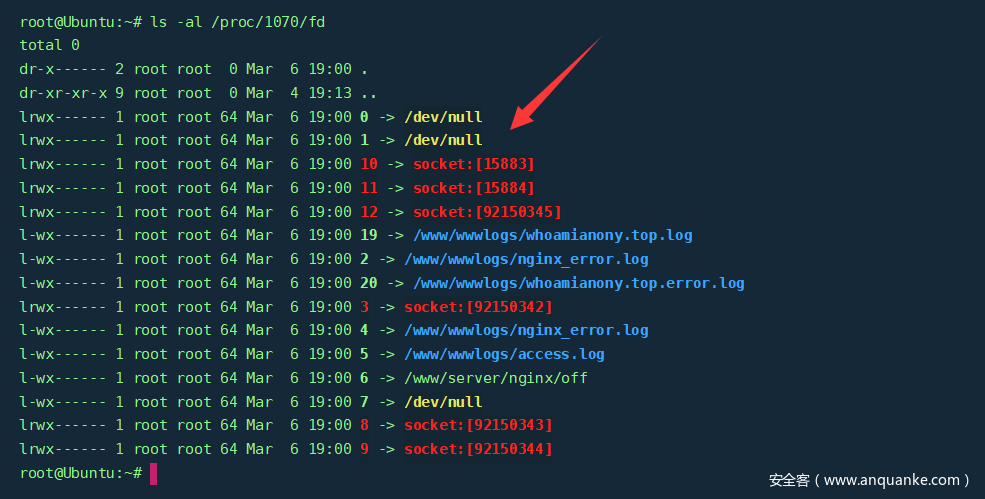
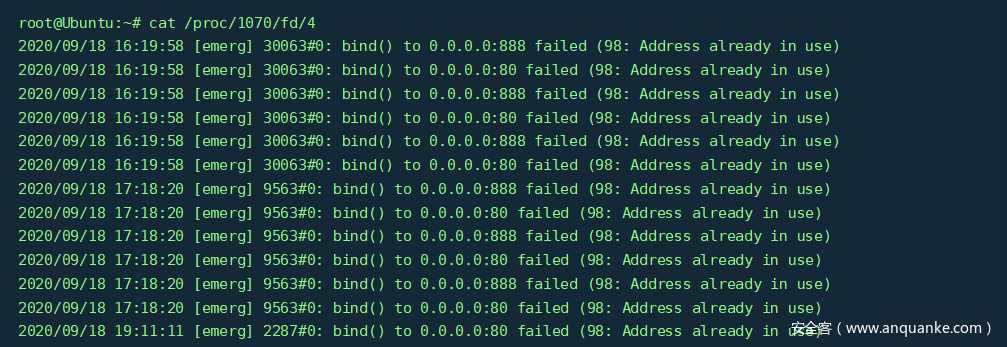
fd 是一个目录,里面包含这当前进程打开的每一个文件的文件描述符(file descriptor),这些文件描述符是指向实际文件的一个符号链接,即每个通过这个进程打开的文件都会显示在这里。所以我们可以通过fd目录里的文件获得指定进程打开的每个文件的路径以及文件内容。
查看指定进程打开的某个文件的路径:
查看指定进程打开的某个文件的内容:
这个fd比较重要,因为在 linux 系统中,如果一个程序用open()打开了一个文件但最终没有关闭他,即便从外部(如os.remove(SECRET_FILE))删除这个文件之后,在 /proc 这个进程的 pid 目录下的 fd 文件描述符目录下还是会有这个文件的文件描述符,通过这个文件描述符我们即可得到被删除文件的内容。
self
上面这些操作列出的都是目标环境指定进程的信息,但是我们在做题的时候往往需要的当前进程的信息,这时候就用到了 /proc 目录中的 self 子目录。
/proc/self 表示当前进程目录。前面说了通过 /proc/$pid/ 来获取指定进程的信息。如果某个进程想要获取当前进程的系统信息,就可以通过进程的pid来访问/proc/$pid/目录。但是这个方法还需要获取进程pid,在fork、daemon等情况下pid还可能发生变化。为了更方便的获取本进程的信息,linux提供了 /proc/self/ 目录,这个目录比较独特,不同的进程访问该目录时获得的信息是不同的,内容等价于 /proc/本进程pid/ 。进程可以通过访问 /proc/self/ 目录来获取自己的系统信息,而不用每次都获取pid。
有了self目录就方便多了,下面我们演示一下self的常见使用。
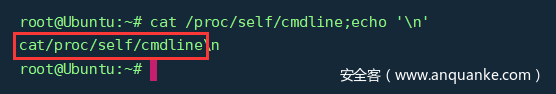
- 获取当前启动进程的完整命令:
- 获取目标当前进程环境的运行目录与目录里的文件:
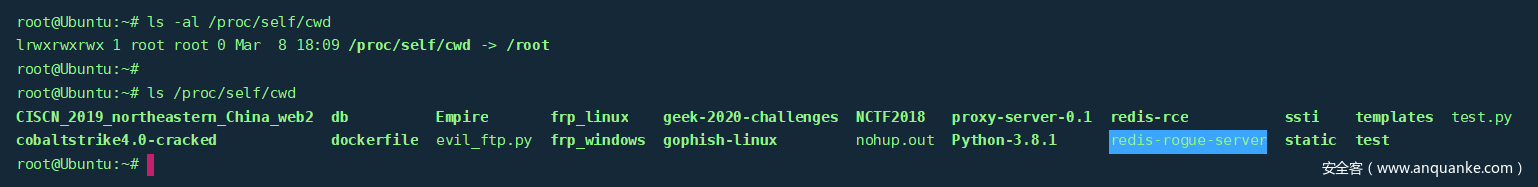
当不知道目标网站的Web路径或当前路径时,这经常使用
- 获得当前进程的可执行文件的完整路径:
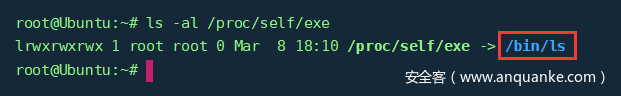
- 获取当前进程的环境变量信息:
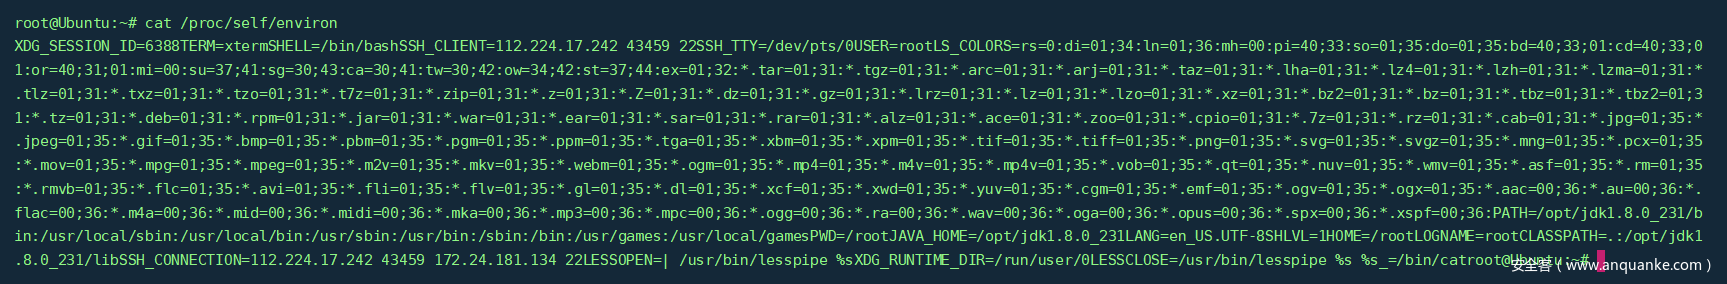
- 获取当前进程打开的文件内容:
下文在题目中演示。
**注意:**在真正做题的时候,我们是不能通过命令的方式执行通过cat命令读取cmdline的,因为如果是cat读取/proc/self/cmdline的话,得到的是cat进程的信息,所以我们要通过题目的当前进程使用读取文件(如文件包含漏洞,或者SSTI使用file模块读取文件)的方式读取/proc/self/cmdline。
例题示例:https://www.anquanke.com/post/id/241148#h2-1