Yara规则编写
YARA 概念
YARA是一种用于识别和分类恶意软件样本的开源工具。其主要目的是通过定义规则来匹配文件中的模式,从而检测恶意软件。YARA规则由一组条件组成,这些条件可以是字符串、正则表达式或其他特征。YARA的灵活性和强大功能使其成为恶意软件分析师和逆向工程师的常用工具。
YARA 是由 Victor M. Alvarez 发明的。Victor M. Alvarez 是一位西班牙的网络安全专家,他在 2008 年首次发布了 YARA。这款工具的设计初衷是帮助恶意软件分析师快速识别和分类恶意软件样本。YARA 名字的来源是“Yet Another Recursive Acronym”的缩写,这种自我递归的命名方式本身也是计算机科学中的一种幽默。
Victor M. Alvarez 在 VirusTotal 工作期间开发了 YARA,而 VirusTotal 是一个流行的在线病毒扫描服务,能够通过多种杀毒引擎和工具来分析文件和URL。这使得 YARA 能够利用 VirusTotal 平台上的大量恶意软件样本进行测试和改进。随着时间的推移,YARA 逐渐发展成为恶意软件分析和威胁检测的标准工具,被广泛应用于网络安全领域。
YARA 规则的主要特点
- 模式匹配: YARA 规则扫描文件中的特定模式,例如文本字符串、正则表达式或十六进制序列,以识别已知和变种的恶意软件。
- 布尔逻辑: 这些规则使用布尔逻辑来组合多种条件,从而实现更精确的威胁检测。
- 跨平台使用: YARA 可以跨多个平台扫描多种文件类型(例如可执行文件、PDF、档案),因此用途非常广泛。
YARA 规则的结构
基本 YARA 规则由三个主要部分组成:
- 元数据:提供有关规则的其他信息,例如其名称、作者和描述。
- 字符串:列出 YARA 在文件或进程内搜索的模式或字符串。
- 条件:定义这些模式必须如何匹配才能触发检测。
// example, it is like C
rule ExampleRule {
    meta:
        author = “John Doe”
        description = “This is an example YARA rule”
        date = “2024-06-24”
    strings:
        $text_string = “example text”
        $hex_string = { 6A 2E 68 74 74 70 }
    condition:
        $text_string or $hex_string
}
condition定义了匹配的条件,text_string和hex_string两个条件任意一个都会被认定为是ExampleRule
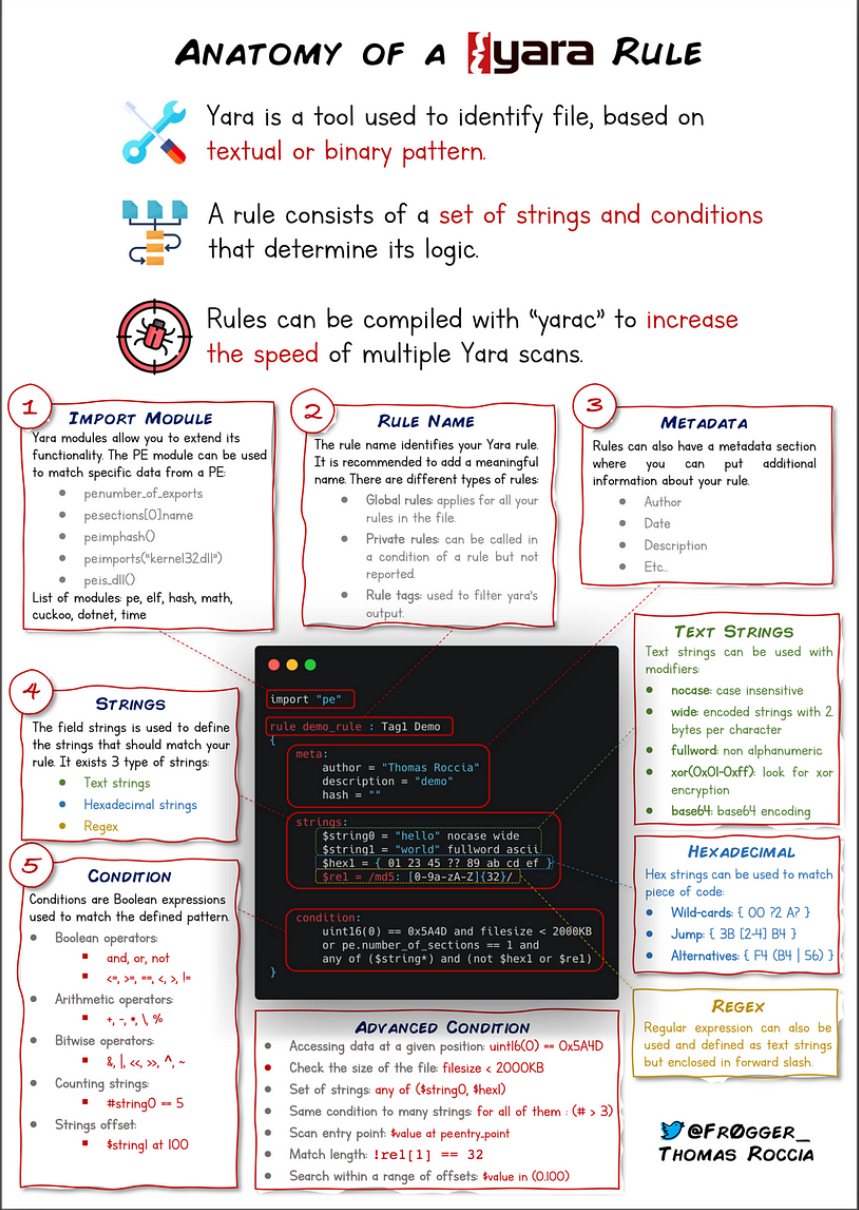
YARA 规则如何运作
YARA 规则由两个主要部分组成
- 狀況: 定义文件或进程必须匹配的特征才会被视为恶意。这些特征可以基于文本字符串、正则表达式或文件元数据等属性。
- 元数据: 这提供了有关规则的更多详细信息,例如名称、作者和描述,使其更易于管理和引用。
YARA 规则的主要优势
- 灵活性: 您可以自定义 YARA 规则来检测各种恶意软件类型,使其适应不同的安全需求。
- 高效: 其处理速度很快,适合实时恶意软件检测。
- 可扩展性: 它可以处理大量数据,确保它们在具有广泛文件系统和网络的环境中高效工作。
- 社区支持: YARA 拥有强大的用户社区,他们定期分享指南、最佳实践和更新,以应对新的安全威胁。
YARA 编写
整体规范
yara的每条规则都以关键字rule开头,后面跟规则标识符。标识符必须遵循与C编程语言相同的词汇约定,它们可以包含任何字母数字字符和下划线字符串,但是第一个字符不能是数字,规则标识符是区分大小写的,不可以超过128个字符。
以下关键字是保留的,不能用作标识符:
| all | and | any | ascii | at | base64 | base64wide | condition |
|---|---|---|---|---|---|---|---|
| contains | endswith | entrypoint | false | filesize | for | fullword | global |
| import | icontains | iendswith | in | include | int16 | int16be | int32 |
| int32be | int8 | int8be | istartwith | matches | meta | nocase | not |
| of | or | private | rule | startswith | strings | them | true |
| uint16 | uint16be | uint32 | uint32be | uint8 | uint8be | wide | xor |
规则部分通常是由两部分组成:字符串定义和条件。如果规则不依赖于任何字符串,则可以省略字符串定义部分,但始终需要条件部分。字符串定义部分是定义成为规则一部分的字符串的地方。每个字符串都有一个标识符,由$字符后跟一系列字母数字字符和下划线组成,这些标识符可以用于条件部分以引用相应的字符串。字符串可以以文本或者十六进制形式定义,如下所示:
rule test
{
    strings:
        $test_string="this is a test"
        $test_hex_value={11 22 33 44}
    condition:
        $test_string or $test_hex_value
}
文本字符串用双引号括起来,像在C语言中一样,十六进制数字用大括号括起来。
条件部分是规则逻辑所在。该部分必须包含一个布尔表达式,说明在何种情况下文件或者进程满足规则。通常。条件将通过使用它们的标识符来引用先前定义的字符串。在这种情况下,字符串标识符充当布尔变量,如果在文件或者进程内存中找到字符串,则该变量评估为真,否则为假。
注释
可以向规则中添加注释,像C一样,支持单行和多行注释。
rule test
{
    //这是单行注释
    strings:
        $test_string="this is a test"
        $test_hex_value={11 22 33 44}
    /*

        这是一个
        多行注释

    */
    condition:
        $test_string or $test_hex_value
}
字符串
yara中有三种类型的字符串:十六进制字符串、文本字符串和正则表达式。十六进制字符串用于定义原始字节序列,而文本字符串和正则表达式用于定义清晰文本的部分。然而,文本字符串和正则表达式也可用于转义序列来表示原始字节。
十六进制字符串
通配符和跳转
十六进制字符串允许三种特殊结构,使其更加灵活:通配符、跳转和替代。通配符只是一个占位符,表明某些字节是未知的,它们可以匹配任何内容。占位符是(?)。示例如下:
通配符在你知道字符串的可变块长度时很有用,然而,有时情况不是这样。某些情况下,可能需要定义具有可变内容和长度的块的字符串。在这些情况下可以使用跳转。
在上面的例子中,用方括号括起来0-7,这就是一个跳转,意思是任何0-7个字节的任意序列都可以占据此位置,比如这些字符都是可以匹配到当前规则的。
123456789
1xx9
19
1asdasd9
任何跳转的条件[X-Y]都必须满足Y>X的条件,如下是无效的
31 32 [10-2] 39
如果上下限相等,也就是说要匹配的数字的长度是固定的,可以写一个括在括号里的数字,如下所示
31 32 33 [2] 36
其等价于:
31 32 33 [2-2] 36
31 32 33 ?? ?? 36
从yara2.0开始还有无界跳转
31 32 [10-] 39
31 32 [-] 39
第一个的意思是10-无限,第二个意思是无限。
正则表达式
在某些情况下,可以使用正则表达式的语法
此规则将会匹配12349和12679
也可以将通配符结合起来,如下:
此时如果有一个字符串12A0G9的字符串也可以被检测到(这只是其中之一,可以根据条件自行构建字符串,并不是唯一的)
文本字符串
文本字符串都是这样定义的
这是最简单的情况:ASCII编码、区分大小写。文本字符串还可以包含以下C语言中可用的转义字符:
| \“ | 双引号 |
|---|---|
| \ | 反斜杠 |
| \r | 回车 |
| \t | 水平标签 |
| \n | 回车换行 |
| \xdd | 十六进制表示 |
文本字符串还可以附带一些有用的修饰符,这些修饰符可以改变字符串的解释方式。这些修饰符附加在由空格分隔的字符串定义的末尾。
不区分大小写
yara中默认文本字符串是区分大小写的,但是可以通过在字符串定义的末尾附加修饰符nocase将字符串转换为不区分大小写的模式。
宽字符串
给字符串加上 L 前缀就变成了宽字符串,他包含的每个字符都是宽字符,一律采用UTF-16或UTF-32编码。输出宽字符串可以使用 <wchar.h>头文件中的 wprintf函数,对应的格式控制符是%ls。
wide可以用于搜索宽字符串
如果想同时搜索ASCII和宽字节字符串,可以将ascii和wide结合起来
异或字符串
xor可以用于搜索字符串的单字节xor结果,比如以下规则可以搜索“this is a test”的每个字符的异或。
上面这个逻辑是等价于
rule test
{
    strings:
        $a = "dxyc0yc0q0ducd"// this is a test 异或0x10结果
        $b = "fz{a2{a2s2fwaf"// this is a test 异或0x12结果
        $c = {8b 97 96 8c df 96 8c df 9e df 8b 9a 8c 8b}
        //this is a test 异或0xFF结果
    condition:
        any of them
}
也可以将wide和ascii结合使用
从yara3.11开始,可以控制异或的范围,如下所示。
Base64字符串
base64可以用于搜索被base64编码过后的字符串,以下规则将搜索“this is a test”base64编码后的结果。
base64wide是搜索宽字符
搜索完整词
fullword该修饰符保证字符串仅出现在由非字母数字字符分隔的文件中时才匹配。
这种时候,比如iamb1ackie和www.b1ackieblog.com都是不匹配的,但是可匹配www.b1ackie.cn和www.b1ackie-blog.com
也就是说会将字符串分割为一个个word进行匹配
正则表达式
正则表达式是yara最强大的功能之一,它们的定义方式与文本字符串相同,使用正斜杠而不是双引号括起来。
这会匹配形如:md5:f10adc3949ba5dabbe56e357f20f883e的字符串
也可以在正则表达式中使用文本修饰符,nocase、ascii、wide和fullword。
正则表达式还可以识别以下元字符
| \ | 引用下一个元字符 |
|---|---|
| ^ | 匹配文件的开头 |
| $ | 匹配文件的结尾 |
| | | 交替 |
| () | 分组 |
| [] | 带括号的字符类 |
也可以使用以下量词
| * | 匹配0次或多次 |
|---|---|
| + | 匹配1次或多次 |
| ? | 匹配0或1次 |
| {n} | 完全匹配n次 |
| {n,} | 至少匹配n次 |
| {,m} | 最多匹配n次 |
| {n,m} | 匹配n到m次 |
这些量词还有一个非贪婪的变体,后面跟一个问号(?)
| *? | 匹配0次或多次,非贪婪 |
|---|---|
| +? | 匹配1次或多次,非贪婪 |
| ?? | 匹配0或1次,非贪婪 |
| {n}? | 完全匹配n次,非贪婪 |
| {n,}? | 至少匹配n次,非贪婪 |
| {,m}? | 最多匹配n次,非贪婪 |
| {n,m}? | 匹配n到m次,非贪婪 |
字符序列
| \w | 匹配一个单词字符(字母数字加_) |
|---|---|
| \W | 匹配一个非单词字符 |
| \s | 匹配一个空白字符 |
| \S | 匹配一个非空白字符 |
| \d | 匹配一个十进制数字字符 |
| \D | 匹配一个非数字字符 |
私有字符串
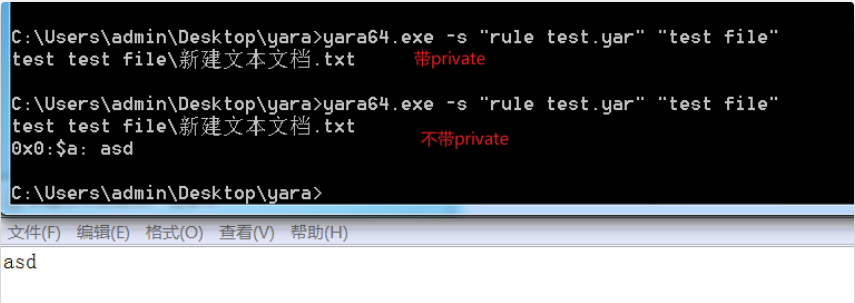
yara中的所有字符串都可以标记为private,这意味着它们将永远不会出现在yara的输出之中,当使用-s参数时也无法看到回显。
计数字符串
有时候不仅仅需要知道某个字符串是否存在,还需要知道该字符串在文件或者进程内存中出现了多少次。每个字符串出现的次数由一个变量表示,该变量的名称是字符串标识符,用#字符代替了$字符。
当a字符串刚好出现了六次,且b字符串出现次数小于三次,进行匹配
yara4.2.0后,
字符串偏移或虚拟地址
有些情况下,我们需要知道字符串是否在某个特定的偏移量文件或者进程地址空间内的某个虚拟地址,这种时候就可以使用at操作符。
上述规则是“test”在文件偏移为0xA或者是进程在虚拟地址0xA的地方,”123”同理
at是指定具体的地址,而使用in可以指定一个范围
rule test
{
    strings:
        $a = "test"
        $b = "123"
    condition:
        $a in (0..10) and $b in (10..filesize)
        // filesize: the end of file
}
这条规则是a字符串在偏移为0-10的地方且b字符串在10-文件末尾的地方。
如果把123在文件的开头,test在偏移10以后的位置,那么就无法检出了。
字符串集
在某些情况下,需要在条件中指定,至少存在多少字符串命中才符合要求,此时可以使用of
这条规则要求,\(a,\)b,$c至少存在两个才行,任意组合都可以。
在集合中也是可以使用通配符的。
也可以使用$*来表示规则中所有的字符串,也可以使用them
rule test1
{
    strings:
        $test1 = "test1"
        $test2 = "test2"
        $test3 = "test3"
    condition:
        2 of ($*)
}

rule test2
{
    strings:
        $test1 = "test1"
        $test2 = "test2"
        $test3 = "test3"
    condition:
        1 of them
}
在上面的示例中都使用了数字常量指定条件的字符串,也可以使用其他的表达式,any和all
all of them //所有规则中包含的字符串
any of them //任意字符串组合都可以,至少为一条
多个字符串应用相同条件
还有一个功能强大的运算符for..of,可以对多个字符串匹配相同的条件,语法是这样的:
for a of b : ©
在b字符串集合中,至少有a个字符串满足c的条件。
下面举一些例子
import "pe"
rule test
{
    strings:
        $a = {E8 C5 03 00 00}
        $b = {E8 01 00 00 00}
    condition:
        for any of ($a,$b) : ($ at pe.entry_point)
}
上述规则,是在a,b两个字符串集合中,至少有一个满足于pe.entry_point相同的条件。
上述规则,abc这三个字符串,任意组合只要出现超过两次就可以,至少是一组。
使用匿名字符串
当使用of,for..of,指定了them时,分配给规则中的每个字符串的标识符通常是多余的,因为并没有单独的引用某个具体的字符串,所以可以不需要为每个字符串都提供标识符。在这些情况下,可以只使用仅有$字符组成的标识符声明匿名字符串
迭代字符串
yara也可以写一个类似于C的FOR循环,语法是for..of
如下示例,可以检索所有PE文件中的区段,区段名为text的会命中规则。
import "pe"
rule test
{
    condition:
        for any section in pe.sections : (section.name == ".text")
        // section 节
}
条件
可以使用and,or以及not等来进行布尔运算,关系运算符>=,<=,<,>,==和!=,算数运算符+,-,*,\,%,,按位运算符&,|,<<,>>,~,^。
字符串标识符也可以在条件中使用,充当布尔变量,其值取决于文件中相关字符串的存在与否。
rule test
{
    strings:
        $a = "asd"
        $b = "123"
        $c = "zxc"
        $d = "987"
    condition:
        ($a or $b) and ($c or $d)
}
上述规则,\(a或者\)b的任何字符串命中以及同时\(c或者\)d命中就是满足条件。
文件大小
字符串标识符并不是唯一可以出现在条件中的变量(规则可以在没有任何字符串定义的情况下定义),还有一些其他的特殊变量可以使用,其中之一是filesize,就是文件大小,大小以字节表示。
这条规则只命中5KB以上大小的文件
可执行入口点
还有一个特殊变量是entrypoint,但是现在已经弃用了,3.0版本之后都使用pe.entry_point来代替了,请注意。
关于入口点,不同编译器的入口点可能略有不同,需要自己进行分析之后再编写规则。
会匹配entry_point == E8 C5 03 00 00的程序
引用其他规则
在编写规则之前,还可以使用类似函数调用的方式,引用之前定义的规则。
rule test1
{
    strings:
        $a = "test1"
    condition:
        $a
}

rule test2
{
    strings:
        $a = "test2"
    condition:
        $a and test1
}
全局规则
全局规则可以一次对所有的规则进行限制,比如想要限制文件的大小,可以定义一条全局规则来进行限制,而不用单独在每个规则中都进行大小限制。
规则标签
yara可以向规则添加标签。这些标签用于过滤yara的输出并且只显示感兴趣的规则。
rule test1 : test
{
    strings:
        $a = "test1"
    condition:
        $a
}

rule test2 : b1ackie
{
    strings:
        $a = "test2"
    condition:
        $a and test1
}
模块的使用
PE
https://yara.readthedocs.io/en/v4.2.3/modules/pe.html
模块是yara核心功能的扩展,一些模块,比如PE,Cuckoo是由yara官方发布的,其他模块可以由第三方创建。使用模块的第一步是使用import导入它。
搭配如模块后,可以使用其功能,用法是modulename.func比如
Magic
就是文件的 magic,可以file命令查看
Magic Module一共两个函数:
- type():returning a string with the type of the file.
magic.type() contains "PDF"
- mime_type():returning a string with the MIME type of the file.
magic.mime_type() == "application/pdf"
Hash
- MD5
- sha1
- sha256
Math
允许您从文件的某些部分计算某些值,并基于这些结果创建签名。
Console module
- log(string):
console.log(pe.imphash()) - log(message,string):
console.log("The imphash is: ", pe.imphash())
后面的参数不止可以string,int,float也可
包含文件
yara提供了include指令,它可以将其他规则文件包含到当前文件中。
相对路径
绝对路径
自动化编写 YARA
- yaragen
- YARA-CI
- yarAnalyzer
Refer
Welcome to YARA's documentation! — yara 4.1.0 documentation