HTTP1.1/HTTP2/HTTP3
HTTP/1.1(1999)
核心特性
- 基于 TCP;
- 每次请求需建立连接(或复用 Keep-Alive);
- 请求/响应是**纯文本格式**;
- 队头阻塞严重,阻碍性能;
- 没有多路复用,只能串行处理请求。
典型问题
- 串行阻塞:一个请求慢,后面的都等着;
- 多连接开销大:浏览器通常开启 6 个连接并发;
- 请求头重复、冗余严重;
- 加密可选,非强制(默认明文传输)。
HTTP/2(2015)
核心特性
- 基于 TCP + TLS(通常是 HTTPS);
- 引入 多路复用:一个连接内多个请求并行;
- 请求头压缩(HPACK);
- 二进制帧格式;
- 支持 服务器推送(Server Push)。
三大优势
- 多路复用,提升并发性能 一个 TCP 连接即可承载多个请求和响应,避免 HTTP/1 的“请求排队”。
- 请求头压缩,更节省带宽 相似的头部字段不再重复发送,降低数据传输体积。
- 服务端推送资源 服务器可主动推送客户端可能需要的资源,减少等待。
遗留问题
- TCP 队头阻塞仍然存在 虽然 HTTP 层解决了阻塞,但底层的 TCP 一旦丢包,整个连接上的所有流都会卡住。
- 连接恢复代价高 一旦断线,TCP + TLS 必须重新完整握手,导致性能下降。
HTTP/3(2020+)
核心特性
- 基于 QUIC 协议,使用 UDP;
- 内建 TLS 1.3 加密协商;
- 消除了 TCP 的队头阻塞;
- 原生支持连接迁移、恢复、0-RTT;
- 每个请求流(stream)真正独立,互不影响。
三大优势
- 更快连接:告别“握手多” HTTP/3 使用 QUIC(基于 UDP),将连接握手与加密协商合并,极大减少 RTT,移动网络更有优势。
- 更稳传输:断网也能恢复 QUIC 支持连接 ID + 多路复用 + 状态同步,即使中途断网或 IP 变化(如 Wi-Fi ⇄ 4G),连接仍能恢复。
- 更彻底解决“队头阻塞” QUIC 在传输层每个 stream 都独立,丢包只影响当前 stream,不影响其他请求。
QUIC 的加密机制概览
- 强制使用 TLS 1.3,连接与加密合并握手;
- 使用 AEAD 对称加密算法(如 AES-GCM、ChaCha20)加密所有数据;
- 每个 QUIC 包都有包号、身份验证、加密保护;
- 支持 0-RTT,允许在建立连接前发送早期数据;
- 前向安全性(PFS)强,抗重放攻击。
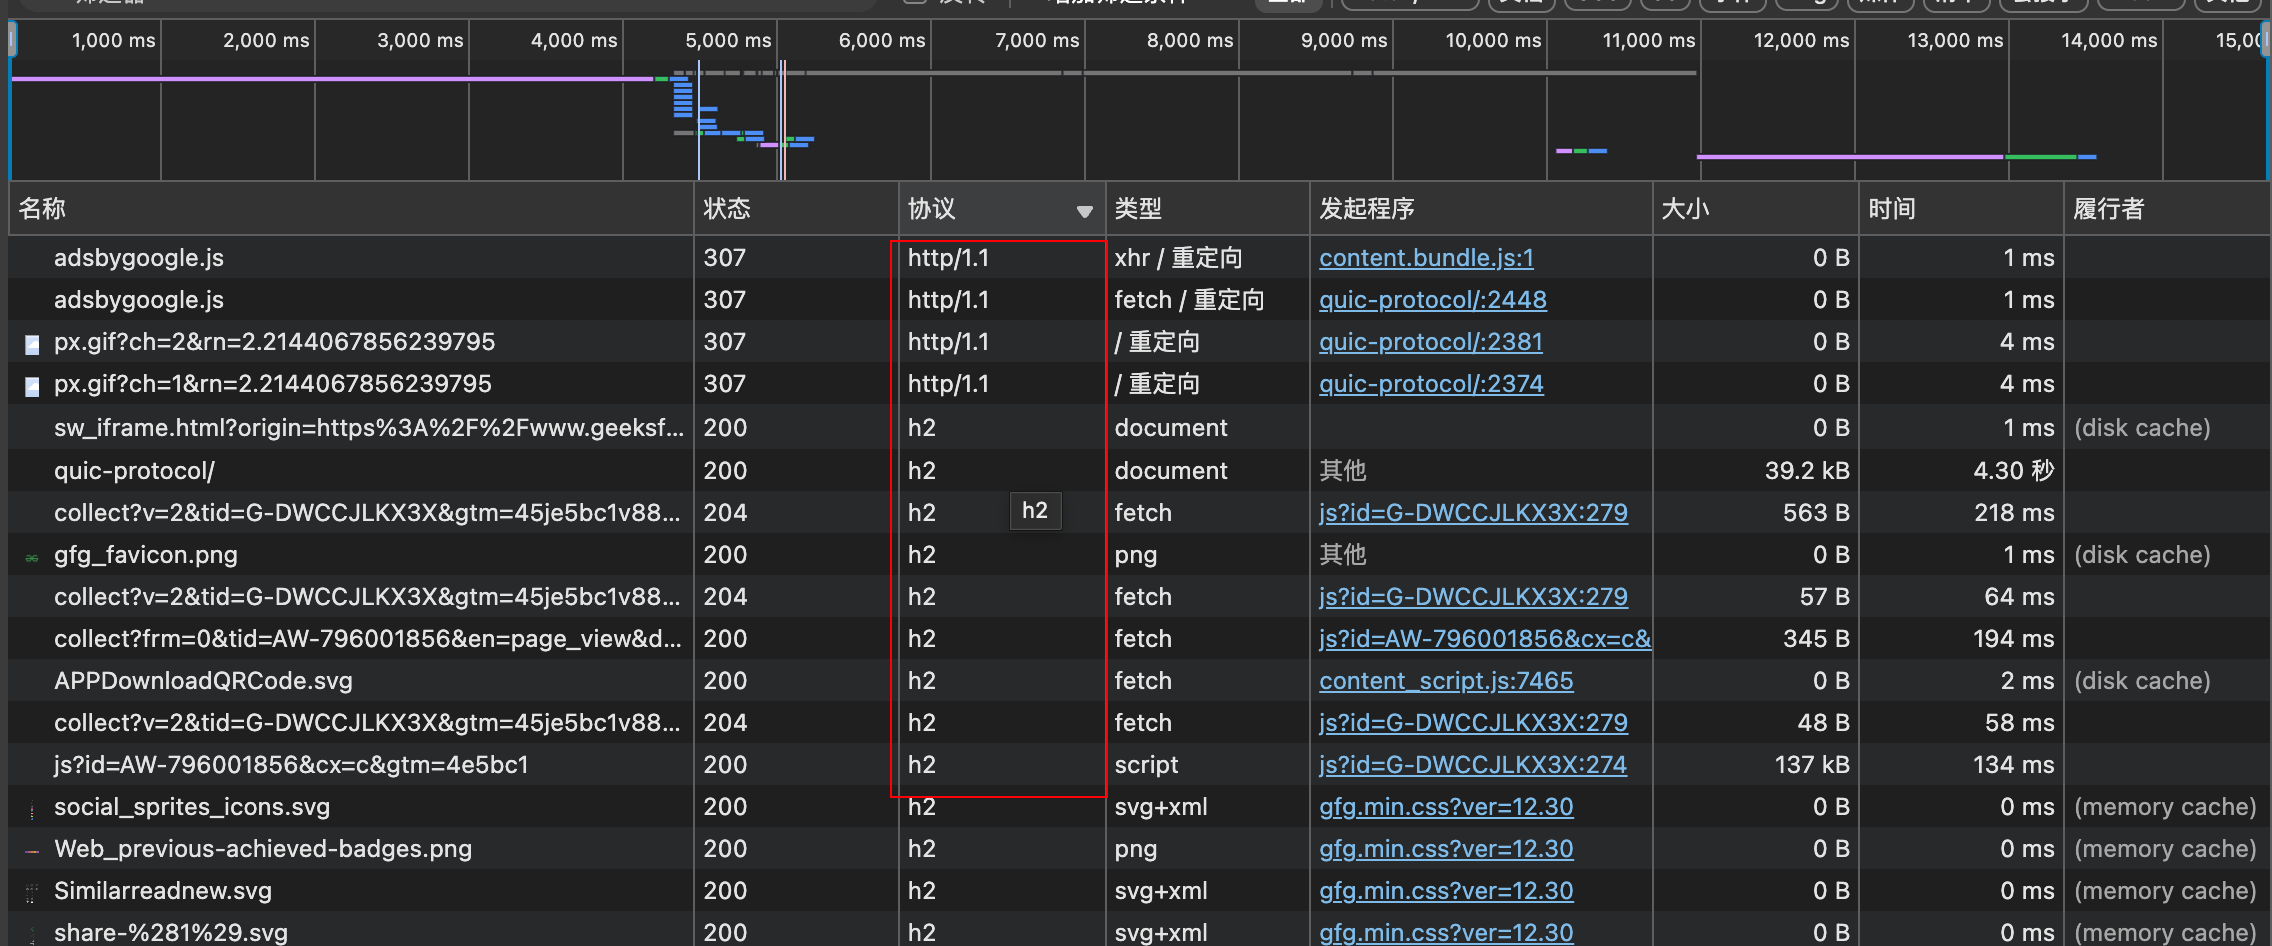
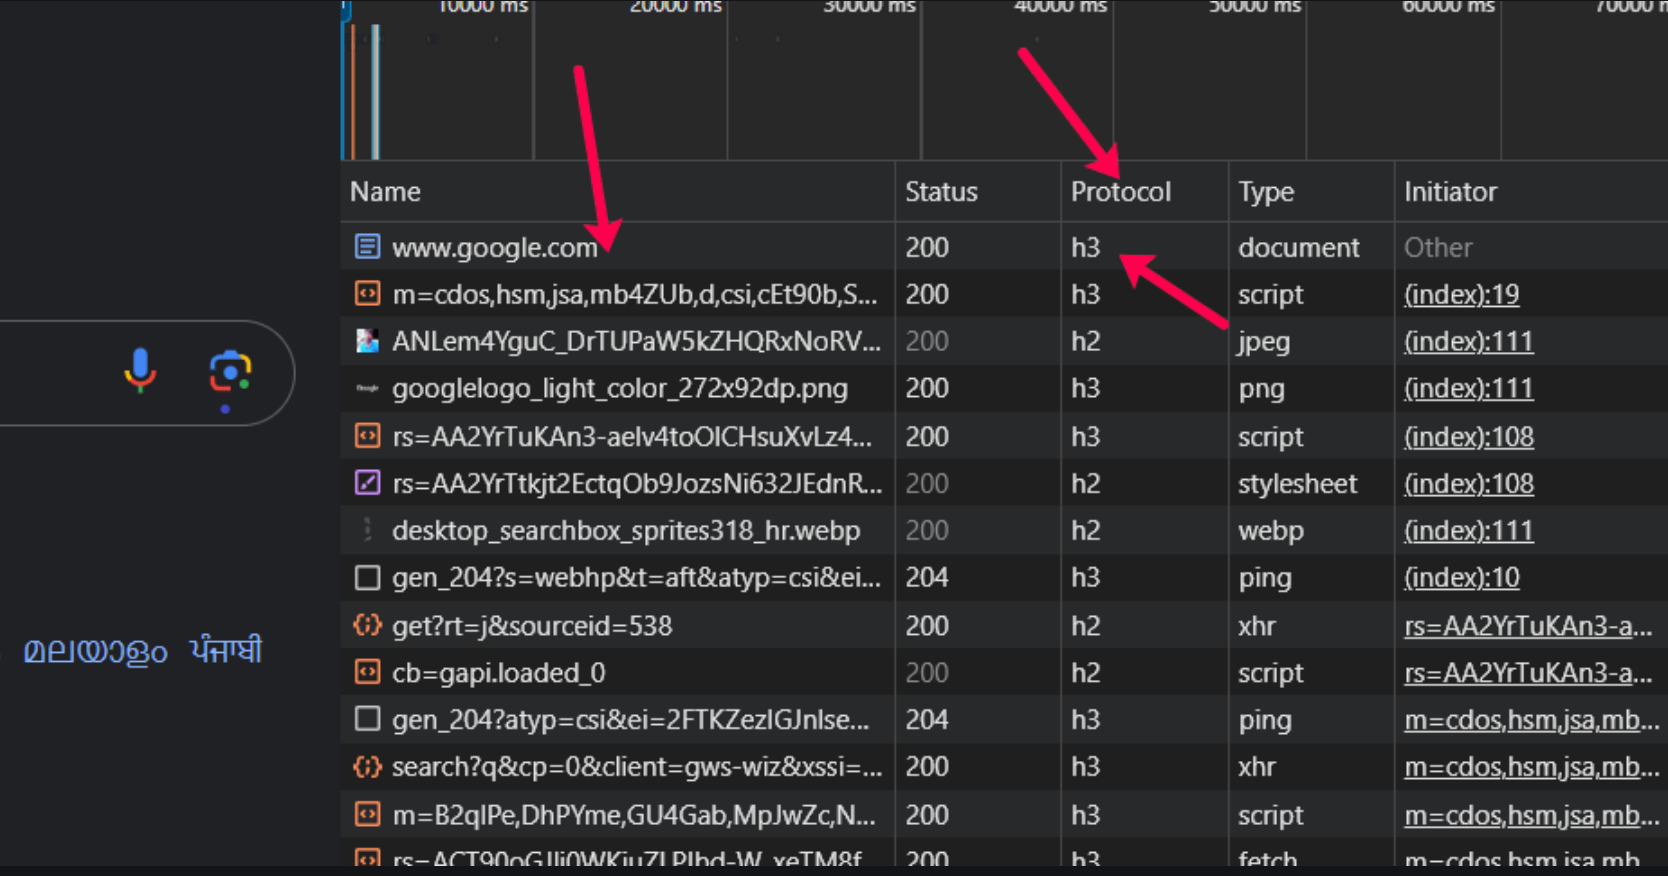
如何判断网站使用的协议?
- Open Developer Tools - Network Tab.
- Load a website (like www.google.com).
- Right-click the column headers and enable the Protocol column.
- If you see h3 or http/3, the site is using QUIC.
总结
| 特性 | HTTP/1.1 | HTTP/2 | HTTP/3 |
|---|---|---|---|
| 传输层协议 | TCP | TCP(通常 HTTPS) | UDP(基于 QUIC) |
| 加密机制 | 可选(HTTP) / TLS | 默认 TLS(HTTPS) | 强制 TLS 1.3(集成于 QUIC) |
| 并发能力 | 单请求排队 | 多路复用 | 真正独立流 |
| 队头阻塞(HOL) | 严重 | TCP 层仍有 | 完全消除 |
| 连接建立速度 | 快(TCP) | 慢(TCP + TLS) | 快(0-RTT,一次完成) |
| 服务器推送 | 不支持 | 支持 | 支持(更灵活) |
| 连接迁移与恢复 | 不支持 | 不支持 | 自动恢复 |
| 浏览器支持 | 全支持 | 主流支持 | 支持中(Chrome, Edge, Safari) |
| 实际部署 | 已逐渐淘汰 | 主流使用 | 快速增长中(CDN、核心站点已部署) |
HTTP/1.1:单车道,严重堵车; HTTP/2:多车道,但底层路面不行(TCP 拖累); HTTP/3:换飞行摩托(QUIC + UDP),连接快,传输稳,掉线不怕,车道不互撞。
AI Chat
USER
他们在安全性方面的区别是什么
ASSISTANT
HTTP 协议在演进过程中,安全性从一个“可选的附加项”逐渐变成了“不可分割的核心设计”。以下是 HTTP/1.1、HTTP/2 和 HTTP/3 在安全性方面的核心区别:
1. HTTP/1.1:明文为主,依赖外部加密
- 默认明文传输:HTTP/1.1 协议本身没有任何加密或完整性校验机制。请求头、Cookie、URL 参数和响应体均以纯文本形式传输,极易遭受窃听和中间人攻击(MITM)。
- 安全性完全依赖 TLS/SSL:要实现安全,必须在外层包裹 TLS(即 HTTPS)。即使使用了 HTTPS,底层的 TCP 头部(如序列号、窗口大小)以及 TLS 握手阶段的 SNI(服务器名称指示) 仍是明文的,攻击者仍可通过流量分析推断用户正在访问的具体域名。
2. HTTP/2:事实上的强制加密,但存在实现层漏洞
- 规范允许明文,但浏览器已封杀:HTTP/2 规范在技术上支持明文模式(称为 h2c, HTTP/2 Cleartext)。然而,出于安全考虑,所有主流浏览器(Chrome, Firefox, Safari, Edge)均已**完全放弃对 h2c 的支持**,仅允许通过 TLS 加密的 HTTP/2(即
h2)。因此,在现代 Web 场景中,HTTP/2 实际上是强制加密的。 - TLS 版本要求提升:主流实现通常要求至少使用 TLS 1.2,并推荐使用更安全的加密套件。
- 遗留攻击面(h2c 请求走私):如果后端服务器或反向代理(如某些旧版 Nginx 或应用框架)同时错误地配置了支持 h2c 和 HTTP/1.1,攻击者可能利用协议升级机制的解析差异,发起 h2c 请求走私攻击 (h2c Smuggling),从而绕过安全控制或窃取数据。
3. HTTP/3 (QUIC):安全即设计,深度加密与抗干扰
HTTP/3 基于 QUIC 协议,其安全架构发生了质的飞跃,加密不再是“附加层”,而是协议的基石:
- 强制内置 TLS 1.3:QUIC 协议在设计上**强制要求使用 TLS 1.3**,不存在任何明文降级模式。TLS 握手与 QUIC 传输层握手被合并,不仅将首次连接延迟降至 1-RTT 或 0-RTT,还从根本上消除了协议降级攻击(Downgrade Attack)的风险。
- 传输层元数据(头部)加密:在传统的 TCP+TLS 栈中,TCP 头部是完全明文的。而在 QUIC 中,不仅应用层数据被加密,大部分传输层头部(如 Packet Number 包序号)也被加密和保护。这有效防止了中间网络设备(如 ISP 的流量整形器、劣质防火墙)窥探、干扰或错误地重置连接,解决了长期存在的“中间盒僵化”问题。
- 安全的连接迁移:HTTP/1.1 和 HTTP/2 依赖“IP+端口”四元组标识连接,网络切换(如 Wi-Fi 切到 5G)会导致连接断开并需要重新握手,这期间易受会话劫持。HTTP/3 使用加密的、可轮换的 64 位 Connection ID 来标识连接。网络切换时连接无缝迁移,且攻击者极难伪造或劫持该 ID。
- 更安全的 0-RTT:虽然 0-RTT 存在重放攻击(Replay Attack)的理论风险,但 QUIC 结合 TLS 1.3 的机制,允许应用层明确标记哪些请求(如 GET)可以安全地使用 0-RTT,而将敏感操作(如 POST)限制为 1-RTT,从而在性能与安全间取得平衡。
4. 安全性核心差异对比表
| 安全维度 | HTTP/1.1 | HTTP/2 | HTTP/3 (QUIC) |
|---|---|---|---|
| 默认加密状态 | 明文(需手动配置 HTTPS) | 规范支持明文 (h2c),但**主流浏览器强制要求 TLS** | 强制加密,无明文模式 |
| 加密协议版本 | 依赖外部配置 (SSLv3 ~ TLS 1.3) | 通常强制 TLS 1.2 或更高 | 强制内置 TLS 1.3 |
| 元数据/头部保护 | TCP 头部明文,TLS SNI 明文 | TCP 头部明文,TLS SNI 明文 | 传输层包头(如 Packet Number)被加密 |
| 抗中间人/干扰能力 | 弱(易受 TCP 重置、流量整形干扰) | 中(仍受 TCP 层特性限制) | 强(加密包头使中间网络设备无法窥探或干扰流) |
| 网络切换安全性 | 连接断开,需重新握手(易受劫持) | 连接断开,需重新握手(易受劫持) | 安全连接迁移(基于加密的 Connection ID) |
| 典型协议层漏洞 | 明文窃听、HTTP 响应拆分 | h2c 请求走私 (h2c Smuggling) | 0-RTT 重放攻击(需应用层配合防御) |
5. 实际部署的安全建议
- 彻底弃用明文:无论使用哪个版本,都应通过 HSTS (HTTP Strict Transport Security) 强制客户端使用 HTTPS。
- 警惕 h2c 配置:如果在内部微服务或 API 网关中使用 HTTP/2,应明确禁用
h2c(明文 HTTP/2),除非在绝对可信且隔离的网络环境中,以防请求走私攻击。 - UDP 端口放行:HTTP/3 使用 UDP 协议(默认端口 443)。企业防火墙或云安全组如果默认拦截 UDP 流量,会导致 HTTP/3 连接失败(客户端通常会回退到 HTTP/2,但会损失性能优势)。
- 0-RTT 风险控制:如果启用了 HTTP/3 的 0-RTT,确保后端业务逻辑对 0-RTT 请求做了幂等性校验,避免重放攻击导致重复扣款或重复提交。
USER
能否理解为HTTP2就是HTTPS协议
ASSISTANT
不能直接划等号。 这是一个非常常见的概念混淆。
简单来说:HTTP/2 是“协议版本”(规定了数据怎么打包和传输),而 HTTPS 是“加密方式”(规定了数据怎么被保护)。 它们是正交的两个概念。
为了彻底理清这个关系,我们可以从以下几个层面来理解:
1. 核心概念的区别
- HTTP/2:是应用层协议的一个演进版本。它定义了二进制分帧、多路复用、头部压缩等规则。它本身**不关心**底层是明文还是加密的。
- HTTPS:严格来说,HTTPS 并不是一个独立的协议,而是 HTTP 协议 + TLS/SSL 加密层 的统称。你可以有 HTTP/1.1 over TLS(最常见的 HTTPS),也可以有 HTTP/2 over TLS,还可以有 HTTP/3 over TLS(QUIC 内置)。
2. 为什么大家容易产生“HTTP/2 = HTTPS”的误解?
因为在**日常浏览器上网**的场景中,这个等式**在事实上是成立的**。
虽然 HTTP/2 的官方规范(RFC 7540)允许它运行在明文 TCP 之上(这种模式被称为 h2c,即 HTTP/2 Cleartext),但出于安全考虑,所有主流浏览器(Chrome, Firefox, Safari, Edge)都拒绝支持明文的 h2c。它们只支持基于 TLS 加密的 HTTP/2(在 ALPN 协商中称为 h2)。
因此,当你在浏览器开发者工具的 Network 面板看到某个请求使用了 HTTP/2 时,它前面必定带着一把“小锁”,它确实是一个 HTTPS 连接。这种浏览器的“事实强制”,导致了人们的误解。
3. HTTP/2 不是 HTTPS 的真实场景(反例)
在浏览器之外的广阔世界里,HTTP/2 经常被用作**明文协议**:
- 后端微服务与内部 API 通信:在受信任的内网环境中,为了减少 TLS 加解密带来的 CPU 开销和延迟,很多系统会使用
h2c(明文 HTTP/2)进行服务间通信。外部的 TLS 加密通常由边缘的负载均衡器(如 Nginx, ALB)或 Service Mesh(如 Istio)统一终结。 - gRPC:Google 开发的著名 RPC 框架 gRPC,其底层默认就是基于 HTTP/2 的。虽然 gRPC 支持 TLS,但在许多内部集群调用中,为了极致性能,默认使用的是明文 HTTP/2 (
h2c)。 - HTTP/2 升级机制:客户端可以先通过 HTTP/1.1 明文发送一个带有
Upgrade: h2c头部的请求,如果服务器支持,双方会在同一个明文 TCP 连接上直接切换到 HTTP/2 协议,全程没有 TLS 握手。
4. 反过来也成立:HTTPS 也不等于 HTTP/2
HTTPS 只是一个加密外壳,里面包裹的 HTTP 协议版本取决于客户端和服务器的协商结果(通过 TLS 的 ALPN 扩展):
- 如果双方都支持,通常会协商为 HTTP/2 (h2) 或 HTTP/3 (h3)。
- 如果有一方较老,或者网络中间设备干扰了 HTTP/2 的协商,它们会安全地回退(Fallback)到 HTTP/1.1 over TLS。这依然是 HTTPS,但不是 HTTP/2。
5. 一个通俗的比喻
- HTTP/1.1, HTTP/2, HTTP/3 就像是 不同格式的信件(HTTP/1.1 是手写散文,HTTP/2 是高效压缩的表格,HTTP/3 是分成多个独立包裹的特快专递)。
- TLS/SSL (HTTPS) 就像是 装甲押运车。
你可以把“手写散文”(HTTP/1.1)放进装甲车(HTTPS)里运送,也可以把“高效表格”(HTTP/2)放进装甲车(HTTPS)里运送。 同时,如果你在公司内部安全的院子里送信,你也可以选择不使用装甲车,直接裸传“高效表格”(这就是内网的明文 HTTP/2 / h2c)。
总结
- 在公网浏览器访问场景:HTTP/2 几乎总是表现为 HTTPS(因为浏览器强制要求)。
- 在严谨的技术定义和后端架构中:HTTP/2 是一种数据格式和多路复用机制,它既可以被 HTTPS 保护,也可以作为明文 (h2c) 独立运行。两者不能直接划等号。
USER
既然HTTP2最常用,为什么我们在写代码发送网络请求时不需要指定HTTP协议版本,是存在默认封装吗?在安全测试时,bp等工具为什么看到的还是HTTP/1.1的协议头?
ASSISTANT
这是一个非常深刻且直击本质的好问题!你观察到了 “理论上的主流协议” 与 “实际开发/测试中的直观感受” 之间的割裂。
简单来说:写代码不需要指定,是因为底层库帮你做了“自动协商”;而安全工具看到的是 HTTP/1.1,是因为工具为了让你能看懂并修改数据,主动把 HTTP/2 “翻译(降级)”成了 HTTP/1.1。
下面为您详细拆解这两个现象背后的原理:
一、 为什么写代码不需要指定协议版本?
答案是:存在默认封装,且底层使用了“自动协商机制”。
在现代网络编程中,你不需要(也不应该)在代码里硬编码写死 HTTP/2。主流的编程语言标准库或第三方 HTTP 客户端(如 Python 的 requests/httpx、Java 的 HttpClient、Go 的 net/http、Node.js 的 fetch,以及所有浏览器)都内置了 ALPN(应用层协议协商,Application-Layer Protocol Negotiation) 机制。
自动协商的过程是怎样的?
当你的代码发起一个 HTTPS 请求时,底层会发生以下事情:
- TLS 握手阶段:客户端在发送 TLS
ClientHello消息时,会顺便带上一句话:“我支持h2(HTTP/2) 和http/1.1,你看着办。” - 服务端响应:服务端在回复
ServerHello时,会挑选双方都支持的最高版本。如果服务端支持 HTTP/2,就会回复:“好,我们用h2。” - 协议切换:TLS 握手完成后,双方的连接自动升级为 HTTP/2 二进制帧模式。
结论:你的代码只需要说“我要访问这个 URL”,底层的网络库会自动帮你协商出最优的协议版本。如果目标服务器太老不支持 HTTP/2,它会自动平滑降级到 HTTP/1.1。这种“向上兼容、择优协商”的封装,让开发者完全感知不到协议版本的存在。
二、 为什么在 Burp Suite (BP) 等工具里看到的还是 HTTP/1.1?
很多安全测试新手都会产生这个疑惑:既然浏览器和服务器都在用 HTTP/2,为什么 Burp Suite 的 Repeater(重放模块)或 Proxy(代理模块)里,看到的请求头依然是 GET / HTTP/1.1 这样的纯文本格式?
这主要是由安全测试工具的**工作原理**和**人类可读性需求**决定的:
1. HTTP/2 是“二进制帧”,人类无法直接阅读和修改
HTTP/1.1 是纯文本的,你可以直接用肉眼看懂,用键盘修改 Header 或 Body。 但 HTTP/2 是**二进制分帧**的。它在底层被切分成了 HEADERS 帧、DATA 帧、SETTINGS 帧等,并且经过了 HPACK 压缩。如果你用 Wireshark 抓包看 HTTP/2,看到的是一堆十六进制的乱码(除非使用专门的解码插件)。 Burp Suite 的核心功能是让你“拦截、查看、修改、重放”请求。 为了让你能修改请求,Burp 必须在内部将拦截到的 HTTP/2 二进制流 **“翻译/降级”成 HTTP/1.1 的文本格式**展示在 UI 上。
2. 代理工具的“两段式”连接架构
Burp Suite 是一个中间人代理(MITM),它实际上建立了**两段独立的连接**:
- 第一段(浏览器 -> Burp):浏览器与 Burp 之间通常协商使用 HTTP/2(或 HTTP/1.1)。
- 第二段(Burp -> 目标服务器):Burp 解析完请求后,需要向目标服务器发起新请求。为了**最大的兼容性**(避免触发某些老旧服务器的 Bug,或绕过某些只认 HTTP/1.1 的 WAF),Burp 默认向目标服务器转发请求时,通常使用的是 HTTP/1.1。
3. 如何在 Burp 中验证它确实处理了 HTTP/2?
虽然你在 Repeater 里看到的是 HTTP/1.1 的文本,但 Burp 确实处理了 HTTP/2。你可以通过以下方式验证:
- 查看 Target 面板:在 Burp 的
Target -> HTTP history中,有一列叫HTTP version,你会看到很多请求标记为2.0。 - 强制使用 HTTP/2 转发:在较新版本的 Burp Suite 中,你可以进入
Settings -> Network -> HTTP,勾选 "Enable HTTP/2"。这样 Burp 在向目标服务器转发时,也会尝试使用 HTTP/2。但请注意,即使开启了这个选项,你在 Repeater 里看到的依然是 HTTP/1.1 的文本格式,因为 Burp 必须用文本格式来让你编辑数据,只是在点击 "Send" 的瞬间,Burp 会在底层把它重新打包成 HTTP/2 二进制帧发出去。
三、 总结与比喻
- 写代码发请求:就像你坐**高铁**。你不需要知道高铁是用交流电还是直流电,也不需要知道轨道是哪种型号(协议版本)。你只需要买票(输入 URL),铁路系统(底层网络库的 ALPN 协商)会自动把你用最快、最合适的交通工具送达。
- 使用 Burp Suite 抓包:就像你是一个**海关检查员**。高铁(HTTP/2)开过来后,因为集装箱是密封且压缩的(二进制帧),你没法直接检查里面的货物。所以海关(Burp Suite)必须把货物**卸下来,拆掉包装,平铺在地上(转换成 HTTP/1.1 文本格式)**,让你能看清楚、能替换掉里面的违禁品(修改请求),然后再重新打包发走。
所以,你看到的 HTTP/1.1,只是安全工具为了“方便人类操作”而提供的一层**可视化翻译界面**,并不代表真实的网络传输状态。
USER
那如果未来服务端仅支持HTTP/2或更高协议版本,那么bp是否就无法对协议进行降级处理,从而安全测试人员也就无法查看和编辑明文了
ASSISTANT
这是一个非常敏锐的推论,但答案是:不会的。即使未来服务端彻底淘汰了 HTTP/1.1,仅支持 HTTP/2 或 HTTP/3,安全测试人员依然可以像现在一样查看和编辑明文。
这里的核心误区在于:Burp Suite (BP) 在界面上展示 HTTP/1.1 文本,并不是因为它在“降级协议”,而是因为它在做“数据反序列化(翻译)”。
为了彻底解开这个疑惑,我们需要厘清以下几个关键概念:
1. 核心本质:语义相同,只是“包装”不同
HTTP/1.1、HTTP/2 和 HTTP/3 在**传输格式**上完全不同(文本 vs 二进制帧 vs QUIC流),但它们在**应用层语义**上是**完全等价**的。
- 它们都使用相同的请求方法(GET, POST)。
- 它们都使用相同的 URI、状态码(200, 404)。
- 它们都使用相同的 Header 概念(Host, Content-Type)。
HTTP/2 并没有发明新的 HTTP 语义,它只是把 HTTP/1.1 的文本内容,塞进了一个更高效的“二进制集装箱”里。
2. Burp Suite 的真实工作原理(纯 HTTP/2 环境下)
假设未来有一个极端的环境:客户端只支持 HTTP/2,服务端也只支持 HTTP/2。BP 作为中间人代理,它的工作流程如下:
- 拦截与接收:浏览器向 BP 发送 HTTP/2 的二进制帧。
- 反序列化(UI 展示层):BP 接收到二进制帧后,在内存中将其**解析/拆解**成人类可读的文本结构。因为 HTTP/2 的语义和 HTTP/1.1 一样,所以 BP 直接借用 HTTP/1.1 的文本格式(如
GET / HTTP/2或干脆还是HTTP/1.1的文本排版)展示在 Repeater 界面上。这只是为了让你能看懂,并不代表 BP 把协议降级了。 - 人工编辑:你在文本界面上修改了 Header 或 Body。
- 重新序列化(发送层):当你点击 "Send" 时,BP 会把你修改后的文本,**重新打包/编译**成 HTTP/2 的二进制帧,然后通过 HTTP/2 协议发送给目标服务端。
结论:BP 根本不需要服务端支持 HTTP/1.1。它只需要在内部实现一个“HTTP/2 二进制帧 <-> 文本格式”的转换器即可。
3. 一个通俗的比喻
- HTTP/1.1 就像是一封**写在纸上的平信**,你一眼就能看懂里面的字。
- HTTP/2 就像是一个**加密压缩的 ZIP 文件**,里面装的其实是同一封信的内容。
- Burp Suite 就像是一个**带解压功能的透明工作台**。
当 ZIP 文件(HTTP/2)经过工作台时,BP 会自动把它**解压**成平信(文本格式)摊开在桌面上让你看、让你改。改完之后,BP 再把它**重新压缩**成 ZIP 文件(HTTP/2)发给收件人(服务端)。 收件人(服务端)根本不需要认识“平信”(HTTP/1.1),他只需要能收“ZIP 文件”(HTTP/2)就行了。
4. 现实中的工具现状
事实上,你不需要等到“未来”。现在的 Burp Suite 就已经完全具备处理纯 HTTP/2 甚至 HTTP/3 流量的能力了。
- 在较新的 Burp Suite 版本中,默认已经开启了对 HTTP/2 的支持。
- 当浏览器和目标服务器都使用 HTTP/2 时,BP 在中间代理的就是纯 HTTP/2 流量。
- 但你在 Repeater 里看到的,依然是类似 HTTP/1.1 的文本排版(因为 BP 认为这种排版对人类最友好)。
- 如果你去查看 BP 的底层日志(Logger++ 插件或 Target 面板),你会清楚地看到,BP 发给服务端的请求,协议版本确实是
HTTP/2。
5. 补充:关于“协议降级攻击”
你提到的“降级处理”,在安全领域通常指 “协议降级攻击”(Protocol Downgrade Attack)。
- 这是指攻击者(或中间网络设备)故意篡改 TLS 握手信息,欺骗客户端和服务端,让他们放弃使用高版本协议(如 TLS 1.3 或 HTTP/2),转而使用低版本协议(如 TLS 1.0 或 HTTP/1.1),以便利用低版本协议的已知漏洞进行攻击。
- Burp Suite 在界面上展示文本,属于“数据格式转换”,绝对不属于“协议降级攻击”。 BP 发给服务端的协议版本,始终是与服务端协商出的最高版本。
总结
安全测试工具的设计初衷就是“让人类能够干预机器间的通信”。只要 HTTP 协议的核心语义(方法、URL、状态码、Header)不发生颠覆性改变(这在未来极不可能发生),无论底层传输协议升级到 HTTP/2、HTTP/3 还是未来的 HTTP/4,安全工具永远都能在 UI 层面为你提供熟悉的“明文编辑界面”。你完全不需要为此感到担忧。
USER
HTTP1.1,HTTP2,HTTP3在协议体内容层面有区别吗,比如请求方法(GET、POST)、请求体等有无明显变化
ASSISTANT
这是一个非常精准且切中要害的问题。
直接给出结论:在应用层语义(即你关心的请求方法、URL、请求体、状态码等业务内容层面),HTTP/1.1、HTTP/2 和 HTTP/3 几乎没有任何区别。
HTTP 协议演进的核心设计哲学是:“语义不变,只改传输”。HTTP/2 和 HTTP/3 的发明者刻意保留了 HTTP/1.1 的所有核心概念,以确保现有的 Web 生态(浏览器、后端代码、API 规范、安全测试工具)能够无缝平滑升级,而不需要重写业务逻辑。
以下是详细的拆解说明:
一、 完全不变的内容(对开发者和测试人员透明)
无论你底层使用的是哪个版本的 HTTP,以下内容在业务层面是**100% 一致**的:
- 请求方法 (Methods):
GET,POST,PUT,DELETE,PATCH,OPTIONS等完全一致。 - URL / URI:请求的路径、查询参数(Query String)的格式和含义完全一致。
- 请求体 / 响应体 (Body):无论是 JSON、XML、HTML 还是二进制文件(图片、视频),其载荷(Payload)内容本身没有任何变化。
- 状态码 (Status Codes):
200 OK,404 Not Found,500 Internal Server Error等语义完全一致。 - 核心业务 Header:如
Content-Type,Authorization,User-Agent,Cookie等,其键值对的逻辑含义完全一致。
结论:你写的后端路由代码(如 @PostMapping("/api/data"))、前端 Fetch 请求、以及你在 Burp Suite 中构造的 Payload,在三个协议版本中**完全通用**。
二、 底层有变化,但通常对开发者“透明”的内容
虽然业务内容没变,但为了适配新的传输机制,协议在**表示形式**上做了一些微调。好消息是,现代编程语言的标准库(如 Python 的 requests/httpx,Go 的 net/http,Java 的 HttpClient)会自动帮你处理这些差异,你通常感知不到:
- Header 键名强制小写:
- HTTP/1.1:Header 键名不区分大小写(如
Content-Type和content-type都可以)。 - HTTP/2 & HTTP/3:为了配合 HPACK/QPACK 头部压缩算法(压缩字典是基于小写构建的),规范**强制要求所有 Header 的键名在传输时必须是小写**。
-
影响:你的代码如果写的是
request.headers.get("Content-Type"),底层库会自动将其转换为小写进行传输,并在接收时按你的代码习惯还原大小写。你无需手动修改代码。 -
引入了“伪头部” (Pseudo-headers):
- HTTP/1.1:请求的第一行是纯文本的
GET /index.html HTTP/1.1(请求行)。 - HTTP/2 & HTTP/3:因为没有了“行”的概念(全是二进制帧),协议引入了以冒号
:开头的伪头部来携带这些元数据,例如:method(值为 GET),:path(值为 /index.html),:scheme(值为 https),:authority(替代 Host)。 - 影响:这完全是底层帧格式的优化。高级 HTTP 库会自动将
:method映射回你熟悉的request.method属性,你不需要在代码里去解析这些带冒号的头部。
三、 真正被“废弃/禁止”的内容层面变化
由于 HTTP/2 和 HTTP/3 接管了底层的连接管理,HTTP/1.1 中一些用于控制底层连接的 Header 在新版本中**被明确禁止使用**。如果你在 HTTP/⅔ 请求中强行发送它们,合规的服务器或代理会直接忽略它们,甚至返回 400 Bad Request 错误:
- 禁止使用的 Header:
ConnectionKeep-AliveProxy-ConnectionTransfer-Encoding(HTTP/2 使用帧长度字段,不再需要 chunked 编码)Upgrade(HTTP/2 的升级在 TLS 握手阶段通过 ALPN 完成,不再需要应用层的 Upgrade 头)-
TE(Trailer Encoding) -
影响:在安全测试或开发中,如果你试图通过注入
Connection: close或Transfer-Encoding: chunked来进行 HTTP 请求走私(Request Smuggling)攻击,在纯 HTTP/⅔ 环境下这些手法将**直接失效**(这也是为什么 h2c smuggling 必须依赖前后端协议解析不一致的原因)。
四、 唯一的“新内容”特性(且已衰退)
- 服务器推送 (Server Push):这是 HTTP/2 在内容层面引入的唯一真正的新语义(允许服务器在客户端请求 HTML 时,主动附带推送 CSS/JS 文件,通过
Push Promise帧实现)。 - 现状:由于缓存管理极其复杂且经常导致带宽浪费,Chrome 等主流浏览器已在 2024 年前后彻底移除了对 HTTP/2 Server Push 的支持。HTTP/3 (RFC 9114) 规范中也**没有包含** Server Push 功能。目前业界推荐使用
103 Early Hints状态码或<link rel="preload">来替代。
总结
你可以把 HTTP 协议的演进想象成**快递行业的升级**:
- HTTP/1.1:用普通的纸箱(文本)装你的货物(Body/Header),一次发一个箱子,排队上车(TCP)。
- HTTP/2:用标准化的、带条形码的集装箱(二进制帧)装同样的货物,多个集装箱可以拼在一辆卡车上同时运输(多路复用),并且纸箱被压缩得更小了(HPACK)。
- HTTP/3:换成了更先进的磁悬浮轨道(QUIC/UDP),集装箱丢了只重发那一个,不影响其他集装箱,且换轨道不用重新安检(连接迁移)。
无论包装和运输工具怎么变,你寄出的“货物本身”(GET/POST、JSON 数据、业务 Header)没有任何改变。 这就是为什么你在写代码或用 Burp Suite 测试时,几乎感觉不到协议版本变化带来的业务层阻碍。
USER
你刚才提到HTTP2协议引入了以冒号 : 开头的伪头部来携带这些元数据,能否给我一个请求示例
ASSISTANT
当然可以。为了让你直观理解,我会先展示一个你熟悉的 HTTP/1.1 请求,然后展示它在 HTTP/2 中是如何被"翻译"成伪头部格式的。
1. 你熟悉的 HTTP/1.1 请求(纯文本)
POST /api/v1/users?page=2&limit=10 HTTP/1.1
Host: api.example.com
Content-Type: application/json
Authorization: Bearer eyJhbGciOiJIUzI1NiJ9...
User-Agent: Mozilla/5.0
Accept: application/json

{"name": "Alice", "email": "alice@example.com"}
注意第一行(请求行)包含了三个关键信息:
- 方法:
POST - 路径:
/api/v1/users?page=2&limit=10 - 协议版本:
HTTP/1.1
再加上第二行的 Host 头,这四个信息在 HTTP/1.1 中分散在请求行和头部里。
2. 同一个请求在 HTTP/2 中的表示(伪头部形式)
HTTP/2 没有"请求行"的概念,所有内容都被统一为 Header 键值对,放在 HEADERS 帧中传输。原来请求行和 Host 里的信息,被拆成了四个以冒号 : 开头的**伪头部**:
:method: POST
:scheme: https
:authority: api.example.com
:path: /api/v1/users?page=2&limit=10
content-type: application/json
authorization: Bearer eyJhbGciOiJIUzI1NiJ9...
user-agent: Mozilla/5.0
accept: application/json

{"name": "Alice", "email": "alice@example.com"}
3. 一一映射关系
| HTTP/1.1 中的位置 | HTTP/1.1 的值 | HTTP/2 伪头部 | HTTP/2 的值 |
|---|---|---|---|
| 请求行第1个词 | POST |
:method |
POST |
| 请求行第2个词 | /api/v1/users?page=2&limit=10 |
:path |
/api/v1/users?page=2&limit=10 |
| 隐式(由连接决定) | (无) | :scheme |
https |
Host 头 |
api.example.com |
:authority |
api.example.com |
| 普通 Header | Content-Type: application/json |
content-type (强制小写) |
application/json |
:status是第五个伪头部,但**仅用于响应**,例如:status: 200,替代了 HTTP/1.1 响应行中的HTTP/1.1 200 OK。
4. 关键规则
- 伪头部必须排在所有普通头部之前。如果
:path出现在content-type之后,这是一个协议错误,接收方必须拒绝该请求。 - 普通头部键名强制小写。
Content-Type变成了content-type,这是 HPACK 压缩算法的要求。 - 伪头部不是真正的 HTTP Header。应用层代码(如你的后端框架)永远不会看到
:method,HTTP/2 库会在内部将它们还原成你熟悉的request.method、request.path等属性。
5. 在底层实际传输时长什么样?
上面展示的伪头部形式,是像 Wireshark 或 nghttp 这样的工具**解码后**给你看的人类可读版本。在实际网络线路上,HTTP/2 的 HEADERS 帧经过 HPACK 压缩后,看起来是这样的(十六进制):
0000  00 00 4a 01 05 00 00 00 01 82 86 41 8b 08 9d 5c
0010  0b 81 70 dc 07 83 90 69 2f 8a 1b e7 44 05 8b 62
0020  0b 81 70 dc 07 83 90 69 2f ...
82→ HPACK 静态表索引,解码为:method: GET86→ HPACK 静态表索引,解码为:scheme: https41 8b ...→ 经过 Huffman 编码的:authority: api.example.com- ...
这就是为什么 Burp Suite 必须帮你"翻译"——如果直接给你看这堆十六进制,你根本无法阅读和修改。
6. 如何自己亲眼看到伪头部?
如果你想验证,可以用 curl 的 --http2 参数配合 -v(verbose)模式:
输出中会包含类似:
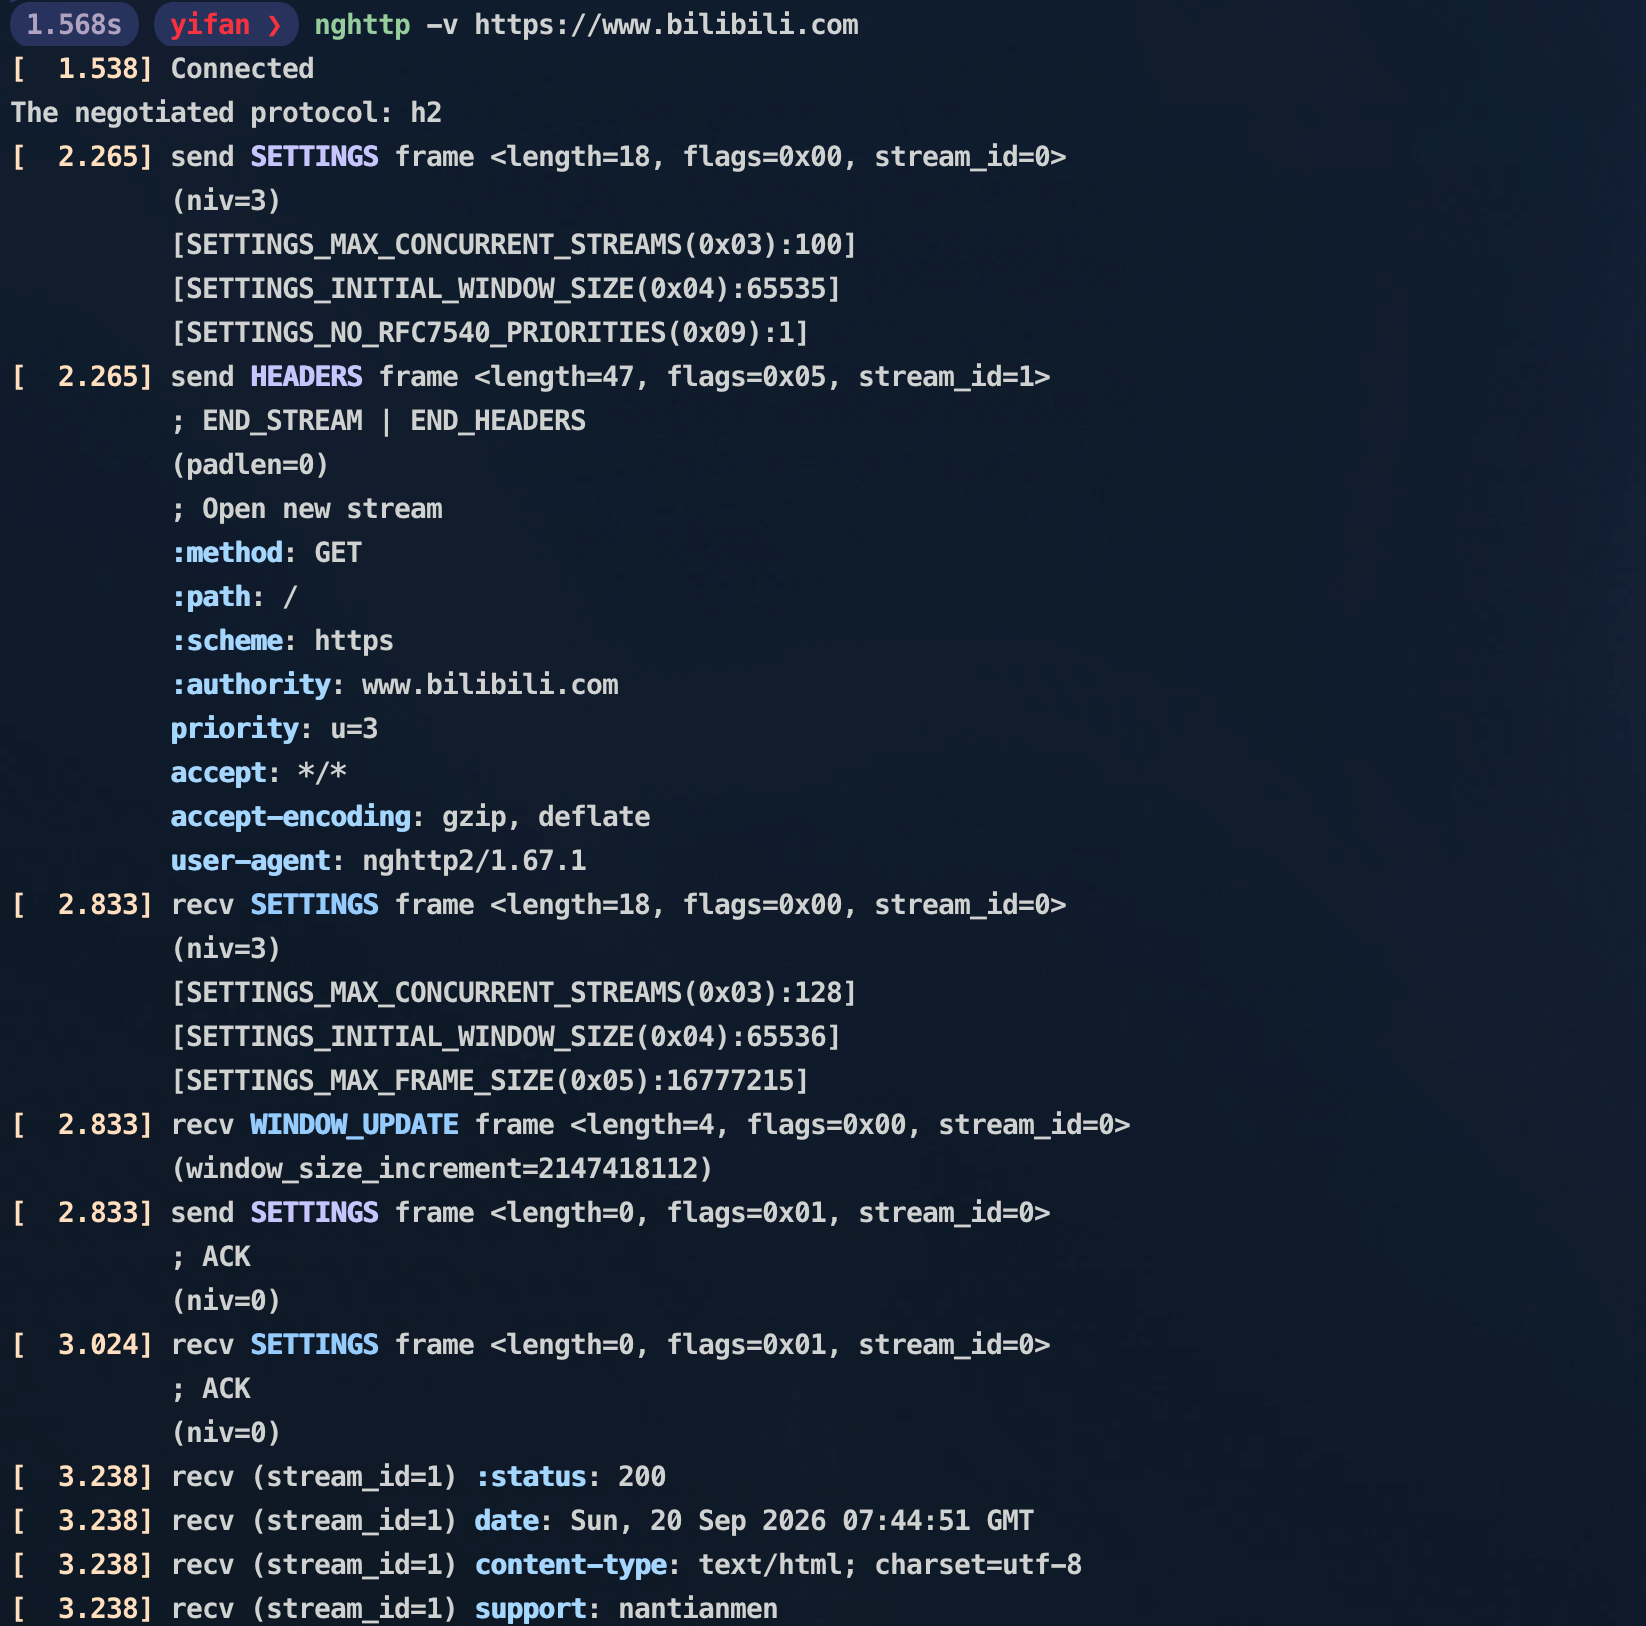
curl 在展示时已经把伪头部**还原**成了 HTTP/1.1 风格。如果你想看到原始的伪头部,可以使用 nghttp 工具:
输出会明确显示:
[  0.001] send HEADERS frame <length=45, flags=0x25, stream_id=13>
          ; END_STREAM | END_HEADERS | PRIORITY
          (padlen=0, dep_stream_id=11, weight=16, exclusive=0)
          ; Open new stream
          :method: GET
          :path: /api/v1/users
          :scheme: https
          :authority: api.example.com
          accept: */*
          accept-encoding: gzip, deflate
          user-agent: nghttp2/1.50.0
这里你就能清晰地看到 :method、:path、:scheme、:authority 这四个伪头部了。
USER
那如何发起HTTP3请求
ASSISTANT
发起 HTTP/3 请求与 HTTP/1.1 或 HTTP/2 最大的不同在于:底层传输协议从 TCP 变成了 UDP (QUIC)。
因此,你使用的工具或编程语言的标准库,必须在底层实现了 QUIC 协议栈,否则无法发起请求。
以下是几种在不同场景下发起 HTTP/3 请求的实用方法:
1. 使用命令行工具 (cURL)
这是最直接的方法,但有一个**巨大的坑**:绝大多数操作系统(如 macOS, Ubuntu, CentOS)自带的 curl 默认是**不支持** HTTP/3 的,因为它编译时没有包含 QUIC 库。
如何发起: 如果你已经安装了支持 HTTP/3 的 curl,命令非常简单:
# 尝试使用 HTTP/3,如果失败则回退到 HTTP/2 或 1.1
curl --http3 -v https://cloudflare.com/

# 强制仅使用 HTTP/3,如果不支持则直接报错
curl --http3-only -v https://cloudflare.com/
如何获取支持 HTTP/3 的 curl?
- 方法 A (推荐,最省事):使用官方提供的 Docker 镜像。
- 方法 B (macOS):使用 Homebrew 编译安装。
- 方法 C (Linux):通常需要下载源码,安装
quiche或ngtcp2依赖后手动编译。
2. 使用编程语言发起请求
在代码中,你不能使用传统的 urllib (Python) 或基础的 http (Go) 库,必须使用支持 QUIC 的第三方库。
Python (使用 httpx)
httpx 是目前 Python 生态中最易用且支持 HTTP/3 的客户端。
首先安装依赖:
代码示例:
import httpx

# 创建一个支持 HTTP/3 的客户端
with httpx.Client(http3=True) as client:
    response = client.get('https://cloudflare.com/')

    # 验证协议版本
    print(f"协议版本: {response.http_version}")  # 输出: HTTP/3
    print(f"状态码: {response.status_code}")
Go (使用 quic-go/http3)
Go 语言社区最权威的 QUIC 实现是 quic-go。
首先安装依赖:
代码示例:
package main

import (
    "fmt"
    "io"
    "net/http"
    "github.com/quic-go/quic-go/http3"
)

func main() {
    // 使用 http3.RoundTripper 替代默认的 http.Transport
    client := &http.Client{
        Transport: &http3.RoundTripper{},
    }

    resp, err := client.Get("https://cloudflare.com/")
    if err != nil {
        panic(err)
    }
    defer resp.Body.Close()

    fmt.Printf("协议版本: %s\n", resp.Proto) // 输出: HTTP/3.0
    body, _ := io.ReadAll(resp.Body)
    fmt.Printf("响应长度: %d bytes\n", len(body))
}
Node.js (原生支持)
从 Node.js 18 开始,内置的 fetch API 底层(基于 undici)已经原生支持 HTTP/3。
// 直接运行 node script.js 即可,无需额外安装库
async function makeRequest() {
    try {
        const response = await fetch('https://cloudflare.com/');
        console.log(`协议版本: ${response.headers.get('x-firefox-spdy') || 'HTTP/3 (取决于底层实现)'}`);
        const text = await response.text();
        console.log(`响应长度: ${text.length}`);
    } catch (error) {
        console.error(error);
    }
}
makeRequest();
3. 在浏览器中发起(自动协商)
你不需要在浏览器里“写代码”来发起 HTTP/3 请求。现代浏览器(Chrome, Edge, Firefox, Safari)默认都开启了 HTTP/3 支持。
浏览器是如何决定使用 HTTP/3 的?
- Alt-Svc 头:当你第一次通过 HTTP/2 访问某个网站(如
cloudflare.com)时,服务器会在响应头中带上Alt-Svc: h3=":443"; ma=86400。这告诉浏览器:“我支持 HTTP/3,下次来请用 UDP 443 端口找我。” - DNS HTTPS 记录:更现代的做法是,域名的 DNS 解析直接返回
HTTPS记录(SVCB/HTTPS RR),明确告知客户端该域名支持 HTTP/3 及端口。
如何验证浏览器使用了 HTTP/3?
- 打开 Chrome 开发者工具 (F12)。
- 切换到 Network (网络) 面板。
- 在表头右键,勾选 Protocol (协议) 列。
- 刷新页面,你会看到很多请求的 Protocol 列显示为
h3或h3-29(代表 HTTP/3 的不同草案版本)。
4. 抓包验证 (Wireshark)
如果你想亲眼看看 HTTP/3 (QUIC) 的底层数据包,可以使用 Wireshark。
- 打开 Wireshark,选择你的网卡开始抓包。
- 在浏览器中访问支持 HTTP/3 的网站(如
https://cloudflare.com/)。 - 在 Wireshark 的过滤器中输入:
quic或udp.port == 443。 - 你会看到大量的 UDP 数据包。展开其中一个 QUIC 包,你可以清晰地看到:
- QUIC 头部(包含 Connection ID, Packet Number)。
- CRYPTO 帧(TLS 1.3 握手数据)。
- STREAM 帧(里面包裹着 HTTP/3 的 HEADERS 帧和 DATA 帧,也就是我们之前讨论的伪头部和请求体)。
⚠️ 发起 HTTP/3 请求的常见“避坑指南”
如果你按照上面的方法尝试,却发现请求失败或回退到了 HTTP/2,通常是以下原因:
- UDP 443 端口被拦截:HTTP/3 使用 UDP 协议,默认端口是 443。很多公司内网防火墙、云安全组、甚至某些公共 Wi-Fi,默认会丢弃 UDP 流量。如果 UDP 不通,客户端会自动回退到 TCP (HTTP/2)。
- 服务端未开启:并非所有网站都开启了 HTTP/3。你需要测试已知支持的目标,如
cloudflare.com,google.com,facebook.com等。 - DNS 缓存问题:如果你刚配置好服务端的 HTTP/3,本地 DNS 可能还没更新 HTTPS 记录,导致客户端不知道要用 UDP 去连接。
总结:发起 HTTP/3 请求的核心在于**更换底层的传输引擎(从 TCP 换到 QUIC/UDP)**。只要工具链支持,上层的业务代码(URL、Header、Body)与 HTTP/2 完全一致。