Web缓存中毒
网络缓存中毒是一种高级攻击手段,攻击者利用 Web 服务器的行为以及缓存机制,向其他用户发送有害的 HTTP 响应。
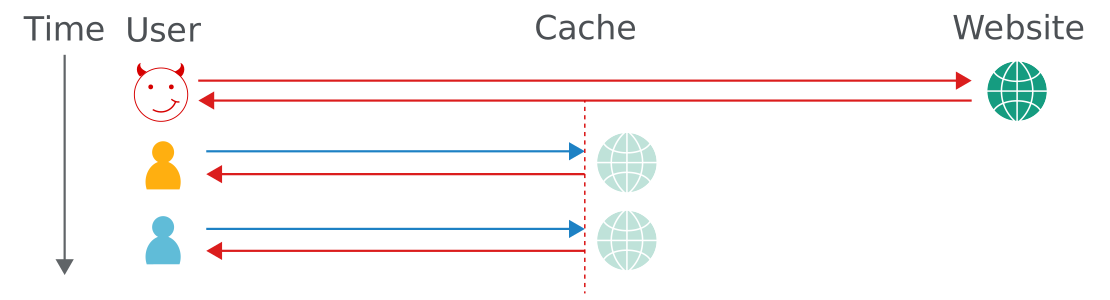
从根本上说,网络缓存中毒的过程包含两个阶段。首先,攻击者必须找到一种方法,让后端服务器产生某种响应,而该响应恰好包含了某种危险的数据包。一旦成功实现这一点,攻击者还需要确保自己的响应被缓存起来,然后被传输到目标受害者那里。
一个被污染的网页缓存可能会成为传播各种攻击的致命手段,这些攻击利用了诸如 XSS 攻击、JavaScript 注入、开放重定向等漏洞。
Web缓存如何实现的
要了解网络缓存中毒漏洞是如何产生的,就需要先了解网络缓存的工作原理。
如果服务器需要为每个 HTTP 请求单独发送新的响应,那么这很可能会让服务器负担过重,从而导致延迟问题,进而影响用户体验,尤其是在繁忙时期。缓存正是解决这类问题的有效手段。
缓存位于服务器和用户之间,用于存储对特定请求的响应结果,这些响应通常会在一定时间内保持有效。当其他用户再次提出类似的请求时,缓存系统会直接将已缓存的响应结果传递给用户,而无需再与后端系统进行任何交互。这样就能大大减轻服务器的负担,因为服务器需要处理的重复请求数量就会减少。
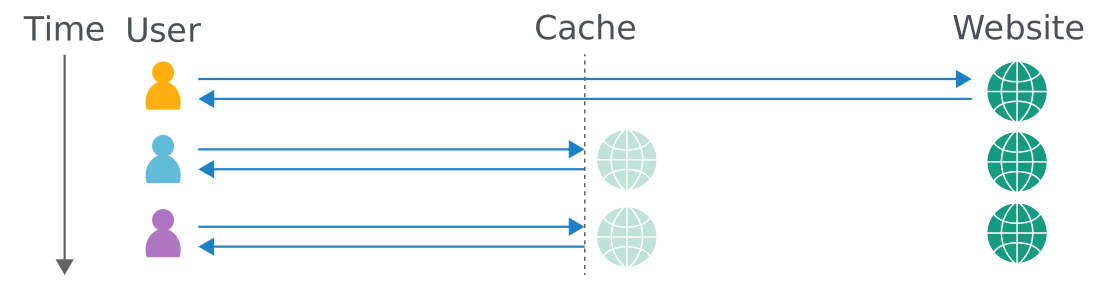
缓存Key
当缓存系统收到一个 HTTP 请求时,它首先需要确定是否存在可以直接服务的缓存响应,或者是否需要将请求转发给后端服务器进行处理。缓存系统通过比较请求中的某些预定义的组件来识别类似的请求,这些组件被称为“缓存键”。通常,缓存键会包含请求的请求行和 Host 头部信息。而那些不在缓存键中的请求组件则被称为“非关键组件”。
如果某个传入请求的缓存键与之前某个请求的键相匹配,那么缓存系统会认为这两个请求是等效的。因此,系统会返回为原始请求生成的缓存响应副本。这种情况适用于所有具有匹配缓存键的后续请求,直到缓存响应失效为止。
Web缓存中毒会造成什么影响
网络缓存中毒的影响主要取决于两个关键因素:
- 攻击者究竟能够成功获取哪些缓存信息呢?
由于网络缓存中毒本质上是一种传播手段,而非独立的攻击方式,因此网络缓存中毒的影响程度实际上与注入的恶意代码本身的危害性密切相关。和大多数攻击一样,网络缓存中毒也可以与其他攻击结合使用,从而进一步放大其潜在危害。
- 受影响页面的访问量
这种恶意的响应只会影响到那些在缓存尚未被污染时访问受影响页面的用户。因此,其影响程度取决于该页面是否受欢迎——可能几乎没有任何影响,也可能造成巨大的破坏。例如,如果攻击者成功地在一家知名网站的首页缓存中植入了恶意代码,那么成千上万的用户都可能受到影响,而攻击者本身则无需进行任何进一步的干预。
需要注意的是,缓存条目的持续时间并不一定会影响网络缓存中毒的影响。通常,攻击可以通过特定的脚本实现,从而让缓存持续处于中毒状态。
如何发现Web缓存中毒
一般来说,构建一个基本的网络缓存攻击方案包括以下步骤:
- 识别并评估未键入的输入数据
- 引发后端服务器的有害反应
- 将响应结果缓存起来
识别并评估未键化的输入数据
任何网络缓存攻击都依赖于对未加密钥的输入参数的操控,比如头部信息。网络缓存系统在决定是否向用户返回缓存响应时,会忽略这些未加密钥的输入参数。这意味着可以利用这一点注入恶意代码,从而生成一种“被污染”的响应。一旦该响应被缓存下来,它就会被传输给所有拥有匹配缓存键的请求的用户。因此,在构建网络缓存攻击时,第一步就是识别出服务器支持的未加密钥的输入参数。
你可以通过向请求中添加随机输入,然后观察这些输入是否会对响应产生影响来手动识别未键入的输入。这种影响可能是显而易见的,比如输入直接反映在响应中,或者触发完全不同的响应。不过,有时候影响更为微妙,需要一些技巧才能发现。你可以使用像 Burp Comparer 这样的工具来比较包含和不含注入输入时的响应,但这仍然需要大量的手动工作。
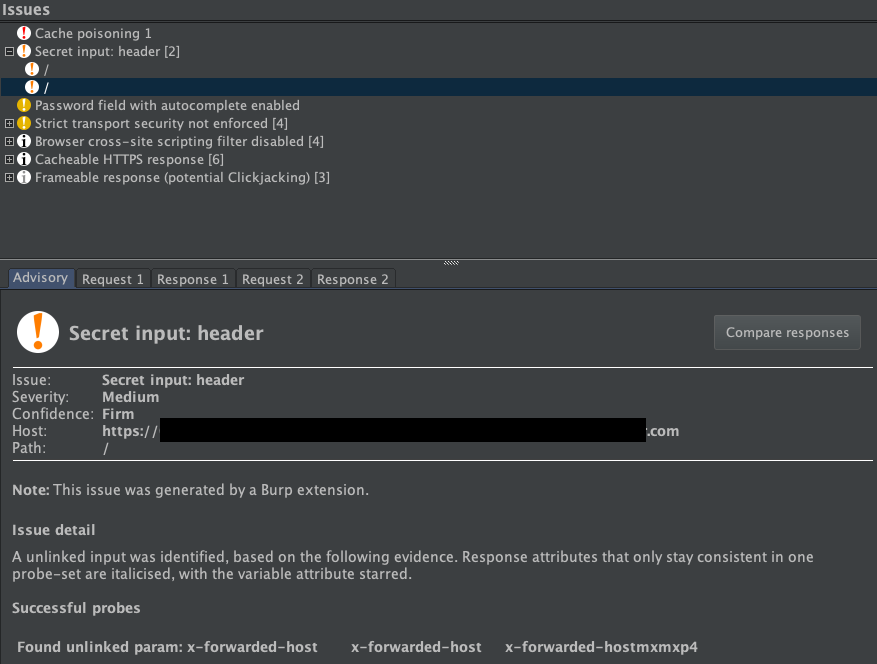
幸运的是,您可以通过在 BApp 商店中下载“Param Miner”扩展程序,来自动化识别未键入参数的输入过程。要使用“Param Miner”,只需在您想要分析的请求上右键点击,然后选择“猜测头部信息”即可。之后,“Param Miner”会在后台运行,不断发送包含不同输入值的请求。如果某个包含特定输入的请求对响应产生了影响,那么“Param Miner”会在 Burp 中记录这一信息——如果您使用的是 Burp Suite 专业版,可以在“问题”面板中查看;而如果您使用的是 Burp Suite 社区版,则可以在扩展程序的“输出”选项卡中查看(路径:BApp 商店 > 安装程序 > “Param Miner” > “输出”)。
例如,在下面的屏幕截图当中,Param Miner 在网站的首页上发现了一个未加键的头部字段 X-Forwarded-Host 。
注意:在实时网站上进行无键输入测试时,存在意外让缓存向真实用户展示生成响应的风险。因此,务必确保所有的请求都包含一个唯一的缓存键,这样这些响应才只会发送给您。为此,您可以在每次请求时手动在请求头中添加一些用于打破缓存的机制(例如独特的参数)。如果您使用的是 Param Miner 工具,那么还可以选择让该工具自动在每次请求中添加这样的机制。
引发后端服务器产生有害的响应
一旦确定了需要处理的未编码输入数据,下一步就是评估网站是如何处理这些数据的。了解这一点对于成功引发有害反应至关重要。如果输入数据在服务器响应中被直接返回,而没有经过适当的消毒处理,或者被用于动态生成其他数据,那么这就成为了网络缓存中毒的一个潜在入口点。
将响应结果缓存起来
操纵输入以引发有害的反应只是其中的一半努力而已,但除非能够使得这种反应被缓存起来,否则这种操作并不会产生太大效果。而让这种反应被缓存起来有时确实挺棘手的。
响应是否会被缓存,取决于多种因素,比如文件扩展名、内容类型、路由、状态码以及响应头信息等。你可能需要花一些时间来尝试在不同的页面上发送请求,并了解缓存机制的工作原理。一旦你找到了一种方法,可以让包含恶意输入的响应被缓存下来,那么你就已经准备好将攻击手段传递给潜在的受害者了。
利用Web缓存中毒来进行攻击
在某些情况下,网络缓存中毒漏洞的出现是由于缓存设计中存在一般性的缺陷所导致的。而另一些情况下,特定网站所实现的缓存机制本身存在一些意想不到的漏洞,这些漏洞可以被利用起来。
利用缓存设计中的缺陷
简而言之,如果网站以不安全的方式处理未加密的输入,并允许后续的 HTTP 响应被缓存,那么这些网站就容易受到网络缓存中毒的攻击。这种漏洞可以被用来实施各种攻击手段。
XSS 攻击
或许,最简单的网络缓存欺骗漏洞就是当未经过处理的输入被错误地包含在可缓存的响应中时。这种情况下,如果没有适当的处理措施,输入内容就有可能被泄露。
例如,考虑以下请求和响应:
GET /en?region=uk HTTP/1.1
Host: innocent-website.com
X-Forwarded-Host: innocent-website.co.uk

HTTP/1.1 200 OK
Cache-Control: public
<meta property="og:image" content="https://innocent-website.co.uk/cms/social.png" />
在这里, X-Forwarded-Host 头部的值被用来动态生成 Open Graph 图片的 URL,该 URL 随后会体现在响应中。对于网络缓存中毒来说,非常关键的是 X-Forwarded-Host 头部通常是不被加密的。在这个例子中,可以通过一个包含简单 XSS payload 的响应来攻击缓存系统。
GET /en?region=uk HTTP/1.1
Host: innocent-website.com
X-Forwarded-Host: a."><script>alert(1)</script>"

HTTP/1.1 200 OK
Cache-Control: public
<meta property="og:image" content="https://a."><script>alert(1)</script>"/cms/social.png" />
如果这种响应被缓存起来,那么所有访问 /en?region=uk 的用户都将收到这种 XSS payload。虽然这种攻击只会让受害者的浏览器中显示一个警告消息,但在真正的攻击中,攻击者有可能窃取密码并操控用户账户。
利用资源导入处理中的安全隐患进行攻击
一些网站使用未加键的头部信息来动态生成导入资源的 URL,比如从外部主机获取的 JavaScript 文件。在这种情况下,如果攻击者能够改变相应头部信息中的域名,他们就有可能操纵 URL,使其指向他们自己控制的恶意 JavaScript 文件。
如果包含此恶意 URL 的响应被缓存了,那么当某个用户的请求与缓存键匹配时,攻击者的 JavaScript 代码就会被导入并在该用户的浏览器会话中执行。
GET / HTTP/1.1
Host: innocent-website.com
X-Forwarded-Host: evil-user.net
User-Agent: Mozilla/5.0 Firefox/57.0

HTTP/1.1 200 OK
<script src="https://evil-user.net/static/analytics.js"></script>
利用与 Cookie 处理相关的漏洞
在响应中,通常会使用 Cookie 来动态生成内容。一个常见的例子是使用 Cookie 来记录用户的偏好语言,然后根据该语言加载相应版本的页面内容。
GET /blog/post.php?mobile=1 HTTP/1.1
Host: innocent-website.com
User-Agent: Mozilla/5.0 Firefox/57.0
Cookie: language=pl;
Connection: close
在这个示例中,用户请求的是博客文章的波兰语版本。注意,关于应提供哪种语言版本的信息仅包含在 Cookie 头部中。假设缓存键包含了请求行以及 Host 头部的信息,但不包含 Cookie 头部的信息。在这种情况下,如果对该请求的响应被缓存了,那么所有后续尝试访问该博客文章的用户都将获得波兰语版本的内容,而不管他们实际选择了哪种语言。
缓存对 Cookie 处理上的缺陷也可以被利用,通过网页缓存中毒技术来攻击。不过实际上,与基于头部信息的缓存中毒相比,这种攻击方式相对较少见。当存在基于 Cookie 的缓存中毒漏洞时,由于是合法用户无意中破坏了缓存,因此这些漏洞往往能够很快被识别并修复。
利用多个头部信息来利用网页缓存中毒漏洞
正如上文所示,一些网站容易受到简单的网络缓存攻击的破坏。然而,另一些网站则需要更复杂的攻击手段,只有当攻击者能够构造出可以操控多个未加密参数的请求时,这些网站才会变得脆弱。
例如,假设有一个网站需要使用 HTTPS 进行安全通信。为了强制执行这一要求,如果收到的是使用其他协议的请求,该网站会动态生成一个重定向链接,指向一个使用 HTTPS 的网站。
GET /random HTTP/1.1
Host: innocent-site.com
X-Forwarded-Proto: http

HTTP/1.1 301 moved permanently
Location: https://innocent-site.com/random
仅从这种行为本身来看,它并不一定具有攻击性。然而,如果将这种行为与我们之前关于动态生成的 URL 所存在的漏洞知识结合起来,攻击者就有可能利用这种行为来生成可缓存的响应,从而将用户重定向到恶意 URL 地址。
Note
在该场景下,若要利用,则要响应中的Location是根据Host等进行动态生成,且攻击者可控
利用信息泄漏
有时候,一些网站因为泄露了太多关于自身以及其行为的信息,从而使得自己更容易受到网络缓存中毒的攻击。
缓存控制指令
在构建网络缓存攻击时,其中一个挑战就是确保有害的响应能够被缓存起来。这通常需要大量的手动尝试和调试,以了解缓存器的行为。不过,有时候,响应本身就会透露出一些关键信息,这些信息对于攻击者成功篡改缓存器来说非常重要。
一个这样的例子就是,当响应中包含有关缓存被清理的频率,或者当前缓存的响应保存了多久的信息时。
虽然这并不直接导致网络缓存中毒漏洞,但至少可以节省攻击者一些手动操作的工作。因为攻击者可以准确知道何时发送恶意代码,以确保代码能够被缓存起来。
这种知识还使得攻击者能够实施更为隐蔽的攻击手段。他们不必通过不断向后端服务器发送请求来迫使服务器处理某个特定的请求,因为这样做可能会引起怀疑。攻击者可以精心安排一次恶意请求,从而逐渐污染缓存数据。
Vary请求头
Vary 头部这种基础性的使用方式,实际上也为攻击者提供了便利。 Vary 头部可以指定一系列额外的头部信息,这些信息即使通常并不作为缓存键的一部分,但仍然会被视为缓存键的一部分。通常, User-Agent 头部会被设置为键,这样当缓存网站的移动版本时,就不会错误地向非移动设备用户提供服务。
这些信息还可以用来实施多步骤攻击,以针对特定的用户群体。例如,如果攻击者知道 User-Agent头部是缓存键的一部分,他们可以通过识别目标用户的用户代理来定制攻击方式,使得只有拥有该用户代理的用户受到影响。或者,他们可以找出最常用的访问该网站的用户代理,然后调整攻击方式,以影响尽可能多的用户。
利用基于 DOM 的漏洞
如前所述,如果网站在不安全的情况下使用未加密的头部信息来导入文件,那么攻击者就有可能利用这一点来导入恶意文件。不过,这种情况并不只适用于 JavaScript 文件,而是适用于所有类型的文件。
许多网站使用 JavaScript 从后端获取和处理额外数据。如果脚本以不安全的方式处理来自服务器的数据,就可能会导致各种基于 DOM 的漏洞。
例如,攻击者可以通过发送一个包含以下有效载荷的 JSON 文件来污染缓存:
如果该网站将此属性的值传递给支持动态代码执行的脚本,那么负载内容就会在受害者的浏览器会话上下文中被执行。
如果你使用网络缓存注入攻击的方式,让一个网站从你的服务器加载恶意的 JSON 数据,那么你可能需要通过 CORS 机制允许该网站访问这些 JSON 数据。
HTTP/1.1 200 OK
Content-Type: application/json
Access-Control-Allow-Origin: *

{
    "malicious json" : "malicious json"
}
利用缓存实现中的缺陷进行攻击
Note
https://portswigger.net/web-security/web-cache-poisoning/exploiting-implementation-flaws
如何防止Web缓存中毒漏洞
防止网络缓存中毒的彻底方法显然就是完全禁用缓存功能。虽然对于许多网站来说,这可能不是一个可行的选择,但在其他情况下,这样做可能是可行的。例如,如果你只是因为采用了 CDN 而默认开启了缓存功能,那么值得考虑一下是否默认缓存选项真的符合你的需求。
即使你确实需要使用缓存,也将缓存限制在纯静态响应上也是有效的做法。当然,你也需要充分注意那些被定义为“静态”的数据,确保攻击者无法诱使后端服务器获取错误的、恶意版本的静态资源,而不是正确的版本。
这也与网络安全相关。如今,大多数网站在开发过程和日常运营中都会引入各种第三方技术。无论您自身的内部安全措施有多么完善,一旦在环境中使用了第三方技术,就意味着您需要依赖这些技术的开发者也能像您一样注重安全性。鉴于安全的程度取决于最薄弱的环节,因此在集成任何第三方技术之前,确保完全理解其安全影响是非常重要的。
特别是在网页缓存中毒这种情况下,这意味着不仅要决定是否默认保持缓存功能开启,还要考虑你的内容分发网络支持哪些头部信息。上述几种网页缓存中毒漏洞之所以存在,是因为攻击者能够操纵一系列看似无用的请求头部信息,而这些头部信息对网站的功能来说其实完全没有必要。再次提醒,你可能在没有意识到的情况下就陷入了这种攻击的陷阱,仅仅因为你的系统默认支持接受这些无意义的输入。如果某个头部信息对网站的运行并不必要,那么就应该将其禁用。
在实施缓存时,你还应该采取以下预防措施:
- 如果你出于性能考虑想要从缓存键中排除某些内容,请重新编写相应的请求。
- 不要接受fat
GETrequests。请注意,某些第三方技术可能会默认允许这种操作。 - 即使那些客户端侧的漏洞看起来无法被利用,但实际上仍有可能被利用。其中一些漏洞可能因为缓存行为的不可预测性而变得可利用。只要过一段时间,总会有某人发现某个漏洞,无论是基于缓存还是其他方面的漏洞,都能被利用起来。