路由配置与管理
以思科设备为例,环境为思科模拟器(Cisco Packet Tracer)
路由基础配置
配置密码
# 进入特权模式
enable/en
# 进入配置模式
configure/config
# 设置明文密码
enable password <pass>
# 设置密文密码(md5加密)
enable secret <pass>
当明文密码和加密密码同时配置的时候,只能够是加密的密码生效。

配置IP
也可以通过图形化界面配置
配置telnet登录
# 首先需要配置IP

# 配置最大允许连接数(最大为0~15)
# format: line vty <start> <end>
config> line vty 0

# 设置密码
config-line> password 123
# 开启登录
# login要求提供密码,login local要求用户名和密码
config-line> login/login local

# 添加可登录路由的用户名和密码(配置了login local)
config-line> exit
config> username aker password 123
删除配置
二层路由配置
拓扑图如下:
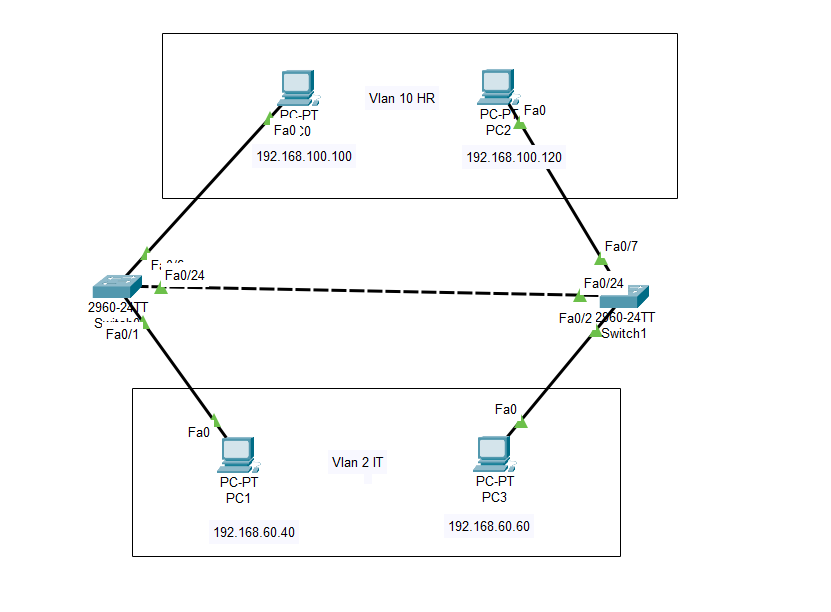
| PC | IP | 网段 |
|---|---|---|
| PC0 | 192.168.100.100 | 255.255.255.0 |
| PC1 | 192.168.60.40 | 255.255.255.0 |
| PC2 | 192.168.100.120 | 255.255.255.0 |
| PC3 | 192.168.60.60 | 255.255.255.0 |
要求配置两个Vlan,实现网络的隔离,并且同一Vlan下的主机能够互相ping,不同Vlan主机之间相隔离
配置vlan
VLAN(Virtual Local Area Network)即虚拟局域网,是将一个物理的LAN在逻辑上划分成多个广播域的通信技术。
每个VLAN是一个广播域,VLAN内的主机间可以直接通信,而VLAN间则不能直接互通。这样,广播报文就被限制在一个VLAN内。
# 进入交换机 Switch0
# 创建 VLAN 10
config> vlan 10
config-vlan> exit

# 进入接口 Fa0/0
config> interface fastEthernet 0/0 or f0/0
# 我们也可以一次进入多个接口(进入f0的0-5端口)
config> interface range fastEthernet 0/0-5
# 绑定vlan
config-if> switchport access vlan 10
config-if> no shutdown
# 结束配置
config-if> end

# 配置vlan 2同理
Switch1配置同理,不再赘述
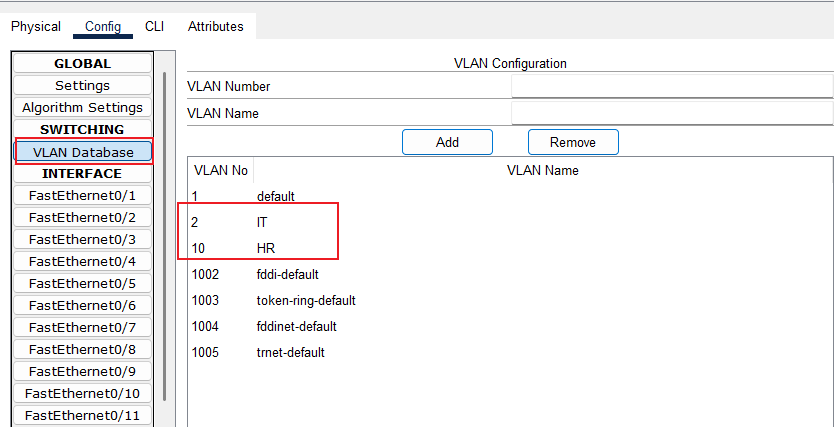
图形化界面配置
- 添加vlan
- 绑定接口
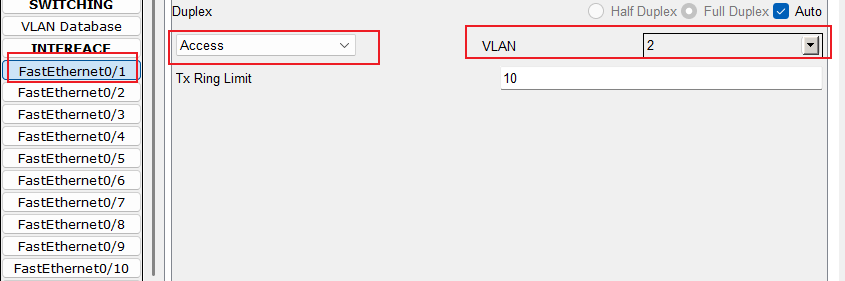
选择对应的vlan即可
交换机之间联通配置
交换机的端口
- ACCESS端口
Access端口只能属于一个VLAN,它发送的帧不带有VLAN标签,一般用于连接计算机的端口
- Trunk端口
可以允许多个VLAN通过,它发出的帧一般是带有VLAN标签的,一般用于交换机之间连接的端口
所以我们需要配置交换机之间使用trunk端口连接
配置trunk
# Switch0
Switch(config) interface fastEthernet 0/24
# 设置接口模式为 Trunk 模式
Switch(config-if) switchport mode trunk
Switch(config-if) no shutdown
Switch(config-if) end

# Switch1同理
结果验证
经过上述配置后,我们已经成功完成了要求
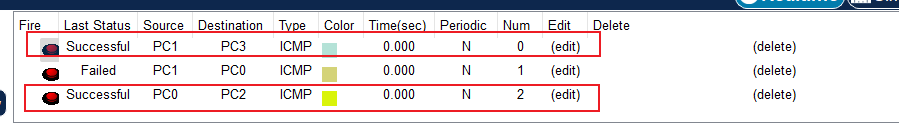
可以看到vlan之间可以互相ping通,不同vlan之间不能互通
生成树协议、端口聚合和安全端口
拓扑图如下:
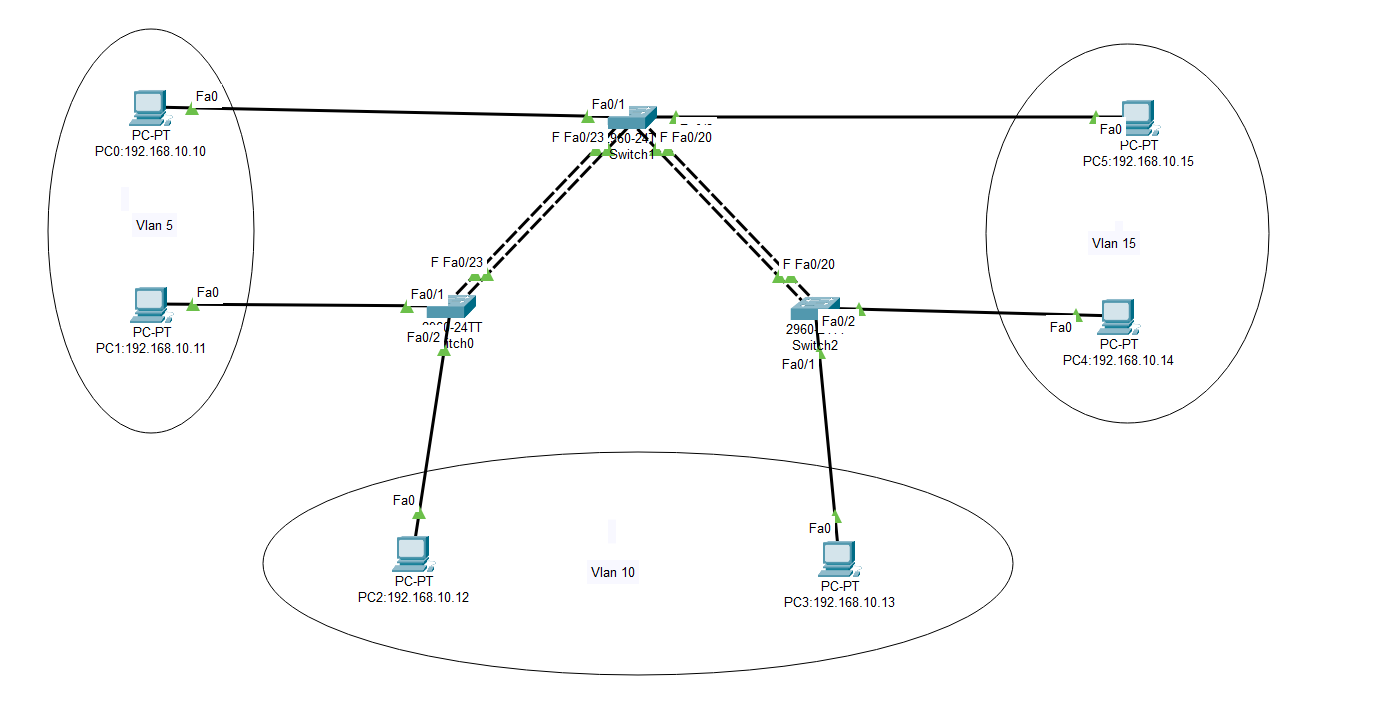
配置交换机端口聚合和安全端口、配置流量均衡策略,实现互联互通
| PC | IP | 网段 |
|---|---|---|
| PC0 | 192.168.10.10 | 255.255.255.0 |
| PC1 | 192.168.10.11 | 255.255.255.0 |
| PC2 | 192.168.10.12 | 255.255.255.0 |
| PC3 | 192.168.10.13 | 255.255.255.0 |
| PC4 | 192.168.10.14 | 255.255.255.0 |
| PC5 | 192.168.10.15 | 255.255.255.0 |
端口聚合配置
端口聚合(又称为链路聚合),将交换机上的多个端口在物理上连接起来,在逻辑上捆绑在一起,形成一个拥有较大宽带的端口,可以实现负载分担,并提供冗余链路。
技术原理
- 端口聚合使用的是EtherChannel特性,在交换机到交换机之间提供冗余的高速的连接方式。将两个设备之间多条FastEthernet或GigabitEthernet物理链路捆在一起组成一条设备间逻辑链路,从而增强带宽,提供冗余。
- 两台交换机到计算机的速率都是100M,SW1和SW2之间虽有两条100M的物理通道相连,可由于生成树的原因,只有100M可用,交换机之间的链路很容易形成瓶颈,使用端口聚合技术,把两个100M链路聚合成一个200M的逻辑链路,当一条链路出现故障,另一条链路会继续工作。
- 一台S2000系列以太网交换机只能有1个汇聚组,1个汇聚组最多可以有4个端口。组内的端口号必须连续,但对起始端口无特殊要求。
- 在一个端口汇聚组中,端口号最小的作为主端口,其他的作为成员端口。同一个汇聚组中成员端口的链路类型与主端口的链路类型保持一致,即如果主端口为Trunk端口,则成员端口也为Trunk端口;如主端口的链路类型改为Access端口,则成员端口的链路类型也变为Access端口。
- 所有参加聚合的端口都必须工作在全双工模式下,且工作速率相同才能进行聚合。并且聚合功能需要在链路两端同时配置方能生效。
- 端口聚合主要应用的场合:
- 交换机与交换机之间的连接:汇聚层交换机到核心层交换机或核心层交换机之间。
- 交换机与服务器之间的连接:集群服务器采用多网卡与交换机连接提供集中访问。
- 交换机与路由器之间的连接:交换机和路由器采用端口聚合解决广域网和局域网连接瓶颈。
- 服务器和路由器之间的连接:集群服务器采用多网卡与路由器连接提供集中访问
# Switch0
# 创建AP1
config> interface port-channel 1
config> interface range f0/23-24
# trunk模式
config-if> Switchport mode trunk
# 将接口加入AP1并开启
config-if> channel-group 1 mode on
config-if> end

# 如果你想要删除AP中的接口
config-if> no channel-group

# Switch1和Switch2同理
RSTP配置
**生成树协议(spanning-tree )**作用是在交换网络中提供冗余备份链路,并且解决交换网络中的环路问题.。
**生成树协议**是利用 SPA 算法(生成树算法),在存在交换环路的网络中生成一个没有环路的树形网络。运用该算法将交换网络冗余的备份链路逻辑上断开,当主要链路出现故障时,能够自动地切换到备份链路,保证数据的正常转发。
生成树协议的特点是收敛时间长。从主要链路出现故障到切换到备份链路需要50秒的时间。
快速生成树协议(RSTP)在生成树协议的基础上增加了两种端口角色:替换端口(Alternate Port)和备份端口(Backup Port),分别作为根端口(Root Port)和指定端口(Designated Port) 的冗余端口。当根端口或指定端口出现故障时,冗余端口不需要经过50秒的收敛时间,可以直接切换到替换端口或备份端口。从而实现 RSTP协议小于1秒的快速收敛。
按照拓扑图连接网络时注意,先不要将交换机的两条线相连,再两台交换机都配置快速生成树协议后,再将两台交换机连接起来。如果先连线再配置会造成广播风暴,影响交换机的正常工作。
# Switch0
# 开启RSTP
config> spanning-tree mode rapid-pvst
# 设置switch0为根交换机
config> spanning-tree vlan 10 priority 4096

# 其他交换机也需要开启RSTP协议
如果 Sw1 与 Sw2 之间的一条链路 shutdown 掉(如拔掉网线), vlan10主机之间仍能ping通
配置流量平衡
流量平衡:把流量平均地分配到AP的成员链路中去
- 可以根据源MAC地址、目的MAC地址或源IP地址/目的IP地址
- 应根据不同的网络环境设置合适的流量分配方式
# 比如配置Switch0 以源mac地址作流量平衡
config> interface port-channel 1
# 启用三层接口(三层交换机)
config-if> no switchport
config-if> exit
# 设置流量平衡策略
# format: port-channel load-balance {dst-mac|src-mac|src-dst mac|dst-ip|src-ip|ip }
config> port-channel load-balance src-mac
config> end
配置安全端口
# Switch0
# 进入f0/2接口
config> interface f0/2
# 启用安全端口
config-if> switchport port-security
# 设置最大值(最多只有一台主机能访问接口)
config-if> switchport port-security maximum 1
# 动态获取设备的 MAC 地址并将其添加到运行配置(在设备访问一次接口后会自动添加)
config-if> switchport port-security mac-address sticky
config-if> end
这样,只有第一台访问f0/2接口的主机能继续访问,其他主机将会被拦截
效果验证
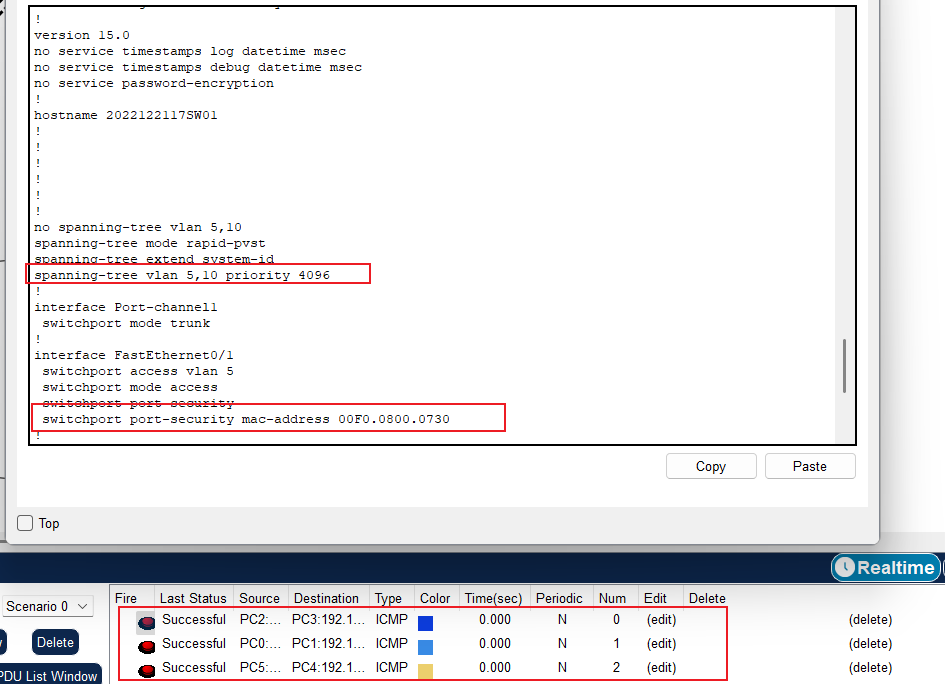
同一vlan主机能够互通且完成相关配置
Vlan之间通信
有两种方法
- 三层交换机
- 单臂路由
三层交换机

# 以上为配置Vlan,不再赘述

# 关键配置如下:
Switch(config)#int range g1/0/1-2
Switch(config-if-range)#switchport trunk encapsulation dot1q
Switch(config-if-range)#switchport mode trunk
# allowed后跟允许通信的vlan号 all表示允许所有vlan互相通信
Switch(config-if-range)#switchport trunk allowed vlan all
# 开启路由功能
Switch(config)# ip   routing
单臂路由

# 在路由上配置

Router(config)> interface fa0/0
Router(config-if)> no shutdown
# 进入子接口fa0/0.1,开启端口
Router(config-if)> interface fa0/0.1
# 子接口封装802.1q,配置到不同的Vlan中,encapsulation dot1q 后面的数字应为vlan ID
Router(config-subif)> encapsulation dot1q 10
# 设置子接口IP为相应Vlan中的网关地址
Router(config-subif)> ip address 192.168.1.1 255.255.255.0
Router(config-subif)> exit
Router(config)> interface fa0/0.2
Router(config-subif)> encapsulation dot1q 20
Router(config-subif)> ip address 192.168.2.1 255.255.255.0
Router(config-subif)> end
实质为子接口充当了网关的角色,网关之间互相转发和去除/重新打上vlan标签,使得不同的vlan之间可以互相通信
静态路由
静态路由选择算法是一种非适应性路由选择算法,这是一种不测量、依靠手动输入的信息来配置路由表的。
静态路由需要手动在路由器配置下一跳的地址,通常只在小型较稳定(网络变化小)的网络中使用
实验
拓扑图如下:
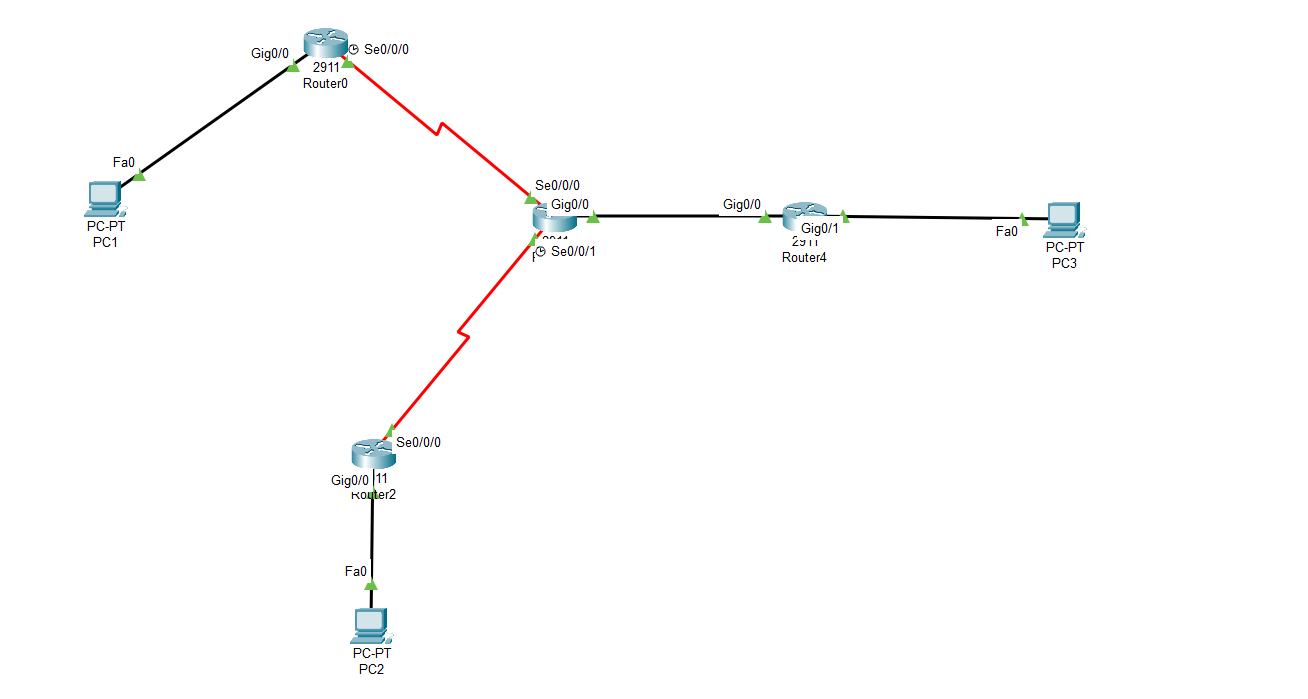
要求配置静态路由并使得PC之间能够互相访问
| 路由 | 接口 | IP | 网段 |
|---|---|---|---|
| Router0 | g0/0 s0/0/0 |
192.168.1.1/27 192.168.1.65/27 |
255.255.255.224 |
| Router1 | g0/0 s0/0/0 s0/0/1 |
192.168.1.192/27 192.168.1.66/27 10.4.6.1/24 |
255.255.255.224 255.255.255.0 |
| Router2 | g0/0 s0/0/0 |
10.4.7.1/24 10.4.6.2/24 |
255.255.255.0 |
| Router3 | g0/0 g0/1 |
192.168.1.194/27 10.1.5.1/16 |
255.255.255.224 255.255.0.0 |
| PC | IP | 网段 |
|---|---|---|
| PC1 | 192.168.1.2 | 255.255.255.224 |
| PC2 | 10.4.7.2 | 255.255.255.0 |
| PC3 | 10.1.5.2 | 255.255.0.0 |
需要注意的是,路由器之间相连接需要扩展接口
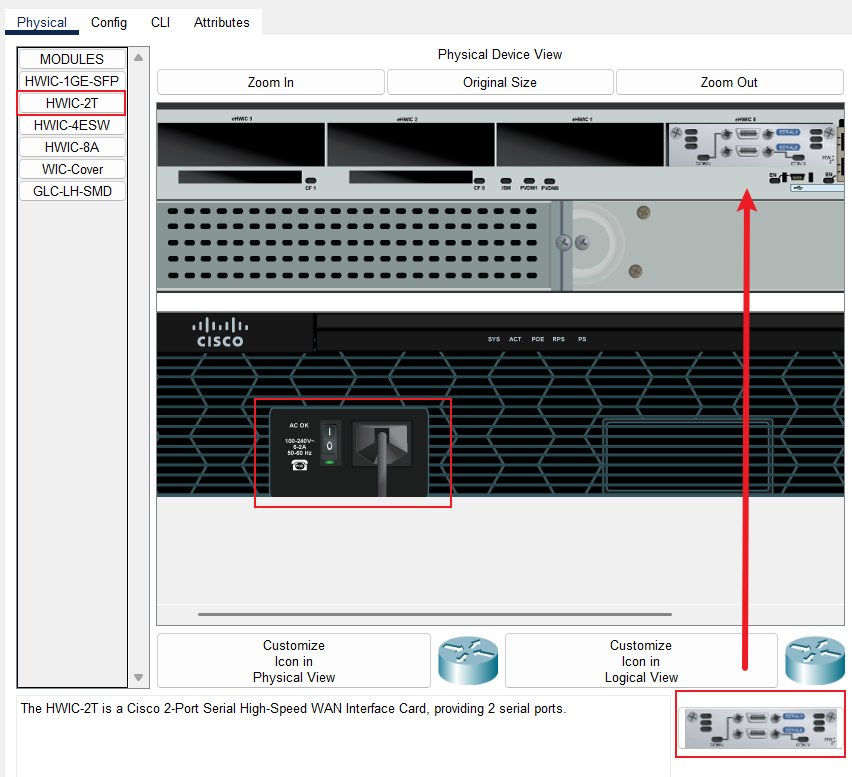
选择器件后先关闭电源,再加入扩展
# 以中间的路由配置静态为例
# format:
# ip route 你要到达的相邻网络号区域 子网掩码 要经过的最近IP地址

config> interface s0/0/0
config-if> ip route 192.168.1.0 255.255.255.224 192.168.1.65
config-if> exit
config> interface s0/0/1
config-if> ip route 10.4.7.0 255.255.255.0 10.4.6.2
config> exit
config> interface g0/0
config-if> ip route 10.1.0.0 255.255.0.0 192.168.1.194
config> exit

# 其他路由配置同理
默认路由的配置
这意味着如果在静态路由表中找不到的地址会默认转发到指定的下一跳路由
图形化界面配置
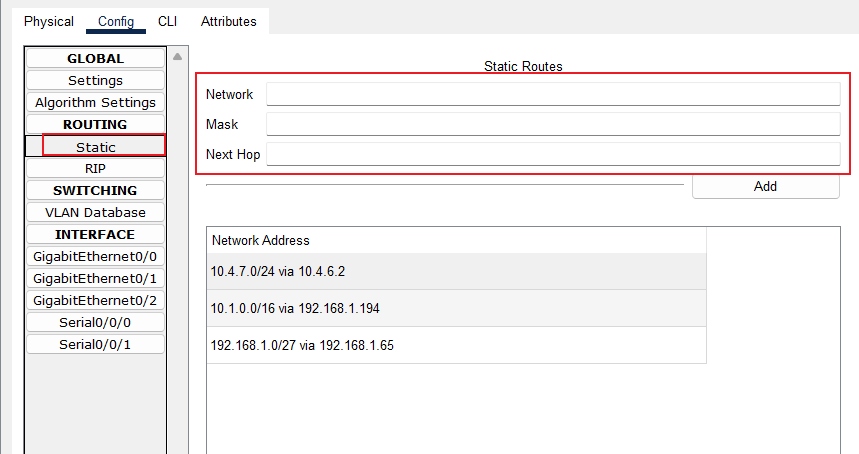
静态路由配置的关键就是明确目的IP段应该交给哪一个路由(下一跳)去转发
结果验证
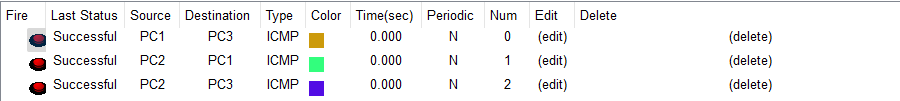
各PC应该能相互ping通
动态路由-OSPF
OSPF协议是有IETF组织开发的开放性标准协议,他是一个链路状态内部网关路由协议,运行OSPF协议的路由器会将自己拥有的链路状态信息,通过启用OSPF协议的接口发送给其他OSPF协议设备,同一个OSPF协议区域中的每台设备都会参与链路状态信息的创建、发送、接收与转发,直至这个区域中的所有OSPF协议设备都获得了相同的链路状态信息为止。
- 一个OSPF协议网络可以被划分成多个区域(Area)。如果一个OSPF协议网络只包含一个区域,则被称为单区域OSPF协议网络;如果一个OSPF协议网络包含多个区域,则被称为多区域OSPF协议网络。
- 在OSPF协议网络中,每一个区域都有一个编号,称为区域ID(Area ID)。
- 区域ID 是一个32位的二进制数,一般用十进制数来表示。
- 区域ID为0的区域称为骨干区域(Backbone Area),其他区域为非骨干区域。
- 单区域OSPF协议网络中只包含一个区域,这个区域就是骨干区域。
- 在多区域中,除骨干区域,其他都是非骨干区域
- 非骨干区域之间的通信必须要通过骨干区域中转才能实现,当非骨干区域没有与骨干区域直连时,要采用虚链路(Virtual Link)技术从逻辑上实现非骨干区域与骨干区域的直连。
同区域OSPF
拓扑图如下:
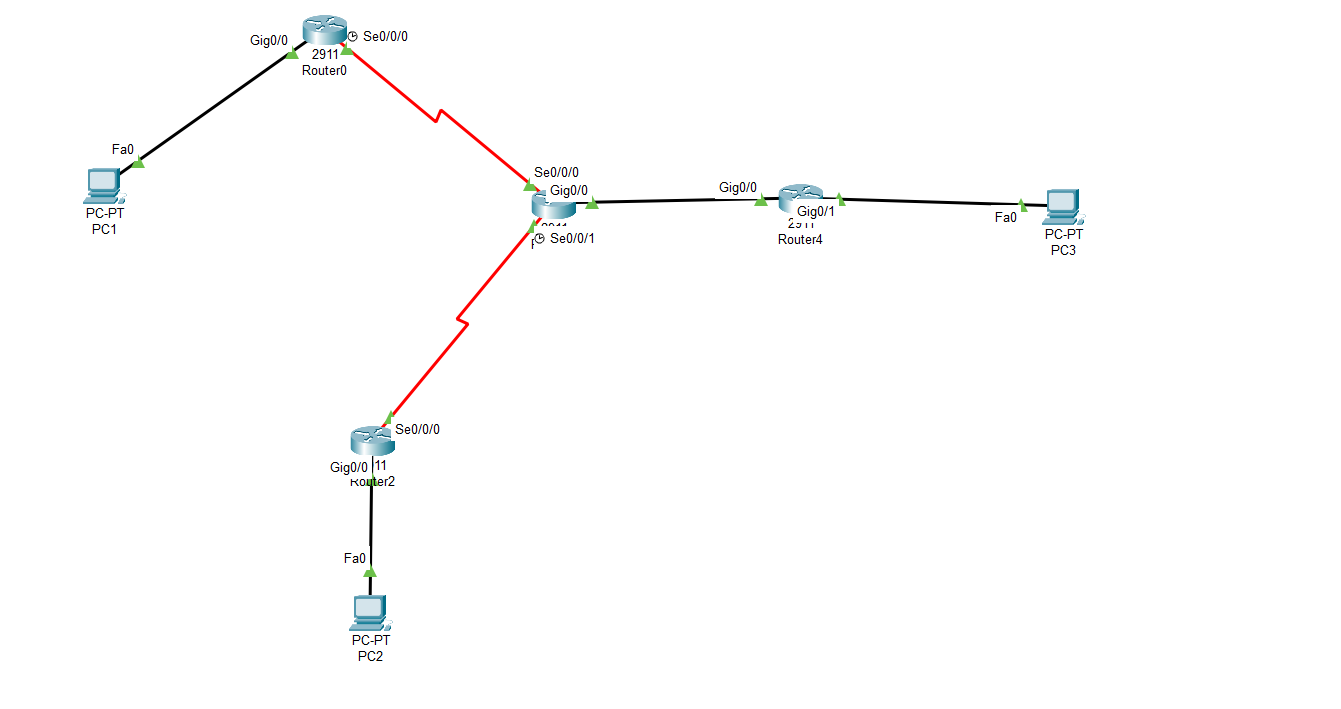
要求配置多区域的OSPF协议,同一区域能够互相访问,不同区域之间隔离
| 路由 | 接口 | IP | 网段 |
|---|---|---|---|
| Router0 | g0/0 s0/0/0 |
192.168.1.1/27 192.168.1.65/27 |
255.255.255.224 |
| Router1 | g0/0 s0/0/0 s0/0/1 |
192.168.1.193/27 192.168.1.66/27 10.4.6.1/24 |
255.255.255.224 255.255.255.0 |
| Router2 | g0/0 s0/0/0 |
10.4.7.1/24 10.4.6.2/24 |
255.255.255.0 |
| Router4 | g0/0 g0/1 |
192.168.1.194/27 10.1.5.1/16 |
255.255.255.224 255.255.0.0 |
| PC | IP | 网段 |
|---|---|---|
| PC1 | 192.168.1.2 | 255.255.255.224 |
| PC2 | 10.4.7.2 | 255.255.255.0 |
| PC3 | 10.1.5.2 | 255.255.0.0 |
# 以Router为例配置OSPF协议
config> Router ospf 10
# 添加邻居网络
# format:
# network IP 反掩码 area <num>
# 比如掩码为255.255.255.224, 那么反掩码为255-255.255-255.255-255.255-224 --> 0.0.0.31
config> network 192.168.1.64 0.0.0.31 area 0
config> network 192.168.1.192 0.0.0.31 area 0
config> network 10.4.6.0 0.0.0.255 area 0

# 其他路由同理
OSPF配置的关键在于配置相邻的network
效果验证
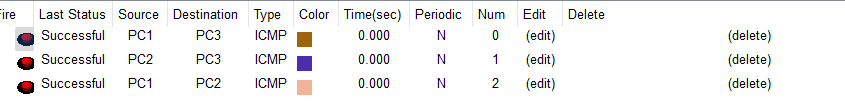
所有的PC间可以相互ping通
多区域的OSPF
和同区域的区别仅仅是区域号配置成不同的,保证区域之间隔离
拓扑图如下:
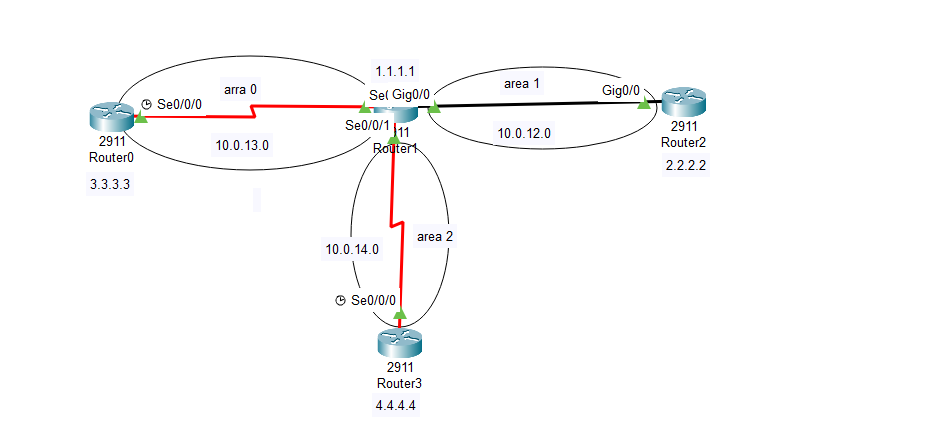
图中路由使用localback接口模拟另一台接入路由的PC
Loopback是路由器里面的一个逻辑接口。逻辑接口是指能够实现数据交换功能,但是物理上不存在、需要通过配置建立的接口。Loopback接口一旦被创建,其物理状态和链路协议状态永远是Up,即使该接口上没有配置IP地址。正是因为这个特性,Loopback接口具有特殊的用途。
| 路由 | 接口 | IP | 网段 |
|---|---|---|---|
| Router0 | localback s0/0/0 |
3.3.3.3/24 10.0.13.10/24 |
255.255.255.0 |
| Router1 | localback g0/0 s0/0/0 s0/0/1 |
1.1.1.1/24 10.0.12.10/24 10.0.13.20/24 10.0.14.10/24 |
255.255.255.0 |
| Router2 | localback g0/0 |
2.2.2.2/24 10.0.12.20/24 |
255.255.255.0 |
| Router3 | localback s0/0/0 |
4.4.4.4/24 10.0.14.20/24 |
255.255.255.0 |
# 以Router2为例进行配置

config> Interface loopback 0
config-if> Ip address 1.1.1.1 255.255.255.0
config-if> exit
config> Router ospf 10
config> network 10.0.13.0 0.0.0.255 area 0
config> network 1.1.1.0 0.0.0.255 area 2
config> network 10.0.12.0 0.0.0.255 area 1

# 其他路由同理
RIP协议
RIP(Routing Information Protocols)属于内部网关协议(IGP),用于一个自治系统内部,是一种基于距离向量的分布式的路由选择协议,实现简单,应用较为广泛。由于RIP不支持子网及跳数太少的原因,实际上常用的是RIPv2版本。可以从以下及格方面理解RIP的特点。
- 在RIP协议中,距离最短的路由就是最好的路由。RIP协议对距离的度量是跳数。初始的直连路由距离为1,此后每经过一台路由器,跳数就加1,这样,经过的路由器数量越多,距离也就越长。RIP规定,一条路由器最大的跳数为15,也就是最大的距离为16,距离越出16的路由被认为不可达,会被删除。
- RIP中的路由跟新是通过定时广播实现的,接收对象为邻居。在默认情况下,路由器每隔30秒向与它项链的网络广播自己的路由表,街道广播的路由器将收到的信息按一定算法添加到自身的路由表中。每个路由器都这样广播,最终网络上所有的路由器都会得知全部RIP范围的路由信息。
-
环路的解决方法:在RIP中也存在环路问题,如好消息传播得快,坏消息传播得慢。解决办法通常有以下几种。
-
定义最大跳数。比如,将TTL值设为16,如果环路陷入分组循环中,则跳数耗尽后就会被消灭,在RIP中就被视为网络不可达而被删除。
- 水平分割。水平分割即单项路由更新,它保证路由器记住每一条路由信息来源,并且不在收到这条信息的端口上再次发送它,这是不产生路由循环得最基本的措施。A从B处得到一个网络的路由信息,A不会向B更新该网络可以通过B到达得信息。这样,当该网络出现故障不可达时,B会将路由信息通告给A,而A则不会把可以通过B到达该网络的路由信息通过高给B。如此便可以加快网络收敛,破坏路由环路。
- 路由毒化。当某直连网络发生故障时,路由器将其度量值标为无穷大,并将此路由信息通告给邻居,邻居再向其邻居通告,依次度化个路由器,从而避免环路。
- 空值更新时间。也称抑制计时,当一条路由信息无效之后,就在一段时间内使这条路由处于抑制状态,即不再接收关于相同目的地址的路由更新。显然,当一个网络频繁的在有效和无效间切换时,往往是有问题的,这时,将该网络的路由信息在一定时间内不更新,可以增加网络的稳定性,避免路由振荡,是合理的。
RIP V1和RIP V2的区别
- RIPv1是有类路由协议,RIPv2是无类路由协议。
- RIPv1不能支持VLSM,RIPv2可以支持VLSM。
- RIPv1没有认证的功能,RIPv2可以支持认证,并且有明文和MD5两种认证。
- RIPv1没有手工汇总的功能,RIPv2可以在关闭自动汇总的前提下进行手工汇总。
- RIPv1是广播更新,RIPv2是组播更新。
- RIPv1对路由没有打标记的功能,RIPv2可以对路由打标记(tag),用于过滤和指定策略。
RIP协议配置
RIP配置相较于OSPF协议不需要配置区域,所以配置更加简单
# 以Router3为例

# rip V1
config> router rip
config> version 1
config> network 192.168.1.64
config> network 192.168.1.192
config> network 10.4.6.0

# rip V2
config> router rip
config> version 2
config> network 192.168.1.64
config> network 192.168.1.192
config> network 10.4.6.0
# 关闭路由自动汇总(默认开启)
config> no auto-summary
# 路由汇总:当出现连续网络同属于一个大型网络的子网时(注意,这里的子网必须是目标汇总网络的全部子网集合),则系统会自动将这些网络汇总成为一个大型网络。
ACL访问控制列表
ACL是应用在路由器接口的指令列表,通过这些指令,来告诉路由器哪些数据包可以接收,哪些数据包需要拒绝,基本原理就是:ACL使用包过滤技术,在路由器上读取OSI七层模型的第三层及第四层包头中的信息,如源地址、目的地址、源端口、目的端口等,根据预先定义好的规则,对包进行过滤,从而达到访问控制的目的。 ACL有三种类型:
- 标准ACL:根据数据包的源IP地址来允许或拒绝数据包,标准ACL的访问列表控制号是1~99。
- 扩展ACL:根据数据包的源IP地址、目的IP地址、指定协议、端口和标志来允许或拒绝数据包,扩展ACL的访问控制列表号是100~199。
- 命名ACL允许在标准ACL和扩展ACL中使用名称代替表号。

创建标准ACL语法
(若源地址为主机,则在地址前面需要加“host”;若源地址为网段,则要在网段地址后面加反掩码,如/24的反掩码就是0.0.0.255。
Router(config)> access-list 1 permit 192.168.1.0 0.0.0.255
# 表示为允许192.168.1.0/24网段地址的流量通过

Router(config)> access-list 1 permit host 192.168.2.1
# 表示为允许主机192.168.2.1的流量通过。
每一个ACL都有一条隐含的拒绝语句,可以拒绝所有流量,所以在做ACL规则时建议以拒绝某个网段或主机的流量通过,然后再允许所有流量通过,如下:
Router(config)> access-list 1 deny host 192.168.1.2
# 拒绝192.168.1.2网段的流量通过

Router(config)> access-list 1 permit any
# 允许所有主机的流量通过
当以上ACL规则应用到接口上时,效果为除了192.168.1.2的流量外都可以通过。源地址可以用 “any”来表示为所有主机。
ACL应用的方向

一个ACL可以配置多条规则,但是一个接口,一个方向只能应用一个ACL。
配置好的ACL规则应用到接口上的语法如下:
Router(config)> int f0/1
Router(config-if)> ip access-list 1 in/out
# 把表号1的规则应用到进站(in)或出站(out)方向
扩展ACL的配置语法
- 语法1
Router(config)> access-list 101 permit ip 192.168.1.0 0.0.0.255 192.168.2.0 0.0.0.255
# 创建一个表号为101的ACL,规则为允许192.168.1.0访问192.168.2.0网段的流量通过

Router(config)> access-list 101 deny ip any any
# 拒绝所有流量通过
以上规则最终应用到接口上的效果为拒绝除了192.168.1.0访问192.168.2.0的数据包以外的所有数据包通过
- 语法2
Router(config)> access-list 101 deny tcp 192.168.1.0 0.0.0.255 host 192.168.2.2 eq 21
# 拒绝网络192.168.1.0访问主机192.168.2.2,tcp端口号21的流量通过

Router(config)> access-list 101 permit ip any any
# 允许所有流量通过
以上扩展ACL的规则为:拒绝网络192.168.1.0访问主机192.168.2.2,tcp端口号21的流量通过,而允许其他任何流量通过。其中命令最后的eq为等于XX端口号,还有 lt (小于)、gt(大于)、neq(不等于)几个选项。
扩展ACL与标准ACL的区别就是扩展ACL可以基于端口号、目标地址、协议,来更加精准的控制流量是允许还是拒绝通过。
命名ACL的配置
命名ACL在管理及维护方面更加方便,同时也支持友好的名称作为ACL名称,而不局限于使用ACL编号。
配置命名ACL的语法如下:
Router(config)> ip access-list { standard | extended } access-list-name
# standard表示标准acl,extended表示扩展acl
实验
拓扑图如下:
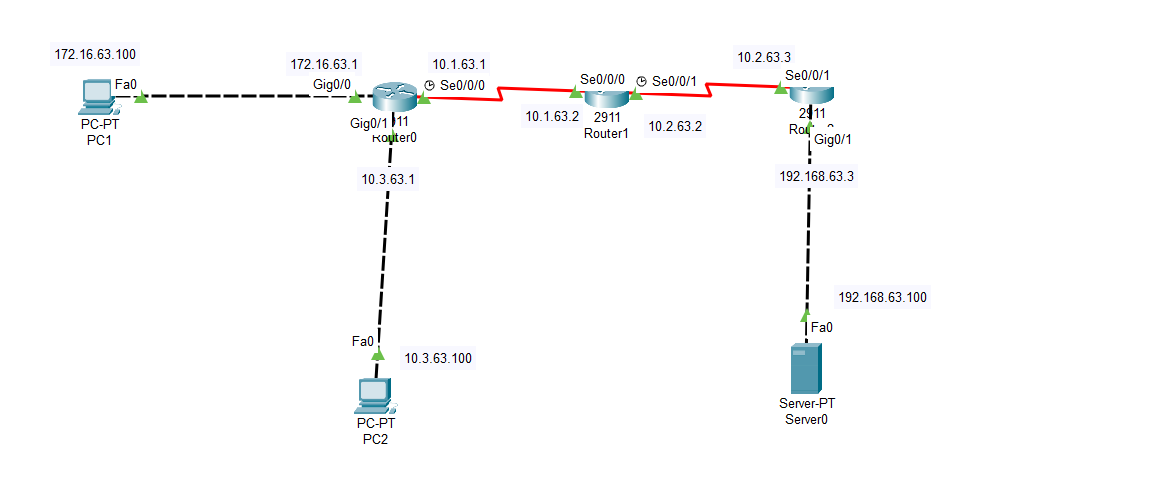
| 路由 | 接口 | IP | 网段 |
|---|---|---|---|
| Router0 | g0/0 g0/1 s0/0/0 |
172.16.63.1/16 10.3.63.1/16 10.1.63.1/16 |
255.255.0.0 |
| Router1 | s0/0/0 s0/0/1 |
10.1.63.2/16 10.2.63.2/16 |
255.255.0.0 |
| Router2 | g0/1 s0/0/1 |
192.168.63.3/24 10.2.63.3/16 |
255.255.255.0 255.255.0.0 |
| 主机/服务器 | IP | 网段 |
|---|---|---|
| PC1 | 172.16.63.100 | 255.255.0.0 |
| PC2 | 10.3.63.100 | 255.255.0.0 |
| Server0 | 192.168.63.100 | 255.255.255.0 |
实验要求
- 实现全网PC和服务器互通,服务器开启Web服务、FTP服务、DNS服务
- 使用标准ACL拒绝PC1所在网段访问PC2
- 拒绝PC1所在网段访问Server 192.168.63.100 的Web服务
- 拒绝PC2所在网段访问Server 192.168.63.100的FTP服务
- 拒绝PC1和PC2所在网段Ping Server服务器
- 对DNS服务访问不做限制
要求一可以配置动态路由或静态路由实现,不再赘述
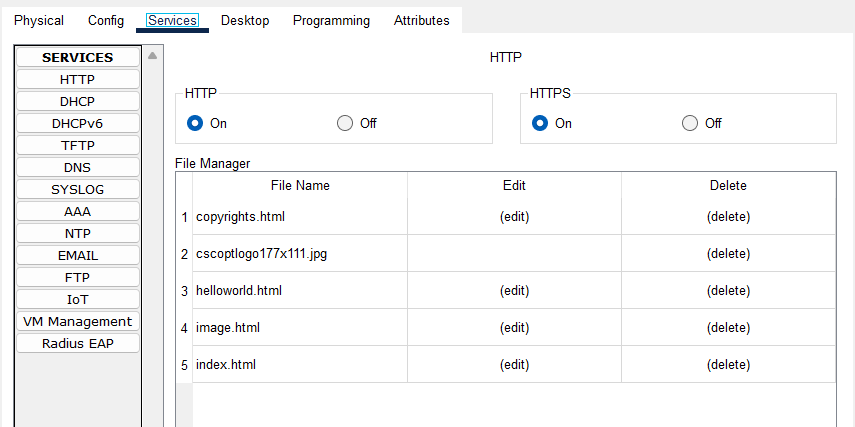
服务器开启对应服务
- 使用标准ACL拒绝PC1所在网段访问PC2
# 在Router0上配置

# 禁止172.16.0.0网段
config> access-list 1 deny 172.16.0.0 0.0.255.255
# 除此之外都允许
config> access-list 1 permit any
config> interface gigabitEthernet0/1
# 应用acl规则到g0/1,方向为出口方向
config-if> ip access-list 1 out
此时用PC1访问PC2会失败并且路由上的acl规则会匹配到
- 拒绝PC1所在网段访问Server 192.168.63.100 的Web服务
# 在Router2上配置

# 使用扩展ACL,拒绝172.16.0.0网段访问192.168.63.100主机的Web服务
config> access-list 100 deny tcp 172.16.0.0 0.0.255.255 host 192.168.63.100 eq www
# 除此之外的所有tcp请求都允许
config> access-list permit tcp any any
config> interface gigabitEthernet0/1
# 应用acl到g0/1的出口方向
config-if> ip access-group 100 out
- 拒绝PC2所在网段访问Server 192.168.63.100的FTP服务
# 在Router2上配置

config> access-list 100 deny tcp 10.3.0.0 0.0.255.255 host 192.168.63.100 eq ftp
config> interface gigabitEthernet0/1
config-if> ip access-group 100 out
需要注意的是,由于一个接口只能应用一个ACL,所以如果有多条规则需要都配置同一个ACL列表号
- 拒绝PC1和PC2所在网段Ping Server服务器
# 在Router2上配置

config> access-list 100 deny tcp 172.16.0.0 0.0.255.255 host 192.168.63.100 eq icmp
config> access-list 100 deny tcp 10.3.0.0 0.0.255.255 host 192.168.63.100 eq icmp
config>interface gigabitEthernet0/1
config-if> ip access-group 100 out
- 对DNS服务访问不做限制
# 在Router2上配置

config> access-list 100 permit udp any any eq domain
config>interface gigabitEthernet0/1
config-if> ip access-group 100 out
NAT地址转换
今天,无数快乐的互联网用户在尽情享受Internet带来的乐趣。他们浏览新闻,搜索资料,下载软件,广交新朋,分享信息,甚至于足不出户获取一切日用所需。企业利用互联网发布信息,传递资料和订单,提供技术支持,完成日常办公。然而,Internet在给亿万用户带来便利的同时,自身却面临一个致命的问题:构建这个无所不能的Internet的基础IPv4协议已经不能再提供新的网络地址了。
2011年2月3日中国农历新年, IANA对外宣布:IPv4地址空间最后5个地址块已经被分配给下属的5个地区委员会。2011年4月15日,亚太区委员会APNIC对外宣布,除了个别保留地址外,本区域所有的IPv4地址基本耗尽。一时之间,IPv4地址作为一种濒危资源身价陡增,各大网络公司出巨资收购剩余的空闲地址。其实,IPv4地址不足问题已不是新问题,早在20年以前,IPv4地址即将耗尽的问题就已经摆在Internet先驱们面前。这不禁让我们想去了解,是什么技术使这一危机延缓了尽20年。
NAT名字很准确,网络地址转换,就是替换IP报文头部的地址信息。NAT通常部署在一个组织的网络出口位置,通过将内部网络IP地址替换为出口的IP地址提供公网可达性和上层协议的连接能力。那么,什么是内部网络IP地址?
RFC1918规定了三个保留地址段落:10.0.0.0-10.255.255.255;172.16.0.0-172.31.255.255;192.168.0.0-192.168.255.255。这三个范围分别处于A,B,C类的地址段,不向特定的用户分配,被IANA作为私有地址保留。这些地址可以在任何组织或企业内部使用,和其他Internet地址的区别就是,仅能在内部使用,不能作为全球路由地址。这就是说,出了组织的管理范围这些地址就不再有意义,无论是作为源地址,还是目的地址。对于一个封闭的组织,如果其网络不连接到Internet,就可以使用这些地址而不用向IANA提出申请,而在内部的路由管理和报文传递方式与其他网络没有差异。
对于有Internet访问需求而内部又使用私有地址的网络,就要在组织的出口位置部署NAT网关,在报文离开私网进入Internet时,将源IP替换为公网地址,通常是出口设备的接口地址。一个对外的访问请求在到达目标以后,表现为由本组织出口设备发起,因此被请求的服务端可将响应由Internet发回出口网关。出口网关再将目的地址替换为私网的源主机地址,发回内部。这样一次由私网主机向公网服务端的请求和响应就在通信两端均无感知的情况下完成了。依据这种模型,数量庞大的内网主机就不再需要公有IP地址了。
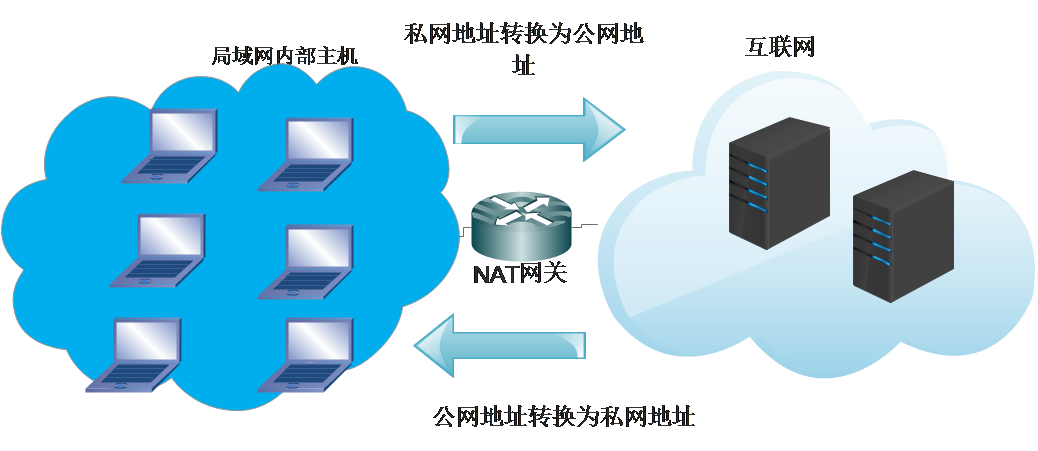
- 网络被分为私网和公网两个部分,NAT网关设置在私网到公网的路由出口位置,双向流量必须都要经过NAT网关
- 网络访问只能先由私网侧发起,公网无法主动访问私网主机;
- NAT网关在两个访问方向上完成两次地址的转换或翻译,出方向做源信息替换,入方向做目的信息替换;
- NAT网关的存在对通信双方是保持透明的;
- NAT网关为了实现双向翻译的功能,需要维护一张关联表,把会话的信息保存下来。
静态NAT
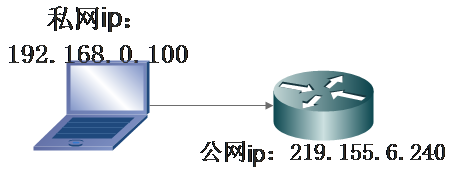
如果一个内部主机唯一占用一个公网IP,这种方式被称为一对一模型。此种方式下,转换上层协议就是不必要的,因为一个公网IP就能唯一对应一个内部主机。显然,这种方式对节约公网IP没有太大意义,主要是为了实现一些特殊的组网需求。比如用户希望隐藏内部主机的真实IP,或者实现两个IP地址重叠网络的通信。
动态NAT
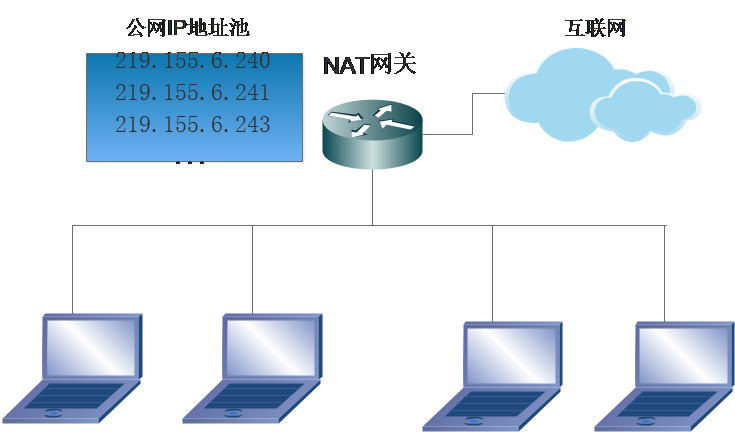
它能够将未注册的IP地址映射到注册IP地址池中的一个地址。不像使用静态NAT那样,你无需静态地配置路由器,使其将每个内部地址映射到一个外部地址,但必须有足够的公有因特网IP地址,让连接到因特网的主机都能够同时发送和接收分组
NAT重载(经常应用到实际中)
这是最常用的NAT类型。NAT重载也是动态NAT,它利用源端口将多个私网ip地址映射到一个公网ip地址(多对一)。那么,它的独特之处何在呢?它也被称为端口地址特换(PAT)。通过使用PAT(NAT重载),只需使用一个公网ip地址,就可将数千名用户连接到因特网。其核心之处就在于利用端口号实现公网和私网的转换。
面对私网内部数量庞大的主机,如果NAT只进行IP地址的简单替换,就会产生一个问题:当有多个内部主机去访问同一个服务器时,从返回的信息不足以区分响应应该转发到哪个内部主机。此时,需要NAT设备根据传输层信息或其他上层协议去区分不同的会话,并且可能要对上层协议的标识进行转换,比如TCP或UDP端口号。这样NAT网关就可以将不同的内部连接访问映射到同一公网IP的不同传输层端口,通过这种方式实现公网IP的复用和解复用。这种方式也被称为端口转换PAT、NAPT或IP伪装,但更多时候直接被称为NAT,因为它是最典型的一种应用模式。
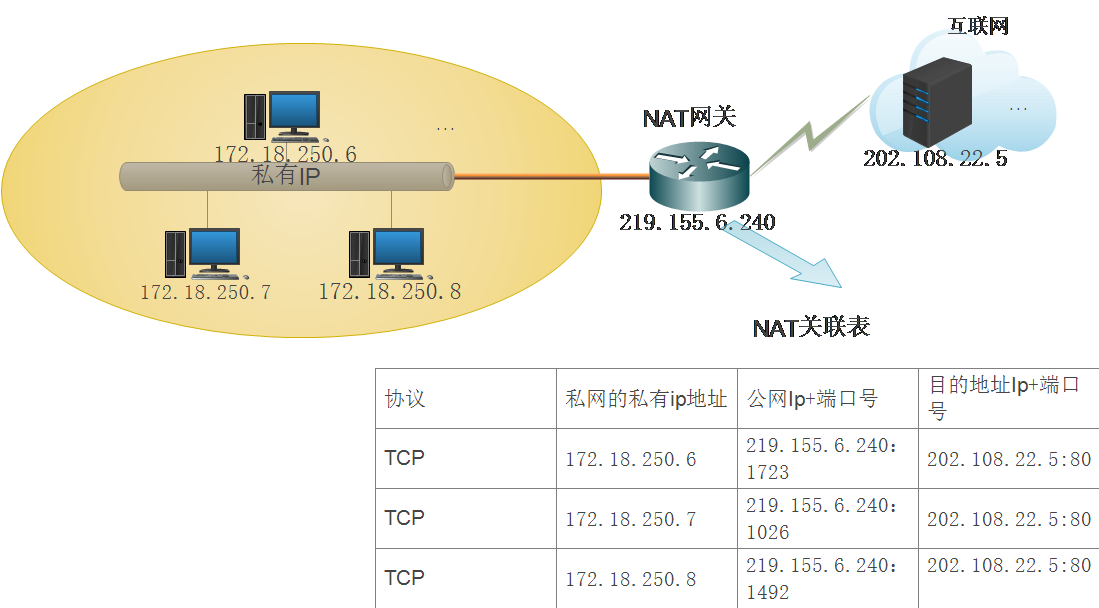
也就是说,我们利用端口号的唯一性实现了公网ip转换为私网ip的这一步。PAT(NAT重载)能够使用传输层端口号来标识主机,因此,从理论上说,最多可让大约65000台主机共用一个公有IP地址
实验
拓扑图如下:
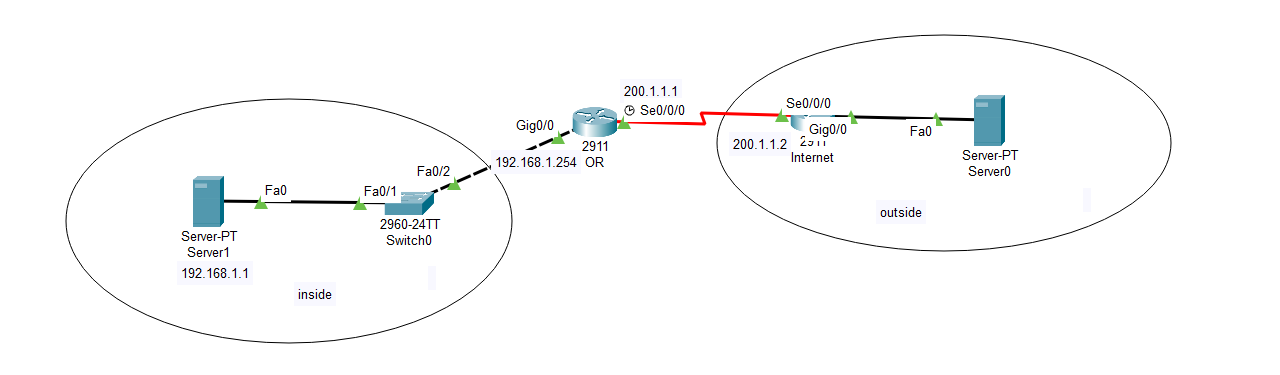
要求使用NAT分别配置静态NAT一对一映射、端口映射、动态NAT映射以及NAT重载
| 路由 | 接口 | IP | 网段 |
|---|---|---|---|
| OR | g0/0 s0/0/0 |
192.168.1.254/24 200.1.1.1/24 |
255.255.255.0 |
| Internet | g0/0 s0/0/0 |
8.8.8.⅛ 200.1.1.2/24 |
255.0.0.0 255.255.255.0 |
| 服务器 | IP | 网段 |
|---|---|---|
| server0 | 8.8.8.8 | 255.0.0.0 |
| server1 | 192.168.1.1 | 255.255.255.0 |
在出口路由OR路由上配置
- 配置一对一静态NAT映射
# 配置一对一静态NAT映射
# format: ip nat inside source static <内网IP> <外网IP>
config> ip nat inside source static 192.168.1.1 200.1.1.10
config> interface g0/0
# 指定g0/0为内网接口
config-if> ip nat inside
config-if> exit
config> interface s0/0/0
# 指定s0/0/0为外网接口
config> ip nat outside
config> end
效果为内网和外网server可以互通
- 配置静态端口映射
# 将内网的80端口映射到外网的8080端口
# format: ip nat inside source static <protocol> <内网IP> <内网Port> <外网IP> <外网Port>
config> ip nat inside source static tcp 192.168.1.1 80 200.1.1.10 8080
# 指定g0/0为内网接口
config-if> ip nat inside
config-if> exit
config> interface s0/0/0
# 指定s0/0/0为外网接口
config> ip nat outside
config> end
效果为外网可以通过访问200.1.1.10:8080访问到内网192.168.1.1:80
- 配置动态NAT地址池一对一
# 配置acl 允许内网网段IP
config> access-list 1 permit 192.168.1.0 0.0.0.255
# 配置地址池范围(200.1.1.10~200.1.1.20)
# format: ip nat pool natpool <start> <end> netmask <mask>
config> ip nat pool natpool 200.1.1.10 200.1.1.20 netmask 255.255.255.0
# 在地址池上应用acl
config> ip nat inside source list 1 pool natpool
# 指定g0/0为内网接口
config-if> ip nat inside
config-if> exit
config> interface s0/0/0
# 指定s0/0/0为外网接口
config> ip nat outside
config> end
- 配置NAT重载
# 配置acl 允许内网网段IP
access-list 1 permit 192.168.1.0 0.0.0.255
# 配置重载接口(外网接口),并应用acl规则
ip nat inside source list 1 interface s0/0/0 overload
# 指定g0/0为内网接口
config-if> ip nat inside
config-if> exit
config> interface s0/0/0
# 指定s0/0/0为外网接口
config> ip nat outside
config> end