装饰器
装饰器是什么?
装饰器,顾名思义,就是增强函数或类的功能的一个函数。
这么说可能有点绕。
举个例子:如何计算函数的执行时间?
如下,你需要计算 add 函数的执行时间。
你可能会这么写
import time


def add(a, b)
    start_time = time.time()
    res = a + b
    exec_time = time.time() - start_time
    print("add函数,花费的时间是:{}".format(exec_time))
    return res
这个时候,老板又让你计算减法函数(sub)的时间。不用装饰器的话,你又得重复写一段减法的代码。
def sub(a, b)
    start_time = time.time()
    res = a - b
    exec_time = time.time() - start_time
    print("sub函数,花费的时间是:{}".format(exec_time))
    return res
这样显得很麻烦,也不灵活,万一计算时间的代码有改动,你得每个函数都要改动。
所以,我们需要引入装饰器。
使用装饰器之后的代码是这样的
import time


# 定义装饰器
def time_calc(func):
    def wrapper(*args, **kargs):
        start_time = time.time()
        f = func(*args,**kargs)
        exec_time = time.time() - start_time
        return f
    return wrapper

# 使用装饰器
@time_calc
def add(a, b):
    return a + b

@time_calc
def sub(a, b):
    return a - b
是不是看起来清爽多了?
装饰器的作用:增强函数的功能,确切的说,可以装饰函数,也可以装饰类。
装饰器的原理:函数是python的一等公民,函数也是对象。
定义装饰器
def decorator(func):
    def wrapper(*args,**kargs):
        # 可以自定义传入的参数
        print(func.__name__)
        # 返回传入的方法名参数的调用
        return func(*args,**kargs)
    # 返回内层函数函数名
    return wrapper
使用装饰器
假设decorator是定义好的装饰器。
方法一:不用语法糖@符号
方法二:采用语法糖@符号
装饰器可以传参,也可以不用传参。
自身不传入参数的装饰器(采用两层函数定义装饰器)
def login(func):
    def wrapper(*args,**kargs):
        print('函数名:%s'% func.__name__)
        return func(*args,**kargs)
    return wrapper

@login
def f():
    print('inside decorator!')

f()

# 输出:
# >> 函数名:f
# >> 函数本身:inside decorator!
自身传入参数的装饰器(采用三层函数定义装饰器)
def login(text):
    def decorator(func):
        def wrapper(*args,**kargs):
            print('%s----%s'%(text, func.__name__))
            return func(*args,**kargs)
        return wrapper
    return decorator

# 等价于 ==> (login(text))(f) ==> 返回 wrapper
@login('this is a parameter of decorator')
def f():
    print('2019-06-13')

# 等价于 ==> (login(text))(f)() ==> 调用 wrapper() 并返回 f()
f()

# 输出:
# => this is a parameter of decorator----f
# => 2019-06-13
迭代器
一个对象要想使用 for 的方式迭代出容器内的所有数据,这就需要这个类实现「迭代器协议」。
也就是说,一个类如果实现了「迭代器协议」,就可以称之为「迭代器」。
什么是「迭代器协议」呢?
在 Python 中,实现迭代器协议就是实现以下 2 个方法:
__iter__:这个方法返回对象本身,即self__next__:这个方法每次返回迭代的值,在没有可迭代元素时,抛出StopIteration异常
下面我们来看一个实现迭代器协议的例子:
# coding: utf8

class A:
    """A 实现了迭代器协议 它的实例就是一个迭代器"""
    def __init__(self, n):
        self.idx = 0
        self.n = n

    def __iter__(self):
        print('__iter__')
        return self

    def __next__(self):
        if self.idx < self.n:
            val = self.idx
            self.idx += 1
            return val
        else:
            raise StopIteration()

# 迭代元素
a = A(3)
for i in a:
    print(i)
# 再次迭代 没有元素输出 因为迭代器只能迭代一次
for i in a:
    print(i)

# __iter__
# 0
# 1
# 2
# __iter__
在这个例子中,我们定义了一个类 A,它内部实现了 __iter__ 和 __next__ 方法。
其中 __iter__ 方法返回了 self,__next__ 方法实现了具体的迭代细节。
然后执行 a = A(3),在执行 for i in a 时,我们看到调用了 __iter__ 方法,然后依次输出 __next__ 中的元素。
其实在执行 for 循环时,实际执行流程是这样的:
for i in a相当于执行iter(a)- 每次迭代时会执行一次
__next__方法,返回一个值 - 如果没有可迭代的数据,抛出
StopIteration异常,for会停止迭代
但是请注意,当我们迭代完 for i in a 时,如果再次执行迭代,将不会有任何数据输出。
如果我们想每次执行都能迭代元素,只需每次迭代一个新对象即可:
生成器
生成器的创建与元素迭代遍历
创建生成器方法1
把一个列表生成式的 [ ] 改成 ( )
生成器(generator)其实是一类特殊的迭代器。前面博客我们每次迭代获取数据(通过next()方法)时按照特定的规律进行生成。但是我们在实现一个迭代器时,关于当前迭代到的状态需要我们自己记录,进而才能根据当前状态生成下一个数据。为了达到记录当前状态,并配合next()函数进行迭代使用,python就搞了个生成器。所以说**生成器(generator)其实是一类特殊的迭代器**。
python复制代码#1.创建生成器
ls = [x*2 for x in range(10)]
generator1 =(x*2 for x in range(10)) #这是一个生成器generator
print(ls)
print(generator1) #注意,打印生成器,不会像列表一样打印他的值,而是地址。
'''
[0, 2, 4, 6, 8, 10, 12, 14, 16, 18]
<generator object <genexpr> at 0x00000239FE00A620>
'''
遍历生成器内容
python复制代码遍历生成器对象中的内容:
1.方法1.使用for循环遍历
for i in generator1:
    print(i)

#方法2:命令行使用next()函数:调用next(G) ,就计算出 G 的下一个元素的值,直到计算到最后一个元素
没有更多的元素时,抛出 StopIteration 的异常。
>>> generator1 =(x*2 for x in range(5))
>>> next(generator1)
0
>>> next(generator1)
2
>>> next(generator1)
4
>>> next(generator1)
6
>>> next(generator1)
8
>>> next(generator1)
Traceback (most recent call last):
  File "<stdin>", line 1, in <module>
StopIteration
2.方法2.python脚本使用next()方法,实际开发中是通过for循环来实现遍历,这种next()方法太麻烦。
g1 =(x*2 for x in range(5))
while True:
    try:
        x = next(g1)
        print(x)
    except StopIteration as  e :
        print("values=%s"%e.value)
        break #注意这里要加break,否则会死循环。
'''结果如下:
0
2
4
6
8
values=None
'''
3.方法3:使用对象自带的__next__()方法,效果等同于next(g1)函数
>>> g1 =(x*2 for x in range(5))
>>> g1.__next__()
0
>>> g1.__next__()
2
>>> g1.__next__()
4
>>> g1.__next__()
6
>>> g1.__next__()
8
>>> g1.__next__()
Traceback (most recent call last):
  File "<stdin>", line 1, in <module>
StopIteration
>>>
创建生成器方法2
使用yield函数创建生成器
generator非常强大。如果推算的算法比较复杂,用类似列表生成式的 for 循环无法实现的时候,还可以用函数来实现。简单来说:只要在def中有yield关键字的 就称为 生成器
python复制代码#著名的斐波拉契数列(Fibonacci):除第一个和第二个数外,任意一个数都可由前两个数相加得到
#1.举例:1, 1, 2, 3, 5, 8, 13, 21, 34, ...使用函数实现打印数列的任意前n项。

def fib(times): #times表示打印斐波拉契数列的前times位。
    n = 0
    a,b = 0,1
    while n<times:
        print(b)
        a,b = b,a+b
        n+=1
    return 'done'

fib(10)  #前10位:1 1 2 3 5 8 13 21 34 55

#2.将print(b)换成yield b,则函数会变成generator生成器。
#yield b功能是:每次执行到有yield的时候,会返回yield后面b的值给函数并且函数会暂停,直到下次调用或迭代终止;
def fib(times): #times表示打印斐波拉契数列的前times位。
    n = 0
    a,b = 0,1
    while n<times:
        yield b
        a,b = b,a+b
        n+=1
    return 'done'

print(fib(10))  #<generator object fib at 0x000001659333A3B8>

3.对生成器进行迭代遍历元素
方法1:使用for循环
for x in fib(6):
    print(x)
''''结果如下,发现如何生成器是函数的话,使用for遍历,无法获取函数的返回值。
1
1
2
3
5
8
'''
方法2:使用next()函数来遍历迭代,可以获取生成器函数的返回值。同理也可以使用自带的__next__()函数,效果一样
f = fib(6)
while True:
    try:  #因为不停调用next会报异常,所以要捕捉处理异常。
        x = next(f)  #注意这里不能直接写next(fib(6)),否则每次都是重复调用1
        print(x)
    except StopIteration as e:
        print("生成器返回值:%s"%e.value)
        break
'''结果如下:
1
1
2
3
5
8
生成器返回值:done
'''
生成器使用总结
- 生成器的好处是可以一边循环一边进行计算,不用一下子就生成一个很大的集合,占用内存空间。生成器的使用节省内存空间
- 生成器保存的是算法,而列表保存的计算后的内容,所以同样内容的话生成器占用内存小,而列表占用内存大。每次调用 next(G) ,就计算出 G 的下一个元素的值,直到计算到最后一个元素,没有更多的元素时,抛出 StopIteration 的异常
- 使用for 循环来遍历生成器内容,因为生成器也是可迭代对象。通过 for 循环来迭代它,不需要关心 StopIteration 异常。但是用for循环调用generator时,得不到generator的return语句的返回值。如果想要拿到返回值,必须用next()方法,且捕获StopIteration错误,返回值包含在StopIteration的value中
- 在 Python 中,使用了 yield 的函数都可被称为生成器(generator)。生成器是一个返回迭代器的函数,只能用于迭代操作。更简单点理解生成器就是一个迭代器
- 一个带有 yield 的函数就是一个 generator,它和普通函数不同,生成一个 generator 看起来像函数调用,但不会执行任何函数代码,直到对其调用 next()(在 for 循环中会自动调用 next())才开始执行。虽然执行流程仍按函数的流程执行,但每执行到一个 yield 语句就会中断,保存当前所有的运行信息,并返回一个迭代值,下次执行next() 方法时从 yield 的下一个语句继续执行。看起来就好像一个函数在正常执行的过程中被 yield 中断了数次,每次中断都会通过 yield 返回当前的迭代值。生成器不仅“记住”了它数据状态;生成器还“记住”了它在流控制构造中的位置
切片
切片
切片是python极其有用且强大的功能。它使我们能够使用简单明了的语法来操作序列,包括字符串、列表、元组。切片简单来说就是从序列中切取咱们需要的值,并生成一个新的序列,理论上来说,只要表达式正确,我们可以通过切片切取序列中的任意值。
切片的用法
如果没有缺省的话,表达式应该包含三个参数以及两个冒号,三个参数的意义分别如下:
1、start_index:切片的起始位置(包括该位置),0表示从第一个开始,1表示从第二个开始,以此类推。-1表示从倒数第一个开始,-2表示从倒数第二个开始,以此类推。缺省时取0或-1(即step为正数取0,负数取-1)
a=[9,2,8,7,4,5,1,5,6,8]
a[0::]表示从第一个到最后一个,结果为   #[9,2,8,7,4,5,1,5,6,8]
a[1::]表示从第二个到最后一个          #[2,8,7,4,5,1,5,6,8]
a[-1::]表示从最后一个到最后一个,一共取一个值  #[8]
2、end_index:切片的结束位置(!!!且不包括该位置),0表示第一个为终点,1表示第二个为终点,以此类推。-1表示倒数第一个为终点,-2表示倒数第二个为终点,以此类推。缺省时默认为序列长度(step为正数取正,step负数取负)
a=[9,2,8,7,4,5,1,5,6,8]
a[:0:]表示从第一个到第一个,一共取0个值      #[]
a[:1:]表示从第一个到第二个且不包括第二个     #[9]
a[:-1:]表示从第一个到最后一个且不包括最后一个,一共取9个值      #[9,2,8,7,4,5,1,5,6]
a[:8]表示从第一个到第九个且不包括第九个      #[9, 2, 8, 7, 4, 5, 1, 5]
3、step,表示步长。可取正负数,正数表示从左往右,负数表示从右往左。缺省时取1
a=[9,2,8,7,4,5,1,5,6,8]
a[::1]表示从第一个到最后一个,步长为1      #[9,2,8,7,4,5,1,5,6,8]
a[::-1]表示从最后一个到第一个,步长为1       #[9,6,5,1,5,4,7,8,2,9]
a[::2]表示从第一个到最后一个,步长为2         #[9,8,4,1,6]
组合使用
只有一个冒号时默认step为1。当start_index的位置在end_index的左边时,表示从左往右取值;当start_index的位置在end_index的右边时,表示从右往左取值
a=[9,2,8,7,4,5,1,5,6,8]
a[:]         #[9,2,8,7,4,5,1,5,6,8]
a[1:]       #[2,8,7,4,5,1,5,6,8]
a[1:-1]      #[9,2,8,7,4,5,1,5,6]
a[-1:2:-1]      #[8, 6, 5, 1, 5, 4, 7]
a[1:8:2]     #[2,7,5,5]
a[-1:4:-1]   #[8,6,5,1,5]123456
特殊情况
a=[9,2,8,7,4,5,1,5,6,8]
a[1:6:-1]    #step=-1表示从右往左取值,但是1:6表示从第二个到第七个从左往右,二者矛盾输出空列表
a[6:1]       #step缺省时为1,但是6:1表示从第七个到第二个从右往左,二者矛盾,输出为空
a[-1:-6]     #step缺省为1表示从左往右取值,但是-1:-6表示从倒数第一到倒数第六从右往左,矛盾输出为空
a[1:-6:-1]   #step=-1表示从右往左,1:-6表示从左往右,矛盾 输出为空
a[-1:6]      #step缺省为1从左到右,-1:6从右到左,两者矛盾,输出为空
连续切片操作
按照顺序进行切片即可
a=[9,2,8,7,4,5,1,5,6,8]
a[:8][2:5][::-1]
#a[:8]输出为[9,2,8,7,4,5,1,5]
#a[:8][2:5]输出为[8,7,4]
#a[:8][2:5][-1]输出为[4,7,8]
其他序列的切片
#字符串的切片
str="ABCDEFG"
str[1:3]        #结果为'BC'
#元组的切片
a=('a','b','c','d','e')
a[::-1]         #结果为('e', 'd', 'c', 'b', 'a')
python常用切片操作
a=[9,2,8,7,4,5,1,5,6,8]
#修改单个元素
a[3]='hello china'  #序列变为[9, 2, 8, 'hello china', 4, 5, 1, 5, 6, 8]
#插入某个元素
a[3:3]='A'  #序列变为[9, 2, 8, 'A', 7, 4, 5, 1, 5, 6, 8]
#替换一部分元素
a[3:5] = ['hello','world']  #序列变为[9, 2, 8, 'hello', 'world', 5, 1, 5, 6, 8]
总结
- start:表示切片的开始索引位置(包括该位置),此参数也可以不指定,会默认为 0,也就是从序列的开头进行切片;
- end:表示切片的结束索引位置(不包括该位置),如果不指定,则默认为序列的长度;
- step:表示在切片过程中,隔几个存储位置(包含当前位置)取一次元素,也就是说,如果 step 的值大于1则在进行切片去序列元素时,会“跳跃式”的取元素。如果省略设置 step 的值,则最后一个冒号就可以省略。
解析式
解析式是将一个可迭代对象转换另一个可迭代对象的工具。在Python,容器类型的数据(str,tuple,list,dict,set)都是可迭代对象。
- 第一个可迭代对象:可以是任何容器类型数据
- 第二个可迭代对象:生成的最终类型解析式,常见的列表解析如下所示:
-
- 列表解析式:可迭代对象为list
-
- 集体解析式:可迭代对象为set
-
- 字典解析式:可迭代对象为dict
先来看看其语法格式如下所示:
# 列表解析式
[item for item in 可迭代对象 if 条件 ]
# 集合解析式
(item for item in 可迭代对象 if 条件 )
# 字典解析式
{item for item in 可迭代对象 if 条件 }
从语法格式看起来,就是for循环和if的结合体,但却非常简洁。至于最终生成的数据类型,可以根据其定义的格式就可以猜出。
列表解析式
先来看看一个需求,将0~10以内的偶数挑选出来,并输出其列表结果。实现方法如下所示:
1.方法1:
- 通过判断是否能与2整除获取
2.方法2
- 通过控制步长实现
3.方法3
- 通过列表解析式
以上示例的详细示意图如下所示(以不同颜色进行区分):

在前面学过,for循环是可以进行嵌套的,那多个for循环的是不是也可以使用列表解析式?答案当然是肯定的,下面将演示在给定的路径下递归列出是文件的文件,并以列表的形式返回完整的路径,如下所示:
import os
def getfiles(path):
    fileList=[os.path.join(r,f) for r,_,fs in os.walk(path) for f in fs if os.path.isfile(os.path.join(r,f))]
    return fileList
其他解析式
另外两种解析(集合、字典)与列表解析都一样,只需要注意在定义时的区别即可。
1.字典解析式
# 传统方式
tempDict={}
for k,v in (("a","b"),("c","d"),("e","f"),("g","h")):
    if k not in ("g"):
        tempDict[k]=v
# 字典解析式
tempDict={k:v for k,v in (("a","b"),("c","d"),("e","f")) if k not in ("g") }
print(tempDict)
2.集合解析式
# 传统方式
tempSet=set()
for item in (1,1,2,3,4,5,6,7,4,6):
    if item >=2:
        tempSet.add(item)
# 集合解析式
tempSet={item for item in (1,1,2,3,4,5,6,7,4,6) if item >=2 }
3.元组解析式
严格来讲,官方并没有元组解析式这种说法,如果像列表、字典和集合一样,最终生成的是一个生成器对象,如果要想生成的结果为元组的形式,需要使用函数tuple(),如下所示:
与lambda的结合使用
lambda可以做为匿名函数使用,当然也可以与解析结合使用,示例如下所示:
# 将元组拆分为列表
tmpList=(1,2,3,(4,5,6),(7,8),9,((10,20,30),(40,50)))
f=lambda x:[ v for item in x for v in f(item)] if isinstance(x,(tuple,)) else [x]

print(f(tmpList))
输出结果为:
解包操作
python中的解包可以这样理解:一个list是一个整体,想把list中每个元素当成一个个个体剥离出来,这个过程就是解包,我们来看下面这些例子(分为12个部分)。
将list中每个元素赋值给一个变量
可迭代对象都可以这样做
# 列表
>>> a,b,c = ['a', 'b', 'c']
>>> a
'a'

>>> a,b,c = enumerate(['a', 'b', 'c'])
>>> a
(0, 'a')


# 元组
>>> a,b,c = ('a', 'b', 'c')
>>> a
'a'

# 字典
>>> a,b,c = {'a':1, 'b':2, 'c':3}
>>> a
'a'

>>> a,b,c = {'a':1, 'b':2, 'c':3}.items()
>>> a
('a', 1)


# 字符串
>>> a,b,c = 'abc'
>>> a
'a'

# 生成器
>>> a,b,c = (x + 1 for x in range(3))
>>> a
1
如果可迭代对象包含的元素和前面待赋值变量数量不一致,则会报错。但是可以通过*来表示多个元素
星号的使用
比如我们要计算平均分,去除最高分和最低分,除了用切片,还可以用解包的方式获得中间的数值
>>> first, *new, last = [94, 85, 73, 46]
>>> new
[85, 73]
或者用来格式化参数
tuple=set([1,2,3,4])
ptint("the first is {0},second is {1},third is {2},forth is {3}".format(*tuple))
用*来表示多个数值
压包过程
压包是解包的逆过程,用zip函数实现,下面例子可以对压包有一个直观的感受
>>> a = ['a', 'b', 'c']
>>> b = [1, 2, 3]
>>> for i in zip(a, b):
...     print(i)
...
('a', 1)
('b', 2)
('c', 3)
压包与解包混合的例子
下面例子实现:两个列表对应数值相加
细细拆解上面过程,可以看出步骤是这样的
- 先是
zip函数将a b压包成为一个可迭代对象 - 对可迭代对象的每一个元素(
('a', 1))进行解包(i, j = ('a', 1)) - 此时就可以分别调用
i j变量进行计算
下面我们加入星号
>>> l = [('Bob', '1990-1-1', 60),
...     ('Mary', '1996-1-4', 50),
...     ('Nancy', '1993-3-1', 55),]
>>> for name, *args in l:
...     print(name, args)
...
Bob ['1990-1-1', 60]
Mary ['1996-1-4', 50]
Nancy ['1993-3-1', 55]
解包与压包结合可以实现类似矩阵转置的操作
_的用法
当一些元素不用时,用_表示是更好的写法,可以让读代码的人知道这个元素是不要的
>>> person = ('Bob', 20, 50, (11, 20, 2000))
>>> name, *_, (*_, year) = person
>>> name
'Bob'
>>> year
2000
多变量同时赋值
之前赋值符号右侧都是可迭代对象,其实右侧也可以是多个变量
下面用法都会报错
可以这样
*之可变参数
函数定义时,我们使用*的可变参数,其实也是压包解包过程
参数用*num表示,num变量就可以当成元组调用了。
其实这个过程相当于*num, = 1,2,5,6
*9.之关键字参数
>>> def myfun(**kw):
...     print(kw)
...
>>> myfun(name = "Bob", age = 20, weight = 50)
{'weight': 50, 'name': 'Bob', 'age': 20}
键值对传入**kw,kw就可以表示相应字典。
**的用法只在函数定义中使用,不能这样使用
可变参数与关键字参数的细节问题
(1)函数传入实参时,可变参数(*)之前的参数不能指定参数名
>>> def myfun(a, *b):
...     print(a)
...     print(b)
...
>>> myfun(a=1, 2,3,4)
  File "<stdin>", line 1
SyntaxError: positional argument follows keyword argument

>>> myfun(1, 2,3,4)
1
(2, 3, 4)
(2)函数传入实参时,可变参数(*)之后的参数必须指定参数名,否则就会被归到可变参数之中
>>> def myfun(a, *b, c=None):
...     print(a)
...     print(b)
...     print(c)
...
>>> myfun(1, 2,3,4)
1
(2, 3, 4)
None
>>> myfun(1, 2,3,c=4)
1
(2, 3)
4
如果一个函数想要使用时必须明确指定参数名,可以将所有参数都放在可变参数之后,而可变参数不用管它就可以,也不用命名,如下
可变参数的这两条特性,可以用于将 只需要按照位置赋值的参数 和 需要明确指定参数名的参数区分开来
(3)关键字参数都只能作为最后一个参数,前面的参数按照位置赋值还是名称赋值都可以
下面展示一个既用可变参数有用关键字参数的例子
>>> def myfun(a, *b, c, **d):
...     print(a)
...     print(b)
...     print(c)
...     print(d)
...
>>> myfun(1, 2, 3, c= 4, m = 5, n = 6)
1
(2, 3)
4
{'n': 6, 'm': 5}
(4)可变参数与关键词参数共同使用以表示任意参数
下面是这一点在装饰器当中的使用
>>> def mydecorator(func):
...     def wrapper(*args, **kw):
...         print('I am using a decorator.')
...         return func(*args, **kw)
...     return wrapper
...
>>> @mydecorator
... def myfun(a, b):
...     print(a)
...     print(b)
...
>>> myfun(1, b = 2)
I am using a decorator.
1
2
(如果有的读者不熟悉装饰器,只需要知道,使用@定义myfun相当于myfun = mydecorator(myfun),定义出来的myfun其实是返回结果wrapper函数)
wrapper函数使用*args, **kw作为参数,则被修饰的myfun函数需要的参数无论是什么样的,传入wrapper都不会报错,这保证了装饰器可以修饰各种各样函数的灵活性。毕竟我们一般在函数中传入参数时,要么所有参数名都写,要么前面几个不写,后面的会写,这样使用*args, **kw完全没有问题。
解包作为参数传入函数中
首先定义一个函数
列表元组的解包
字典的解包
一个应用
>>> bob = {'name': 'Bob', 'age': 30}
>>> "{name}'s age is {age}".format(**bob)
"Bob's age is 30"
多返回值函数
下面过程也涉及到了解包
其实本身是一个元组
线程操作
多线程与多进程的区别
多线程 threading: 一个人有与异性聊天和看剧两件事要做。单线程的她可以看完剧再去聊天,但这样子可能就没人陪她聊天了「哼,发消息不回」。我们把她看成一个CPU核心,为她开起多线程——先看一会剧,偶尔看看新消息,在两件事(线程)间来回切换。多线程:单个CPU核心可以同时做几件事,不至于卡在某一步傻等着。
用处:爬取网站信息(爬虫),等待多个用户输入
多进程 processing: 一个人有很多砖需要搬,他领取手套、推车各种物资(向系统申请了资源)然后开始搬砖。然而他身边有很多人,我们让这些人去帮他!(一核有难,八核围观)。于是他们做了分工,砖很快就搬完了。多进程让多个CPU核心可以一起做事,不至于只有一人干活而其他人傻站着。
用处:进行高性能计算。只有多进程方案设计合理,才能加速计算。
一核有难,七核围观
全局锁与多进程
为何在Python里用多进程这么麻烦? 因为Python的线程是操作系统线程,因此要有Python全局解释器锁。一个python解释器进程内有一条**主线程**,以及多条用户程序的**执行线程**。即使在多核CPU平台上,由于GIL的存在,所以禁止多线程的并行执行。——来自百度百科词条 全局解释器锁。发展历程:
- Python全局锁。Python 3.2的时候更新过GIL。在我小时候,由于Python GIL的存在(全局解释器锁 Global Interpreter Lock) ,此时Python无法靠自己实现多进程
- 外部多进程通信。Python3.5。在2015年,要么用Python调用C语言(如Numpy此类用其他语言在底层实现多进程的第三方库),要么需要在外部代码(MPI 2015)
- 内置多进程通信。Python 3.6 才让 multiprocessing逐渐发展成一个能用的Python内置多进程库,可以进行进程间的通信,以及有限的内存共享
- 共享内存。Python 3.8 在2019年增加了新特性 shared_memory
子进程 Process
多进程的主进程一定要写在程序入口 if name =='main': 内部
def function1(id):  # 这里是子进程
    print(f'id {id}')

def run__process():  # 这里是主进程
    from multiprocessing import Process
    process = [mp.Process(target=function1, args=(1,)),
               mp.Process(target=function1, args=(2,)), ]
    [p.start() for p in process]  # 开启了两个进程
    [p.join() for p in process]   # 等待两个进程依次结束

# run__process()  # 主线程不建议写在 if外部。由于这里的例子很简单,你强行这么做可能不会报错
if __name__ =='__main__':
    run__process()  # 正确做法:主线程只能写在 if内部
尽管在这个简单的例子里,把主进程run__process()写在程序入口if外部不会有报错。但是你最好还是按我要求去做。详细解释的内容过长,我写在→「Python程序入口有重要功能(多线程)而非编程习惯」
上面的例子只是用Process开启了多进程,不涉及进程通信。当我准备把一个串行任务编排成多进程时,我还需要多进程通信。进程池Pool可以让主程序获得子进程的计算结果(不太灵活,适合简单任务),管道Pipe 队列Queue 等等 可以让进程之间进行通信(足够灵活)。共享值 Value 共享数组 Array 共享内容 shared_memory(Python 3.6 Python3.9 的新特性,还不太成熟)下面开讲。
Python多进程可以选择两种创建进程的方式,spawn 与 fork。**分支创建:fork**会直接复制一份自己给子进程运行,并把自己所有资源的handle 都让子进程继承,因而创建速度很快,但更占用内存资源。**分产创建:spawn**只会把必要的资源的handle 交给子进程,因此创建速度稍慢。详细解释请看 Stack OverFlow multiprocessing fork vs spawn 。(分产spawn 是我自己随便翻译的,有更好的翻译请推荐。我绝不把handle 翻译成句柄)
multiprocessing.set_start_method('spawn')  # default on WinOS or MacOS
multiprocessing.set_start_method('fork')   # default on Linux (UnixOS)
请注意:我说 分支fork 在初始化**创建多进程**的时候比 分产spawn 快,而不是说高性能计算会比较快。通常高性能计算需要让程序运行很久,因此为了节省内存以及进程安全,我建议选择 spawn。
进程池 Pool
几乎Python多进程代码都需要你明明白白地调用Process。而进程池Pool 会自动帮我们管理子进程。Python的Pool 不方便传入多个参数,我这里提供两个解决思路:
思路1:函数 func2 需要传入多个参数,现在把它改成一个参数,无论你直接让args作为一个元组tuple、词典dict、类class都可以
思路2:使用 function.partial Passing multiple parameters to pool.map() function in Python。这个不灵活的方法固定了其他参数,且需要导入Python的内置库,我不推荐
import time

def func2(args):  # multiple parameters (arguments)
    # x, y = args
    x = args[0]  # write in this way, easier to locate errors
    y = args[1]  # write in this way, easier to locate errors

    time.sleep(1)  # pretend it is a time-consuming operation
    return x - y


def run__pool():  # main process
    from multiprocessing import Pool

    cpu_worker_num = 3
    process_args = [(1, 1), (9, 9), (4, 4), (3, 3), ]

    print(f'| inputs:  {process_args}')
    start_time = time.time()
    with Pool(cpu_worker_num) as p:
        outputs = p.map(func2, process_args)
    print(f'| outputs: {outputs}    TimeUsed: {time.time() - start_time:.1f}    \n')

    '''Another way (I don't recommend)
    Using 'functions.partial'. See https://stackoverflow.com/a/25553970/9293137
    from functools import partial
    # from functools import partial
    # pool.map(partial(f, a, b), iterable)
    '''

if __name__ =='__main__':
    run__pool()
from multiprocessing import Pool
import os,time,random

#任务在子进程中运行
def task(name):
    #打印进程 id
    print('process {} 启动运行,id: {}',format(name,os.getpid()))
    start_time=time.time()
    #假设有个比较费时的操作
    #生成一个随机数
    time.sleep(random.random() * 3)
    end_time=time.time()
    print('任务{}结束运行,耗时: {:.2f}秒'.format(name,(end_time-start_time)))

if __name__=='__main__':
    print('当前是主进程,id {}'.format(os.getpid()))
    print("============================================")
    p=Pool(4)
    for i in range(1,6):
        #异步方式启动进程池
        p.apply_async(task,args=(i,))

    p.close()
    print('开始运行子进程')
    p.join()
    print("==============================================")
    print("子进程运行完毕,当前是主进程,id :{}".format(os.getpid()))
管道 Pipe
顾名思义,管道Pipe 有两端,因而 main_conn, child_conn = Pipe() ,管道的两端可以放在主进程或子进程内,我在实验中没发现主管道口main_conn 和子管道口child_conn 的区别。两端可以同时放进去东西,放进去的对象都经过了深拷贝:用 conn.send()在一端放入,用 conn.recv() 另一端取出,管道的两端可以同时给多个进程。conn是 connect的缩写。
import time

def func_pipe1(conn, p_id):
    print(p_id)

    time.sleep(0.1)
    conn.send(f'{p_id}_send1')
    print(p_id, 'send1')

    time.sleep(0.1)
    conn.send(f'{p_id}_send2')
    print(p_id, 'send2')

    time.sleep(0.1)
    rec = conn.recv()
    print(p_id, 'recv', rec)

    time.sleep(0.1)
    rec = conn.recv()
    print(p_id, 'recv', rec)


def func_pipe2(conn, p_id):
    print(p_id)

    time.sleep(0.1)
    conn.send(p_id)
    print(p_id, 'send')
    time.sleep(0.1)
    rec = conn.recv()
    print(p_id, 'recv', rec)


def run__pipe():
    from multiprocessing import Process, Pipe

    conn1, conn2 = Pipe()

    process = [Process(target=func_pipe1, args=(conn1, 'I1')),
               Process(target=func_pipe2, args=(conn2, 'I2')),
               Process(target=func_pipe2, args=(conn2, 'I3')), ]

    [p.start() for p in process]
    print('| Main', 'send')
    conn1.send(None)
    print('| Main', conn2.recv())
    [p.join() for p in process]

if __name__ =='__main__':
    run__pipe()
如果追求运行更快,那么最好使用管道Pipe而非下面介绍的队列Queue
Pipe还有 duplex参数 和 poll() 方法 需要了解。默认情况下 duplex==True,若不开启双向管道,那么传数据的方向只能 conn1 ← conn2 。conn2.poll()==True 意味着可以马上使用 conn2.recv() 拿到传过来的数据。conn2.poll(n) 会让它等待n秒钟再进行查询。
from multiprocessing import Pipe

conn1, conn2 = Pipe(duplex=True)  # 开启双向管道,管道两端都能存取数据。默认开启
#
conn1.send('A')
print(conn1.poll())  # 会print出 False,因为没有东西等待conn1去接收
print(conn2.poll())  # 会print出 True ,因为conn1 send 了个 'A' 等着conn2 去接收
print(conn2.recv(), conn2.poll(2))  # 会等待2秒钟再开始查询,然后print出 'A False'
尽管我下面的例子不会报错,但这是因为它过于简单,没有真的开多线程去跑,也没有写在程序入口的if内部。很多时候 Pipe运行会快一点,但是它的功能太少了,得用 Queue。最明显的一个区别是:
conn1, conn2 = multiprocessing.Pipe()  # 管道有两端,某一端放入的东西,只能在另一端拿到
queue = multiprocessing.Queue()        # 队列只有一个,放进去的东西可以在任何地方拿到。
队列 Queue
可以 import queue 调用Python内置的队列,在多线程里也有队列 from multiprocessing import Queue。下面提及的都是多线程的队列。
队列Queue 的功能与前面的管道Pipe非常相似:无论主进程或子进程,都能访问到队列,放进去的对象都经过了深拷贝。不同的是:管道Pipe只有两个断开,而队列Queue 有基本的队列属性,更加灵活,详细请移步Stack Overflow Multiprocessing - Pipe vs Queue。
def func1(i):
    time.sleep(1)
    print(f'args {i}')

def run__queue():
    from multiprocessing import Process, Queue

    queue = Queue(maxsize=4)  # the following attribute can call in anywhere
    queue.put(True)
    queue.put([0, None, object])  # you can put deepcopy thing
    queue.qsize()  # the length of queue
    print(queue.get())  # First In First Out
    print(queue.get())  # First In First Out
    queue.qsize()  # the length of queue

    process = [Process(target=func1, args=(queue,)),
               Process(target=func1, args=(queue,)), ]
    [p.start() for p in process]
    [p.join() for p in process]

if __name__ =='__main__':
    run__queue()
from multiprocessing import  Process,Queue

queue=Queue()

def send(q):
    senddata='hello world'
    q.put(senddata)
    print("the send data is {0}".format(senddata))

def recv(q):
    recvdata=q.get()
    print("the recv data is {0}".format(recvdata))

def main():
    p1=Process(target=send,args=(queue,))
    p1.start()
    p2=Process(target=recv,args=(queue,))
    p2.start()

if __name__=='__main__':
    main()
多线程
threading 模块
Python 常用的多线程模块有threading 和 Queue,在这里我们将 threading 模块。
threading 模块的Thread 类是主要的执行对象。使用Thread 类,可以有很多方法来创建线程。最常用的有下面三种:
创建Thread 的实例,传给它一个可调用对象(函数或者类的实例方法)。 派生Thread 的子类,并创建子类的实例。
可调用对象使用多线程
步骤如下:
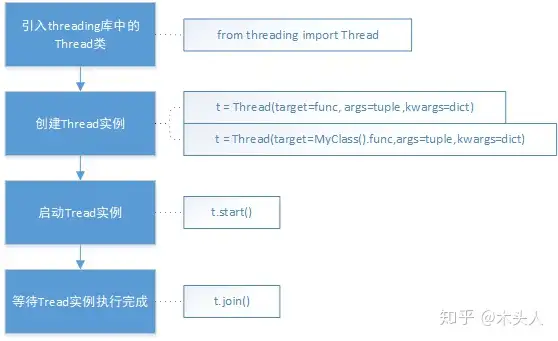
示例:创建Thread实例,传递给他一个函数
from threading import Thread
from time import sleep, ctime

def func(name, sec):
    print('---开始---', name, '时间', ctime())
    sleep(sec)
    print('***结束***', name, '时间', ctime())

# 创建 Thread 实例
t1 = Thread(target=func, args=('第一个线程', 1))
t2 = Thread(target=func, args=('第二个线程', 2))

# 启动线程运行
t1.start()
t2.start()

# 等待所有线程执行完毕
t1.join()  # join() 等待线程终止,要不然一直挂起
t2.join()
示例:创建Thread实例,传递给他一个类的实例方法
from threading import Thread
from time import sleep, ctime


class MyClass(object):

    def func(self,name,sec):
        print('---开始---', name, '时间', ctime())
        sleep(sec)
        print('***结束***', name, '时间', ctime())

def main():
    # 创建 Thread 实例
    t1 = Thread(target=MyClass().func, args=(1, 1))
    t2 = Thread(target=MyClass().func, args=(2, 2))

    # 启动线程运行
    t1.start()
    t2.start()

    # 等待所有线程执行完毕
    t1.join()  # join() 等待线程终止,要不然一直挂起
    t2.join()

if __name__=="__main__":
    main()
运行结果:
---开始--- 一 时间 Fri Nov 29 11:34:31 2019 ---开始--- 二 时间 Fri Nov 29 11:34:31 2019 结束 一 时间 Fri Nov 29 11:34:32 2019 结束 二 时间 Fri Nov 29 11:34:33 2019
程序总共运行两秒,如果程序按照线性运行需要3秒,节约1秒钟。
Thread 实例化时需要接收 target,args(kwargs)两个参数。
target 用于接收需要使用多线程调用的对象。
args 或 kwargs 用于接收调用对象的需要用到的参数,args接收tuple,kwargs接收dict。对args与kwargs你理解的看 木头人:Python入门 函数 提高篇 中的**Python函数的可变参数(*args, *kwargs)* 部分。
start() 是方法用来启动线程的执行。
join() 方法是一种自旋锁,它用来等待线程终止。也可以提供超时的时间,当线程运行达到超时时间后结束线程,如join(500),500毫秒后结束线程运行。
注意:如果当你的主线程还有其他事情要做,而不是等待这些线程完成,就可以不调用join()。join()方法只有在你需要等待线程完成然后在做其他事情的时候才是有用的。
派生Thread 的子类,并创建子类的实例。
我们可以通过继承Thread类,派生出一个子类,使用子类来创建多线程。
示例:派生Thread 的子类,传递给他一个可调用对象
from threading import Thread
from time import sleep, ctime


# 创建 Thread 的子类
class MyThread(Thread):
    def __init__(self, func, args):
        '''
        :param func: 可调用的对象
        :param args: 可调用对象的参数
        '''
        Thread.__init__(self)   # 不要忘记调用Thread的初始化方法
        self.func = func
        self.args = args

    def run(self):
        self.func(*self.args)


def func(name, sec):
    print('---开始---', name, '时间', ctime())
    sleep(sec)
    print('***结束***', name, '时间', ctime())

def main():
    # 创建 Thread 实例
    t1 = MyThread(func, (1, 1))
    t2 = MyThread(func, (2, 2))
    # 启动线程运行
    t1.start()
    t2.start()
    # 等待所有线程执行完毕
    t1.join()
    t2.join()

if __name__ == '__main__':
    main()
注意:不要忘记在子类中初始化父类的方法Thread.init(self) 。需要重构 run() 方法来执行多线程的程序。
获取可调用对象的返回值
在多线程中运行的程序时与主线程分开,我们没法直接获取线程中程序的返回值。这时就可以使用派生Thread 的子类,将给过保存的实例属性中,通过一个新方法获取运行结果。
示例: 获取多线程中程序运行的结果
from threading import Thread
from time import sleep, ctime

# 创建 Thread 的子类
class MyThread(Thread):
    def __init__(self, func, args):
        '''
        :param func: 可调用的对象
        :param args: 可调用对象的参数
        '''
        Thread.__init__(self)
        self.func = func
        self.args = args
        self.result = None

    def run(self):
        self.result = self.func(*self.args)

    def getResult(self):
        return self.result


def func(name, sec):
    print('---开始---', name, '时间', ctime())
    sleep(sec)
    print('***结束***', name, '时间', ctime())
    return sec


def main():
    # 创建 Thread 实例
    t1 = MyThread(func, (1, 1))
    t2 = MyThread(func, (2, 2))
    # 启动线程运行
    t1.start()
    t2.start()
    # 等待所有线程执行完毕
    t1.join()
    t2.join()
    # 或线程中程序的运行结果
    print(t1.getResult())
    print(t2.getResult())


if __name__ == '__main__':
    main()
线程同步
常用模块
os模块
简介
os就是“operating system”的缩写,顾名思义,os模块提供的就是各种 Python 程序与操作系统进行交互的接口。通过使用os模块,一方面可以方便地与操作系统进行交互,另一方面页可以极大增强代码的可移植性。如果该模块中相关功能出错,会抛出OSError异常或其子类异常。
注意,如果是读写文件的话,建议使用内置函数
open();如果是路径相关的操作,建议使用os的子模块os.path;如果要逐行读取多个文件,建议使用fileinput模块;要创建临时文件或路径,建议使用tempfile模块;要进行更高级的文件和路径操作则应当使用shutil模块。
当然,使用os模块可以写出操作系统无关的代码并不意味着os无法调用一些特定系统的扩展功能,但要切记一点:一旦这样做就会极大**损害代码的可移植性**。
此外,导入os模块时还要小心一点,千万**不要**为了图调用省事儿而将os模块解包导入,即不要使用from os import *来导入os模块;否则os.open()将会覆盖内置函数open(),从而造成预料之外的错误。
常用功能
注意,
os模块中大多数接受路径作为参数的函数也可以接受“文件描述符”作为参数。 文件描述符:file descriptor,在 Python 文档中简记为 fd,是一个与某个打开的文件对象绑定的整数,可以理解为该文件在系统中的编号。
os.name
该属性宽泛地指明了当前 Python 运行所在的环境,实际上是导入的操作系统相关模块的名称。这个名称也决定了模块中**哪些功能是可用**的,哪些是没有相应实现的。
目前有效名称为以下三个:posix,nt,java。
其中posix是 Portable Operating System Interface of UNIX(可移植操作系统接口)的缩写。Linux 和 Mac OS 均会返回该值;nt全称应为“Microsoft Windows NT”,大体可以等同于 Windows 操作系统,因此 Windows 环境下会返回该值;java则是 Java 虚拟机环境下的返回值。
因此在我的电脑(win10)上执行下述代码,返回值是nt:
而在 WSL(Windows Subsystem Linux,Windows 下的 Linux 子系统)上的结果则是:
查看
sys模块中的sys.platform属性可以得到关于运行平台更详细的信息,在此不再赘述
os.environ
os.environ属性可以返回环境相关的信息,主要是各类环境变量。返回值是一个映射(类似字典类型),具体的值为第一次导入os模块时的快照;其中的各个键值对,键是环境变量名,值则是环境变量对应的值。在第一次导入os模块之后,除非直接修改os.environ的值,否则该属性的值不再发生变化。
比如其中键为“HOMEPATH”(Windows 下,Linux 下为“HOME”)的项,对应的值就是用户主目录的路径。Windows 下,其值为:
Linux 下,其值为:
os.walk()
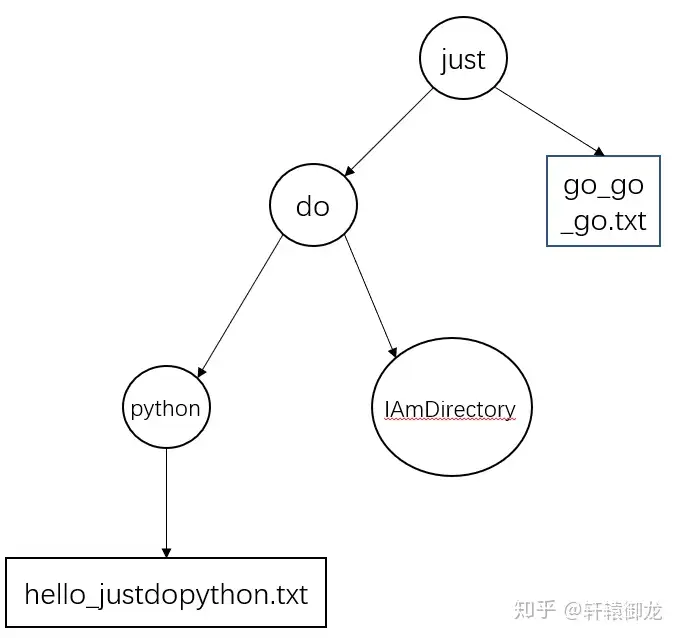
这个函数需要传入一个路径作为top参数,函数的作用是在以top为根节点的目录树中游走,对树中的每个目录生成一个由(dirpath, dirnames, filenames)三项组成的三元组。
其中,dirpath是一个指示这个目录路径的字符串,dirnames是一个dirpath下子目录名(除去“.”和“..”)组成的列表,filenames则是由dirpath下所有非目录的文件名组成的列表。要注意的是,这些名称并不包含所在路径本身,要获取dirpath下某个文件或路径从top目录开始的完整路径,需要使用os.path.join(dirpath, name)。
注意最终返回的结果是一个迭代器,我们可以使用for语句逐个取得迭代器的每一项:
 >>> for item in os.walk("."):
 ...     print(item)
 ...
 ('.', ['do'], ['go_go_go.txt'])
 ('.\\do', ['IAmDirectory', 'python'], [])
 ('.\\do\\IAmDirectory', [], [])
 ('.\\do\\python', [], ['hello_justdopython.txt'])
os.listdir()
“listdir”即“list directories”,列出(当前)目录下的全部路径(及文件)。该函数存在一个参数,用以指定要列出子目录的路径,默认为“.”,即“当前路径”。
函数返回值是一个列表,其中各元素均为字符串,分别是各路径名和文件名。
通常在需要遍历某个文件夹中文件的场景下极为实用。
比如定义以下函数:
 def get_filelists(file_dir='.'):
     list_directory = os.listdir(file_dir)
     filelists = []
     for directory in list_directory:
         # os.path 模块稍后会讲到
         if(os.path.isfile(directory)):
             filelists.append(directory)
     return filelists
该函数的返回值就是当前目录下所有文件而非文件夹的名称列表。
os.mkdir()
“mkdir”,即“make directory”,用处是“新建一个路径”。需要传入一个类路径参数用以指定新建路径的位置和名称,如果指定路径已存在,则会抛出FileExistsError异常。
该函数只能在已有的路径下新建一级路径,否则(即新建多级路径)会抛出FileNotFoundError异常。
相应地,在需要新建多级路径的场景下,可以使用os.makedirs()来完成任务。函数os.makedirs()执行的是递归创建,若有必要,会分别新建指定路径经过的中间路径,直到最后创建出末端的“叶子路径”。
示例如下:
 >>> os.mkdir("test_os_mkdir")
 >>> os.mkdir("test_os_mkdir")
 Traceback (most recent call last):
   File "<stdin>", line 1, in <module>
 FileExistsError: [WinError 183] 当文件已存在时,无法创建该文件。: 'test_os_mkdir'
 >>>
 >>> os.mkdir("test_os_mkdir/test_os_makedirs/just/do/python/hello")
 Traceback (most recent call last):
   File "<stdin>", line 1, in <module>
 FileNotFoundError: [WinError 3] 系统找不到指定的路径。: 'test_os_mkdir/test_os_makedirs/just/do/python/hello'
 >>>
 >>> os.makedirs("test_os_mkdir/test_os_makedirs/just/do/python/hello")
os.remove()
用于删除文件,如果指定路径是目录而非文件的话,就会抛出IsADirectoryError异常。删除目录应该使用os.rmdir()函数。
同样的,对应于os.makedirs(),删除路径操作os.rmdir()也有一个递归删除的函数os.removedirs(),该函数会尝试从最下级目录开始,逐级删除指定的路径,几乎就是一个os.makedirs()的逆过程;一旦遇到非空目录即停止。
os.rename()
该函数的作用是将文件或路径重命名,一般调用格式为os.rename(src, dst),即将src指向的文件或路径重命名为dst指定的名称。
注意,如果指定的目标路径在其他目录下,该函数还可实现文件或路径的“剪切并粘贴”功能。但无论直接原地重命名还是“剪切粘贴”,中间路径都必须要存在,否则就会抛出FileNotFoundError异常。如果目标路径已存在,Windows 下会抛出FileExistsError异常;Linux 下,如果目标路径为空且用户权限允许,则会静默覆盖原路径,否则抛出OSError异常,
和上两个函数一样,该函数也有对应的递归版本os.renames(),能够创建缺失的中间路径。
注意,这两种情况下,如果函数执行成功,都会调用os.removedir()函数来递归删除源路径的最下级目录。
os.getcwd()
“getcwd”实际上是“get the current working directory”的简写,顾名思义,也就是说这个函数的作用是“获取当前工作路径”。在程序运行的过程中,无论物理上程序在实际存储空间的什么地方,“当前工作路径”即可认为是程序所在路径;与之相关的“相对路径”、“同目录下模块导入”等相关的操作均以“当前工作路径”为准。
在交互式环境中,返回的就是交互终端打开的位置;而在 Python 文件中,返回的则是文件所在的位置。
在 Windows 下会有如下输出:
Linux 下的输出则是:
os.chdir()
“chdir”其实是“change the directory”的简写,因此os.chdir()的用处实际上是切换当前工作路径为指定路径。其中“指定路径”需要作为参数传入函数os.chdir(),该参数既可以是文本或字节型字符串,也可以是一个文件描述符,还可以是一个广义的类路径(path-like)对象。若指定路径不存在,则会抛出FileNotFoundError异常。
在 Windows 下,调用该函数的效果为:
在 Linux 下的效果则是:
>>> os.chdir("/home/justdopython/just/do") # 也可将参数指定为"..",即可切换到父目录
>>> os.getcwd()
'/home/justdopython/just/do'
有了这个函数,跨目录读写文件和调用模块就会变得非常方便了,很多时候也就不必再反复将同一个文件在各个目录之间复制粘贴运行,脚本完全可以坐镇中军,在一个目录下完成对其他目录文件的操作,正所谓“运筹帷幄之中,决胜于千里之外”也。
举例来说,可以通过将“当前工作目录”切换到父目录,从而直接访问父目录的文件内容:
>>> os.chdir("..")
>>> os.getcwd()
'D:\\justdopython\\just'
>>> with open("hello_justdopython.txt", encoding="utf-8") as f:
...     f.read()
...
'欢迎访问 justdopython.com,一起学习 Python 技术~'
>>> os.listdir()
['hello_justdopython.txt']
os.path 模块
其实这个模块是os模块根据系统类型从另一个模块导入的,并非直接由os模块实现,比如os.name值为nt,则在os模块中执行import ntpath as path;如果os.name值为posix,则导入posixpath。
使用该模块要注意一个很重要的特性:os.path中的函数基本上是纯粹的字符串操作。换句话说,传入该模块函数的参数甚至不需要是一个有效路径,该模块也不会试图访问这个路径,而仅仅是按照“路径”的通用格式对字符串进行处理。
更进一步地说,os.path模块的功能我们都可以自己使用字符串操作手动实现,该模块的作用是让我们在实现相同功能的时候不必考虑具体的系统,尤其是不需要过多关注文件系统分隔符的问题。
os.path.join()
这是一个十分实用的函数,可以将多个传入路径组合为一个路径。实际上是将传入的几个字符串用系统的分隔符连接起来,组合成一个新的字符串,所以一般的用法是将第一个参数作为父目录,之后每一个参数即使下一级目录,从而组合成一个新的符合逻辑的路径。
但如果传入路径中存在一个“绝对路径”格式的字符串,且这个字符串不是函数的第一个参数,那么其他在这个参数之前的所有参数都会被丢弃,余下的参数再进行组合。更准确地说,只有最后一个“绝对路径”及其之后的参数才会体现在返回结果中。
>>> os.path.join("just", "do", "python", "dot", "com")
'just\\do\\python\\dot\\com'
>>>
>>> os.path.join("just", "do", "d:/", "python", "dot", "com")
'd:/python\\dot\\com'
>>>
>>> os.path.join("just", "do", "d:/", "python", "dot", "g:/", "com")
'g:/com'
os.path.abspath()
将传入路径规范化,返回一个相应的绝对路径格式的字符串。
也就是说当传入路径符合“绝对路径”的格式时,该函数仅仅将路径分隔符替换为适应当前系统的字符,不做其他任何操作,并将结果返回。所谓“绝对路径的格式”,其实指的就是一个字母加冒号,之后跟分隔符和字符串序列的格式:
当指定的路径不符合上述格式时,该函数会自动获取当前工作路径,并使用os.path.join()函数将其与传入的参数组合成为一个新的路径字符串。示例如下:
os.path.basename()
该函数返回传入路径的“基名”,即传入路径的最下级目录。
>>> os.path.basename("/ityouknow/justdopython/IAmBasename")
'IAmBasename'
>>> # 我的系统中同样没有这么一个路径。可见 os.path.basename() 页是单纯进行字符串处理
整这个函数要注意的一点是,返回的“基名”实际上是传入路径最后一个分隔符之后的子字符串,也就是说,如果最下级目录之后还有一个分隔符,得到的就会是一个空字符串:
os.path.dirname()
与上一个函数正好相反,返回的是最后一个分隔符前的整个字符串:
>>> os.path.dirname("/ityouknow/justdopython/IAmBasename")
'/ityouknow/justdopython'
>>>
>>> os.path.dirname("/ityouknow/justdopython/IAmBasename/")
'/ityouknow/justdopython/IAmBasename'
os.path.split()
哈哈实际上前两个函数都是弟弟,这个函数才是老大。
函数os.path.split()的功能就是将传入路径以最后一个分隔符为界,分成两个字符串,并打包成元组的形式返回;前两个函数os.path.dirname()和os.path.basename()的返回值分别是函数os.path.split()返回值的第一个、第二个元素。就连二者的具体实现都十分真实:
def basename(p):
    """Returns the final component of a pathname"""
    return split(p)[1]


def dirname(p):
    """Returns the directory component of a pathname"""
    return split(p)[0]
通过os.path.join()函数又可以把它们组合起来得到原先的路径。
os.path.exists()
这个函数用于判断路径所指向的位置是否存在。若存在则返回True,不存在则返回False:
>>> os.path.exists(".")
True
>>> os.path.exists("./just")
True
>>> os.path.exists("./Inexistence") # 不存在的路径
False
一般的用法是在需要持久化保存某些数据的场景,为避免重复创建某个文件,需要在写入前用该函数检测一下相应文件是否存在,若不存在则新建,若存在则在文件内容之后增加新的内容。
os.path.isabs()
该函数判断传入路径是否是绝对路径,若是则返回True,否则返回False。当然,仅仅是检测格式,同样不对其有效性进行任何核验:
os.path.isfile() 和 os.path.isdir()
这两个函数分别判断传入路径是否是文件或路径,注意,此处会核验路径的有效性,如果是无效路径将会持续返回False。
 >>> # 无效路径
 >>> os.path.isfile("a:/justdopython")
 False
 >>>
 >>> # 有效路径
 >>> os.path.isfile("./just/plain_txt")
 True
 >>>
 >>> # 无效路径
 >>> os.path.isdir("a:/justdopython/")
 False
 >>> # 有效路径
 >>> os.path.isdir("./just/")
 True
4. 总结
本文详细介绍了与操作系统交互的os模块中一些常用的属性和函数,基本可以覆盖初阶的学习和使用。有了这些功能,我们已经可以写出一些比较实用的脚本了。
除了文中介绍的函数外,os模块还有很多更加复杂的功能,但大多是我们暂时用不到的,以后用到会进一步讲解。
time模块
时间的表示方式
- UTC(Coordinated Universal Time,世界协调时)亦即格林威治天文时间,世界标准时间。在中国为UTC+8。DST(Daylight Saving Time)即夏令时。
- 时间戳(timestamp)的方式:通常来说,时间戳表示的是从**1970年1月1日00:00:00**开始按秒计算的偏移量。我们运行“type(time.time())”,返回的是float类型。返回时间戳方式的函数主要有time(),clock()等。
- 元组(struct_time)方式:struct_time元组共有9个元素,返回struct_time的函数主要有gmtime(),localtime(),strptime()。下面列出这种方式元组中的几个元素:
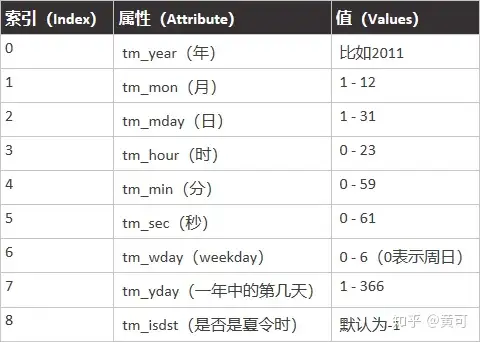
常用函数
**1)**time.localtime([secs]):将一个时间戳转换为当前时区的struct_time。secs参数未提供,则以当前时间为准。
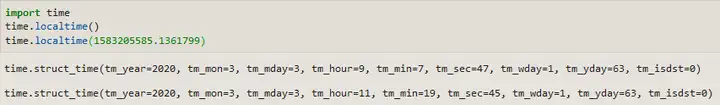
**2)**time.gmtime([secs]):和localtime()方法类似,gmtime()方法是将一个时间戳转换为UTC时区(0时区)

**3)**time.time():返回当前时间的时间戳。
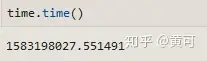
**4)**time.mktime(t):将一个struct_time转化为时间戳。
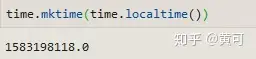
**5)**time.sleep(secs):线程推迟指定的时间运行。单位为秒。
6)time.asctime([t]):把一个表示时间的元组或者struct_time表示为这种形式:'Sun Jun 20 23:21:05 1993'。如果没有参数,将会将time.localtime()作为参数传入。
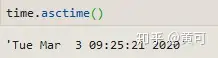
**7)**time.ctime([secs]):把一个时间戳(按秒计算的浮点数)转化为time.asctime()的形式。如果参数未给或者为None的时候,将会默认time.time()为参数。它的作用相当于time.asctime(time.localtime(secs))。
**8)**time.strftime(format[, t]):把一个代表时间的元组或者struct_time(如由time.localtime()和time.gmtime()返回)转化为格式化的时间字符串。如果t未指定,将传入time.localtime()。如果元组中任何一个元素越界,ValueError的错误将会被抛出。
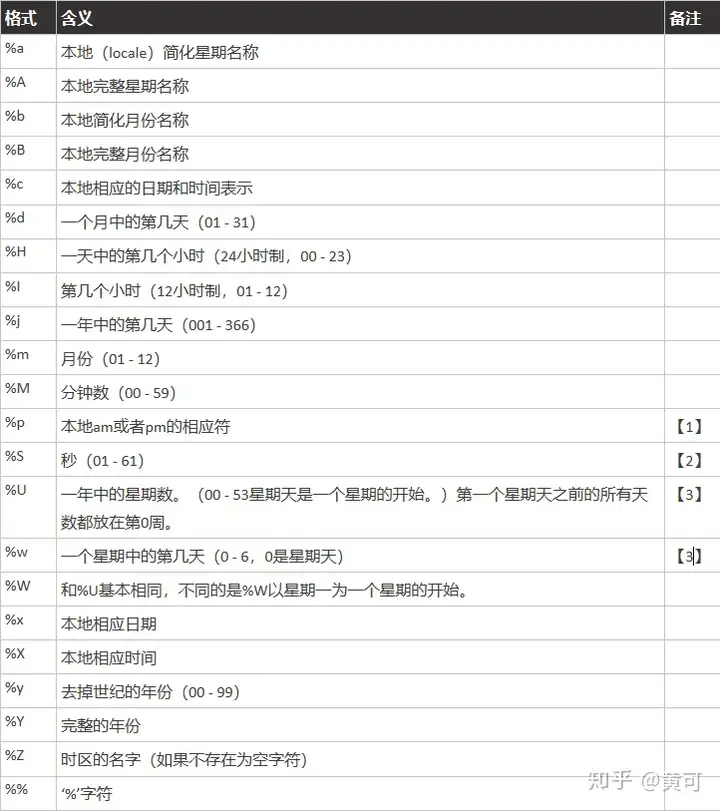
备注:
- “%p”只有与“%I”配合使用才有效果。
- 文档中强调确实是0 - 61,而不是59,闰年秒占两秒(汗一个)。
- 当使用strptime()函数时,只有当在这年中的周数和天数被确定的时候%U和%W才会被计算。
举个例子:

9)time.strptime(string[, format]):把一个格式化时间字符串转化为struct_time。实际上它和strftime()是逆操作。

在这个函数中,format默认为:"%a %b %d %H:%M:%S %Y"。
requests模块
requests模块介绍
requests文档http://docs.python-requests.org/zh_CN/latest/index.html
requests模块作用
- 发送http请求,获取响应数据
requests模块安装
pip/pip3 install requests
发送get请求
- 需求:通过requests向百度首页发送请求,获取该页面的源码
- 运行下面的代码,观察打印输出的结果
# 1.2.1-简单的代码实现
import requests

# 目标url
url = 'https://www.baidu.com'

# 向目标url发送get请求
response = requests.get(url)

# 打印响应内容
print(response.text)
response响应对象
观察上边代码运行结果发现,有好多乱码;这是因为编解码使用的字符集不同早造成的;我们尝试使用下边的办法来解决中文乱码问题
# 1.2.2-response.content
import requests

# 目标url
url = 'https://www.baidu.com'

# 向目标url发送get请求
response = requests.get(url)

# 打印响应内容
# print(response.text)
print(response.content.decode()) # 注意这里!
- response.text是requests模块按照chardet模块推测出的编码字符集进行解码的结果
- 网络传输的字符串都是bytes类型的,所以response.text = response.content.decode('推测出的编码字符集')
- 我们可以在网页源码中搜索
charset,尝试参考该编码字符集,注意存在不准确的情况
response.text 和response.content的区别
- response.text
- 类型:str
- 解码类型: requests模块自动根据HTTP 头部对响应的编码作出有根据的推测,推测的文本编码
- response.content
- 类型:bytes
- 解码类型: 没有指定
解决中文乱码
response.content.decode()默认utf-8response.content.decode("GBK")- 常见的编码字符集
- utf-8
- gbk
- gb2312
- ascii (读音:阿斯克码)
- iso-8859-1
response响应对象常用属性或方法
response = requests.get(url)中response是发送请求获取的响应对象;response响应对象中除了text、content获取响应内容以外还有其它常用的属性或方法:
response.url响应的url;有时候响应的url和请求的url并不一致response.status_code响应状态码response.request.headers响应对应的请求头response.headers响应头response.request._cookies响应对应请求的cookie;返回cookieJar类型response.cookies响应的cookie(经过了set-cookie动作;返回cookieJar类型response.json()自动将json字符串类型的响应内容转换为python对象(dict or list)
# 1.2.3-response其它常用属性
import requests

# 目标url
url = 'https://www.baidu.com'

# 向目标url发送get请求
response = requests.get(url)

# 打印响应内容
# print(response.text)
# print(response.content.decode())          # 注意这里!
print(response.url)                         # 打印响应的url
print(response.status_code)                 # 打印响应的状态码
print(response.request.headers)             # 打印响应对象的请求头
print(response.headers)                     # 打印响应头
print(response.request._cookies)            # 打印请求携带的cookies
print(response.cookies)                     # 打印响应中携带的cookies
requests模块发送请求
发送带header的请求
我们先写一个获取百度首页的代码
import requests

url = 'https://www.baidu.com'

response = requests.get(url)

print(response.content.decode())

# 打印响应对应请求的请求头信息
print(response.request.headers)
携带请求头发送请求的方法
从浏览器中复制User-Agent,构造headers字典;完成下面的代码后,运行代码查看结果
import requests

url = 'https://www.baidu.com'

headers = {"User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/54.0.2840.99 Safari/537.36"}

# 在请求头中带上User-Agent,模拟浏览器发送请求
response = requests.get(url, headers=headers)

print(response.content)

# 打印请求头信息
print(response.request.headers)
发送带参数的请求
我们在使用百度搜索的时候经常发现url地址中会有一个
?,那么该问号后边的就是请求参数,又叫做查询字符串
在url携带参数
直接对含有参数的url发起请求
import requests

headers = {"User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/54.0.2840.99 Safari/537.36"}

url = 'https://www.baidu.com/s?wd=python'

response = requests.get(url, headers=headers)
通过params携带参数字典
1.构建请求参数字典
2.向接口发送请求的时候带上参数字典,参数字典设置给params
import requests

headers = {"User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/54.0.2840.99 Safari/537.36"}

# 这是目标url
# url = 'https://www.baidu.com/s?wd=python'

# 最后有没有问号结果都一样
url = 'https://www.baidu.com/s?'

# 请求参数是一个字典 即wd=python
kw = {'wd': 'python'}

# 带上请求参数发起请求,获取响应
response = requests.get(url, headers=headers, params=kw)

print(response.content)
在headers参数中携带cookie
网站经常利用请求头中的Cookie字段来做用户访问状态的保持,那么我们可以在headers参数中添加Cookie,模拟普通用户的请求。我们以github登陆为例:
import requests

url = 'https://github.com/USER_NAME'

# 构造请求头字典
headers = {
    # 从浏览器中复制过来的User-Agent
    'User-Agent': 'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/67.0.3396.87 Safari/537.36',
    # 从浏览器中复制过来的Cookie
    'Cookie': 'xxx这里是复制过来的cookie字符串'
}

# 请求头参数字典中携带cookie字符串
resp = requests.get(url, headers=headers)

print(resp.text)
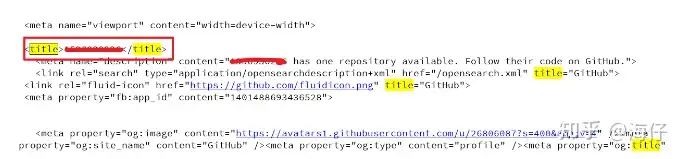
在打印的输出结果中搜索title,html中的标题文本内容如果是你的github账号,则成功利用headers参数携带cookie,获取登陆后才能访问的页面
cookies参数的使用
上一小节我们在headers参数中携带cookie,也可以使用专门的cookies参数
- cookies参数的形式:字典
- 该字典对应请求头中Cookie字符串,以分号、空格分割每一对字典键值对
- 等号左边的是一个cookie的name,对应cookies字典的key
- 等号右边对应cookies字典的value
- cookies参数的使用方法
- 将cookie字符串转换为cookies参数所需的字典:
cookies_dict = {cookie.split('=')[0]:cookie.split('=')[-1] for cookie in cookies_str.split('; ')}
- 注意:cookie一般是有过期时间的,一旦过期需要重新获取
import requests

url = 'https://github.com/USER_NAME'

# 构造请求头字典
headers = {
    'User-Agent': 'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/67.0.3396.87 Safari/537.36'
}
# 构造cookies字典
cookies_str = '从浏览器中copy过来的cookies字符串'

cookies_dict = {cookie.split('=')[0]:cookie.split('=')[-1] for cookie in cookies_str.split('; ')}

# 请求头参数字典中携带cookie字符串
resp = requests.get(url, headers=headers, cookies=cookies_dict)

print(resp.text)
cookieJar对象转换为cookies字典的方法
使用requests获取的resposne对象,具有cookies属性。该属性值是一个cookieJar类型,包含了对方服务器设置在本地的cookie。我们如何将其转换为cookies字典呢?
- 转换方法
- 其中response.cookies返回的就是cookieJar类型的对象
requests.utils.dict_from_cookiejar函数返回cookies字典
timeout的使用
在平时网上冲浪的过程中,我们经常会遇到网络波动,这个时候,一个请求等了很久可能任然没有结果。 在爬虫中,一个请求很久没有结果,就会让整个项目的效率变得非常低,这个时候我们就需要对请求进行强制要求,让他必须在特定的时间内返回结果,否则就报错。
- 超时参数timeout的使用方法
- timeout=3表示:发送请求后,3秒钟内返回响应,否则就抛出异常
了解代理以及proxy代理参数的使用
proxy代理参数通过指定代理ip,让代理ip对应的正向代理服务器转发我们发送的请求,那么我们首先来了解一下代理ip以及代理服务器
理解使用代理的过程
- 代理ip是一个ip,指向的是一个代理服务器
- 代理服务器能够帮我们向目标服务器转发请求
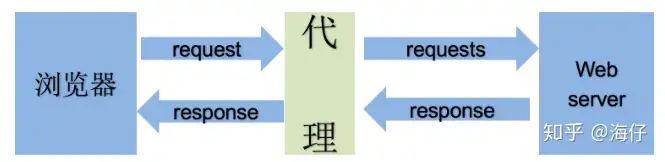
正向代理和反向代理的区别
前边提到proxy参数指定的代理ip指向的是正向的代理服务器,那么相应的就有反向服务器;现在来了解一下正向代理服务器和反向代理服务器的区别
- 从发送请求的一方的角度,来区分正向或反向代理
- 为浏览器或客户端(发送请求的一方)转发请求的,叫做正向代理
- 浏览器知道最终处理请求的服务器的真实ip地址,例如VPN
- 不为浏览器或客户端(发送请求的一方)转发请求、而是为最终处理请求的服务器转发请求的,叫做反向代理
- 浏览器不知道服务器的真实地址,例如nginx
代理ip(代理服务器)的分类
-
根据代理ip的匿名程度,代理IP可以分为下面三类:
-
透明代理(Transparent Proxy):透明代理虽然可以直接“隐藏”你的IP地址,但是还是可以查到你是谁。目标服务器接收到的请求头如下:
REMOTE_ADDR = Proxy IP HTTP_VIA = Proxy IP HTTP_X_FORWARDED_FOR = Your IP -
匿名代理(Anonymous Proxy):使用匿名代理,别人只能知道你用了代理,无法知道你是谁。目标服务器接收到的请求头如下:
REMOTE_ADDR = proxy IP HTTP_VIA = proxy IP HTTP_X_FORWARDED_FOR = proxy IP -
高匿代理(Elite proxy或High Anonymity Proxy):高匿代理让别人根本无法发现你是在用代理,所以是最好的选择。毫无疑问使用高匿代理效果最好。目标服务器接收到的请求头如下:
REMOTE_ADDR = Proxy IP HTTP_VIA = not determined HTTP_X_FORWARDED_FOR = not determined -
根据网站所使用的协议不同,需要使用相应协议的代理服务。从代理服务请求使用的协议可以分为:
-
http代理:目标url为http协议
-
https代理:目标url为https协议
-
socks隧道代理(例如socks5代理)等:
-
- socks 代理只是简单地传递数据包,不关心是何种应用协议(FTP、HTTP和HTTPS等)。
- socks 代理比http、https代理耗时少。
- socks 代理可以转发http和https的请求
proxies代理参数的使用
为了让服务器以为不是同一个客户端在请求;为了防止频繁向一个域名发送请求被封ip,所以我们需要使用代理ip;那么我们接下来要学习requests模块是如何使用代理ip的
- 用法:
- proxies的形式:字典
- 例如:
python proxies = { "http": "http://12.34.56.79:9527", "https": "https://12.34.56.79:9527", }
- 注意:如果proxies字典中包含有多个键值对,发送请求时将按照url地址的协议来选择使用相应的代理ip
使用verify参数忽略CA证书
在使用浏览器上网的时候,有时能够看到下面的提示(2018年10月之前的12306网站):
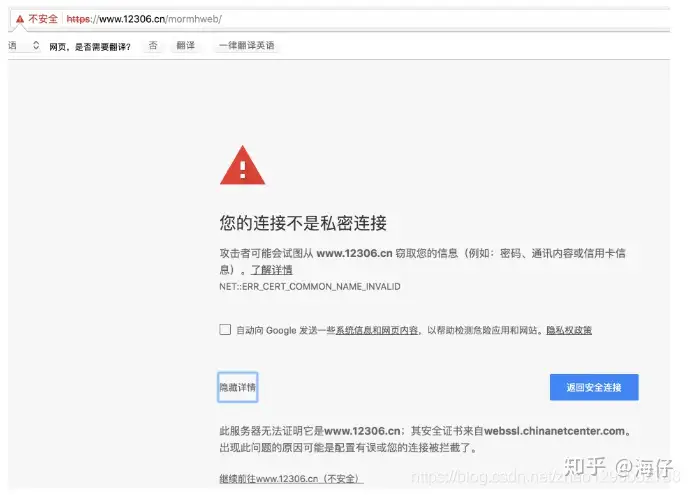
- 原因:该网站的CA证书没有经过【受信任的根证书颁发机构】的认证
运行下面的代码将会抛出包含
ssl.CertificateError ...字样的异常
import requests
url = "https://sam.huat.edu.cn:8443/selfservice/"
response = requests.get(url)
解决方案
为了在代码中能够正常的请求,我们使用
verify=False参数,此时requests模块发送请求将不做CA证书的验证:verify参数能够忽略CA证书的认证
import requests
url = "https://sam.huat.edu.cn:8443/selfservice/"
response = requests.get(url,verify=False)
requests模块发送post请求
思考:哪些地方我们会用到POST请求?
- 登录注册( 在web工程师看来POST 比 GET 更安全,url地址中不会暴露用户的账号密码等信息)
- 需要传输大文本内容的时候( POST 请求对数据长度没有要求)
所以同样的,我们的爬虫也需要在这两个地方回去模拟浏览器发送post请求
response = requests.post(url, data)data参数接收一个字典- requests模块发送post请求函数的其它参数和发送get请求的参数完全一致
了解requests模块发送post请求的方法,以及分析过移动端的百度翻译之后,我们来完成代码
import requests
import json


class King(object):

    def __init__(self, word):
        self.url = "http://fy.iciba.com/ajax.php?a=fy"
        self.word = word
        self.headers = {
            "User-Agent": "Mozilla/5.0 (Macintosh; Intel Mac OS X 10_12_6) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/71.0.3578.98 Safari/537.36"
        }
        self.post_data = {
            "f": "auto",
            "t": "auto",
            "w": self.word
        }

    def get_data(self):
        response = requests.post(self.url, headers=self.headers, data=self.post_data)
        # 默认返回bytes类型,除非确定外部调用使用str才进行解码操作
        return response.content

    def parse_data(self, data):

        # 将json数据转换成python字典
        dict_data = json.loads(data)

        # 从字典中抽取翻译结果
        try:
            print(dict_data['content']['out'])
        except:
            print(dict_data['content']['word_mean'][0])

    def run(self):
        # url
        # headers
        # post——data
        # 发送请求
        data = self.get_data()
        # 解析
        self.parse_data(data)

if __name__ == '__main__':
    # king = King("人生苦短,及时行乐")
    king = King("China")
    king.run()
    # python标准库有很多有用的方法,每天看一个标准库的使用
re模块
re模块的方法
python语言中把**函数提供的功能叫做方法**,re模块提供了各种各样的正则表达式方法。
**re.match(pattern, string, flags=0)方法:如果string开始的0或者多个字符匹配到了正则表达式样式,就返回一个相应的**匹配对象。如果没有匹配,就返回None.
>>> import re
>>> print(re.match('abc', 'abcdef').group())  # 匹配到开头
abc
>>> print(re.match('abc', 'defabc').group())  # 未未匹配开头,返回None
None
**re.search(pattern, string, flags=0)方法:**扫描整个字符串找到匹配样式的第一个位置(一旦匹配成功则停止匹配),并返回一个相应的匹配对象。如果没有匹配,就返回None.
>>> import re
>>> print(re.search('\d+', 'ab12cd236ef').group())  # 返回第一个匹配
12
>>> print(re.search('\d+', 'abcd236ef').group())  # 返回第一个匹配
236
**re.match与re.search的区别:re.match只匹配字符串的**开始,如果字符串开始不符合正则表达式,则匹配失败,函数返回None,而re.search匹配整个字符串,直到找到一个匹配对象为止。
**re.fullmatch(pattern, string, flags=0)方法:**如果整个string匹配到正则表达式样式,就返回一个相应的匹配对象 ,否则就返回None.
>>> print(re.fullmatch('\d+', 'ab12cd236ef'))  # 未匹配成功
None
>>> print(re.fullmatch('\d+', '236'))  # 匹配整个字符串
<re.Match object; span=(0, 3), match='236'>
**re.findall(pattern, string, flags=0)方法:**搜索string,以列表的形式返回全部能匹配到的字串,对string从左到右进行扫描,按找到的顺序返回。
import re
>>> print(re.findall('(w=2u).*(l=1u)', 'n33 w=2u m=2 l=1u'))  # 分组
[('w=2u', 'l=1u')]
>>> print(re.findall('\d+', 'ab12cd236ef12'))  # 匹配所有
['12', '236', '12']
如果样式里存在一到多个组,就返回一个组合列表;如果样式里有超过一个组合的话就是一个元组的列。
**re.split(pattern, string, maxsplit=0, flags=0)方法:**用pattern分开string,如果在pattern中捕获到括号,那么所有的组里的文字也会包含在列表里。
import re
>>> print(re.split('\d+', 'ab12cd236ef5678'))  # 使用数字分割
['ab', 'cd', 'ef', '']
>>> print(re.split('\d+', 'ab12cd236ef'))  # 使用数字分割
['ab', 'cd', 'ef']
>>> print(re.split('(\d+)', 'ab12cd236ef5678'))  # 分组
['ab', '12', 'cd', '236', 'ef', '5678', '']
>>> print(re.split('(\d+)', 'ab12cd236ef'))  # 分组
['ab', '12', 'cd', '236', 'ef']
如果maxsplit非零,最多进行maxsplit次分隔,剩下的字符全部返回到列表的最后一个元素。
**re.sub(pattern, repl, string, count=0, flags=0):**使用repl替换string中每一个匹配的子串后返回替换后的字符串。可选参数count是要替换的最大次数,count必须是非负整数,如果忽略这个参数,或者设置为0,所有的匹配都会被替换。
import re
>>> print(re.sub(r'\d+', ',', 'ab12cd236ef5678'))
ab,cd,ef,
>>> print(re.sub(r'(w=2u)(.*)(l=1u)', r'\1*0.9\2\3*0.8', 'n33 w=2u m=2 l=1u'))
n33 w=2u*0.9 m=2 l=1u*0.8
**repl可以是字符串或函数,**如为字符串,则其中任何反斜杠转义序列都会被处理。也就是说,\n会被转换为一个换行符,\r会被转换为一个回车附,依此类推。
re.sub()方法用来实现电路设计中网表替换功能十分方便,可以按照需要替换器件参数,会经常使用。
**re.subn(pattern, repl, string, count=0, flags=0):行为与re.sub()相同,但是返回一个**元组 (新的替换字符串,替换次数)。
以上是re模块常用的方法,还有个别不常用的方法如果有需要可以**参考re模块的官方文档**。