X86逆向基础知识
汇编语言是 CPU 中最低级别的指令集。你需要掌握汇编的基础知识,才能使用像 Ghidra、IDA 和 Binary Ninja 这样的 dissembler,以及像 x64dbg 这样的调试器。x86 是大多数 Windows 系统使用的 CPU 架构。尽管 ARM CPU 架构在市场份额上有所提升,但 ARM 上的 Windows 模拟 x86 应用程序,64 位 CPU 可以运行 32 位应用程序。恶意软件作者可能会在一段时间内继续针对 32 位 x86 处理器以实现最大兼容性
寄存器
寄存器是 CPU 上的超高速临时内存。在 x86 CPU 上,寄存器每个存储 32 位。通用寄存器 EAX、EBX、ECX 和 EDX 可以分别分为 16 位或 8 位,如下图所示。
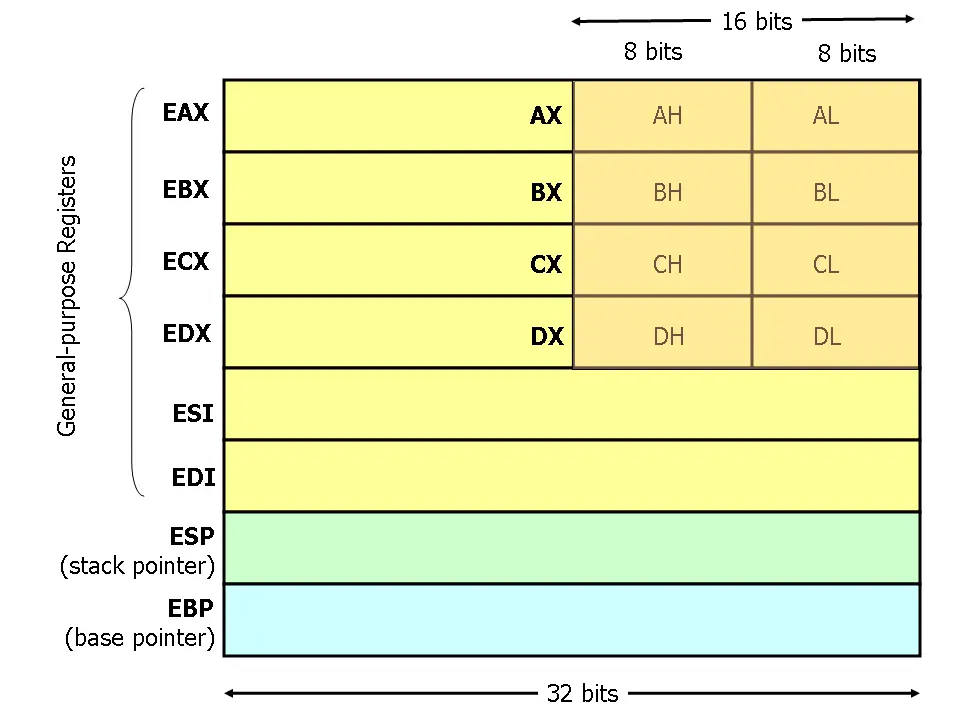
此外,ESI、EDI、EBP 和 ESP 也可以用其 16 位等价的 SI、DI、BP、SP 来引用。
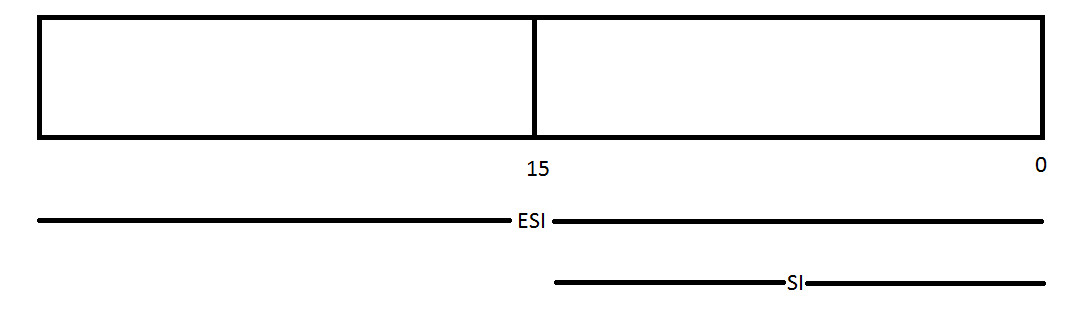
有些寄存器用于特定任务。
| Register | Purpose |
|---|---|
| EAX | 用于加法、乘法和返回值 |
| EBP | 基准点。通常用于引用传递到函数中的参数,以及函数内的局部变量。 |
| ECX | 作为计数器使用 |
| ESP | 指向堆栈上的最后一项——堆栈指针 |
| ESI/EDI | 内存传输指令的使用 |
| EIP | 指向下一条要执行的指令 |
EFLAGS
我们处理的是 32 位汇编,其中有一个 32 位寄存器,包含一组状态、控制和系统标志。该寄存器称为 EFLAGS 寄存器,因为它包含 32 位信息,映射为代表特定信息标志。
标志有三种类型:状态标志、控制标志和系统标志。
| 位号 | 标志缩写 | 名称 | 类型 | 说明 |
|---|---|---|---|---|
| 0 | CF | Carry Flag | 状态 | 进位/借位标志。无符号运算溢出时置 1(如加法产生进位、减法需要借位)。 |
| 2 | PF | Parity Flag | 状态 | 奇偶标志。结果低 8 位中 1 的个数为偶数时为 1。 |
| 4 | AF | Auxiliary Carry Flag | 状态 | 辅助进位标志。用于 BCD(二进制编码十进制)运算,低 4 位向高 4 位进位或借位时置 1。 |
| 6 | ZF | Zero Flag | 状态 | 零标志。运算结果为 0 时置 1。 |
| 7 | SF | Sign Flag | 状态 | 符号标志。结果的最高位(符号位)为 1 时置 1(表示负数)。 |
| 8 | TF | Trap Flag | 控制 | 单步调试标志。置 1 时,CPU 进入单步模式,每条指令执行后产生调试异常(INT 1)。 |
| 9 | IF | Interrupt Enable Flag | 系统 | 中断允许标志。置 1 时允许响应可屏蔽中断(INTR);置 0 时禁止。 |
| 10 | DF | Direction Flag | 控制 | 方向标志。用于字符串操作指令(如 MOVS、LODS)。DF=0:地址递增(正向);DF=1:地址递减(反向)。 |
| 11 | OF | Overflow Flag | 状态 | 溢出标志。有符号运算结果溢出时置 1(如 127 + 1 = -128)。 |
| 12–13 | IOPL | I/O Privilege Level | 系统 | I/O 特权级别(2 位)。控制程序是否可以执行 I/O 指令(通常仅操作系统使用)。 |
| 14 | NT | Nested Task | 系统 | 嵌套任务标志。用于任务切换机制(在现代系统中较少使用)。 |
| 16 | RF | Resume Flag | 系统 | 恢复标志。用于调试,抑制断点异常。 |
| 17 | VM | Virtual 8086 Mode | 系统 | 虚拟 8086 模式标志(仅在保护模式下有效)。 |
| 18 | AC | Alignment Check | 系统 | 对齐检查标志。与 CR0 的 AM 位配合,启用未对齐内存访问检查。 |
| 19 | VIF | Virtual Interrupt Flag | 系统 | 虚拟中断标志(用于虚拟 8086 模式)。 |
| 20 | VIP | Virtual Interrupt Pending | 系统 | 虚拟中断挂起标志。 |
| 21 | ID | ID Flag | 系统 | 支持 CPUID 指令的标志。可用来检测 CPU 是否支持 CPUID 指令。 |
虽然标志有很多,但在逆向过程中最常用的是**OF、ZF、CF、SF**这四个标志位
| 标志 | 全称 | 作用简述 | 常见场景 |
|---|---|---|---|
| ZF | Zero Flag(零标志) | 运算结果为 0 时置 1 | cmp/test 后判断相等(je/jz)、循环终止条件 |
| CF | Carry Flag(进位标志) | 无符号运算溢出(进位/借位) | 无符号比较(jb/ja)、多精度加减法、移位指令 |
| SF | Sign Flag(符号标志) | 结果最高位为 1(负数) | 有符号数比较的辅助标志 |
| OF | Overflow Flag(溢出标志) | 有符号运算溢出 | 有符号比较(jg/jl)的关键依据 |
指令指针寄存器(EIP)
指令指针寄存器称为 EIP 寄存器,是你在任何逆向工程中处理到的最重要寄存器。EIP 负责跟踪下一个要执行的指令代码。EIP 指向下一条要执行的指令。如果你修改那个指针跳转到代码中的另一个区域,你就能完全控制那个程序。
让我们直接跳到代码里。这里有一个简单的 C 语言 hello world 应用示例,我们将在后续教程系列中详细介绍。就我们今天的目的而言,我们将看到汇编语言的原始威力,特别是 EIP 寄存器的强大,以及我们如何彻底破解程序控制。
#include <stdio.h>
#include <stdlib.h>

void unreachableFunction(void){
    printf("I'm hacked! I am a hidden funnction!\n");
    exit(0);
}

int main(void){
    printf("Hello World!\n");

    return 0;
}
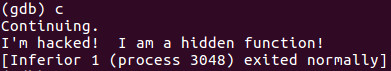
这里需要注意的是,我们有一个叫 unreachableFunction 的函数,主函数从未调用过它。正如你会看到的,如果我们能控制 EIP 寄存器,我们就能破解这个程序来执行那个代码!
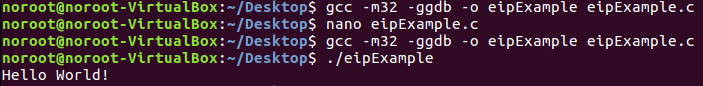
我们只是简单地编译了代码以配合 IA32 指令集并运行。如你所见,没有调用任何形式的 unreachableFunction,因为在正常情况下它无法到达,你可以看到执行时打印出的“Hello World!”。
如果我们再次运行该程序,检查 EIP 指向的方向,我们将看到:
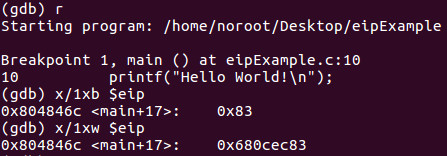
我们可以看到 EIP 指向 main+17 或 0x680cec83 的地址。
我们检查 unreachableFunction,看看它在内存中的起始位置,然后写下该地址。
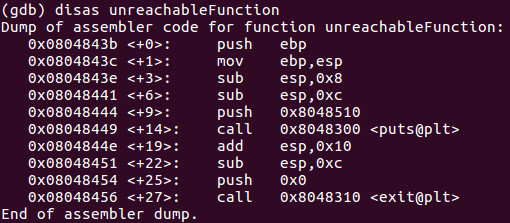
下一步是将 EIP 设置为寻址 0x0804843b,这样我们劫持程序流以运行 unreachableFunction。
既然我们已经黑进了对 EIP 的控制,让我们继续,看看我们如何劫持一个正在运行的程序的运行,为自己谋取优势!
栈
函数是软件开发中最基本的功能。函数允许你以逻辑方式组织代码,以执行指定任务。在这个阶段,理解函数的工作原理并不一定重要,重要的是你要明白,当我们开始学习开发时,我们希望通过使用可以多次调用的函数来减少重复,而不是重复代码占用过多内存。
当程序开始执行时,会为程序预留一段连续的内存,称为栈。
栈指针是一个寄存器,包含栈顶端。栈指针包含最小地址,比如 0x00001000,使得任何小于 0x00001000 的地址被视为垃圾,任何大于 0x00001000 的地址都被视为有效。
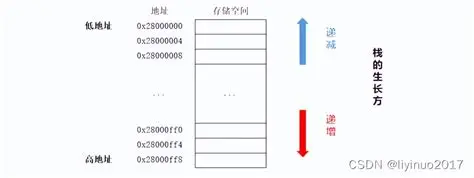
栈生长方向为从下到上,栈地址增长方向为从上到下,从栈顶到栈底,栈顶地址最小,栈底地址最大
栈是一种后进先出(LIFO)数据结构,存储在系统内存(即内存)中。就像一堆盘子一样,最后一个被推到堆上的物品会是第一个从堆里弹出来的。
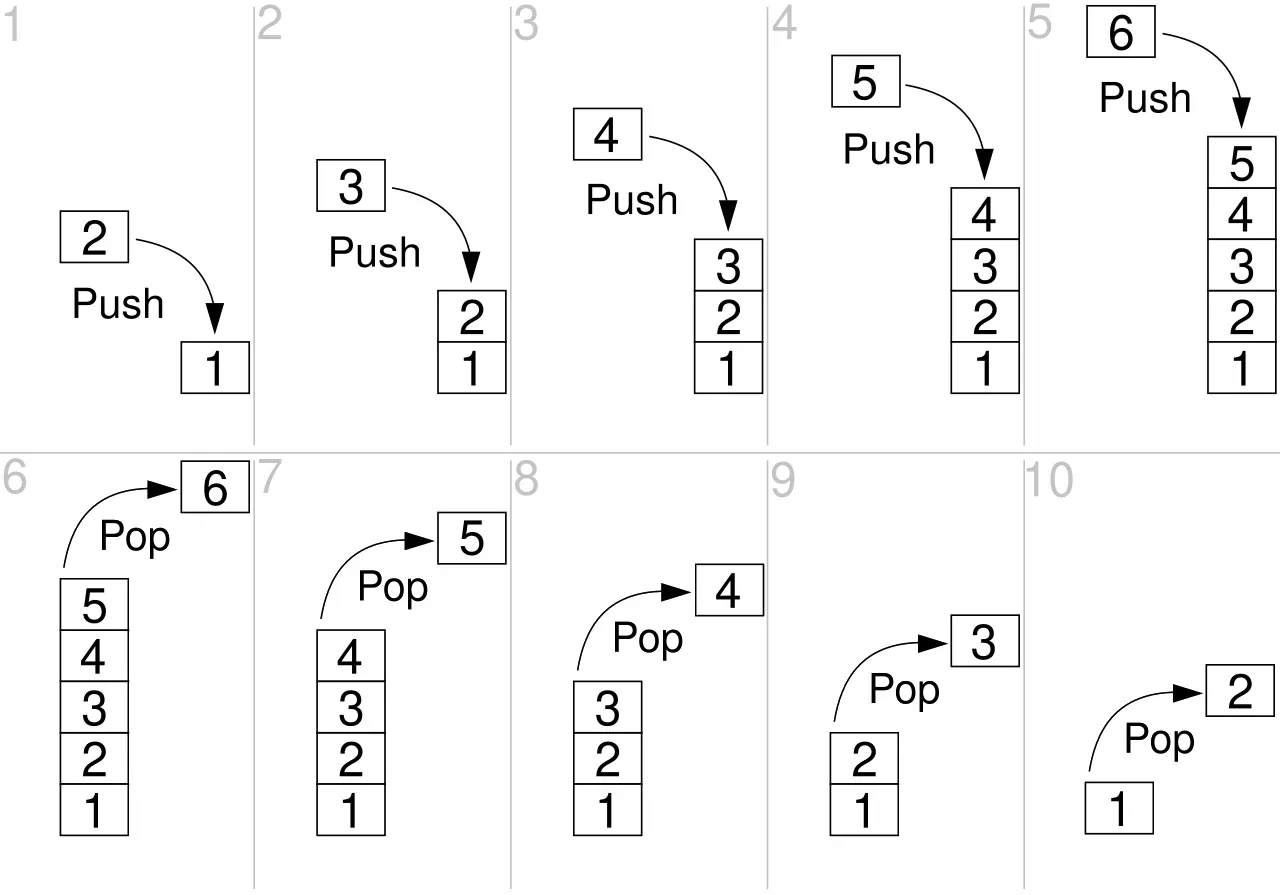
32 位应用使用该堆栈存储局部变量和函数参数的值。第一个参数是底部的 PUSH 指令,最后一个参数是顶部的 PUSH 指令。堆栈上的每个项目有 4 个字节。堆栈上的寻址值会随着添加的项目增加而从大到小,这看起来可能有些反直觉。
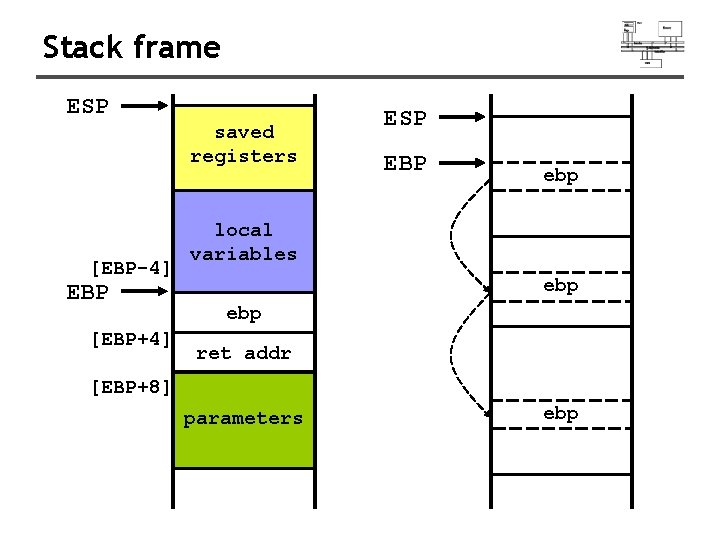
ESP 寄存器指向堆栈中栈顶的地址。随着堆栈的变化,其值会自动更新。
EBP 寄存器存储基础指针(也称为帧指针),这是一个不变的值,作为访问栈中项目的参考点(栈底)。例如:
-
Parameter:
EBP+ value -
Local variables:
EBP- value
我们看一下栈与函数调用的关系
#include <stdio.h>

int add(int a, int b);

int main(void){
    int result = add(2, 3);

    printf("The result of the add function is: %d!\n", result);

    return 0;
}

int add(int a, int b){
    return a + b;
}
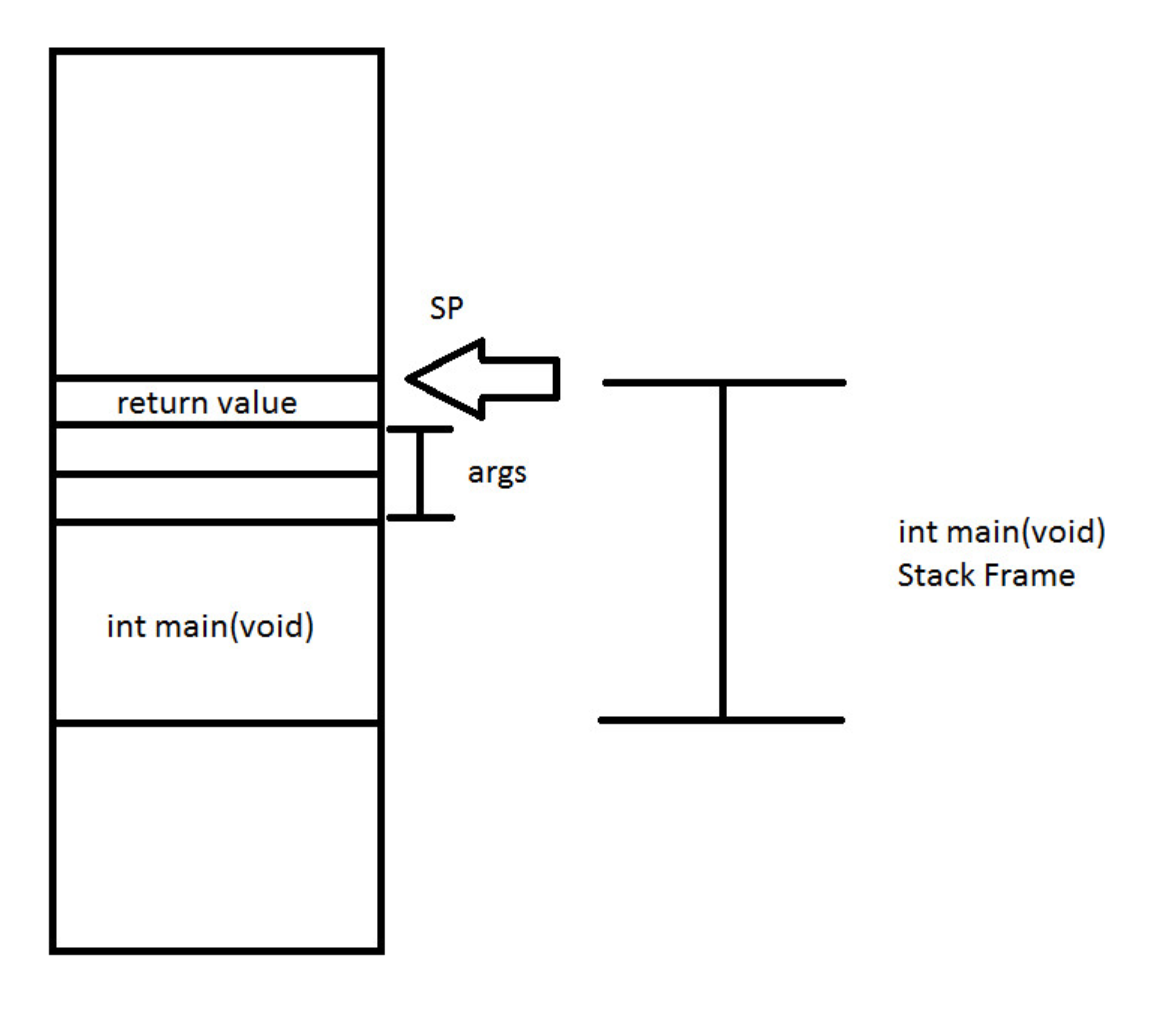
非常简单,int main(void) 先调用 int addMe(int a, int b),并会像这样被放到堆栈中:
堆
我们在基础恶意软件逆向工程部分的下一步聚焦于堆。请记住,堆叠是向下增长,堆积是向上增长的。在我们未来的教程中,理解这个概念非常重要。
堆是你电脑内存中不会自动管理的区域,也不是 CPU 严格管理的区域。它是自由浮动的内存区域,且比内存的栈分配更大。
要在堆上分配内存,必须使用 malloc() 或 calloc(),这两者是内置的 C 函数。一旦你在堆上分配了内存,你需要通过使用 free() 来释放该内存,当它不再需要时。
如果不这样做,程序将会出现所谓的内存泄漏。也就是说,堆上的内存仍会被保留,无法提供给其他需要它的进程。
与堆栈不同,堆对可变大小没有大小限制。唯一会限制堆的,就是你电脑的物理限制。堆内存的读写速度稍慢,因为你需要用指针访问堆上的内存。
与栈不同,堆上创建的变量可以被程序中任何函数访问。堆变量本质上是全局范围的。
如果你需要为结构体或大型数组分配一个大块内存,并且需要在程序中保持该变量一段时间,并且需要全局访问,那么你应该选择堆来实现这个目的。如果你需要像数组和结构体这样能动态变化大小的变量,比如可以根据需要大小变大或缩小的数组,那么你很可能需要将它们分配到堆上,并使用动态内存分配函数如 malloc()、calloc()、realloc()和 free() 来手动管理内存。
Assembly notation
Ghidra 和其他工具使用 Intel 的汇编代码表示法,在将数据搬入和移出寄存器时遵循此格式
Comments start with ;.
在 Ghidra 中,引用内存位置而非直接值的参数用方括号括住。例如:
| Example | Description |
|---|---|
| [EAX] | Access dynamically allocated memory (base) |
| [EBP + 0x10] | Access data on the stack (base + displacement) |
| [EAX + EBX * 8] | Access an array with 8-byte structures (base + index * scale) |
| [EAX + EBX + 0xC] | Access a two-dimensional array of structures (base + index + displacement) |
Common patterns
Setting a register to 0
编译器会单独将寄存器异或,这是作为将寄存器设置为 0 的最高效方式。
Testing if a register is set to 0
Testing if a register is set to a value
Stack cleanup
无条件跳转
| Name | Description |
|---|---|
| JMP | Jump directly to a memory address |
| CALL | Call a function |
| RET | Return a value to the calling function |
条件跳转
jcc format
| Notation | Description |
|---|---|
| a | Above (unsigned) |
| b | Below (unsigned) |
| e | Equal |
| n | Not equal |
| g | Greater (signed) |
| l | Less (signed) |
| z | Zero |
条件跳转示例
| Notation | Description |
|---|---|
| jz | jump if zero |
| jnz | Jump if not 0 |
| ja | jump above |
| jnge | jump if not greater than or equal to |
loopcc format
遵循与 jcc 相同的符号
Loop example
一个循环,在控制变量小于 5 时加 1。
Start:
  mov eax, 0 ; Initialize the control variable

CheckIfStop:
  cmp eax, 5 ; Compare the current state of the control variable with the end condition
  jnl End ; jnl ; jump if not less. je (jump if equal) would also work here

InsideLoop:
  ; Actions inside the loop go here
  add eax, 1 ; Increment the control variable
  jmp CheckIfStop

End:
  ; Code that continues here after the loop
代码分支
为了将 if/else 和 case 语句从 C/C++ 转换为汇编,编译器会使用条件跳转。例如,在评估一个或条件时,两个条件跳跃都会指向同一个函数。在评估 AND 条件时,第一次条件跳跃会跳转到代码以评估第二个条件,如果第二个条件通过,代码才执行该代码。
错误处理
通常,Windows API 调用在失败时返回 0(也称为 FALSE 或 NULL),但并非总是如此。在检查执行 Windows API 调用的函数时,重要的是查阅 Microsoft 文档中的该 API 调用(只需在 Google 上搜索函数名),以了解可能的返回值及其含义。
Calling conventions
The cdecl and stdcall calling conventions have a few things in common:
- 参数从右到左添加到堆栈
- 返回值存储在EAX中
cdecl CDCL
- Most common
- The caller cleans up the stack by removing the arguments
stdcall
-
Used in the WIN32 APIs
-
The callee cleans up the stack by removing the arguments
fastcall
- Arguments are stored in registers
- Both Microsoft and GNU compilers use ECX and EDX
- Additional arguments are stored on the stack
- The callee cleans up the stack by removing the arguments
thiscall
- Used in C++ object member functions
thisis stored as a pointer- Microsoft compilers store the
thispointer inECX, and the callee cleans up the stack - GNU compilers store the
thispointer as the last (i.e., top) item pushed to the stack
如何编译程序
Linux
编写好后使用gcc编译
这一步会创建二进制文件test,如果我们想要从C代码得到汇编代码,使用如下命令:
gcc -S -m32 -O0 test.c

# -S 交换机将生成可比的 AT&T 语法汇编源代码。
# -m32 会生成一个 32 位的可执行文件,而 -O0 则告诉编译器在编译二进制时需要使用多少优化。这就是大写的 O 和数字 0。在这种情况下,数字为 0 意味着没有优化,也就是说它在人类可读的指令集里。如果你用 1、2 或 3 替代,随着数值增加,优化量会增加。
如果我们想要从汇编代码得到二进制程序,则需要多个步骤:
我们可以使用objdump来看一下二进制文件结构:
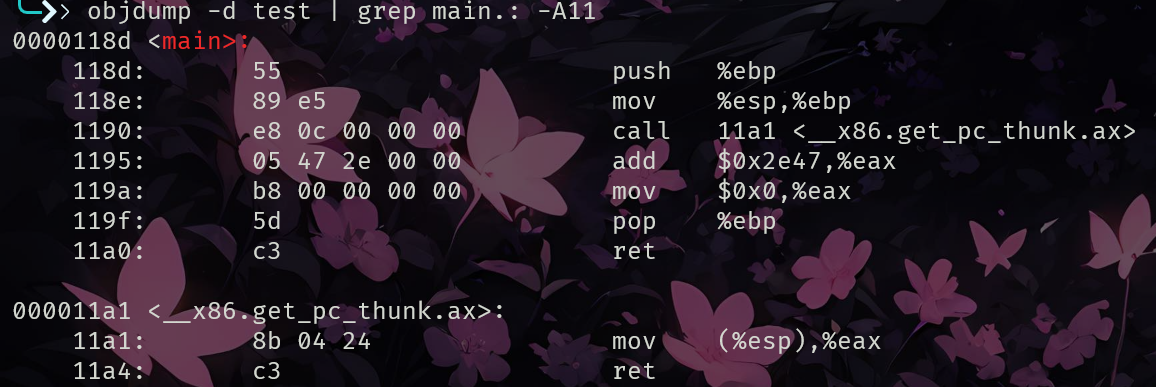
Linux使用的是AT&T汇编语言语法,与windows使用的Intel语法的不同如下:
- AT&T
- 操作数顺序:源, 目标(与 Intel 相反)
- 立即数前加
$ - 寄存器前加
% -
指令后缀表示操作数大小:
b(byte)、w(word)、l(long)、q(quad) -
Intel
- 操作数顺序:目标, 源
- 无
$/%前缀 - 内存访问用
[] - 操作数大小通常由寄存器名隐含(如
eax是 32 位)