访问控制漏洞与权限提升
访问控制是对谁或什么被授权执行动作或访问资源施加约束。在 Web 应用的语境中,访问控制依赖于身份验证和会话管理:
- 认证确认用户身份是否合法
- 会话管理识别正在发出的后续 HTTP 请求是否是由同一用户发出。
- 访问控制决定用户是否被允许执行他们试图执行的操作。
访问控制失效很常见,且常常构成关键的安全漏洞。访问控制的设计和管理是一个复杂且动态的问题,涉及业务、组织和法律限制对技术实施的应用。访问控制的设计决策必须由人工做出,因此错误的可能性很高。
访问控制模型
访问控制安全模型是一套独立于技术或实施平台的正式定义的访问控制规则。访问控制安全模型可在操作系统、网络、数据库管理系统以及后台、应用和网页服务器软件中实现。多年来,各种访问控制安全模型被设计出来,以将访问控制政策与业务或组织的规则及技术变化相匹配。
四大经典访问控制模型
自主访问控制 (DAC - Discretionary Access Control)
- 概念:资源的所有者(属主)可以自主决定将访问权限授予其他用户或收回权限
- 特点:权限管理分散,由数据属主自行控制。典型的例子是 Linux/Unix 文件系统中的
rwx(读、写、执行)权限设置。 - 优点:实现简单,灵活性高,用户体验好,管理成本较低。
- 缺点:安全性相对较低,权限容易被随意扩散(如用户将敏感文件共享给未授权人员),难以进行全局的集中管理和安全审计。
- 适用场景:对数据安全性要求不高的场景,如个人电脑、小型团队协作系统或内部非敏感数据管理。
强制访问控制 (MAC - Mandatory Access Control)
- 概念:系统根据主体(用户/进程)和客体(资源)的固定安全标签(如密级:公开、机密、绝密)来强制决定访问权限,用户无权自行更改。
- 特点:集中式管理,基于严格的安全策略(如著名的 BLP 保密模型和 Biba 完整性模型)强制执行。
- 优点:安全性极高,能有效防止内部威胁和权限滥用,提供高度的一致性和合规性保障。
- 缺点:实现复杂,灵活性极差,管理成本高,普通用户无法参与权限分配。
- 适用场景:高安全性需求和严格合规性要求的环境,如军事、政府、金融核心系统或医疗设备。
基于角色的访问控制 (RBAC - Role-Based Access Control)
- 概念:权限不直接分配给具体用户,而是先分配给“角色”,用户通过被赋予一个或多个角色来间接获得相应权限。
- 特点:以角色为中心,实现了用户与权限的逻辑解耦(如系统管理员、编辑、普通访客)。
- 优点:极大简化了权限管理,易于理解和实施;支持职责分离(SoD),非常适合人员流动频繁的中大型组织。
- 缺点:灵活性较差,难以处理复杂的、动态的权限需求(如“仅允许在工作时间从公司 IP 访问”);当业务复杂时,容易导致“角色爆炸”(Role Explosion),即角色数量激增难以维护。
- 适用场景:大多数企业级应用、后台管理系统、组织架构清晰且权限相对固定的业务系统。
基于属性的访问控制 (ABAC - Attribute-Based Access Control)
- 概念:通过评估与访问请求相关的多重属性(包括**主体属性**、客体属性、环境属性**如时间/IP、以及**操作属性),动态地决定是否允许访问。
- 特点:细粒度、动态、策略驱动。NIST 对其有专门的标准化指南(如 SP 800-162),常使用 XACML 等策略语言来描述规则。
- 优点:极其灵活,支持高度复杂的动态访问控制需求,细粒度控制能力极强,能适应云环境和分布式系统的复杂场景。
- 缺点:策略设计和系统实现复杂,策略评估会带来一定的性能开销,且对管理员的策略管理能力要求较高。
- 适用场景:云计算环境、SaaS 多租户系统、跨组织协作以及需要动态、细粒度权限控制的现代分布式系统。
其他衍生与新兴访问控制模型
除了上述四大核心模型,实际应用中还会根据特定需求使用以下模型:
- 基于规则的访问控制 (Rule-Based Access Control):根据系统预定义的全局规则(如防火墙的 ACL 规则、特定时间段禁止访问)来决定访问,常作为 MAC 或 RBAC 的补充来添加上下文逻辑。
- 基于任务的访问控制 (TBAC - Task-Based Access Control):权限与特定的工作流或任务状态动态绑定。当用户开始执行某项任务时临时授予权限,任务完成或超时后自动撤销,适用于审批流或工单系统。
- 基于组织的访问控制 (OBAC - Organization-Based Access Control):在传统模型基础上扩展,将组织结构、组织策略和安全需求纳入考量,适用于复杂的多组织或跨企业协作环境。
- 下一代访问控制 (NGAC - Next Generation Access Control):由 NIST 提出的一种高度抽象的访问控制模型,旨在通过统一的图结构来管理用户、资源和策略,解决 ABAC 和 RBAC 在超大规模系统中的策略管理复杂性问题。
现代主流操作系统用什么访问控制模型
现代主流操作系统(Windows、Linux、macOS)在访问控制方面,都没有单一地使用某一种理论模型,而是采用了**混合访问控制架构**。它们通常以**自主访问控制(DAC)** 为基础,并在此基础上引入了**强制访问控制(MAC)** 或**基于角色的访问控制(RBAC)** 的思想,以弥补 DAC 在安全性上的不足。
以下是这三个操作系统具体使用的访问控制模型及底层技术实现的详细解析:
Linux 系统
Linux 的访问控制演进非常典型,完美展示了从基础 DAC 到高级 MAC 的扩展。
- 基础模型:自主访问控制 (DAC)
- 传统 Unix 权限 (UGO):最基础的
rwx(读、写、执行)权限,针对所有者 (User)、所属组 (Group) 和其他人 (Others)。这是典型的 DAC,文件所有者可以使用chmod或chown自由更改权限。 -
POSIX ACL (Access Control Lists):作为传统 UGO 的扩展,允许为特定的用户或组设置更细粒度的权限(如
setfacl和getfacl命令),但本质上仍属于 DAC 范畴,因为所有者仍可修改这些 ACL。 -
高级模型:强制访问控制 (MAC) 由于 DAC 无法防止特权用户(如 root)的滥用或受损进程的恶意行为,Linux 引入了 LSM (Linux Security Modules) 内核框架,允许加载不同的 MAC 策略模块:
- SELinux (Security-Enhanced Linux):由 NSA 开发,是 Linux 上最强大的 MAC 实现。它主要使用**类型强制 (Type Enforcement, TE)**,为所有进程和文件分配安全上下文(标签),访问决策由内核根据集中定义的策略强制做出,即使 root 用户也无法绕过。
- AppArmor:Ubuntu 等发行版默认使用。它是一种基于**路径**的 MAC 实现,通过配置文件限制特定应用程序可以访问的文件、网络和能力 (Capabilities)。相比 SELinux,它更易配置和管理。
-
其他 MAC 模块:如 Smack、TOMOYO Linux 等。
-
补充机制:能力机制 (Capabilities)
- 将传统的超级用户 (root) 权限细分为多个独立的“能力”(如
CAP_NET_ADMIN仅允许网络管理,CAP_SYS_TIME仅允许修改系统时间)。这是一种细粒度的权限分离机制,常用于容器(如 Docker)的安全隔离。
Windows 系统
Windows 的访问控制设计高度结构化,主要围绕其对象管理器 (Object Manager) 和安全引用监视器 (Security Reference Monitor, SRM) 展开。
- 基础模型:自主访问控制 (DAC)
-
ACL (访问控制列表):Windows 的核心访问控制机制。每个安全对象(文件、注册表项、进程等)都有一个安全描述符 (Security Descriptor),其中包含:
- DACL (Discretionary ACL):自主访问控制列表,定义了哪些用户/组被允许或拒绝访问该对象。对象所有者可以修改 DACL。
- SACL (System ACL):系统访问控制列表,用于审计,记录哪些访问尝试需要被记录到安全日志中。
-
高级模型:强制访问控制 (MAC) 的变体
-
MIC (Mandatory Integrity Control, 强制完整性控制):从 Windows Vista 引入。它为进程和对象分配“完整性级别”(如 Low、Medium、High、System)。MAC 规则强制规定:低完整性级别的进程不能写入或修改高完整性级别的对象(即“下不能写上”)。这是 Windows UAC(用户账户控制)和 IE/Edge 保护模式的核心底层机制,有效防止了恶意软件提权。
-
管理模型:基于角色的访问控制 (RBAC) 思想
- 虽然 Windows 底层是 DAC,但在管理层面(如 Active Directory 域环境),广泛使用**用户组 (Groups)** 和**组策略 (Group Policy)**。管理员将权限分配给“角色”(如 Domain Admins、Print Operators),再将用户加入这些组,这在实际应用中实现了 RBAC 的管理便利性。
macOS 系统
macOS 继承自 BSD Unix,因此其底层与 Linux 类似,但苹果在其上构建了极具自身特色的、面向应用生态和隐私保护的强制控制体系。
- 基础模型:自主访问控制 (DAC)
-
与 Linux 一样,macOS 支持标准的 Unix
rwx权限和 POSIX ACL。用户可以通过chmod等命令管理自己文件的权限。 -
高级模型:强制访问控制 (MAC) 与沙盒
- Sandbox (沙盒):macOS 应用(尤其是 Mac App Store 中的应用)被强制要求在沙盒中运行。沙盒使用基于 Seatbelt 的 MAC 策略,严格限制应用只能访问其自身的容器目录和明确声明需要的系统资源。
- TCC (Transparency, Consent, and Control):这是 macOS 特有的、面向用户的 MAC 机制。当应用尝试访问敏感资源(如麦克风、摄像头、位置、通讯录、桌面文件夹)时,系统会强制拦截并弹出提示,要求用户明确“同意”。即使用户是管理员,未经 TCC 授权,进程也无法访问这些受保护的资源。
- AMFI (Apple Mobile File Integrity) 与代码签名:macOS 强制要求可执行文件必须经过苹果签名。系统通过检查代码签名中的 Entitlements (权利/授权) 来决定该应用是否有资格调用受保护的内核 API 或访问特定硬件。这也是一种强制性的访问控制。
三大系统访问控制模型对比总结
| 操作系统 | 基础访问控制模型 | 核心底层技术实现 | 高级/强制访问控制 (MAC) 实现 | 特色补充机制 |
|---|---|---|---|---|
| Linux | DAC | Unix UGO 权限, POSIX ACL | SELinux, AppArmor (通过 LSM 框架) | Capabilities (能力机制), Namespaces (容器隔离) |
| Windows | DAC | DACL (自主访问控制列表) | MIC (强制完整性控制, Integrity Levels) | Active Directory 组策略 (RBAC 思想), SACL (审计) |
| macOS | DAC | Unix UGO 权限, POSIX ACL | Sandbox (沙盒), TCC (隐私同意控制) | Code Signing (代码签名), Entitlements (权利授权) |
访问控制的分类
垂直访问控制
垂直访问控制是一种机制,它允许只对特定类型的用户才能访问一些敏感的功能。
通过垂直访问控制机制,不同类型的用户可以访问不同的应用程序功能。例如,管理员可以修改或删除任何用户的账户,而普通用户则无法执行这些操作。垂直访问控制是一种更为精细的安全机制,旨在强制执行诸如职责分离和最小权限等业务政策。
水平访问控制
水平访问控制是一种机制,它允许将资源的访问权限限制在特定用户身上。
在水平访问控制中,不同的用户只能访问同一类型资源中的一部分。例如,一个银行应用程序允许用户查看自己的交易记录并支付款项,但无法访问其他用户的账户信息。
上下文依赖的访问控制
基于上下文的访问控制能够根据应用程序的状态或用户与其交互的情况来限制对功能和资源的访问。
基于上下文的访问控制可以防止用户以错误的顺序执行操作。例如,一个零售网站可以阻止用户在支付完成后仍然修改购物车中的商品内容。
访问控制被破坏的示例
当用户能够访问本不应被允许的资源或执行某些操作时,就会存在安全漏洞。
垂直权限提升
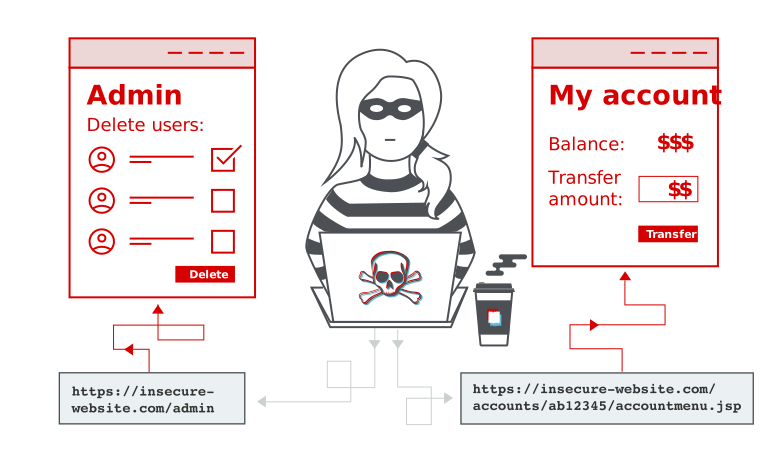
如果某个用户能够访问那些他们无权访问的功能,那么这就是垂直方向上的权限提升行为。例如,如果一个非管理员的用户能够访问管理员页面,并删除用户账户,那么这也属于垂直方向上的权限提升。
无保护的功能
最简单地说,垂直权限提升现象发生在应用程序没有对敏感功能实施任何保护的情况下。例如,管理功能可能被绑定到管理员欢迎页面上,而用户欢迎页面则没有这样的功能。不过,用户仍然可以通过访问相关的管理 URL 来访问这些管理功能。
例如,一个网站可能会将敏感功能部署在以下 URL 地址上:
这个链接可能可以被任何用户访问,而不仅仅是那些在用户界面中拥有相关链接的管理员用户。在某些情况下,管理员的访问链接也可能在其他地方被公开,比如robots.txt文件。
即使该 URL 没有任何公开的信息,攻击者仍然可以利用字典通过暴力破解的方式找到敏感功能的位置。
在某些情况下,可以通过为敏感功能分配一个不太容易预测的 URL 来隐藏它们。这就是所谓的“通过隐蔽性来实现安全保护”的方法。然而,这种隐藏敏感功能的方式并不能提供有效的访问控制,因为用户可能会通过多种方式来找到那个被混淆的 URL。
想象一个应用程序,它可以在以下 URL 地址处执行各种管理功能:
这可能无法被攻击者直接猜测到。不过,应用程序仍然可能会将 URL 泄露给用户。这个 URL 可能会出现在基于用户角色的界面构建过程中所使用的 JavaScript 代码中。
<script>
    var isAdmin = false;
    if (isAdmin) {
        ...
        var adminPanelTag = document.createElement('a');
        adminPanelTag.setAttribute('href', 'https://insecure-website.com/administrator-panel-yb556');
        adminPanelTag.innerText = 'Admin panel';
        ...
    }
</script>
此脚本会在用户为管理员时在其用户界面中添加一个链接。不过,包含该链接的页面对所有用户都是可见的,无论用户的角色是什么。
基于参数的访问控制方法
一些应用程序会在用户登录时确定其访问权限或角色,然后将这些信息存储在一个由用户可访问的位置中。这可能包括:
- 一个隐藏的字段
- 一个 Cookie
- 预定义的查询字符串参数
该应用程序会根据提交的数值来做出访问控制决策。例如:
https://insecure-website.com/login/home.jsp?admin=true
https://insecure-website.com/login/home.jsp?role=1
这种方法存在安全性问题,因为用户可以修改数据从而绕过权限控制,比如管理功能。
配置错误导致权限控制有误
一些应用程序在平台层面实施访问控制。它们通过根据用户的角色来限制对特定 URL 和 HTTP 方法的访问来实现这一点。例如,某个应用程序可以配置如下规则:
这条规则禁止管理组中的用户访问 URL /admin/deleteUser 中的 POST 方法。在这种情况下,可能会出现各种问题,从而导致访问权限被绕过。
一些应用程序框架支持各种非标准的 HTTP 头部字段,这些字段可以用来覆盖原始请求中的 URL 参数,例如 X-Original-URL 和 X-Rewrite-URL 。如果某个网站通过严格的前端控制机制来限制基于 URL 的访问,但应用程序允许通过请求头部来覆盖这些 URL 参数,那么就有可能使用类似的请求来绕过访问控制。
另一种攻击方式与请求中使用的 HTTP 方法有关。前面章节中提到的前端控件是根据 URL 和 HTTP 方法来限制访问的。有些网站在执行某些操作时允许使用不同的 HTTP 请求方法。如果攻击者能够使用 GET (或其他方法)对受限制的 URL 执行操作,他们就可以绕过平台层所实施的访问控制机制。
Note
该攻击能够成功的本质在于:没有做到**路径与方法的强绑定**,常见原因可能如下:
- 鉴权拦截器/过滤器的规则遗漏
 // 伪代码:只拦截了 POST 请求的删除操作
 if (request.getRequestURI().equals("/admin/deleteUser") && request.getMethod().equals("POST")) {
     checkAdminPermission(); // 校验管理员权限
 }
此时开发者只对POST方法的/admin/deleteUser端点进行了权限校验
- Web框架路由配置的过度宽容
现代 Web 框架(如 Spring MVC、Express、Django 等)在处理路由映射时,如果开发者没有显式绑定 HTTP 方法,框架往往会默认支持所有标准 HTTP 方法,比如Spring框架的@PostMapping("/admin/deleteUser"),框架在底层只会为 POST 方法注册路由。此时用 GET 或 PUT 请求会直接返回 405 Method Not Allowed,无法绕过;但若使用@RequestMapping("/admin/deleteUser"),Spring 默认会将其映射到 GET, POST, HEAD, OPTIONS, PUT, PATCH, DELETE, TRACE 等所有方法
- HTTP方法覆盖
由于某些老旧浏览器或网络环境不支持 PUT 或 DELETE 方法,许多 Web 框架(如 Spring、Laravel、Ruby on Rails)提供了**方法覆盖机制**:允许客户端发送 POST 请求,但通过特定的 HTTP Header 或表单参数来“伪装”成其他方法
示例1:
示例2:
可以分别通过请求头X-HTTP-Method-Override和参数_method来实现请求方法覆盖,后端鉴权时会先判断原有的请求头,但最终会被新的请求头覆盖
由于URL匹配方式存在差异导致权限控制有误
网站在匹配传入请求与指定端点的匹配程度方面可能存在差异。例如,有些网站允许大小写不一致的情况,因此向 /ADMIN/DELETEUSER 发出的请求仍可能被映射到 /admin/deleteUser 这个端点。而如果访问控制机制不够严格,它可能会将这两种情况视为不同的端点,从而无法有效实施正确的限制措施。
如果使用 Spring 框架的开发者启用了 useSuffixPatternMatch 选项,同样可能会出现类似的问题。这个选项允许将带有任意文件扩展名的路径映射到没有文件扩展名的等效端点。换句话说,对 /admin/deleteUser.anything 的请求仍然会匹配 /admin/deleteUser 模式。在 Spring 5.3 之前,这个选项是默认启用的。
在其他系统中,可能会遇到关于 /admin/deleteUser 和 /admin/deleteUser/ 是否应被视为独立端点的问题。在这种情况下,可以通过在路径末尾添加一个斜杠来绕过访问限制。
Note
在 HTTP 协议规范(RFC 3986)层面,/admin/deleteUser 和 /admin/deleteUser/ 始终是两个不同的 URI。
但在实际中,/admin/deleteUser 和 /admin/deleteUser/ 是否会被认为是两个独立端点取决于多个因素:
- Web框架设置
- 重定向设置(有些开发者为了用户体验,即使用户访问了
/admin/deleteUser/,也会重定向到/admin/deleteUser,但这并不存在权限绕过,因为服务端仍然认为这两个是独立的端点) - 反向代理和API网关层设置,比如Nginx:
location /admin/deleteUser:会匹配/admin/deleteUser,也会匹配/admin/deleteUser/xxx;location = /admin/deleteUser:精确匹配,不匹配/admin/deleteUser/;location /admin/deleteUser/:只匹配以该路径开头的请求
水平权限提升
当用户能够访问属于其他用户的资源,而不是自己的资源时,就发生了横向权限提升。例如,如果一名员工能够访问其他员工的记录以及自己自身的记录,那么这就是横向权限提升的行为。
水平权限提升攻击可能会使用与垂直权限提升类似的攻击手段。例如,用户可以使用以下 URL 来访问自己的账户页面:
如果攻击者将 id 参数的值修改为另一个用户的数值,他们就有可能访问该用户的账户页面,并获取相关的数据和功能。
在某些应用中,那些可以被利用的参数并没有固定的取值。例如,应用程序可能会使用全局唯一标识符来标识用户,而不是使用递增的数字。这样就能防止攻击者猜测或预测其他用户的标识符。不过,其他用户的标识符也可能在应用程序的其他地方被披露,比如用户的信息或评价中。
Note
最典型的用户唯一性标识是UUID,UUID本身无法被猜测出来,但如果你可以通过你有权访问的其他路由获取其他用户的UUID,那么可以尝试用其他用户的UUID进行替换,从而访问到其他用户的资料
在某些情况下,应用程序能够检测到用户未被允许访问该资源,并会返回登录页面进行重定向。然而,包含重定向请求的响应中仍可能包含一些属于目标用户的敏感数据,因此攻击仍然有效。
由水平权限提升到垂直权限提升
通常,通过利用某个具有更高权限的用户,水平方向上的权限提升攻击可以转化为垂直方向上的权限提升。例如,水平方向上的权限提升可能使攻击者能够重置或获取其他用户的密码。如果攻击者选择攻击一个管理型用户并获取其账户权限,那么他们就可以获得管理级访问权限,从而实现垂直方向上的权限提升。
攻击者可能通过类似上述提到的横向权限提升技术中的参数篡改手段,获取另一个用户账户页面的访问权限。
如果目标用户是应用程序管理员,那么攻击者就可以访问管理账户页面。该页面可能会显示管理员的密码,或者提供修改密码的方法,甚至可能直接访问一些特权功能。
不安全的直接对象引用
不安全的直接对象引用是一种访问控制漏洞。当应用程序使用用户提供的输入直接访问对象时,如果存在攻击者能够修改输入数据以获取未经授权的访问权限,那么就会引发这种漏洞。这一漏洞因在 2007 年 OWASP 十大漏洞中被提及而广为人知。这只是众多可能导致访问控制被绕过的技术错误中的一个例子而已。IDOR 漏洞通常会导致横向权限提升,但也可能引发纵向权限提升的问题。
直接应用数据库对象的IDOR漏洞
假设有一个网站,它通过以下 URL 地址来访问客户账户页面,该地址从后端数据库中提取相关信息:
在这里,客户编号被直接用作在后端数据库上执行查询时的记录索引。如果没有其他控制措施,攻击者可以简单地修改 customer_number 的值,从而绕过访问控制,查看其他客户的记录。这就是一个典型的 IDOR 漏洞导致横向权限提升的例子。
攻击者可以通过修改用户的权限,使其拥有更多的特权,从而实现横向和纵向的权限提升。此外,攻击者还可能利用密码泄露的漏洞,或者在成功进入用户的账户页面后,修改相关参数。
静态文件中的IDOR漏洞
IDOR 漏洞通常出现在服务器端的文件系统中,当敏感资源被存储在静态文件中时。例如,一个网站可能会将聊天记录保存到磁盘中,并且使用递增的文件名来存储这些文件。用户可以通过访问类似以下的 URL 来获取这些文件:
在这种情况下,攻击者只需修改文件名,就能获取其他用户生成的登录信息,进而获取用户的密码和其他敏感数据。
Note
在Restful请求风格的网站中,还可能存在如/users/<user_id>/delete等路由,此时也可以修改路径中的userid,看是否存在IDOR漏洞
多步骤流程中的访问控制漏洞
许多网站通过一系列步骤来实现重要的功能。这种情况常见于:
- 需要收集各种不同的输入或选项。
- 用户在执行操作之前需要审核并确认相关细节。
例如,更新用户信息的行政操作可能包括以下步骤:
- 填写包含特定用户信息的表单。
- 提交这些更改。
- 请审核这些更改,并确认无误后予以批准。
有时候,一些网站会对这些步骤中的某些环节实施严格的访问控制,而忽略其他步骤。想象一个网站,它对第一步和第二步实施了正确的访问控制,但对第三步却如此。该网站认为,只有当用户已经成功完成前两步后,才能访问第三步。因此,攻击者可以通过跳过前两步,直接提交包含所需参数的第三步请求,从而获取对该功能的未经授权的访问权限。
成因分析
多步骤业务流程(如电商支付、密码重置、订单审批、用户注册等)中的访问控制绕过,是业务逻辑漏洞中最常见且危害最大的一类。其根本成因在于:服务端将"流程的完整性"和"步骤的合法性"交由客户端来保证,而自身缺乏对业务状态机的严格校验。
步骤跳跃——前置状态校验缺失
这是最典型、最高频的成因。多步骤流程在服务端本质上是一个**有限状态机(FSM)**,每个步骤的合法执行都依赖于前序步骤的完成状态。如果服务端没有校验"当前用户是否已经合法完成了上一步",攻击者就可以直接调用后续步骤的接口。
- 典型场景:电商支付流程
- 典型场景:密码重置流程
token 和 new_password 参数,但**没有校验 Step2 的验证码是否已被正确验证**。
* 攻击方式:攻击者直接请求 Step3 接口,传入一个猜测的或过期的 token,如果服务端未校验 token 的"已验证"状态标记,密码即被重置。
客户端状态信任——隐藏字段与前端控制
开发者错误地将流程的当前状态存储在客户端(如隐藏表单字段、Cookie、JWT Claims 或 URL 参数中),并信任客户端传回的值。
-
漏洞成因:
HTML服务端在 Step3 处理时,直接读取<!-- Step 2 的表单中 --> <input type="hidden" name="step" value="2"> <input type="hidden" name="is_vip" value="false"> <input type="hidden" name="discount_applied" value="true">request.getParameter("discount_applied")来决定是否打折,而**没有从服务端数据库或 Session 中重新查询该用户的真实状态**。 -
攻击方式:攻击者使用 Burp Suite 拦截请求,将
is_vip改为true,或将discount_applied改为true,即可绕过业务规则。
会话与资源绑定不足(跨用户/跨订单操作)
在多步骤流程中,服务端没有将当前操作与**发起该流程的特定用户会话**进行强绑定,导致攻击者可以操纵其他用户的流程实例。
-
漏洞成因: 假设审批流程中,Step2 的接口为
/api/approve?orderId=10086。服务端只校验了"当前用户是否有审批权限",但**没有校验订单 10086 是否属于当前用户的审批队列**,或者**没有校验该订单是否仍处于"待审批"状态**。 -
攻击方式(IDOR 变体): 攻击者遍历
orderId参数,审批或拒绝不属于自己的订单;或者将一个已经"已完成"的订单重新拉回到"待审批"状态进行二次操作。
流程状态回退(State Regression)
攻击者通过重新调用前序步骤的接口,将已经推进到后续阶段的业务流程**强制回退**到早期状态,从而绕过后续步骤中新增的安全校验。
- 典型场景:
- 漏洞成因:Step4 生效时,系统会校验"管理员是否审核通过"。但 Step1 的接口没有校验"该申请是否已经处于审核中或已通过状态"。
- 攻击方式:攻击者在 Step2 审核通过后,重新调用 Step1 的接口修改申请内容(如将金额从 100 改为 10000),由于 Step1 没有状态锁,数据被覆盖。随后 Step3 确认时,系统使用的是被篡改后的数据。
条件竞争(Race Condition / TOCTOU)
在多步骤流程的关键状态转换节点,如果服务端没有使用数据库事务或分布式锁,并发请求可能导致流程状态出现不一致。
- 典型场景:优惠券使用
- 漏洞成因:Step1 和 Step2 之间存在时间窗口(Time-of-Check to Time-of-Use, TOCTOU)。服务端在 Step1 校验优惠券有效后,在 Step2 扣减之前,没有对优惠券记录加锁。
- 攻击方式:攻击者使用多线程工具(如 Turbo Intruder)同时发送 50 个 Step2 的请求。由于所有请求在 Step1 的校验都通过了(优惠券尚未被扣减),最终 50 个请求全部成功,一张优惠券被使用了 50 次。
参数污染与步骤间数据不一致
多步骤流程中,数据往往在步骤之间传递。如果服务端在每一步都从客户端重新接收关键参数(而非从服务端存储中读取),攻击者可以在不同步骤中传入**相互矛盾的数据**。
- 典型场景:
- Step1:攻击者选择商品 A(价格 10 元),服务端生成订单。
- Step2:攻击者在确认订单的请求中,将
productId篡改为商品 B(价格 10000 元),但price字段仍保留 10 元。 - 漏洞成因:Step2 的服务端逻辑只校验了
price > 0,而**没有重新查询数据库中商品 B 的真实价格**进行交叉比对。
异常流程与边界条件处理不当
开发者通常只关注"正常路径(Happy Path)"的访问控制,而忽略了异常分支的安全校验。
- 典型场景:
- 取消后重试:用户在 Step3 支付失败后取消订单,随后重新发起支付。如果服务端没有重新校验 Step1 和 Step2 的数据有效性(如库存是否仍然充足、价格是否已变更),攻击者可能以旧价格完成支付。
- 超时后继续:流程设置了 30 分钟超时,但 Step3 的接口没有校验流程是否已过期,攻击者在超时后仍可完成操作。
防御架构建议
| 防御层面 | 具体措施 |
|---|---|
| 状态机设计 | 在服务端显式建模业务流程的状态机(如使用 Spring StateMachine),每个步骤的接口必须校验"当前状态是否允许转换到目标状态" |
| 服务端状态存储 | 流程的关键状态(如"已验证"、"已审核"、"已锁定")必须存储在**服务端 Session 或数据库**中,严禁信任客户端传回的状态值 |
| 数据锚定 | 每个步骤的关键业务数据(如价格、数量、用户 ID)必须从**服务端数据库实时查询**,而非从请求参数中读取 |
| 幂等与防重 | 为每个流程实例生成唯一的 flowId / nonce,并在服务端校验其唯一性和一次性,防止步骤重放 |
| 并发控制 | 在状态转换的关键节点使用**数据库行锁**(SELECT ... FOR UPDATE)或**分布式锁**(如 Redis Redlock),消除竞态条件 |
| 全链路鉴权 | 不要只在"入口"做权限校验,**每一个步骤的接口**都必须独立校验:① 用户身份 ② 资源归属 ③ 流程状态 ④ 数据一致性 |
多步骤业务流程的访问控制本质上是一个**分布式状态管理问题**。只有将"状态校验"的责任完全收归服务端,并在每一步都执行"零信任"式的完整断言,才能从根本上杜绝此类漏洞。
基于Referer的访问控制
一些网站通过 HTTP 请求中提交的 Referer 头部信息来实施访问控制。浏览器可以在请求中添加 Referer 头部信息,以表明是由哪个页面发起的请求。
例如,某个应用程序在主要管理页面 /admin 上严格执行访问控制机制,但对于像 /admin/deleteUser这样的子页面,则只检查 Referer 头信息。如果 Referer 头信息中包含主要的 /admin URL,那么该请求就会被允许。
在这种情况下, Referer 头部完全可以被攻击者控制。这意味着他们可以通过提供所需的 Referer 头部,伪造对敏感子页面的请求,从而获取未经授权的访问权限。
基于地址位置的访问控制
一些网站会根据用户的地理位置来执行访问控制。例如,在银行应用程序或媒体服务中,由于法律法规或商业限制的原因,可能会实施这种访问控制。不过,通过使用网络代理、VPN,或者操纵客户端的位置识别机制,通常可以绕过这些访问控制措施。
如何防御访问控制漏洞
通过采用纵深防御的方法并遵循以下原则,可以防范访问控制方面的漏洞:
- 永远不要仅依靠混淆技术来实现访问控制。
- 除非某个资源是供公众访问的,否则应默认拒绝访问。
- 在可能的情况下,采用一种适用于整个应用程序的访问控制机制。
- 在代码层面,必须要求开发者明确每个资源所允许的访问权限,并默认拒绝其他访问请求。
- 对访问控制机制进行彻底的审核和测试,以确保其按预期发挥作用。