Others
Grsecurity And Pax
gsecurity 是 Linux 内核的一组修补程序, 重点是增强安全性。除其他外, 它允许系统管理员为系统定义最小特权策略, 在该策略中, 每个进程和用户只有运行所需的最低权限
典型应用是在Web服务器和系统中接受来自不受信任位置的远程连接,例如为其用户提供shell访问的系统
同grsecurity一起使用的主要组件是PaX,标记数据存储器,如堆栈上的数据存储器,不可执行,以及程序存储器不可写。 防止可执行内存页被注入的代码覆盖,从而防止利用许多类型的安全漏洞,例如缓冲区溢出。
PaX还提供地址空间布局随机化(ASLR),它随机化重要的内存地址,以阻止依赖这些地址的攻击。
PaX本身不是由grsecurity开发人员开发的,可以独立于grsecurity。
grsecurity的另一个组成部分是它提供了一个完整的基于角色的访问控制(RBAC)系统。 RBAC旨在限制对通常由Unix访问控制列表提供的系统的访问,目的是创建一个完全最小权限的系统,其中用户和进程具有正常工作的绝对最小权限,仅此而已。 这样,如果系统受到攻击,攻击者破坏或获取系统上敏感信息的能力可以大大降低。
RBAC通过一系列“角色”进行工作。 每个角色都可以对他们能做什么或不能做什么有限制,这些角色和限制形成一个“政策”,可以根据需要进行修改。grsecurity以各种方式限制chroot,以防止各种漏洞,特权升级攻击,以及添加额外的检查和平衡。
grsecurity还为内核添加增强的审计(auditing)功能。为审核一个特定用户组,审核设备的安装/卸载,系统时间和日期的更改,chdir日志记录等。其他一些事情允许管理员也记录被拒绝的资源尝试,失败的fork尝试和带参数的exec日志记录。
可信路径执行是另一个可选功能,可用于防止用户执行非root用户拥有的二进制文件,或者为可写的。这有助于防止用户执行他们自己的恶意二进制文件或意外执行可能已被恶意用户修改的系统二进制文件(可全球写入)。
grsecurity也加强了chroot“jails”工作的方式。可以使用chroot的jails将特定进程与系统的其余部分隔开来,如果服务受到损害,可以使用chroot监控,完成最小化损坏的可能。
TOMOYO Linux
与AppArmor一样,TOMOYO是另一个基于Path的MAC实现,Linux 2.6.30版本首次合入。TOMOYO是专为嵌入式系统设计的,允许安全管理员在测试时记录所有的用户进程交互,从而根据开发、测试期间互相看见的进程才能够交互。如果使用了TOMOYO策略的系统,落入不可信的用户或敌对环境中,用户态进程仅执行那些之前允许的交互,简化了策略生成。
SMACK
Smack(Simplified Mandatory Access Control Kernel)是Casey Schaufler[15]于2007年在LSM基础上实现的Linux强制访问控制安全模块,它以内核安全补丁的形式存在于Linux操作系统中,其设计思想是利用LSM安全域将Linux内核中所有主体与客体都打上安全标签,并规定安全策略,只有符合安全策略的访问方式才被容许。与SELinux和DTE相比,Smack安全策略要简单得多,但却能实现它们相似的强制访问控制功能,并且Smack对内核性能损耗比较低,因此,Smack也逐渐被业界看好和推广
SMACK语法主要分为五种:subject(访问控制学习者) 、object(被控资源) 、rule(指定具体规则) 、privileged rule(权限规则) 、action(允许执行操作)。可以通过这五种语法设置具体的权限访问规则。
例如,使用下面的语法,可以在传统的linux DAC上指定一条权限规则,表示user1类型的安全主体可以访问object1类型的安全对象:
以上就是我们对Linux中的SMACK安全模型的介绍,SMACK模型是用mandatory access control(MAC)方式实现安全性,可以通过指定的权限规则来实现系统中资源的访问权 or 以及操作的执行权。SMACK安全模型可以弥补Linux DAC和SELinux等技术的空白,为弱安全性环境提供了额外的安全保护。
Yama
Yama,Linux 3.4合入内核的LSM模块,旨在收集主内核没有处理的系统内的DAC安全限制。目前,它支持缩小ptrace()系统调用的范围,阻止通过已经攻击成功的用户进程作为跳板,从相同用户的其它进程中抽取敏感数据信息。
Yama主要是对Ptrace函数调用进行访问控制。
Ptrace是一个系统调用,它提供了一种方法来让‘父’进程可以观察和控制其它进程的执行,检查和改变其核心映像以及寄存器。 主要用来实现断点调试和系统调用跟踪。利用ptrace函数,不仅可以劫持另一个进程的调用,修改系统函数调用和改变返回值,而且可以向另一个函数注入代码,修改eip,进入自己的逻辑。这个函数广泛用于调试和信号跟踪工具。所以说,对ptrace函数进行访问控制还是很有必要的。
Yama一共分为四个等级:
#define YAMA_SCOPE_DISABLED    0
#define YAMA_SCOPE_RELATIONAL    1
#define YAMA_SCOPE_CAPABILITY    2
#define YAMA_SCOPE_NO_ATTACH    3
其中YAMA_SCOPE_DISABLED代表yama并不起任何作用,YAMA_SCOPE_RELATIONAL代表只能ptarce子进程才能进行调试,YAMA_SCOPE_CAPABILITY,拥有CAP_SYS_PTRACE能力的进程才可以使用ptrace。而YAMA_SCOPE_NO_ATTACH代表没有任何进程可以attach,而且只要设置成了3就无法降级了。
StackGuard
首先我们来看一下USENIX上论文中,对StackGuard的描述与介绍:
StackGuard is a compiler extension that enhances the executable code produced by the compiler so that it detects and thwarts buffer-overflow attacks against the stack. The effect is transparent to the normal function of programs. The only way to notice that a program is StackGuard-enhanced is to cause it to execute C statements with undefined behavior: StackGuard-enhanced programs define the behavior of writing to the return address of a function while it is still active.
由此我们知道,StackGuard是一个用来防御缓冲区溢出攻击的方式,一般在 编译器里实现,它的存在对函数调用是没有直接影响的。
不过,为了进一步了解它是如何工作的,我们得先来了解一下缓冲区溢出攻击。
缓冲区溢出攻击
缓冲区溢出(buffer overflow),是针对程序设计缺陷,向程序输入缓冲区写入使之溢出的内容(通常是超过缓冲区能保存的最大数据量的数据),从而破坏程序运行、趁著中断之际并获取程序乃至系统的控制权。
下图是正常的函数调用时,函数调用栈的示意图:
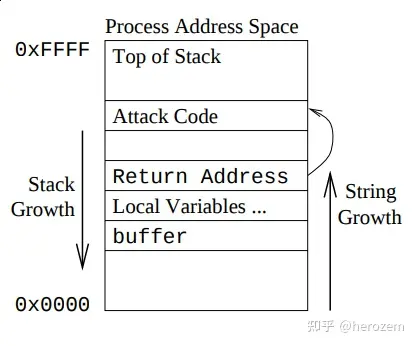
缓冲区异常攻击,需要程序没有检查数组或者指针的边界,因此攻击者可以把 特定的二进制代码写到数组里,覆盖 函数的返回地址,从而执行攻击者的代码。攻击者可以注入类似于 exec("sh") 的代码,这样就为后续的操作奠定了基础。
StackGuard 如何发挥作用
由上图可以看到,缓冲区溢出攻击的核心点在于,由于程序没有检测边界,而攻击者利用这一点,覆盖函数的返回地址。如果我们有办法能检测到 程序是否被修改,就可以作出一定的防御,比如检测到被修改,就退出。
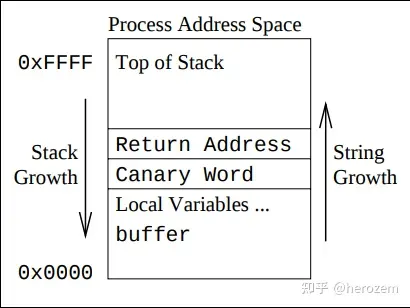
StackGuard的方法很简单,就是往返回地址后面插入一段特殊值(称之为canary),在函数返回之前,首先检查这个 特殊值是否被修改, 如果被修改了,说明发生了缓冲区溢出攻击。更安全的方式是,插入这段特殊值,是随机值。
但是,即便如此,攻击者仍然有办法绕过,那就是不修改这段值,而是直接 修改返回地址,但是这很难做到,因为攻击者无法知道这段随机值到底是多长。另外由于随机化,攻击者也无法轻易复制这一段随机值
Seccomp
Secommp (SECure COMPuting) 是 Linux 内核 2.6.12 版本引入的安全模块,主要是用来限制某一进程可用的系统调用 (system call)。它最初被用于 cpushare 这个项目,让人们可以出租自己空闲的 cpu cycle 来执行 untrusted code。这个 feature 本身并不是一个沙盒 (sandbox),它只是一种减少 Linux 内核暴露的机制,是构建一个安全的沙盒的重要组成部分。
Seccomp Strict Mode
Seccomp 在最初引入的时候只支持了 strict mode,意味着只有 read ,write ,_exit ,_sigreturn 四个 system call 会被允许。一旦出现其他的 system call,进程会被立刻终止 (SIGKILL)。一个简单的例子如下:
#include <stdio.h>
#include <sys/prctl.h>

#include <sys/socket.h>
#include <linux/seccomp.h>


int main(int argc, char* argv[]) {
  printf("Install seccomp\n");
  prctl(PR_SET_SECCOMP, SECCOMP_MODE_STRICT);

  printf("Creating socket\n");
  int sock = socket(AF_INET, SOCK_STREAM, 0);

  return 0;
}
编译并执行,结果如下:
$ g++82 -o seccomp seccomp.c
$ ./seccomp
Install seccomp
Creating socket
Killed
$ echo $?
137
上面的程序在 seccomp 被启动之后有两个系统调用:write 和 socket ,printf 这个函数本质上向 stdout 写了一些 bytes,是被允许的。然而当进程想要创建 socket 的时候,程序就被终止了。我们通过 strace 也能得到相同的结论,附上 strace 的结果:
...
write(1, "Install seccomp\n", 16Install seccomp
)       = 16
prctl(PR_SET_SECCOMP, SECCOMP_MODE_STRICT) = 0
write(1, "Creating socket\n", 16Creating socket
)       = 16
socket(AF_INET, SOCK_STREAM, IPPROTO_IP) = ?
+++ killed by SIGKILL +++
Seccomp Filter Mode (Seccomp-BPF)
strict mode 固然很棒,然而实用性却不高。因为一个复杂的程序根本不可能只用到四个 system call。strict mode 下进程能够完成的任务非常的有限。于是 Linux 又引入了 filter mode,也就是 BPF ( Berkley Packet Filter)。BPF 提供了更高的灵活度,赋予了开发者对于程序更细颗粒度的控制。
Linux 内核实现了一个能够执行 BPF 程序的虚拟机。对于每一次 system call,内核都会执行一遍开发者提供的 BPF 程序,用来确定是否需要过滤 system call。BPF 程序在 c 中表示为一个长度固定的指令数组,定义如下:
struct sock_fprog {
    unsigned short      len;    /* Number of BPF instructions */
    struct sock_filter *filter; /* Pointer to array of BPF instructions */
};
内核的虚拟机会按顺序读取 BPF 指令 ( sock_filter ) ,读取完之后会解码 (decode) 指令并执行指令。指令的定义如下:
struct sock_filter {            /* Filter block */
    __u16 code;                 /* Actual filter code */
    __u8  jt;                   /* Jump true */
    __u8  jf;                   /* Jump false */
    __u32 k;                    /* Generic multiuse field */
};
结合以上所有,我们来看一个具体的例子:
void configure_seccomp() {
  struct sock_filter filter [] = {
    ...
    BPF_STMT(BPF_RET | BPF_K, SECCOMP_RET_KILL)
  };

  struct sock_fprog prog = {
       .len = (unsigned short)(sizeof(filter) / sizeof (filter[0])),
       .filter = filter,
  };

  prctl(PR_SET_NO_NEW_PRIVS, 1, 0, 0, 0);
  prctl(PR_SET_SECCOMP, SECCOMP_MODE_FILTER, &prog);
}
我们之前说过,BPF 代码在 C 中表示成一个指令数组。这个例子只出现了最后一条指令:返回杀死进程,其他的都被省略了。在实际应用中,BPF 代码会更加复杂。
有一点值得注意的是我们一般会设置PR_SET_NO_NEW_PRIVS这个 bit,主要是为了防止 untrusted code 篡改已有 BPF 程序,进而导致安全隐患。
Ptrace
ptrace 函数简介
Ptrace是一个系统调用,它提供了一种方法来让‘父’进程可以观察和控制其它进程的执行,检查和改变其核心映像以及寄存器。 主要用来实现断点调试和系统调用跟踪。利用ptrace函数,不仅可以劫持另一个进程的调用,修改系统函数调用和改变返回值,而且可以向另一个函数注入代码,修改eip,进入自己的逻辑。这个函数广泛用于调试和信号跟踪工具。
ptrace使用场景:
由于ptrace可以跟踪运行进程并修改寄存器与内存,因此可以用于以下用途。
- 黑客利用该特性进行代码注入。
- 不退出进程,进行在线升级。
- 开发追踪调试工具。
函数定义
       #include <sys/ptrace.h>
       long ptrace(enum __ptrace_request request, pid_t pid, void *addr, void *data);
函数参数解释
request:请求执行的行为,可能选择有
- PTRACE_TRACEME //指示父进程跟踪某个子进程的执行。任何传给子进程的信号将导致其停止执行,同时父进程调用wait()时会得到通告。之后,子进程调用exec()时,核心会给它传送SIGTRAP信号,在新程序开始执行前,给予父进程控制的机会。pid, addr, 和 data参数被忽略。
- PTRACE_PEEKTEXT, PTRACE_PEEKDATA //从子进程内存空间addr指向的位置读取一个字,并作为调用的结果返回。Linux内部对文本段和数据段不加区分,所以目前这两个请求相等。data参数被忽略。
- PTRACE_PEEKUSR //从子进程的用户区addr指向的位置读取一个字,并作为调用的结果返回。
- PTRACE_POKETEXT, PTRACE_POKEDATA //将data指向的字拷贝到子进程内存空间由addr指向的位置。
- PTRACE_POKEUSR //将data指向的字拷贝到子进程用户区由addr指向的位置。
- PTRACE_GETREGS, PTRACE_GETFPREGS //将子进程通用和浮点寄存器的值拷贝到父进程内由data指向的位置。addr参数被忽略。
- PTRACE_GETSIGINFO //获取导致子进程停止执行的信号信息,并将其存放在父进程内由data指向的位置。addr参数被忽略。
- PTRACE_SETREGS, PTRACE_SETFPREGS //从父进程内将data指向的数据拷贝到子进程的通用和浮点寄存器。addr参数被忽略。
- PTRACE_SETSIGINFO //将父进程内由data指向的数据作为siginfo_t结构体拷贝到子进程。addr参数被忽略。
- PTRACE_SETOPTIONS //将父进程内由data指向的值设定为ptrace选项,data作为位掩码来解释,由下面的标志指定
- PTRACE_O_TRACESYSGOOD //当转发syscall陷阱(traps)时,在信号编码中设置位7,即第一个字节的最高位。例如:SIGTRAP | 0x80。这有利于追踪者识别一般的陷阱和那些由syscall引起的陷阱。
- PTRACE_O_TRACEFORK //通过 (SIGTRAP | PTRACE_EVENT_FORK << 8) 使子进程下次调用fork()时停止其执行,并自动跟踪开始执行时就已设置SIGSTOP信号的新进程。新进程的PID可以通过PTRACE_GETEVENTMSG获取。
- PTRACE_O_TRACEVFORK //通过 (SIGTRAP | PTRACE_EVENT_VFORK << 8) 使子进程下次调用vfork()时停止其执行,并自动跟踪开始执行时就已设置SIGSTOP信号的新进程。新进程的PID可以通过PTRACE_GETEVENTMSG获取。
- PTRACE_O_TRACECLONE //通过 (SIGTRAP | PTRACE_EVENT_CLONE << 8) 使子进程下次调用clone()时停止其执行,并自动跟踪开始执行时就已设置SIGSTOP信号的新进程。新进程的PID可以通过PTRACE_GETEVENTMSG获取。
- PTRACE_O_TRACEEXEC //通过 (IGTRAP | PTRACE_EVENT_EXEC << 8) 使子进程下次调用exec()时停止其执行。
- PTRACE_O_TRACEVFORKDONE //通过 (SIGTRAP | PTRACE_EVENT_VFORK_DONE << 8) 使子进程下次调用exec()并完成时停止其执行。
- PTRACE_O_TRACEEXIT //通过 (SIGTRAP | PTRACE_EVENT_EXIT << 8) 使子进程退出时停止其执行。子进程的退出状态可通过PTRACE_GETEVENTMSG。
- PTRACE_GETEVENTMSG //获取刚发生的ptrace事件消息,并存放在父进程内由data指向的位置。addr参数被忽略。
- PTRACE_CONT //重启动已停止的进程。如果data指向的数据并非0,同时也不是SIGSTOP信号,将会作为传递给子进程的信号来解释。那样,父进程可以控制是否将一个信号发送给子进程。 addr参数被忽略。
- PTRACE_SYSCALL, PTRACE_SINGLESTEP //如同PTRACE_CONT一样重启子进程的执行,但指定子进程在下个入口或从系统调用退出时,或者执行单个指令后停止执行,这可用于实现单步调试。addr参数被忽略。
- PTRACE_SYSEMU, PTRACE_SYSEMU_SINGLESTEP //用于用户模式的程序仿真子进程的所有系统调用。
- PTRACE_KILL //给子进程发送SIGKILL信号,从而终止其执行。data,addr参数被忽略。
- PTRACE_ATTACH //衔接到pid指定的进程,从而使其成为当前进程的追踪目标。
- PTRACE_DETACH //PTRACE_ATTACH的反向操作。
pid:目标进程标识。
addr:执行peek和poke操作的目标地址。
data:对于poke操作,存放数据的地方。对于peek操作,获取数据的地方。
返回说明:
成功执行时,PTRACE_PEEK*请求返回所请求的数据,其它返回0。失败返回-1,errno被设为以下的某个值。由于一个成功的PTRACE_PEEK*请求可能返回-1,决定错误是否发生前,调用者应检查errno。
2. ptrace 函数的内核实现
ptrace的内核实现在kernel/ptrace.c文件中,内核接口是SYSCALL_DEFINE4(ptrace, long, request, long, pid, unsigned long, addr, unsigned long, data),从中可以看到整个代码逻辑比较简单,其中对PTRACE_TRACEME和PTRACE_ATTACH 是做特殊处理的。其他的是与架构相关的。
     1  SYSCALL_DEFINE4(ptrace, long, request, long, pid, unsigned long, addr,
     2          unsigned long, data)
     3  {
     4      struct task_struct *child;
     5      long ret;

     6      if (request == PTRACE_TRACEME) {
     7          ret = ptrace_traceme();
     8          if (!ret)
     9              arch_ptrace_attach(current);
    10          goto out;
    11      }

    12      child = ptrace_get_task_struct(pid);
    13      if (IS_ERR(child)) {
    14          ret = PTR_ERR(child);
    15          goto out;
    16      }

    17      if (request == PTRACE_ATTACH || request == PTRACE_SEIZE) {
    18          ret = ptrace_attach(child, request, addr, data);
    19          /*
    20           * Some architectures need to do book-keeping after
    21           * a ptrace attach.
    22           */
    23          if (!ret)
    24              arch_ptrace_attach(child);
    25          goto out_put_task_struct;
    26      }

    27      ret = ptrace_check_attach(child, request == PTRACE_KILL ||
    28                    request == PTRACE_INTERRUPT);
    29      if (ret < 0)
    30          goto out_put_task_struct;

    31      ret = arch_ptrace(child, request, addr, data);
    32      if (ret || request != PTRACE_DETACH)
    33          ptrace_unfreeze_traced(child);

    34   out_put_task_struct:
    35      put_task_struct(child);
    36   out:
    37      return ret;
    38  }
Firejail
**Firejail**是Linux提供的SUID(设置用户ID)程序,可用于在有限的环境中运行不受信任的应用程序时最大程度地减少系统的安全问题。 Firejail 使用沙箱的概念来最大限度地减少安全问题。
安装Firejail
在使用 Firejail 之前,我们必须使用 apt-get 命令将其安装在我们的系统上。因此,在终端中运行以下命令来安装 Firejail
安装**Firejail**后,您可以通过在终端中运行以下命令来检查它是否安装在您的系统上
如果此命令给出 Firejail 的版本,则说明它已安装。
运行桌面应用程序
到目前为止,我们已经在系统中安装了 Firejail,现在我们将讨论如何使用它在安全的环境中运行不受信任的应用程序。我们可以通过在终端中输入以下命令来运行桌面应用程序
在下图中,我们可以看到当我们在有限环境下运行应用程序时终端窗口的样子
将 Firejail 与桌面集成
那么,如果我们想在有限的环境中从桌面管理器图标运行应用程序,我们必须做什么?
我们可以通过将**Firejail**集成到桌面环境中,从桌面管理器图标运行应用程序。运行以下命令将**Firejail**集成到桌面环境中
运行上述命令后,注销并重新登录
当您运行上述命令时,它将在您的系统上配置一些符号链接,如图所示。
现在,当您从桌面图标或从终端运行任何应用程序而无需在其之前使用 firejail 命令时,它将自动在受限环境中运行。
追踪沙箱
您还可以通过列出所有沙盒应用程序来检查您的应用程序是否在沙盒中运行。运行以下命令列出受限环境中运行的所有应用程序
此命令将列出所有沙盒应用程序
或者,您也可以运行 top 命令和 firejail 来显示 firejail 下运行的所有进程。在终端窗口中运行以下命令以显示所有进程
关闭沙箱
如果沙箱没有响应,您只需键入命令即可从终端窗口将其关闭。首先运行带有 –list 选项的 firejail 命令来列出所有沙箱
列出所有沙箱后,记下要关闭的沙箱的PID并运行以下命令
当您运行上述命令时,它将关闭PID指定的沙箱
私人模式
我们还可以在私人模式下使用**Firejail**。私有模式用于对沙盒程序隐藏主目录中的所有文件。我们可以通过在终端窗口中键入以下命令来启用私人模式
它将在私有模式下运行应用程序。 **Firejail**使用安装在主目录上的临时文件系统,当您关闭沙箱时,在此目录中创建的任何文件都将被删除。我们还可以通过运行以下命令来使用另一个目录作为沙箱
它将把“my_dir”目录设置为 firejail 的主目录。
构建自定义配置文件
我们还可以在 Firejail 中构建自定义配置文件。在本节中,我们将在 Firejail 中创建我们自己的黑名单配置文件。以下是创建黑名单配置文件的过程
创建黑名单配置文件
以下是构建用户定义的配置文件的步骤。首先移动到主目录并在主目录中创建“.config/firejail”目录。创建目录后移动到该目录
现在,通过运行以下命令将默认安全配置文件复制到此目录中
“app”文件的名称必须与应用程序的名称相同,扩展名为.profile。例如,如果您想为 firefox 构建自定义配置文件,则文件名必须是“firefox.profile”。现在通过运行以下命令打开此文件进行修改
现在,如果您想将文档目录列入黑名单,请在此文件中添加以下行
要将下载目录指定为只读,请在此文件中添加以下行
现在您的个人资料就可以使用了。在终端中键入以下命令以在有限环境中运行不受信任的应用程序
现在您的应用程序不能使用文档目录中的任何类型的数据,也不能修改下载目录中的数据。