Shell编程
Shell概述
大数据和全栈工程师程为什么要学习Shell呢?
-
需要看懂运维人员编写的Shell程序。
-
偶尔会编写一些简单Shell程序来管理集群、提高开发效率。
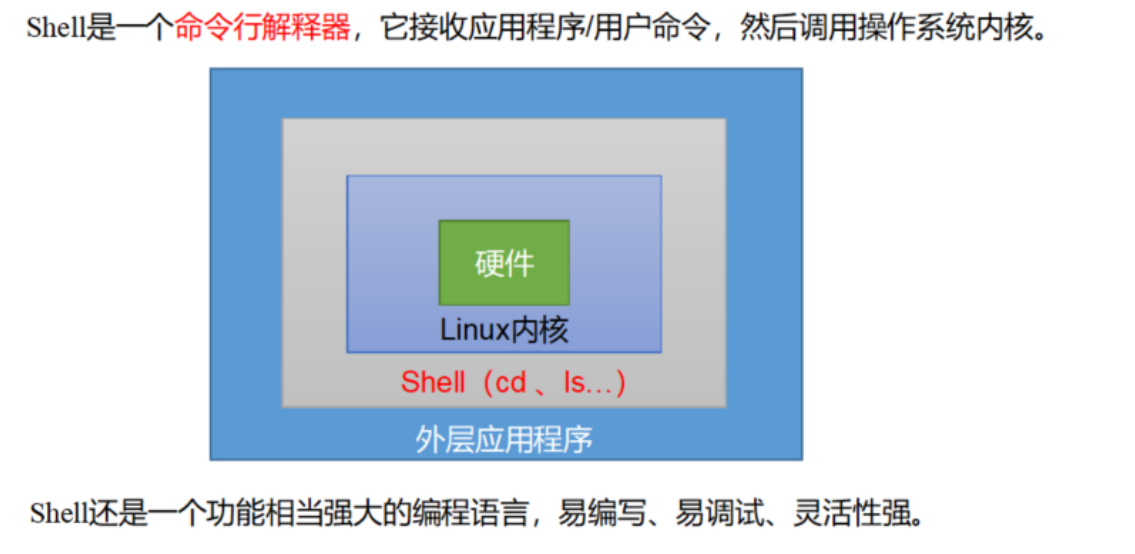
Shell解析器
(1)Linux提供的Shell解析器有:
[laoxiao@hadoop101 ~]$ cat /etc/shells
/bin/sh
/bin/bash
/sbin/nologin
/bin/dash
/bin/tcsh
/bin/csh
(2)bash和sh的关系
[laoxiao@hadoop101 bin]$ ll /bin/ | grep bash
-rwxr-xr-x. 1 root root 941880 5 月 11 2016 bash
lrwxrwxrwx. 1 root root 4 5 月 27 2017 sh -> bash
(3)Centos默认的解析器是bash
Shell脚本入门
脚本格式
脚本以#!/bin/bash开头(指定解析器)
第一个Shell脚本:helloworld
(1)需求:创建一个Shell脚本,输出helloworld
(2)案例实操:
(3)脚本的常用执行方式
第一种:采用bash或sh+脚本的相对路径或绝对路径(不用赋予脚本+x权限)
sh+脚本的相对路径
sh+脚本的绝对路径
bash+脚本的相对路径
第二种:采用输入脚本的绝对路径或相对路径执行脚本(必须具有可执行权限+x)
(a)首先要赋予helloworld.sh 脚本的+x权限
(b)执行脚本
相对路径
**注意:**第一种执行方法,本质是bash解析器帮你执行脚本,所以脚本本身不需要执行权限。第二种执行方法,本质是脚本需要自己执行,所以需要执行权限。
第二个Shell脚本:多命令处理
(1)需求:
在/home/laoxiao/目录下创建一个banzhang.txt,在banzhang.txt文件中增加“I love cls”。
(2)案例实操:
在batch.sh中输入如下内容
Shell中的变量
系统(环境)变量
1. 常用系统变量 : 作用域是整个操作系统或者整个用户,注意:临时的用户环境变量只作用到当前bash及它的 子bash。\(HOME、\)PWD、\(SHELL、\)USER等
2.案例实操
(1)查看系统变量的值
(2)显示当前Shell中所有变量:set
自定义变量
普通变量: 作用域是当前shell(当前的解释器)
基本语法
(1)定义变量:变量=值
(2)撤销变量:unset 变量
(3)声明静态变量:readonly变量,注意:不能unset
变量定义规则
(1)变量名称可以由字母、数字和下划线组成,但是不能以数字开头,环境变量名建议大写。
(2)等号两侧不能有空格
(3)变量的值如果有空格,需要使用双引号或单引号括起来。
案例实操
(1)定义变量A
(2)给变量A重新赋值
(3)撤销变量A
(4)声明静态的变量B=2,不能unset
[laoxiao@hadoop101 datas]$ readonly B = 2
[laoxiao@hadoop101 datas] $ echo $ B
2

[laoxiao@hadoop101 datas]$ B = 9
-bash: B: readonly variable
(5)在bash中,变量默认类型都是字符串类型,无法直接进行数值运算
(6)变量的值如果有空格,需要使用双引号或单引号括起来
[laoxiao@hadoop102 ~]$ D = I love banzhang
-bash: world: command not found

[laoxiao@hadoop102 ~]$ D =" I love banzhang "
[laoxiao@hadoop102 ~] $ echo $ A
I love banzhang
(7)可把变量提升为全局环境变量,可供其他Shell程序使用
记住 : 用户登录之后开启一个解释器bash(一号),当启动一个脚本文件:重新启动一个bash(二号)去执行脚本,二号bash是一号子bash。
export 变量名
在helloworld.sh文件中增加echo $B
发现并没有打印输出变量B的值。
特殊变量:$n
基本语法
\(n (功能描述:n为数字,\)0代表该脚本名称,\(1-\)9代表第一到第九个参数,十以上的参数需要用大括号包含,如${10})
案例实操
(1)输出该脚本文件名称、输入参数1和输入参数2 的值
[laoxiao@hadoop101 datas]$ touch parameter.sh
[laoxiao@hadoop101 datas]$ vim parameter.sh

#!/bin/bash
# $0表示脚本名,$1/$2表示接收的第一/第二个参数,以此类推
echo " $0 $1 $2 "

[laoxiao@hadoop101 datas]$ chmod 777 parameter.sh
[laoxiao@hadoop101 datas]$ ./parameter.sh cls xz
./parameter.sh cls xz
特殊变量:$#
基本语法
$# (功能描述:获取所有输入参数个数,常用于循环)。
案例实操
(1)获取输入参数的个数
[laoxiao@hadoop101 datas]$ vim parameter.sh
#!/bin/bash
echo " $0 $1 $2 "
echo $#

[laoxiao@hadoop101 datas]$ chmod 777 parameter.sh
[laoxiao@hadoop101 datas]$ ./parameter.sh cls xz
parameter.sh cls xz
2
特殊变量:\(\* 和\)@
基本语法
-
\(\* (功能描述:这个变量代表命令行中所有的参数,\)*把所有的参数看成一个整体)
-
\(@ (功能描述:这个变量也代表命令行中所有的参数,不过\)@把每个参数区分对待)
案例实操
(1)打印输入的所有参数
[laoxiao@hadoop101 datas]$ vim parameter.sh

#!/bin/bash
echo " $0 $ 1 $2 "
echo $#
echo $\*
echo $@

[laoxiao@hadoop101 datas]$ bash parameter.sh 1 2 3
parameter.sh 1 2
3
1 2 3
1 2 3
特殊变量:$?
基本语法
$? (功能描述:最后一次执行的命令的返回状态。如果这个变量的值为0,证明上一个命令正确执行;如果这个变量的值为非0(具体是哪个数,由命令自己来决定),则证明上一个命令执行不正确了。)
案例实操
(1)判断helloworld.sh脚本是否正确执行
运算符
基本语法
(1)“\(((运算式))”或“\)[运算式]”
(2)expr + , - , *, /, % 加,减,乘,除,取余
注意:expr运算符间要有空格
2.案例实操:
(1)计算3+2的值
(2)计算3-2的值
(3)计算(2+3)X4的值
(a)expr一步完成计算
(b)采用$[运算式]方式
条件判断
基本语法
[ condition ](注意condition前后要有空格)
注意:条件非空即为true,[ laoxiao ]返回true,[] 返回false。
常用判断条件
两个整数之间比较
- = 字符串比较
-
-lt 小于(less than) -le 小于等于(less equal)
-
-eq 等于(equal) -gt 大于(greater than)
-
-ge 大于等于(greater equal) -ne 不等于(Not equal)
按照文件权限进行判断
- -r 有读的权限(read)
- -w 有写的权限(write)
- -x 有执行的权限(execute)
按照文件类型进行判断
-
-f 文件存在并且是一个常规的文件(file)
-
-e 文件存在(existence)
-
-d 文件存在并是一个目录(directory)
注意:任何命令的执行状态为0则为True,否则为False
条件判断中的运算符
逻辑运算符
-f               判断文件是否存在 eg: if [ -f filename ]
-d               判断目录是否存在 eg: if [ -d dir     ]
-eq              等于 应用于:整型比较 equal
-ne              不、等于 应用于:整型比较 not equal
-lt              小于 应用于:整型比较 letter
-gt              大于 应用于:整型比较 greate
-le              小于或等于 应用于:整型比较
-ge              大于或等于 应用于:整型比较
-a               双方都成立(and) 逻辑表达式 –a 逻辑表达式
-o               单方成立(or) 逻辑表达式 –o 逻辑表达式
-z               空字符串
布尔运算符
- ! 非运算
- -o 或运算
- -a 与运算
字符串运算符*
- = 字符串是否相等
- != 字符串是否不相等
- -z 字符串长度是否为0
- -n 字符串长度是否不为0
- str 字符串是否为空
案例实操
(1)23是否大于等于22
(2)helloworld.sh是否具有写权限
(3)/home/laoxiao/cls.txt目录中的文件是否存在
(4)多条件判断(&& 表示前一条命令执行成功时,才执行后一条命令,|| 表示上一条命令执行失败后,才执行 下一条命令)
[laoxiao@hadoop101 ~]$ [ condition ] && echo OK || echo notok
OK
[laoxiao@hadoop101 datas]$ [ condition ] && [ ] || echo notok
notok
流程控制(重点)
if 判断
基本语法
或者
注意事项:
(1)[ 条件判断式 ],中括号和条件判断式之间必须有空格
(2)if后要有空格
案例实操
(1)输入一个数字,如果是1,则输出banzhang zhen shuai,如果是2,则输出cls zhen mei,如果是其它,什么也不输出。
[laoxiao@hadoop101 datas]$ touch if.sh
[laoxiao@hadoop101 datas]$ vim if.sh

#!/bin/bash

if [ $1 -eq " 1 " ]
then
    echo "banzhang zhen shuai"
elif [ $1 -eq " 2 " ]
then
    echo "cls zhen mei"
fi

[laoxiao@hadoop101 datas]$ chmod 777 if.sh
[laoxiao@hadoop101 datas]$ ./if.sh 1
banzhang zhen shuai
case 语句
基本语法
case $变量名 in
"值 1")
如果变量的值等于值 1,则执行程序 1
;;
"值 2")
如果变量的值等于值 2,则执行程序 2
;;
…省略其他分支…
*)
如果变量的值都不是以上的值,则执行此程序
;;
esac
注意事项:
- case行尾必须为单词“in”,每一个模式匹配必须以右括号“)”结束。
-
双分号“;;”表示命令序列结束,相当于java中的break。
-
最后的“*)”表示默认模式,相当于java中的default。
案例实操
(1)输入一个数字,如果是1,则输出banzhang,如果是2,则输出cls,如果是其它,输出renyao。
[laoxiao@hadoop101 datas]$ touch case.sh
[laoxiao@hadoop101 datas]$ vim case.sh

!/bin/bash

case $1 in
"1")
        echo "banzhang"
;;
"2")
        echo "cls"
;;
*)
        echo "renyao"
;;
esac

[laoxiao@hadoop101 datas]$ chmod 777 case.sh
[laoxiao@hadoop101 datas]$ ./case.sh 1
1
for 循环
基本语法(一)
案例实操
(1)从1加到100
[laoxiao@hadoop101 datas]$ touch for1.sh
[laoxiao@hadoop101 datas]$ vim for1.sh

#!/bin/bash

s = 0
for((i = 0; i <= 100; i++))
do
        s = $[$ s+$i]
done
echo $s

[laoxiao@hadoop101 datas]$ chmod 777 for1.sh
[laoxiao@hadoop101 datas]$ ./for1.sh
“5050”
基本语法(二)
4.案例实操
(1)打印所有输入参数
[laoxiao@hadoop101 datas]$ touch for2.sh
[laoxiao@hadoop101 datas]$ vim for2.sh

#!/bin/bash

#打印数字

for i in $\*
do
        echo " ban zhang love $i "
done

[laoxiao@hadoop101 datas]$ chmod 777 for2.sh
[laoxiao@hadoop101 datas]$ bash for2.sh cls xz bd
ban zhang love cls
ban zhang love xz
ban zhang love bd
(2)比较\(\*和\)@区别
(a)\(\*和\)@都表示传递给函数或脚本的所有参数,不被双引号“”包含时,都以$1 \(2 …\)n的形式输出所有参数。
[laoxiao@hadoop101 datas]$ vim for.sh

#!/bin/bash

for i in $*
do
        echo " ban zhang love $i "
done

for j in $@
do
        echo " ban zhang love $j "
done

[laoxiao@hadoop101 datas]$ bash for.sh cls xz bdban zhang love cls ban zhang love xz
ban zhang love bd ban zhang love clsban zhang love xzban zhang love bd
(b)当它们被双引号“”包含时,“\(\*”会将所有的参数作为一个整体,以“\)1 \(2 …\)n”的形式输出所有参数;“\(@”会 将各个参数分开,以“\)1” “\(2”…”\)n”的形式输出所有参数。
[laoxiao@hadoop101 datas]$ vim for.sh

#!/bin/bash

for i in "$\*"
#$\*中的所有参数看成是一个整体,所以这个 for 循环只会循环一次
do
    echo " ban zhang love $i "
done

for j in "$@"
#$@中的每个参数都看成是独立的,所以“$@”中有几个参数,就会循环几次
do
    echo " ban zhang love $j "
done

[laoxiao@hadoop101 datas]$ chmod 777 for.sh
[laoxiao@hadoop101 datas]$ bash for.sh cls xz bd
ban zhang love cls xz bd
ban zhang love cls
ban zhang love xz
ban zhang love bd
while 循环
基本语法
案例实操
(1)从1加到100
[laoxiao@hadoop101 datas]$ vim while.sh

#!/bin/bash

s = 0
i = 1
while [ $i -le 100 ]
do
    s = $[$ s+$i]
    i = $[$ i+1]
done
echo $s

[laoxiao@hadoop101 datas]$ chmod 777 while.sh
[laoxiao@hadoop101 datas]$ ./while.sh
5050
read读取控制台输入
基本语法
read(选项)(参数)
选项:
-
-p:指定读取值时的提示符;
-
-t:指定读取值时等待的时间(秒)。
参数
变量:指定读取值的变量名
案例实操
(1)提示7秒内,读取控制台输入的名称
[laoxiao@hadoop101 datas]$ touch read.sh
[laoxiao@hadoop101 datas]$ vim read.sh

#!/bin/bash

read -t 7 -p "Enter your name in 7 seconds " NAME
echo $NAME

[laoxiao@hadoop101 datas]$ ./read.sh
Enter your name in 7 seconds xiaoze
xiaoze
函数
系统函数
basename基本语法
basename [string / pathname][suffix] (功能描述:basename命令会删掉所有的前缀包括最后一个(‘/’)字符, 然后将字符串显示出来。
选项:
suffix为后缀,如果suffix被指定了,basename会将pathname或string中的suffix去掉。
2.案例实操
(1)截取该/home/laoxiao/banzhang.txt路径的文件名称
[laoxiao@hadoop101 datas]$ basename /home/laoxiao/banzhang.txt
banzhang.txt
[laoxiao@hadoop101 datas]$ basename /home/laoxiao/banzhang.txt .txt
banzhang
dirname基本语法
dirname 文件绝对路径 (功能描述:从给定的包含绝对路径的文件名中去除文件名(非目录的部分),然后返回 剩下的路径(目录的部分))
4.案例实操
(1)获取banzhang.txt文件的路径
自定义函数
基本语法
经验技巧
(1)必须在调用函数地方之前,先声明函数,shell脚本是逐行运行。不会像其它语言一样先编译。
(2)函数返回值,只能通过$?系统变量获得,可以显示加:return返回,如果不加,将以最后一条命令运行结
果,作为返回值。return后跟数值n(0-255)
(3)可以采用标准输出:echo来作为函数的返回值
3.案例实操
(1)计算两个输入参数的和
[laoxiao@hadoop101 datas]$ touch fun.sh
[laoxiao@hadoop101 datas]$ vim fun.sh

#!/bin/bash


function sum()
{
    s = 0
    s = $[ $ 1 + $2 ]
    echo "$s "
}

read -p "Please input the number1: " n1;
read -p "Please input the number2: " n2;
sum $n1 $ n2;

[laoxiao@hadoop101 datas]$ chmod 777 fun.sh
[laoxiao@hadoop101 datas]$ ./fun.sh
Please input the number1: 2
Please input the number2: 5
7
Shell工具(重点)
cut
cut的工作就是“剪”,具体的说就是在文件中负责剪切数据用的。cut 命令从文件的每一行剪切字节、字符和字段并将这些字节、字符和字段输出。
基本用法
说明:默认分隔符是制表符
选项参数说明
-
-f 列号,提取第几列
-
-d 分隔符,按照指定分隔符分割列
3.案例实操
(0)数据准备
[laoxiao@hadoop101 datas]$ touch cut.txt
[laoxiao@hadoop101 datas]$ vim cut.txt

dong shen
guan zhen
wo wo
lai lai
le le
(1)切割cut.txt第一列
(2)切割cut.txt第二、三列
(3)在cut.txt文件中切割出guan
(4)选取系统PATH变量值,第2个“:”开始后的所有路径:
[laoxiao@hadoop101 datas] $ echo $PATH
/usr/lib64/bin:/usr/local/bin:/bin:/usr/bin:/usr/local/sbin:/usr/sbin:/sbin:/home/laoxiao/bin

[laoxiao@hadoop102 datas] $ echo $PATH | cut -d ':' -f 2-
/usr/local/bin:/bin:/usr/bin:/usr/local/sbin:/usr/sbin:/sbin:/home/laoxiao/bin

[laoxiao@hadoop102 datas] $ echo $PATH | cut -d ':' -f 2-3
/usr/local/bin:/bin:/usr/bin
sed
sed是一种流编辑器,它一次处理一行内容。处理时,把当前处理的行存储在临时缓冲区中,称为“模式空间”,接着用sed命令处理缓冲区中的内容,处理完成后,把缓冲区的内容送往屏幕。接着处理下一行,这样不断重复,直到文件末尾。文件内容并没有改变,除非你使用重定向存储输出。
基本用法
选项参数说明
-e 直接在指令列模式上进行sed的动作编辑。
3. 命令功能描述
| 命令 | 功能描述 |
|---|---|
| a | 新增 |
| d | 删除 |
| s | 查找并替换 |
4. 案例实操
(0)数据准备
[laoxiao@hadoop102 datas]$ touch sed.txt
[laoxiao@hadoop102 datas]$ vim sed.txt

dong shen
guan zhen
wo wo
lai lai
le le
(1)将“mei nv”这个单词插入到sed.txt第二行下,打印。
[laoxiao@hadoop102 datas]$ sed '2a mei nv' sed.txt

dong shen
guan zhen
mei nv
wo wo
lai lai
le le
文件并没有改变, -i∶直接修改读取的档案内容
(2)删除sed.txt文件所有包含wo的行
(3)将sed.txt文件中wo替换为ni
‘g’表示global,全部替换
(4)将sed.txt文件中的第二行删除并将wo替换为ni
awk
一个强大的文本分析工具,把文件逐行的读入,以空格为默认分隔符将每行切片,切开的部分再进行分析处理。
基本用法
-
awk [选项参数] ‘pattern1{action1} pattern2{action2}...’ filename
-
pattern:表示AWK在数据中查找的内容,就是匹配模式
-
action:在找到匹配内容时所执行的一系列命令
选项参数说明
-
-F 指定输入文件折分隔符
-
-v 赋值一个用户定义变量
3. 案例实操
(0)数据准备
(1)搜索passwd文件以root关键字开头的所有行,并输出该行的第7列。
(2)搜索passwd文件以root关键字开头的所有行,并输出该行的第1列和第7列,中间以“,”号分割。
注意:只有匹配了pattern的行才会执行action
(3)只显示/etc/passwd的第一列和第七列,以逗号分割,且在所有行前面添加列名user,shell在最后一行添加"dahaige,/bin/zuishuai"。
[laoxiao@hadoop102 datas] $ awk -F ':' 'BEGIN{print "user,shell"} {print $ 1 ","$7} END{print "dahaige,/bin/zuishuai"}' /etc/passwd
user,shell
root,/bin/bash
bin,/sbin/nologin
。。。
laoxiao,/bin/bash
dahaige,/bin/zuishuai
注意:BEGIN 在所有数据读取行之前执行;END 在所有数据执行之后执行。
(4)将passwd文件中的用户id增加数值1并输出
4. awk的内置变量
-
FILENAME 文件名
-
NR 已读的记录数
-
NF 浏览记录的域的个数(切割后,列的个数)
5. 案例实操
(1)统计passwd文件名,每行的行号,每行的列数
[laoxiao@hadoop102 datas]$ awk -F: '{print " filename:" FILENAME ", linenumber:" NR ", columns:" NF}' passwd

filename: passwd, linenumber: 1, columns: 7
filename: passwd, linenumber: 2, columns: 7
filename: passwd, linenumber: 3, columns: 7
(2)切割IP
[laoxiao@hadoop102 datas] $ ifconfig ens33 | awk '/inet / {print $ 2}'
192.168.1.102

[laoxiao@hadoop102 datas] $ ip a | awk '/inet / {print $ 2}'
127.0.0.1/8
192.168.1.102/24
(3)查询sed.txt中空行所在的行号
sort
sort命令是在Linux里非常有用,它将文件进行排序,并将排序结果标准输出。
基本语法
sort(选项)(参数)
-
-n 依照数值的大小排序
-
-r 以相反的顺序来排序
-
-t 设置排序时所用的分隔字符
-
-k 指定需要排序的列
参数:指定待排序的文件列表
2. 案例实操
(0)数据准备
[laoxiao@hadoop102 datas]$ touch sort.sh
[laoxiao@hadoop102 datas]$ vim sort.sh

bb: 40: 5.4
bd: 20: 4.2
xz: 50: 2.3
cls: 10: 3.5
ss: 30: 1.6
(1)按照“:”分割后的第三列倒序排序。
[laoxiao@hadoop102 datas]$ sort -t ':' -nrk 3 sort.sh

bb: 40: 5.4
bd: 20: 4.2
cls: 10: 3.5
xz: 50: 2.3
ss: 30: 1.6
学习代码
输出语句(echo/printf)
#!/bin/bash
#第一行用来告诉用那个 bash 执行
ls > result.txt
echo "this is a first bash shell 'yyf'"
#echo --> 表示输出到控制台
echo -n "the system time is: "
#echo -n --> 表示不换行
date
#echo 直接输出命令执行结果
echo "the result of id is `id`"
printf "the is printf output\n"
printf "my name is:%s and my age is:%d\n" yyf 18
#printf 函数和 c 的一样
变量
#变量-->$表示
#1.环境变量--> 之前加上$引用环境变量
echo " User info for userid: $USER "
echo UID: $UID
echo HOME: $HOME
#看到 $,系统就会当成变量,若要打印出$,需要转义
echo " this is \$yyf "
#2.自定义变量
test = "hello world"
echo $test
#将命令输出赋给变量-->``反引号 / $()格式
userinfo = `id`
echo " userinfo is $userinfo "
user =$(whoami)
echo " user is $user "
运算操作
#运算操作
#1.方括号 --> $[]形式
var1 =$[1+5]
echo $var1
var2 = $[$ var1 * 2]
echo $var2
#bash shell 只支持整数运算,zsh 支持浮点运算
数组和bash退出
#数组
#数组的创建
myarray =(1 "yyf" 87 "hxj")
#数组的引用 --> ${array_name[index]}
echo " this is array [1] ${myarray[1]}"
#获取数组的所有元素 --> array_name[*]
echo " the all content of array are ${myarray[*]}"
#获取数组的长度 --> #array_name[*]
echo " the length of array is ${#myarray[*]}"
#退出状态码 --> 表示脚本已经结束(范围为 0-255)
#可以$?来查看退出状态码 --> 正常结束为 0 异常结束为正整数
#echo $?
#exit 可以指定退出状态码
#exit 5
#echo $?
结构化命令
test命令
#test 命令 --> 检测命令执行状态(正常执行返回 0 异常返回其他) --> 可以配合 if—then 使用
#常见比较
#1.数值比较
#2.字符串比较
#3.文件比较 --> 很重要
if then else结构
#结构化命令
#1.if then
if pwd
then
    echo "it worded"
fi
#if 后面的命令正常执行才会执行 then 的命令
username = root
if grep $username /etc/passwd
then
    cat /etc/passwd > ./user_pass.txt
fi
echo 'this is the first if-then process'

#2.if then else 命令 --> 如果 if 后的命令正常执行,会执行 then 后的语句,如异常执行,会执行 else 后的语句
#if 可以使用复合条件 --> &&和||
if ifconfig
then
    echo "ifconfig worked"
else
    echo "ifconfig wrong"
fi
#if 嵌套
if whoami
then
    echo "whoami worked"
    if pwd
    then
        echo "pwd worked"
    else
        echo "pwd wrong"
    fi
else
    echo "whoami wrong"
fi

#3.if-then elif-then
if ls
then
    echo "ls worked"
elif cat ./result.txt
then
    echo "cat worked"
fi

#if-then 高级特性
#1.单括号 --> if (commond) --> 表示命令在子 shell 执行
#2.双括号 --> if ((commond)) --> 允许在比较过程中使用高级数学表达式(如 ++ >> **等)
((num1 = 2 ** 2))
if (($num1 > 10))
then
    num1 = 5
else
    num1 = 10
fi
echo $num1
#3.双方括号 --> if [[]] --> 提供了针对字符串比较的高级特性
for循环
#循环
#1.for 循环
#格式
#for var in list
#do
#   commonds
#done
for test in hello world yyf hxj
do
    echo $test
done
echo " the final test is $test "
for test in I don\'t know if this\'ll work
do
    echo " word:$test "
done
#shell 看到列表值中的单引号,会尝试使用他们来定义一个单独的数据值--> 解决:转义
#for 的列表值默认以空格分隔,若值中含有空格,需要用双引号包围
for temp in hello "world world" "ha ha" shell
do
    echo " word:$temp "
done
#for 从变量读取值列表
list = "this is test process in var"
list =$list " end "
#字符串的拼接
for var in $list
do
    echo " the var is $var "
done
#for 从命令读取值列表
filename = "/root/shelltest/testfile.txt"
#将字段分隔符设为换行符--> 需要将旧的字段分割符保存
IFS.OLD =$IFS
#指定多个字段分隔符
IFS =$'\n;:'
for file in $(cat $ filename)
#命令需要加$
#更改字段分隔符(默认分隔符为空格/制表符/换行符)--> IFS
do
    echo " the file content is:$file "
done
IFS =$IFS.OLD
#使用通配符读取目录
for file in /root/shelltest/*
do
    if [ -d "$file " ]
    #这里$file 加双引号的原因是避免文件名有空格导致报错
    then
        echo "$file is a directory "
    elif [ -f "$file " ]
    then
        echo "$file is a file "
    fi
done
while循环
#while 循环
#格式
#while test command
#do
#   other commands
#done
#test 的条件成立就一直执行循环

#循环处理文件数据示例
#嵌套循环与管道符结合
IFS.OLD =$IFS
IFS =$'\n'
for entry in $(cat /etc/passwd)
do
    echo " Values in $entry -" >> /root/shelltest/passwd_info.txt
    IFS =:
    for value in $entry
    do
        echo "      $value " >> /root/shelltest/passwd_info_brief.txt
    done
done
#查找环境变量中的可执行文件
IFS.OLD =$IFS
IFS =:
for folder in $PATH
do
    echo "$folder:" >> ./path.txt
    for file in $folder/*
    do
        if [ -x $file ]
        then
            echo "      $file " >> ./path_file_cecute.txt
        fi
    done
done
循环控制
命令行参数
#处理用户输入
#传递参数--> 命令行参数,在使用脚本时将参数传入
#读取参数--> $0对应脚本名。$ 1 对应第一个命令行参数,依次类比,直到$9(默认以空格分隔,若要有空格,需要加引号)
echo " this is first var-->$1 "
echo " this is second var-->$2 "
echo " the name and load of the shellfile is $0 "
#$0 会包含脚本的路径,若只要脚本名,可以使用 basename 命令
name = $(basename $ 0)
echo " the file name is $name "
#特殊参数变量
#1.参数统计-->$#可以统计有多少个命令行参数
if [ $# -eq 1 ]
then
    echo "the var number is 1"
elif [ $# -eq 2 ]
then
    echo "the var number is 2 and right"
elif [ $# -eq 0 ]
then
    echo "the var number is 0"
fi
#获取所有的命令行参数--> $*和$@
#主要使用$@--> 会将命令参数视为多个独立的单词,然后遍历来访问
count = 1
for param in "$@"
do
    echo "the #$count var is $ param"
    count = $[$ count+1]
done
读取用户输入(read)
#获取用户输入--> read(从标准输入)
echo "enter your name: "
read -t 5 -n 3 name
# -t 用于指定等待输入时间,-n 用于指定输入的字数限定(到达规定数后自动读取,不用按 enter)
echo
echo " your name is $name "
read -p "please input your age and i will count the days: " age
# -p 用于指定提示语句
days = $[$ age*365]
echo " your days is $days "
#read 也可用来读取文件(一行一行的读取)
count = 1
cat $(pwd)/readtest.txt | while read line
do
    echo "the $count line is $ line"
    count = $[$ count+1]
done
# while 会循环处理 read 命令,直到 read 以 0 退出(文件读取完时)
文件描述符
#!/bin/bash
#文件描述符--> 0/1/2
#1--> 标准输出  2--> 标准错误
#ls -al ./test1.txt ./test2.txt ./test3.txt ./test.txt 1 >./rightinfo.txt 2 >./errorinfo.txt
# 2 > 1 > 中间不能有空格 &> 表示将标准输入和标准错误都重定向到一个地方
#永久重定向--> exec(适用于一个脚本中有很多需要重定向时)
#exec 2 >./errorinfo.txt
#整个脚本运行时错误都会重定向到指定文件
函数
#函数
#创建函数
function hello() {
#注{这里必须要有空格
    echo "hello"
}
#函数调用--> 直接名字调用即可
hello
function add() {
    read -p "please input first number:" firnum
    read -p "please input second number:" secnum
    return $(( $ firnum + $secnum ))
    #注 return 只能返回 0-255 的值
}
add
echo " the add result of two numbers is $?"
#$?用于获得函数的返回值

function addinput() {
    return $(($ 1+$2))
}
#在函数内部,可以通过 $n(1-9)的形式,若n>=10,则通过${n}来获取参数
addinput 34 56
echo " the result of addinput is $?"
shell文件包含
- filename.sh
- showsysteminfo.sh
#!/bin/bash
CL ="\033[1; 32m "
END ='\033[0m'
IPV4 = `ifconfig ens33 |grep -Eo '([0-9]{1,3}\.){3}[0-9]{1,3}'|head -n1`
VS = `uname -a`
KN = `uname -r`
CPU = `lscpu |grep 'Model name' |tr -s ' ' |cut -d: -f2`
MEMORYSIZE = `free -h |grep 'Mem' |tr -s ' ' : |cut -d: -f2`
DISKSIZE = `lsblk |grep '^sd' |tr -s ' '  |cut -d ' ' -f1,4 |paste -s -d, `
echo -e " Hostname is :          ${CL}${HOSTNAME}${END}"
echo -e " IPV4 adress is :       ${CL}${IPV4}${END}"
echo -e " system's version :     ${CL}${VS}${END}"
echo -e " Kernel version is :    ${CL}${KN}${END}"
echo -e " CPU version is :       ${CL}${CPU}${END}"
echo -e " Memory's size is :     ${CL}${MEMORYSIZE}${END}"
echo -e " Disk size is :         ${CL}${DISKSIZE}${END}"